


November 17, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
大規模言語モデル(LLM)は、企業がタスクを自動化し、コンテンツを生成し、データと対話する方法を根本から変えつつあります。しかし、現在のLLMサービスの多くはクラウド中心であり、データセキュリティ、コンプライアンス、および制御に関する懸念を引き起こしています。
機密情報や規制対象データを扱う組織にとって、外部APIやパブリッククラウドモデルへの依存は実行不可能な場合が多くあります。これが、企業が自社のインフラストラクチャ内で安全にモデルを運用する、オンプレミスLLMデプロイメントへの急速な移行につながっています。
本記事では、オンプレミスLLMとは何か、なぜ重要なのか、どのように機能するのか、そしてTrueFoundryのようなプラットフォームがエンタープライズ環境でスケーラブルかつ安全なデプロイメントをどのように実現するのかを探ります。
オンプレミスLLMとは、外部のクラウドサービスやサードパーティAPIを介するのではなく、組織自体のインフラストラクチャ内でデプロイおよび運用される大規模言語モデルを指します。これらのモデルはオープンソースまたはプロプライエタリであり、通常は内部のセキュリティおよびコンプライアンス基準を満たすように構成された社内GPUサーバー、プライベートデータセンター、または分離されたクラウド環境で実行されます。
パブリックエンドポイントやベンダー管理のインフラストラクチャに依存するクラウドホスト型LLMとは異なり、オンプレミスLLMは組織によって完全に制御されます。これにより、高度なカスタマイズ、ファインチューニング、および社内システムやワークフローとの統合が可能になります。企業はLLaMA 2、Mistral、Mixtralなどの使用するモデルを選択し、特定のビジネスニーズや領域のニーズに基づいて最適化できます。
オンプレミスデプロイメントにより、チームはモデルの動作をカスタマイズし、データレジデンシーポリシーを適用し、機密情報が信頼できるネットワークから外部に出ないようにすることができます。また、特に大容量またはレイテンシに敏感なアプリケーションにおいて、より厳密なパフォーマンスチューニングとコスト管理の機会が開かれます。自律性、セキュリティ、および規制遵守を優先する組織にとって、オンプレミスLLMは商用AI APIに代わる実用的でスケーラブルな選択肢を提供します。
オンプレミスLLMデプロイメントにより、インフラストラクチャ、データ、およびモデルの動作を完全に制御できます。ただし、慎重な計画、投資、および継続的な管理も必要となります。考慮すべき主要な側面は以下の通りです。
大規模言語モデルを効率的に実行するには、ハイパフォーマンスなハードウェアが必要です。これには、NVIDIA A100やH100などの強力なGPU、十分なRAM、高速ネットワーク、および大きなモデル重みやデータセットを処理するための高速SSDストレージが含まれます。
データの完全な所有権を保持できるため、エアギャップ環境の構築、厳格なファイアウォールポリシー、GDPRやHIPAAなどのデータレジデンシー規制への準拠が可能になります。これにより、オンプレミスデプロイメントは機密情報や規制対象データを扱う業界に最適です。
バージョニング、コンテナ化、デプロイメント、およびモニタリングのためのMLパイプラインを実装する必要があります。継続的なパフォーマンス追跡により、長期にわたるモデルの精度、信頼性、および運用の安定性を確保できます。
トークンベースの継続的なAPI利用料は回避できますが、オンプレミスLLMデプロイメントにはハードウェアへの大規模な初期資本投資が必要です。また、電力、冷却、メンテナンス、専任スタッフなどの継続的な運用コストも考慮する必要があります。
モデル重みに完全にアクセスできるため、独自データを使用した高度なファインチューニングが可能です。一般的なクラウドホスト型モデルとは異なり、組織のワークフローに沿った高度にカスタマイズされたパフォーマンスを実現できます。
スケーラビリティは利用可能なハードウェア容量に依存します。クラウドの自動スケーリングとは異なり、ピーク時のワークロードを計画し、ロードバランシングを実装し、低レイテンシと高スループットを維持するためにシステムを最適化する必要があります。
社内のITまたはDevOpsチームが、セキュリティパッチの適用、インフラストラクチャの保守、およびモデルの更新を担当します。定期的なメンテナンスにより、システムの信頼性、セキュリティ、および進化するAI要件との互換性が確保されます。
クラウドベースのAIサービスにより、チームは機械学習モデルを大規模に試行、プロトタイプ作成、デプロイすることが容易になりました。しかし、エンタープライズ環境における本番ワークロードとなると、クラウド中心のLLMのみに依存することには無視できないいくつかの制限事項が存在します。
データのプライバシーと制御は最も重大な懸念事項です。パブリッククラウドAPIを使用する場合、機密入力データはインターネット経由で送信され、外部インフラストラクチャ上で処理される必要があります。これは、特に厳格な規制基準が適用されるヘルスケア、金融、防衛、法務などの分野において、データ漏洩、不正アクセス、およびコンプライアンス違反のリスクをもたらします。
ベンダーロックインも大きなデメリットです。クラウドAIプラットフォームは、推論API、ストレージ、ファインチューニングを独自の能力で組み込むことがよくあります。特定のプロバイダーを中心にワークフローが構築されると、別のサービスへ移行したりワークロードを内製化したりするには時間と費用がかかります。この依存関係により、長期的な柔軟性や、モデルの更新・利用規約に対する制御が制限されます。
予測不能なコストのスケーリングも、使用量が増加するにつれて課題となります。LLMは計算集約型であり、トークン数やリクエスト量に基づくクラウドの価格設定モデルは、特に高スループットや継続的な対話を伴うアプリケーションにおいて、運用コストの急増を招く可能性があります。
さらに、クラウド環境は低レイテンシおよびエッジデプロイメントの選択肢が限られています。ほぼ即時の応答やオフライン機能を必要とするアプリケーションは、外部APIに依存しているとパフォーマンス目標の達成に苦労する可能性があります。
最後に、クラウドプロバイダーはインフラストラクチャの多くを抽象化しているため、チームにはパフォーマンスのボトルネック、最適化の機会、またはチューニングパラメータに対する可視性がほとんど残りません。
制御、透明性、および長期的な持続可能性を求める企業にとって、これらの制限事項はオンプレミスLLMソリューションを採用する強力な理由となります。
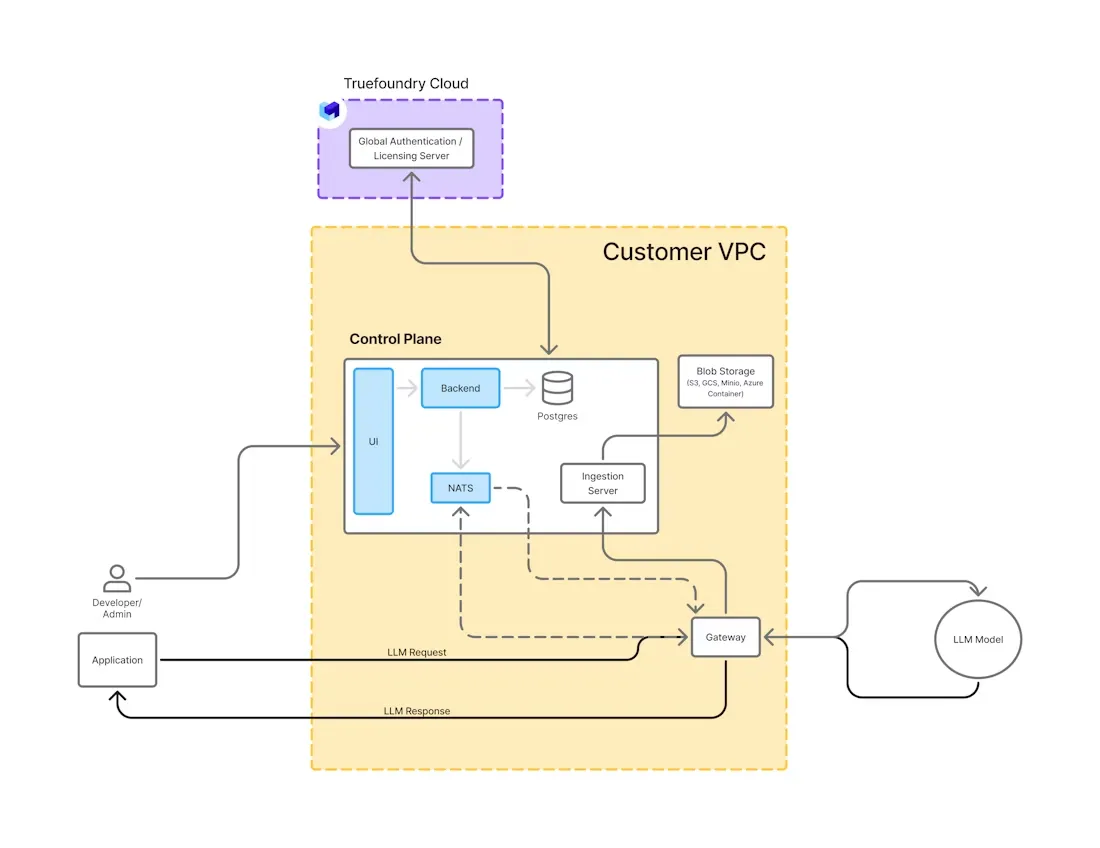
LLMをオンプレミスにデプロイするには、パフォーマンス、セキュリティ、および保守性のバランスをとる、慎重に構造化されたアーキテクチャが必要です。以下は、エンタープライズグレードの構成で一般的に見られる主要コンポーネントです。
コンピュートインフラストラクチャ:ハイパフォーマンスGPUは、オンプレミスLLMの基盤です。企業はモデルのサイズやスループットの要件に応じて、NVIDIA A100、H100、またはL40 GPUをよく使用します。これらは、適切な冷却、ネットワーク、ストレージを備えたローカルデータセンターまたはプライベートクラウドクラスタに配置されます。
推論エンジン:vLLM、TGI、DeepSpeed-Inferenceなどの推論フレームワークが、実際のモデル実行を処理します。これらはメモリ使用量を最適化し、トークンストリーミングをサポートし、複数リクエストのバッチ処理を可能にしてスループットを最大化します。
モデル管理とストレージ:モデルは、安全な成果物リポジトリまたはボリュームマウントにローカル保存されます。モデルのライフサイクルを管理し、変更を監査するためには、バージョニング、ロールバック、およびアクセス制御メカニズムが不可欠です。
コンテナ化とオーケストレーション:DockerやKubernetesなどのツールを使用して、LLMワークロードのデプロイ、スケーリング、管理を行います。Kubernetesは自動スケーリング、GPUスケジューリング、ロードバランシング、障害復旧を処理し、サービス全体で一貫したパフォーマンスを確保します。
API層とルーティング:RESTまたはOpenAI互換のAPI層が、LLM機能を内部アプリケーションに公開します。これには、安全性と制御のためのマルチモデルルーティング、ユーザー認証、プロンプトフィルタリングを含めることができます。
オブザーバビリティとモニタリング:レイテンシ、GPU使用率、リクエストスループット、トークン生成速度などのメトリクスは、Prometheus、Grafana、OpenTelemetryなどのツールを使用して追跡されます。稼働時間の維持や問題のデバッグには、ロギングとアラートが不可欠です。
このモジュール式アーキテクチャにより、企業は内部ポリシー、パフォーマンス目標、コンプライアンス要件に合わせた、スケーラブルで安全なLLMシステムを構築できます。
オンプレミスLLMは、データ主権、低レイテンシパフォーマンス、およびAIパイプラインの完全な制御を必要とする業界全体で採用が進んでいます。以下に代表的で影響力の大きいユースケースを紹介します。
病院や研究機関は、患者の経過記録の要約、退院サマリーの作成、臨床記録の支援にLLMを使用しています。オンプレミスデプロイメントにより、患者の健康情報が病院の安全なインフラストラクチャ内に留まり、HIPAAコンプライアンスや組織のデータポリシーをサポートします。
金融機関は、決算説明会の要約、コンプライアンスレポートの自動化、財務諸表の分析などのタスクにLLMを使用しています。オンプレミス環境により、内部リスク枠組みや規制監査への準拠を維持しながら、機密性の高い財務データがサードパーティAPIに公開されるのを防ぎます。
政府機関は、質疑応答、機密レポートの要約、内部ナレッジ検索にLLMを使用しています。国家安全保障データは厳格に隔離される必要があるため、オンプレミスLLMはデータ分類プロトコルに違反することなく生成AIアプリケーションを可能にします。
法律事務所や法務部門は、契約書の分析、要約の作成、法務調査の支援にLLMを使用しています。オンプレミスデプロイメントにより、弁護士・クライアント間の秘匿特権情報が社内サーバーから外部に出ないことが保証され、機密性を維持し弁護士会の要件を満たします。
製造業の企業は、トラブルシューティングガイドの生成、センサーログの解釈、現場技術者の支援にLLMを使用しています。ローカルサーバーにLLMをデプロイすることで、独自の機械データを外部サービスに送信することを回避し、リモート環境やネットワークから切断された環境でのレイテンシを削減できます。
通信会社は、チャットボットの駆動、チケットの優先順位付け、自動サービス推奨の提供にLLMを使用しています。オンプレミスデプロイメントにより、地域のプライバシー法に準拠して顧客データを内部インフラストラクチャ内に保持しながら、リアルタイムのパフォーマンスを実現します。
これらのユースケースは、オンプレミスLLMがセキュリティ、コンプライアンス、制御を損なうことなく、強力な自動化とインテリジェンスをどのように解き放つかを際立たせています。
LLMをオンプレミスにデプロイするには、モデルの選定から本番環境でのモニタリングに至る一連の調和されたステップが含まれます。明確に定義されたワークフローにより、システムはスケーラブルかつ安全で、組織のニーズに合わせて最適化されます。
プロセスは、ユースケースに基づいた適切なモデルの選択から始まります。LLaMA 2、Mistral、Mixtralなどの人気のあるオープンソースモデルは、オンプレミスデプロイメントでよく好まれます。選定後、モデルはダウンロードされ、必要に応じて量子化され、インフラストラクチャとの互換性が検証されます。
次に、GPUサーバーまたはプライベートクラウドのリソースが準備されます。これには、コンテナランタイム(例:Docker)、オーケストレーター(例:Kubernetes)、モデルの重みやログをホストするためのストレージ層のセットアップが含まれます。コンプライアンス要件を満たすように、アクセス制御とセキュリティポリシーが構成されます。
モデルはvLLMやTGIなどの推論エンジンに読み込まれます。これらのエンジンは、リアルタイムテキスト生成、バッチ処理、ストリーミング、およびメモリ最適化のためのランタイム環境を提供します。構成ファイルによってバッチサイズ、最大トークン数、および同時実行制限が定義されます。
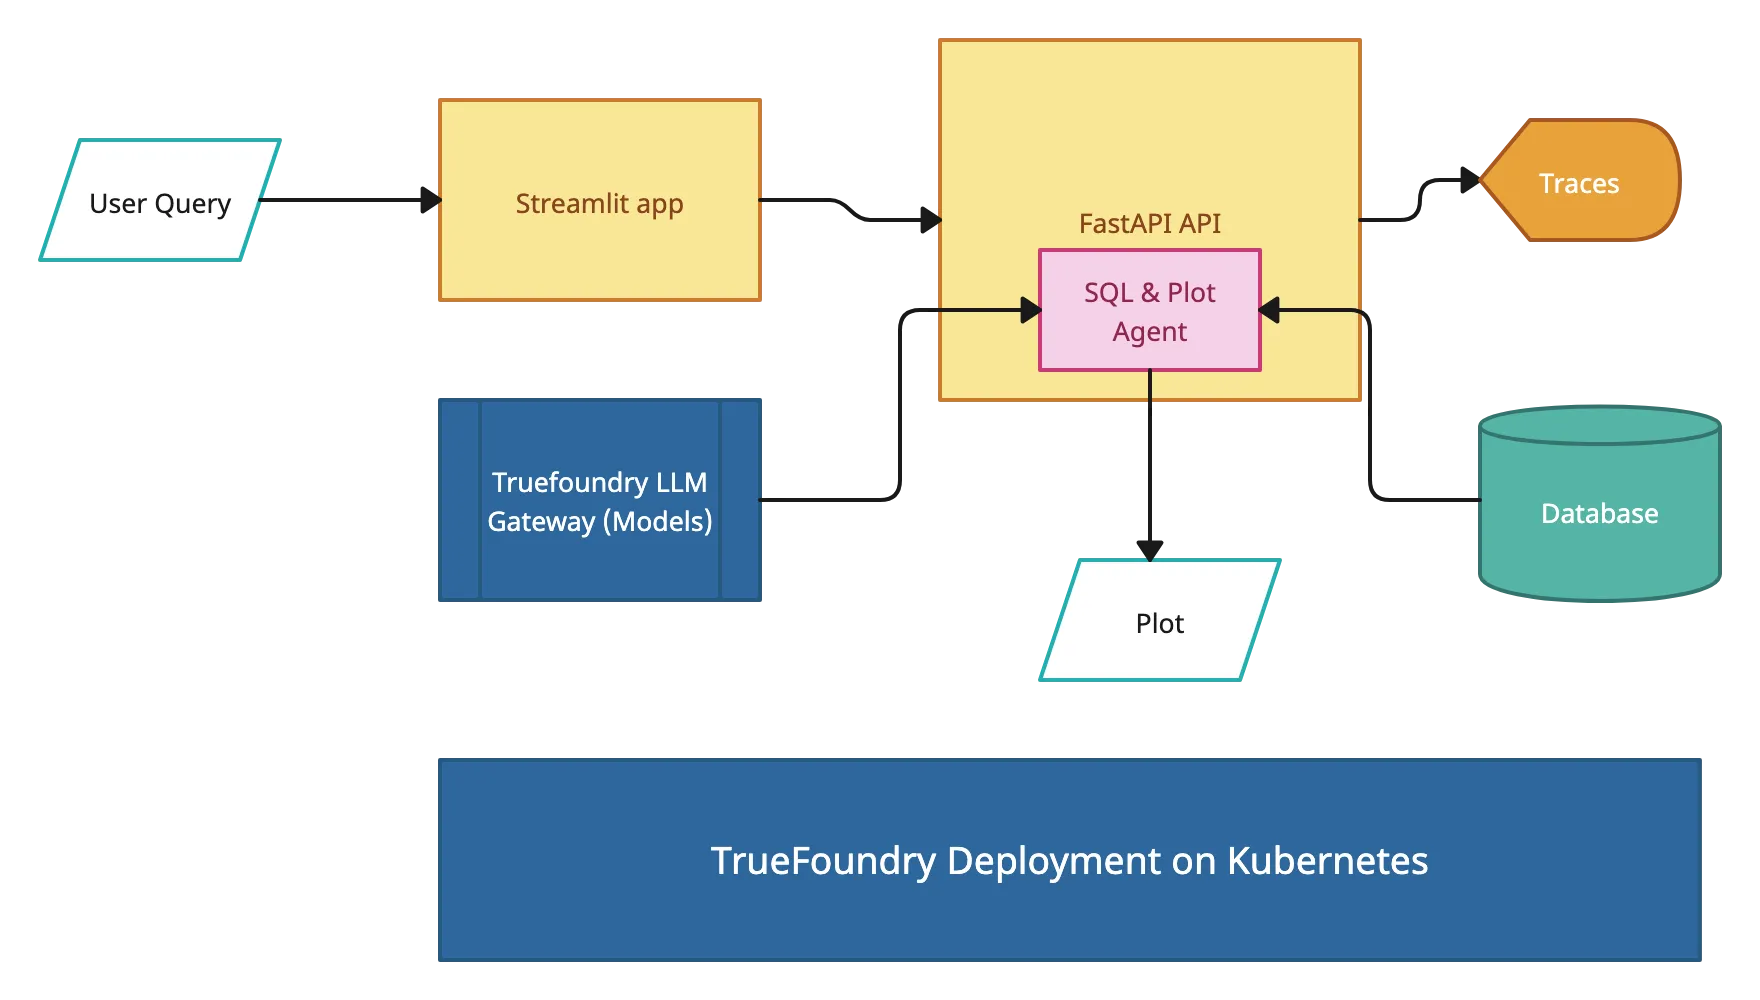
エンジンが稼働すると、RESTまたはOpenAI互換のAPIを介して公開されます。これにより、内部アプリ、ツール、またはユーザーインターフェースがモデルにクエリを実行できるようになります。制御性を高めるために、この層でマルチモデルルーティング、認証、およびレート制限を追加できます。
GPU使用率、レイテンシ、トークンスループット、およびリクエストエラーを追跡するために、オブザーバビリティツールが接続されます。トラフィックパターンに基づいて、ダウンタイムなしで需要に対処できるように自動スケーリングポリシーまたは手動スケーリング手順が構成されます。
このワークフローに従うことで、組織は外部プラットフォームに依存したり機密データを公開したりすることなく、自社のインフラストラクチャ内でLLMを効率的に立ち上げ、管理することができます。
以下のツールと技術は、エンタープライズグレードの信頼性を維持しながら、優れたパフォーマンス、セキュリティ、および完全なデータ制御を備えたオンプレミスLLMのデプロイを支援します。
LLMをオンプレミスにデプロイすることで、組織はAIインフラストラクチャを完全に制御できますが、トレードオフも伴います。導入を成功させるには、メリットと課題の両方を理解することが不可欠です。
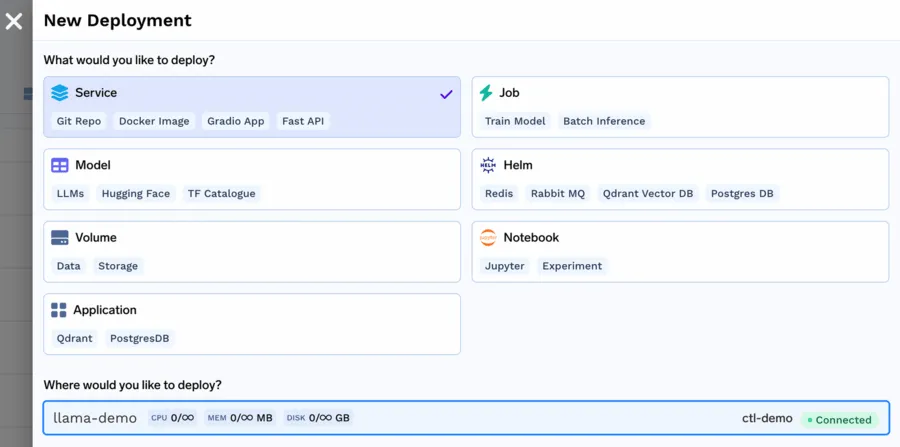
TrueFoundryは、プライベートインフラストラクチャ内での大規模言語モデルのデプロイと管理を簡素化し、深いDevOpsやMLOpsの専門知識を必要とせずに、企業がオンプレミスGenAIを利用できるようにします。Kubernetes上に構築されたTrueFoundryは、vLLMやTGIなどのハイパフォーマンス推論エンジンの事前統合サポートを通じて、高速で安全かつスケーラブルなLLMサービングを可能にします。
このプラットフォームはコンテナ、GPU、およびスケーリングポリシーの管理の複雑さを抽象化し、チームがインフラストラクチャの保守ではなくアプリケーションの構築に集中できるようにします。TrueFoundryのAI Gatewayを使用すると、組織はすべて自社の安全な環境内で、レート制限、トークンベースの課金、およびマルチモデルルーティングを適用しながら、OpenAI互換APIを使用してLLMを公開できます。
また、TrueFoundryはトークン使用量、レイテンシ、モデルパフォーマンスのリアルタイムモニタリングを含む組み込みのオブザーバビリティ機能を提供します。これにより、チームはスループットを最適化し、問題をトラブルシューティングし、ガバナンスを徹底できます。
LLaMA 2、Mistral、またはファインチューニングされた内部モデルのいずれをデプロイする場合でも、TrueFoundryは企業に、完全にカスタマイズ可能でコンプライアンスに準拠し、スケーリングに対応した、オンプレミスGenAI用の本番環境対応ソリューションを提供します。
企業での大規模言語モデルの採用が増加する中、オンプレミスデプロイメントは、データのプライバシー、コンプライアンス、またはインフラストラクチャの制御を損なうことなくGenAI を活用するための安全で柔軟な道を提供します。クラウドベースのソリューションは利便性を提供しますが、規制された環境や機密性の高い環境では不十分なことがよくあります。オンプレミスLLMは、スタックの完全な所有権、優れたカスタマイズ性、および予測可能なコストを組織にもたらし、長期的なAI戦略に最適です。TrueFoundryのようなプラットフォームを使用すれば、社内でのLLMのデプロイとスケーリングがより迅速かつ効率的になり、管理も容易になります。制御、透明性、およびイノベーションに焦点を当てる組織にとって、オンプレミスGenAIは単なる代替手段ではなく、戦略的な優位性となります。
Dockerでモデルをコンテナ化し、Kubernetesでオーケストレーションを行い、vLLMやTGIなどの最適化された推論エンジンを介して提供することで、LLMをオンプレミスにデプロイします。プライベートインフラストラクチャ内でGPU、ネットワーク、ストレージを構成し、モニタリングツールを統合し、バージョニング、スケーリング、セキュリティ、パフォーマンスを管理するためのMLOpsパイプラインを実装します。
クラウドデプロイメントはオンデマンドのスケーラビリティ、管理されたインフラストラクチャ、従量課金制の価格設定を提供するのに対し、オンプレミスデプロイメントは完全なデータ制御、カスタマイズ、およびコンプライアンスを提供します。オンプレミスではクラウドの柔軟性と引き換えにセキュリティと主権を高めますが、ハードウェアコスト、メンテナンス、スケーリングの限界、および運用の複雑さを社内で処理する必要があります。
パブリッククラウドLLMサービス、プライベートクラウド環境、ハイブリッドデプロイメント、または管理型AIプラットフォームを使用できます。OpenAIのようなAPIベースのモデルやホスト型のHugging Faceエンドポイントは、インフラストラクチャのオーバーヘッドを削減します。ハイブリッド構成では、ピーク時のワークロードや実験のためにクラウドのスケーラビリティを活用しながら、機密データをオンプレミスに保持できます。
オンプレミスLLMには、高額な初期ハードウェアコスト、継続的なメンテナンス、熟練したスタッフ、および容量計画が必要です。スケーリングの制限、電力および冷却の費用、アップデートの遅延といった問題に直面します。セキュリティパッチ、モデルの更新、インフラストラクチャの信頼性の管理は、完全管理型のクラウドベースAIサービスと比較して運用の複雑さを増大させます。
TrueFoundryは、Kubernetesのオーケストレーション、GPUスケジューリング、モデルサービング、モニタリング、およびセキュリティコントロールを統合することで、オンプレミスでのLLMデプロイを簡素化します。一括管理、RBAC、オブザーバビリティ、そして環境間でのシームレスなスケーリングが可能になります。事前統合された推論エンジンとコンプライアンス対応機能により、プロダクションレベルのAIを安全かつ効率的にデプロイできます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























