August 31, 2026
|
5 min read

Blazingly fast way to build, track and deploy your models!
組織がAIアプリケーションをスケールさせる際、本番環境でモデルがどのように動作しているかを把握することは、まずモデルを稼働させることと同じくらい重要です。エンジニアは、レイテンシー、トークン使用量、モデルの動作、終了理由(finish reason)など、あらゆるインファレンスリクエストに対する可視性を必要とします。しかし、すべてのモデルやプロバイダーに可視化ツールを接続することは、統合のたびに複雑で反復的な計装(instrumentation)作業が発生することを意味します。
大きな疑問:各モデルに対してカスタムエンジニアリングを行うことなく、チームが使用しているすべてのモデル全体でフルスタックの可視性を得るにはどうすればよいでしょうか?
Middlewareの目標は、可視性を強力であると同時に容易にすることです。そのため、MiddlewareとTrueFoundry AI Gatewayの統合を発表できることを大変嬉しく思います。この統合により、インフラストラクチャメトリクス、アプリケーションのトレース、ログと関連付けられたすべてのAIインファレンスリクエストに対する完全な可視性が単一の集中プラットフォームから組織に提供され、AI運用が透明かつ制御下にあることを確実にするのに役立ちます。
TrueFoundry AI Gatewayは、開発者やプラットフォームチームがAIアプリケーションを管理、監視、スケールさせるための強力な手段です。数百に及ぶ大規模言語モデルへの統合アクセス、スマートルーティング、集中化されたポリシー適用をすべて1箇所に集約します。単一のゲートウェイPodで、レイテンシーの増加をわずか約3msに抑えながら250 RPS以上を処理できるため、初日から本番運用に耐えうる性能を発揮します。
AIの導入が加速する中で、本当の課題はモデルへのアクセスではなく、その後に続く複雑性の管理です。複数のプロバイダー、進化し続けるAPI、厳格なコンプライアンス要件により、チームの速度は急速に低下する可能性があります。TrueFoundry AI Gatewayはこの複雑性を整理し、エンタープライズAIのコントロールプレーンとして機能します。ゲートウェイを呼び出すアプリケーションに一切の変更を加えることなく、すべてのモデルおよび環境においてアクセスを統合し、ポリシーを適用し、OpenTelemetry準拠の可視性を提供します。
Middlewareは、コアな計装標準としてOpenTelemetry上に構築されたフルスタック可視性プラットフォームです。OTEL Collectorを通じてトレース、ログ、インフラストラクチャメトリクス、リアルユーザーモニタリング(RUM)データを受け取り、それらを単一の関連付けられたデータレイヤーに保存することで、エンジニアリングチームにシステムの全体像を一箇所で提供します。
Middlewareを際立たせているのは、トレースが到着した後の処理です。スパンを孤立させて保存するのではなく、Middlewareはサービスが実行されているホストまたはクエリからのインフラストラクチャシグナルとそれらを関連付けます。ゲートウェイスパンにおけるレイテンシーの急増を調査しているエンジニアは、ダッシュボードを切り替えることなく、トレースビューからそのPodのCPUやメモリメトリクスに直接移動できます。また、Middlewareは受信したスパンデータからライブサービストポロジーマップを構築し、計装されたすべてのサービスをサービスマップ上のノードとして可視化し、レイテンシーやエラー率をスパンから自動計算します。
MiddlewareとTrueFoundry AI Gatewayの統合は、AIの可視性を簡素化し強化します。この組み合わせにより、本番グレードの可視性をAIワークフローに直接組み込むことが容易になり、デプロイの瞬間からシステムが観察可能(observable)になります。
この統合ソリューションにより、TrueFoundry AI Gatewayを通過するすべてのインファレンスリクエストは、構造化されたOpenTelemetryスパンのセットを自動的に生成します。これらのスパンは、プロンプト内容、完了内容、トークン数、モデル名、レイテンシー、終了理由をクエリ可能な属性として保持し、OTLP/HTTPを介して非同期でMiddlewareに送信されます。Middlewareは、他のインフラストラクチャテレメトリとともにそれらを取り込み、ゲートウェイトラフィックを、それを呼び出すアプリケーションサービスと並んで、トポロジーマップやAPMビューの第一級サービスとして即座に可視化します。
機密データを完全に制御するために、TrueFoundryゲートウェイの「Request Dataの除外」トグルを使用すると、エクスポート前にスパン属性からプロンプトおよび完了内容が削除されます。トークン数、レイテンシー、モデルのメタデータはそのまま保持されるため、外部システムにユーザー入力を晒すことなく、完全な運用可視性を維持できます。厳格なネットワークエグレス要件を持つ組織の場合、ゲートウェイのエクスポーターをMiddlewareに転送するセルフマネージドOpenTelemetry Collectorに向けることもでき、エンドポイントURL以外の変更は不要です。
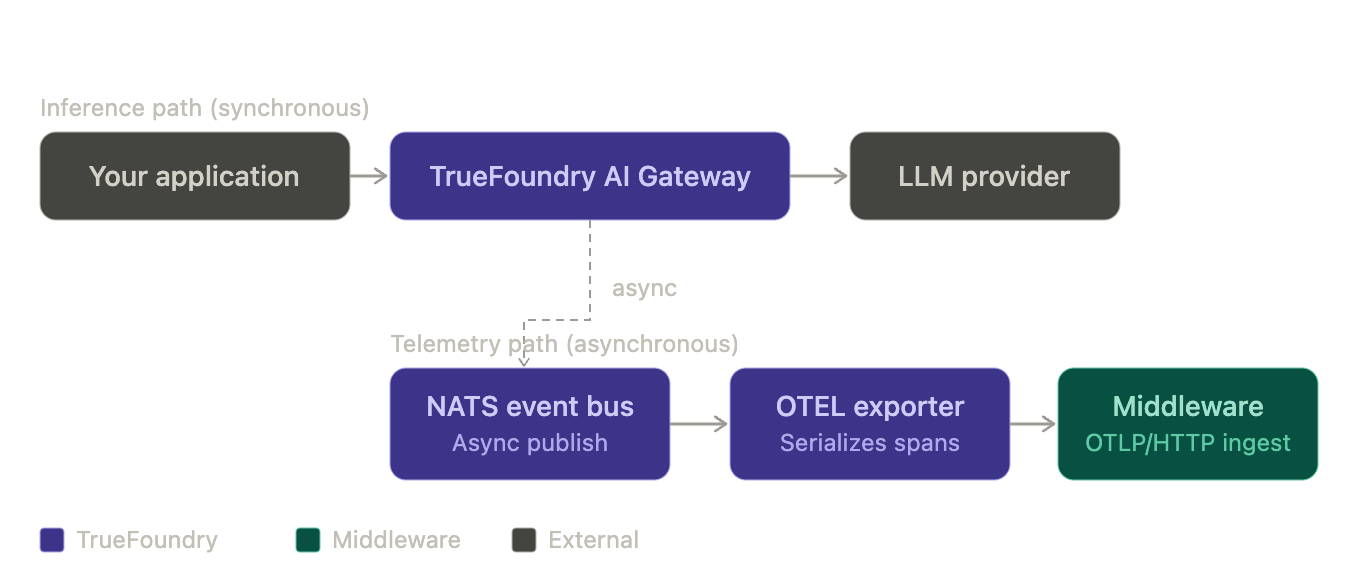
MiddlewareとTrueFoundry AI Gatewayの統合
MiddlewareとTrueFoundry AI Gatewayが連携し、インファレンスパスに複雑さを加えることなく可視性を提供します。
設定も同様に簡単です。TrueFoundryダッシュボードの AI Engineering → Settings → OTEL Config に移動し、MiddlewareテナントエンドポイントとAPIキーを入力し、プロトコルをprotobufエンコーディングのHTTPに設定するだけで準備は完了です。
AIの可視化のために複雑な計装作業を行う必要はありません。MiddlewareがTrueFoundry AI Gatewayに統合されているため、設定を保存した瞬間から、インファレンストラフィック全体が可視化され、インフラストラクチャシグナルと関連付けられ、モデル名やトークン数でフィルタリング可能になり、ライブサービストポロジーにマッピングされます。これは、カスタムエンジニアリングプロジェクトというよりもスイッチを切り替えるような感覚で、簡単にセットアップできる完全で本番グレードの可視性です。
詳細については、MiddlewareドキュメントおよびTrueFoundry統合リファレンスをご覧いただき、AIアプリケーションのフルスタック可視性を得るのがいかに簡単かをご確認ください。
始める準備はできましたか?今すぐTrueFoundryゲートウェイをMiddlewareに接続し、すべてのインファレンスリクエストを構造化されクエリ可能な可視性イベントに変換しましょう。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.