



November 16, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
大規模言語モデルは急速にエンタープライズソフトウェアの中核レイヤーとなりつつあります。ホスト型APIを使用したクラウドベースの実験から始まった取り組みは、社内ツール、顧客向けアプリケーション、自動化ワークフロー全体に組み込まれる本番グレードのシステムへと進化しています。
この移行が進む中で、多くの企業が厳しい現実に直面しています。すべてのAIワークロードをパブリッククラウド上で実行できるわけではないということです。
機密性の高いエンタープライズデータ、独自の知的財産、規制対象のワークロード、レイテンシが極めて重要なアプリケーション、そしてコンプライアンス上の義務により、多くのチームがオンプレミスまたはプライベートインフラ内にLLMをデプロイすることを余儀なくされています。しかし、単にモデルをセルフホストするだけでは、運用の大きな問題は解決しません。利用するチーム、アプリケーション、モデルが増加するにつれて、企業にはLLMエコシステム全体でアクセスを制御し、ポリシーを適用し、使用状況を監視し、コストを管理するための統一された方法が必要になります。
ここで不可欠となるのが、オンプレミスインフラにおけるLLM Gatewayです。
LLM Gatewayは、すべてのアプリケーションが個々のモデルと直接統合できるようにするのではなく、モデルのアクセス方法と使用方法を制御する中央集権型のコントロールレイヤーを導入します。オンプレミス環境において、このゲートウェイは、可視性やコントロールを損なうことなく、企業が安全かつコンプライアンスに準拠し、効率的にLLMの導入を拡張できるようにするバックボーンとなります。
LLM Gatewayとは、アプリケーションと言語モデルの間に位置する中央集権型のアクセスおよびガバナンスレイヤーです。アプリケーションがモデルを直接呼び出す代わりに、すべてのLLMリクエストがゲートウェイを経由し、一箇所でセキュリティ、ルーティング、オブザーバビリティ(可視性)、ポリシー制御を適用します。
オンプレミス環境では、ゲートウェイとモデルの両方が、データセンター、プライベートクラウド(VPC)、エアギャップ環境など、組織のインフラ内で完全に実行されます。これにより、プロンプト、レスポンス、エンベディング、メタデータが管理された境界から外部に出ることは一切ありません。
ハイレベルで見ると、オンプレミスのLLM Gatewayは以下を提供します:
標準化されたAPIの背後にモデルアクセスを抽象化することで、ゲートウェイはアプリケーション開発をモデルインフラから分離します。チームはアプリケーションコードを変更することなく、モデルの切り替え、微調整(ファインチューニング)されたバージョンの導入、新しいガバナンスルールの適用を行うことができます。
インフラが有限で、コンプライアンス要件が厳しく、運用の複雑さが高いオンプレミス環境において、この中央集権型ゲートウェイレイヤーこそが大規模なLLM導入を実現可能にする要素です。これにより、セルフホストされたモデルが隔離されたデプロイメントから、統制された本番運用可能なAIプラットフォームへと進化します。
Gateway評価の主要メトリクス
| 評価基準 | 評価すべき項目 | 優先度 | TrueFoundry |
|---|---|---|---|
| レイテンシ | 最初のトークンまでの時間(TTFT)のオーバーヘッドはp95で10ms未満か? | 必須(Must Have) | ✅ 対応済み |
| データレジデンシー | ログを指定地域(EU/米国)内に保持できるか? | ユースケースによる | ✅ 対応済み |
| レイテンシベースのルーティング | リアルタイムのレイテンシや障害に基づいて自動的に再ルーティングできるか? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーをローテーションまたは失効できるか? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーをローテーションまたは失効できるか? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーをローテーションまたは失効できるか? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーをローテーションまたは失効できるか? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーをローテーションまたは失効できるか? | 必須(Must Have) | ✅ 対応済み |

オンプレミスでLLMを運用することは、単なるインフラ上の選択にとどまりません。データ制御、セキュリティ、ガバナンスに関する譲れないエンタープライズ要件によって駆動されることが一般的です。LLM Gatewayは、これらのデプロイメントを大規模かつ実践的なものにします。
企業は、社内文書、顧客記録、ソースコード、機密データなどのデリケートな入力を扱うことが多々あります。規制の厳しい環境では、一時的なプロンプトデータであっても管理されたインフラを離れることは許されません。
オンプレミスLLM Gatewayにより、以下が保証されます:
これは、厳格なデータのローカライゼーションや主権要件の下で運用されている組織にとって特に重要です。
アプリケーションとモデルを直接統合すると、セキュリティ境界が細分化されてしまいます。各サービスが独自の認証情報、権限、アクセスロジックを管理することになり、一貫したセキュリティ基準の適用が難しくなります。
LLM Gatewayは以下を中央集権化します:
すべてのトラフィックを単一の制御レイヤー経由でルーティングすることにより、企業は攻撃対象領域(アタックサーフェス)を大幅に削減し、モデルへのアクセス方法に対する安全性を高めることができます。
規制フレームワークでは、企業に対して次のような問いへの回答を求めるケースが増えています:
オンプレミスLLM Gatewayは、デフォルトで監査トレイル機能を備えています。個々のアプリケーションチームがコンプライアンスロジックを正確に実装することに依存することなく、すべてのリクエストをログ記録、計測、追跡できます。
これは、GDPR、ITAR、HIPAA、または社内ガバナンス基準の対象となる環境に不可欠です。
オンプレミスのGPUリソースは有限であり高価です。集中制御がない場合、チームが推論キャパシティを過剰消費したり、効率の悪いワークロードをデプロイしたりする可能性があります。
LLM Gatewayが有効にする機能:
これにより、企業はLLM推論を制御不能な支出ではなく、管理されたリソースとして扱うことができます。
オンプレミスLLM Gatewayは単一のサービスではありません。企業環境内でモデルがどのようにアクセスされ、統制され、運用されるかを制御するために設計された多層構造のインフラストラクチャスタックです。
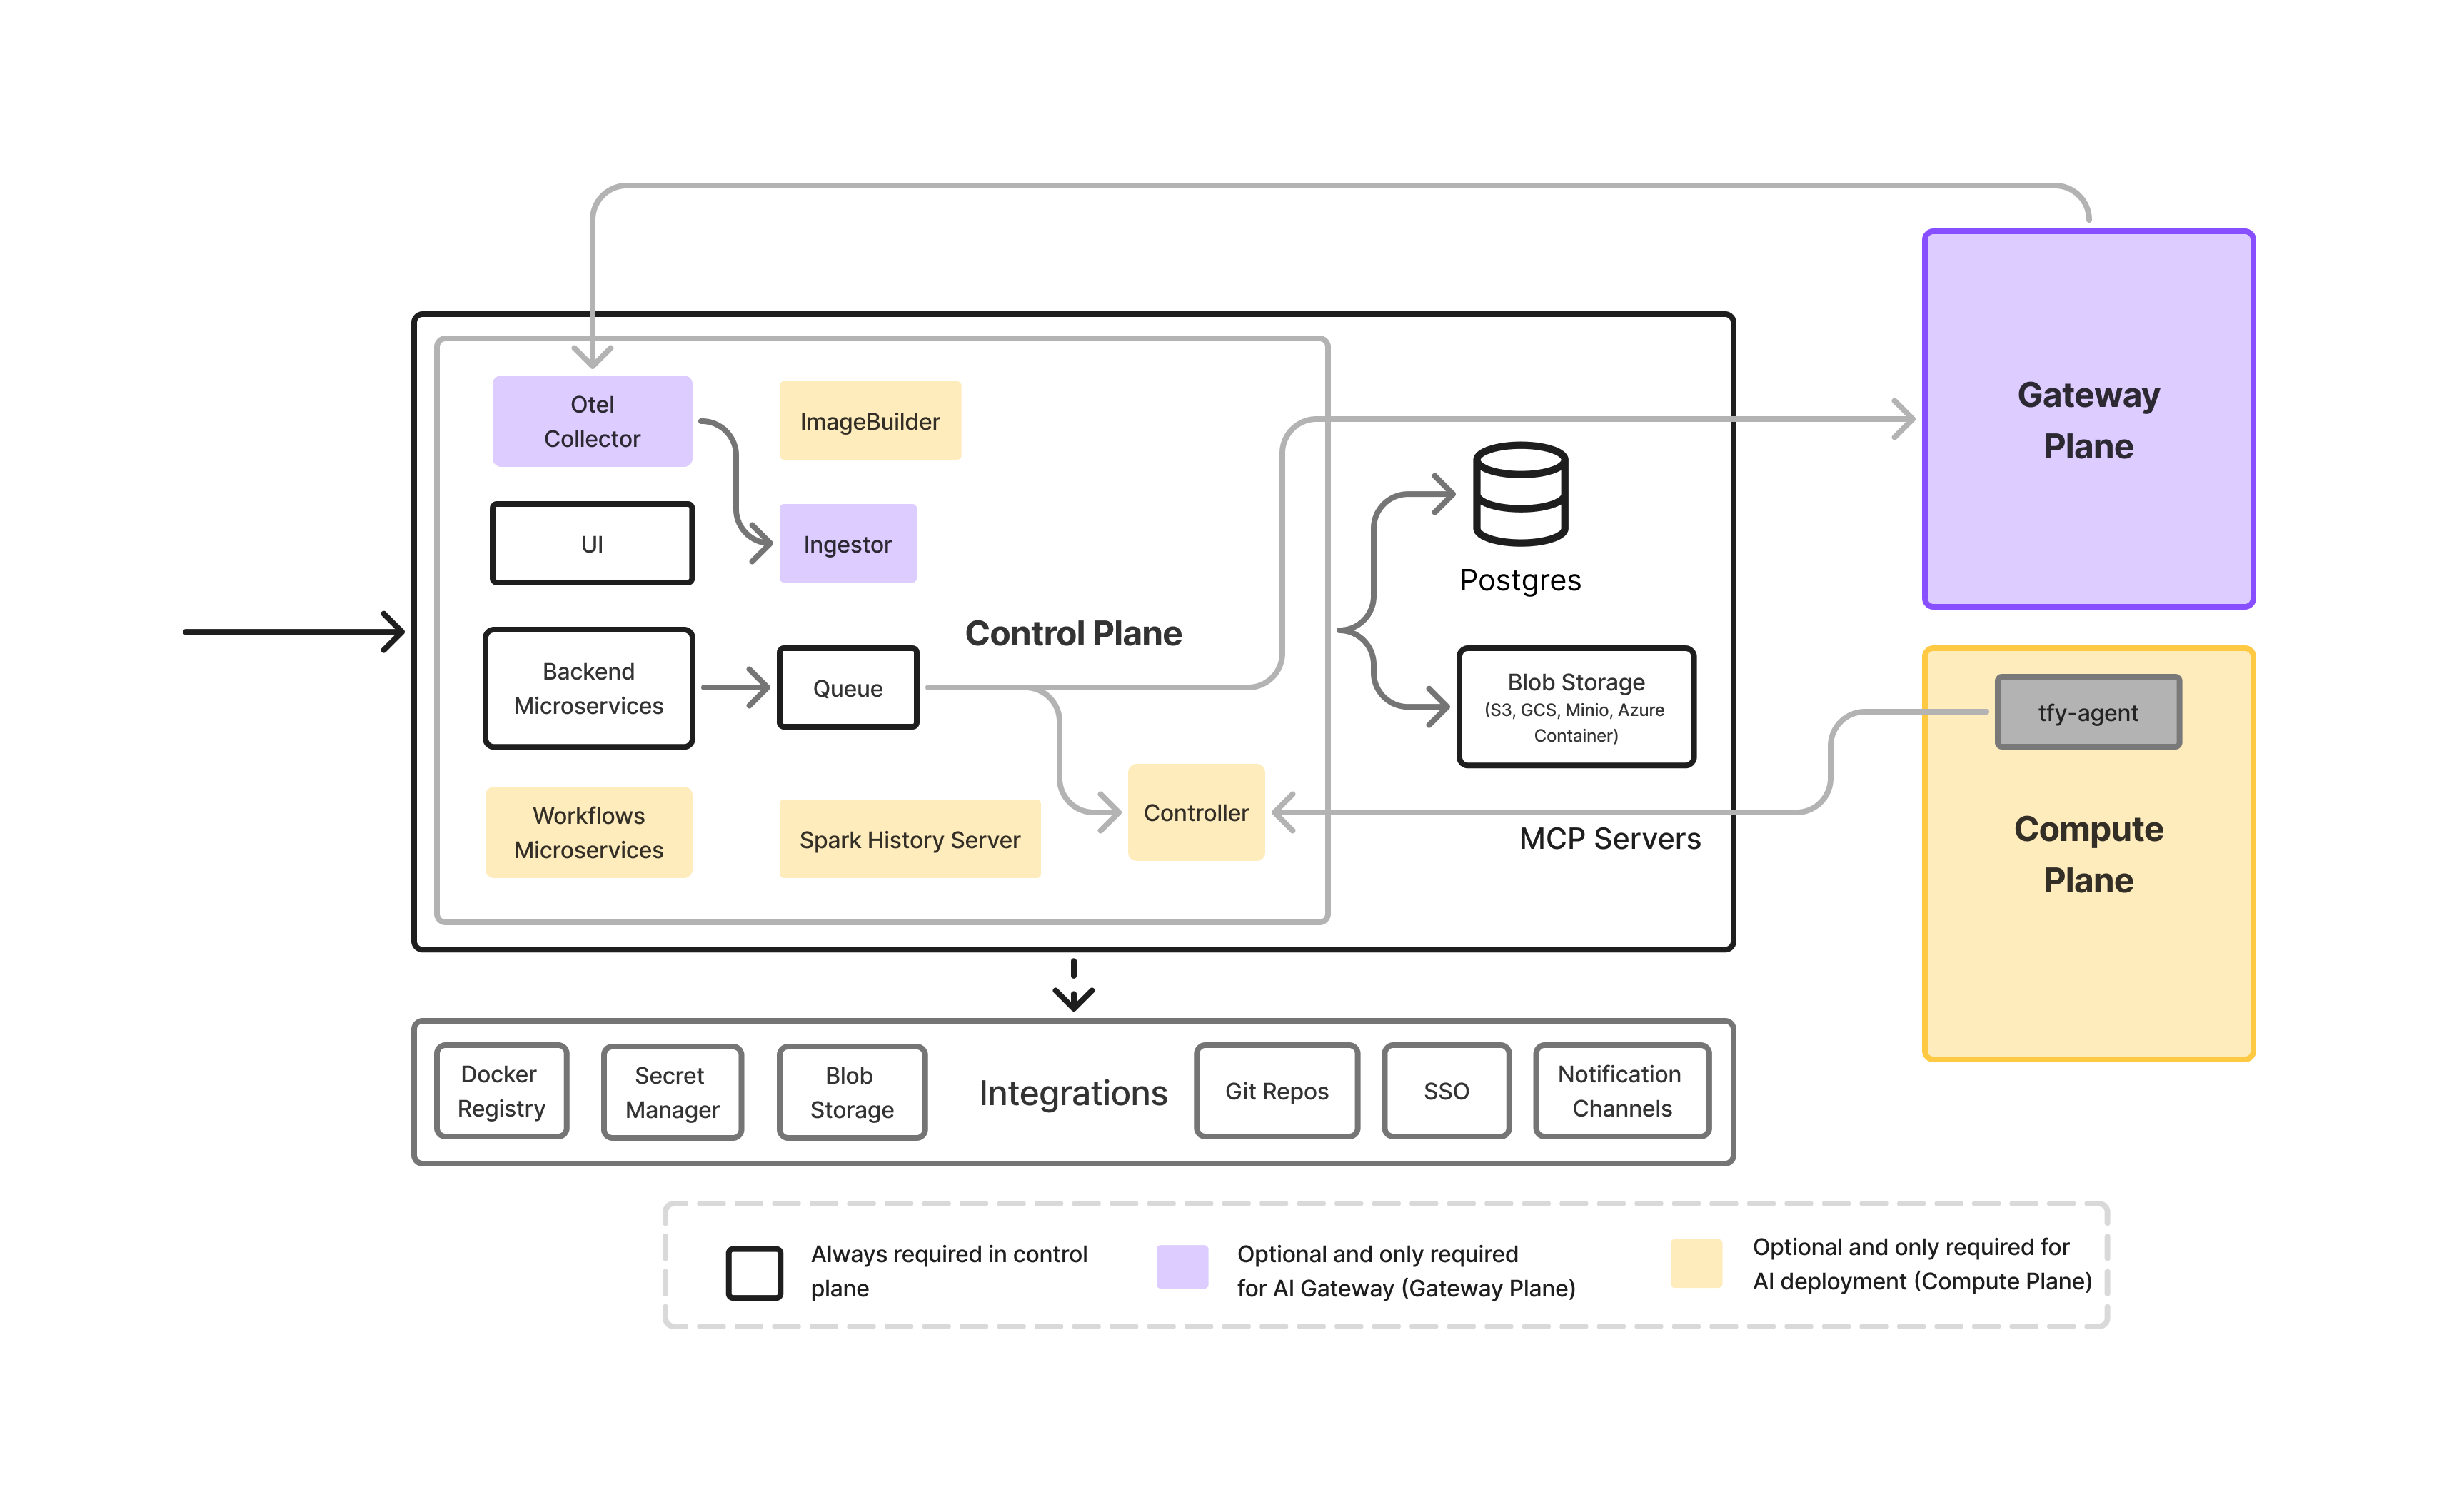
これはすべてのLLMトラフィックの正面玄関です。
認証、認可、リクエストの検証、およびルーティングの決定を処理します。ポリシーを集中適用することで、コントロールプレーンはアプリケーションチームがコード内にセキュリティやガバナンスのロジックを埋め込む必要性を排除します。
このレイヤーはモデルサービングを担当し、オンプレミスで実行されている実際のLLMをホストし、以下を含む低レイテンシでGPUアクセラレーションされた推論用に公開します:
ゲートウェイはこれらのモデルを統一されたAPIの背後に抽象化し、チームがアプリケーションに影響を与えることなくモデルを変更またはアップグレードできるようにします。
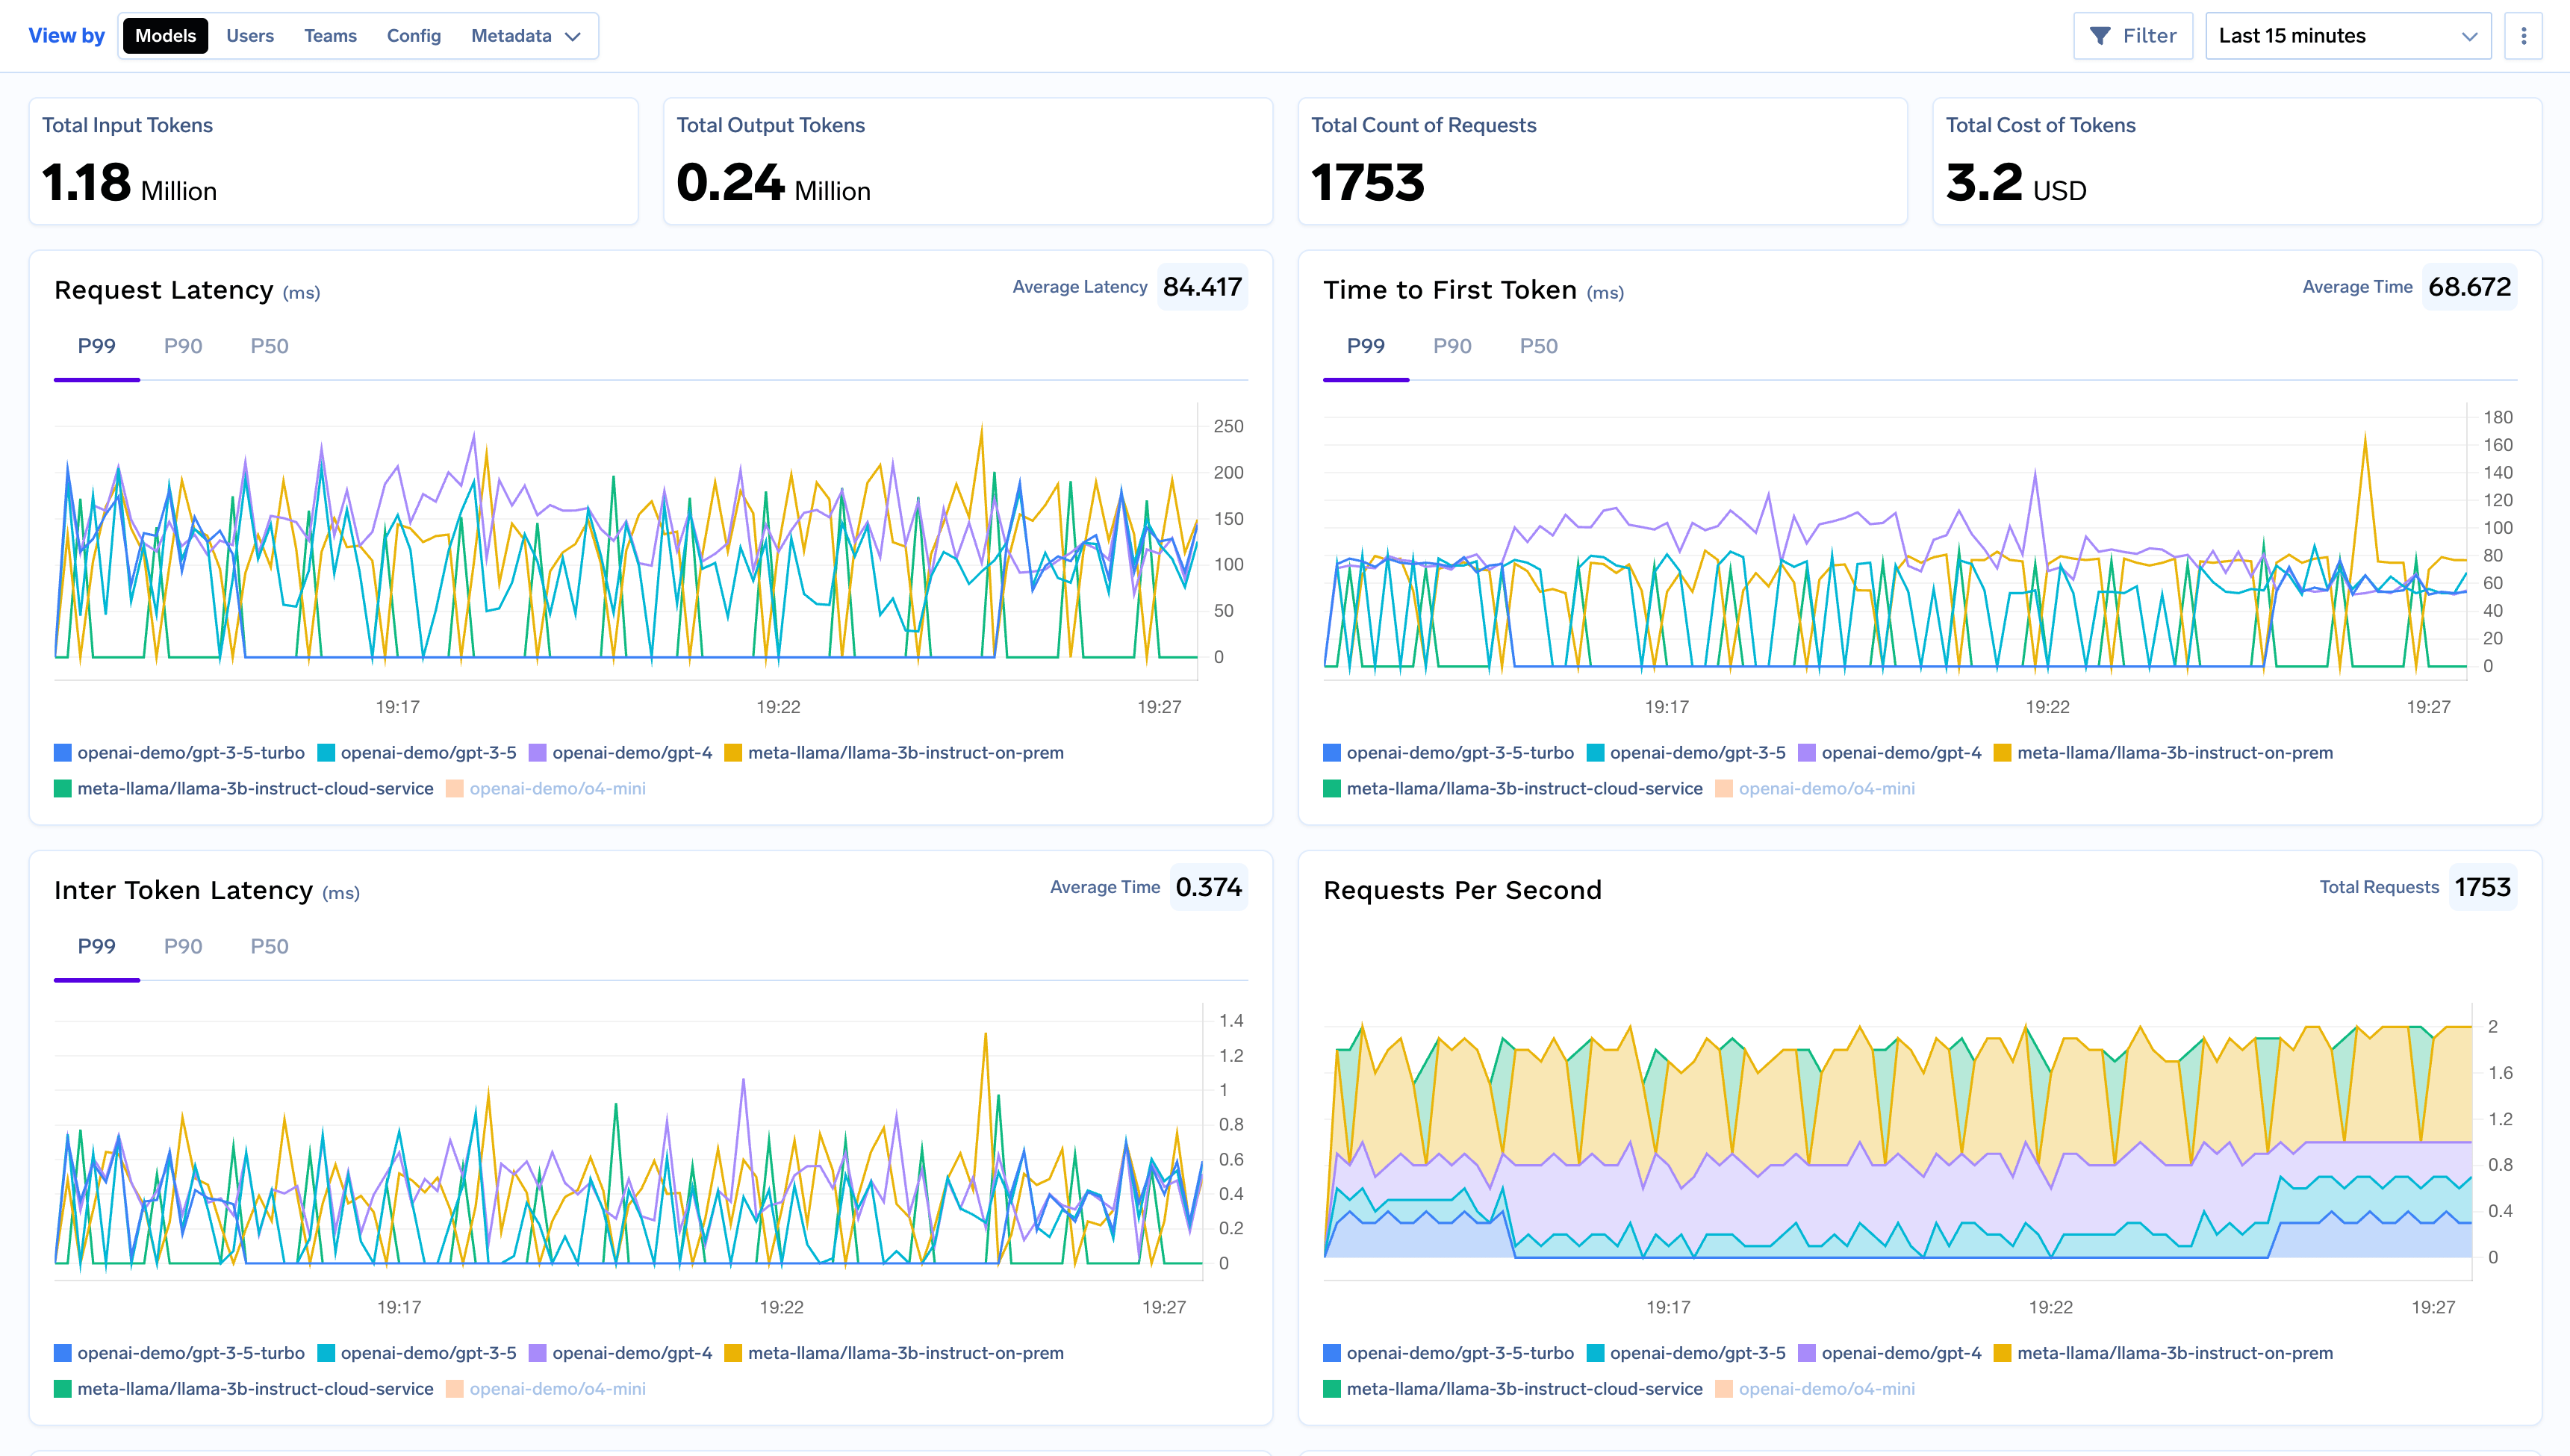
リソースが限られているオンプレミス環境では、可視性が非常に重要です。
ゲートウェイが提供する機能:
これにより、チームはモデルがどのように使用されているかを把握し、パフォーマンスやコストの問題を早期に特定できます。
ガバナンスルールは一度定義されれば、あらゆる場所で適用されます。
これには以下が含まれます:
中央集権型のガバナンスにより、チームやアプリケーション間でのポリシーの乖離(ドリフト)を防ぎます。
ゲートウェイとモデルサービスは通常、GPUをサポートしたKubernetesベースのインフラストラクチャ上で動作します。このレイヤーが提供するもの:
広範なオンプレミスAIスタックの一部として、ゲートウェイが信頼性高く動作することを保証します。
オンプレミス環境において、LLM Gatewayはアプリケーションとセルフホスト型モデルの間の中央制御レイヤーとして機能します。すべてのリクエストはこのレイヤーを通過し、一貫したセキュリティ、ガバナンス、オブザーバビリティを維持します。
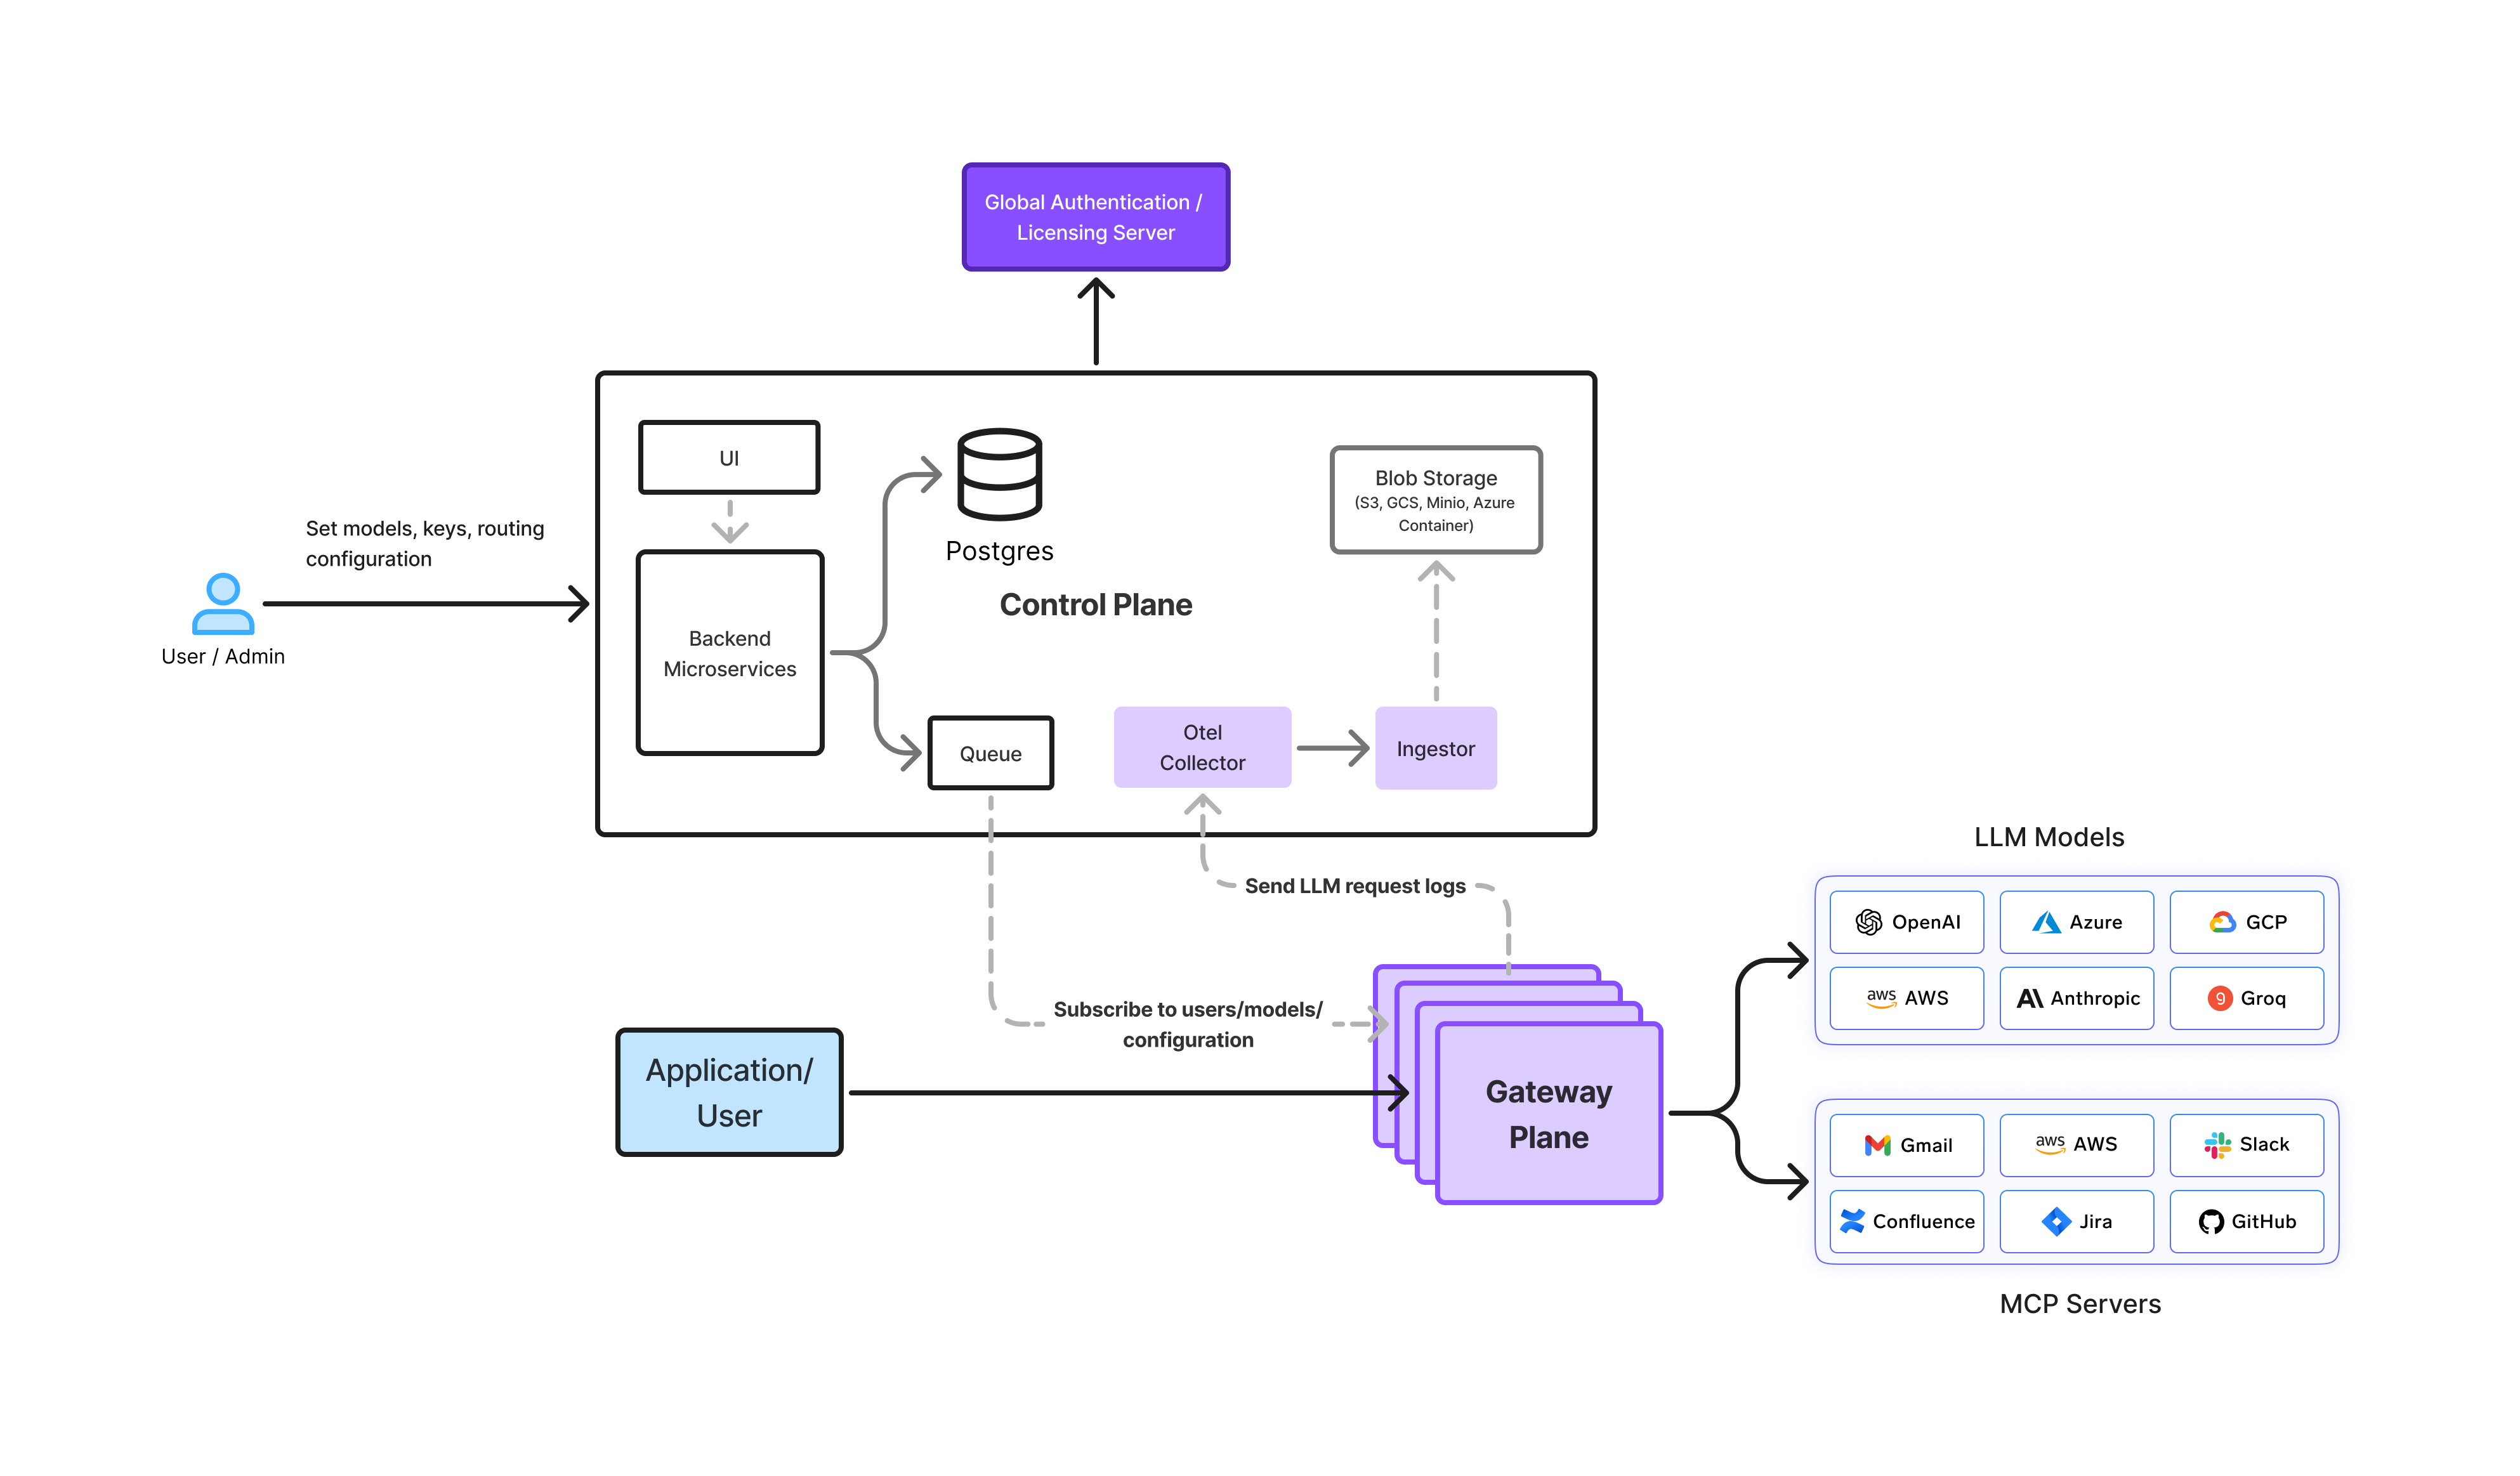
企業は、セキュリティ、コンプライアンス、および接続性の要件に応じて、さまざまな方法でオンプレミスLLM Gatewayをデプロイします。ゲートウェイのアーキテクチャ自体は同じですが、デプロイモデルが変化します。
非常に厳格な規制環境では、インフラストラクチャは外部ネットワーク接続なしで運用されます。
これらの構成において、LLM Gatewayは厳密な分離要件を満たしながら完全な制御を提供します。
多くの企業は、独自のクラウドアカウントまたはプライベートネットワーク内にLLM Gatewayをデプロイしています。
このモデルは、規制対象となるSaaSや金融サービス企業で一般的です。
機密性に基づいてワークロードを分割する組織もあります。
ゲートウェイにより、複数の実行環境が混在している場合でも一貫したポリシーが保証されます。
オンプレミスLLM Gatewayは高度な制御とコンプライアンスをもたらす一方で、企業が事前に対策を講じるべき運用の課題も生み出します。
GPUに支えられた推論ワークロードをオンプレミスで管理するには、周到なキャパシティ計画が必要です。自動化が行き届いていない場合、モデルのスケーリングやトラフィック急増への対応が運用上の大きな負担となる可能性があります。
オンプレミス環境のリソースは有限です。不適切なルーティングやリクエスト制御の欠如は、レイテンシの問題やGPUの低利用率につながります。パフォーマンスと効率性のバランスをとるには、トラフィックの一元管理が不可欠です。
複数のチームがLLMを採用するにつれて、アプリケーションレベルでルールを適用しているとガバナンスルールが容易に形骸化・分散してしまいます。集中型ゲートウェイなしで環境全体のアクセス制御や使用ポリシーを一貫して維持することは困難です。
企業は、ストレージを圧迫したりパフォーマンスを低下させたりすることなく、LLMの使用に関する明確な記録を保持する必要があります。オブザーバビリティとオーバーヘッドの最適なバランスを見つけることは共通の課題です。
オンプレミスLLMのデプロイに成功している企業は、ゲートウェイを単なるAPIプロキシではなく中核となるインフラストラクチャとして扱っています。
すべてのアプリケーションとエージェントは、必ずゲートウェイ経由でモデルにアクセスさせるべきです。これにより、シャドー統合を排除し、一貫したセキュリティとガバナンスを確保できます。
アプリケーションが特定モデルのエンドポイントに依存する設計は避けるべきです。ゲートウェイの背後にモデルを抽象化することで、チームはコード変更なしにモデルの交換、更新、またはファインチューニングを行えるようになります。
アクセス制御、レート制限、使用ルールはアプリケーションのロジック内ではなく、ゲートウェイレイヤーに配置すべきです。これにより、チームや環境間でのポリシーの乖離を防ぎます。
開発、ステージング、本番環境は、インフラおよびポリシーレベルで完全に分離する必要があります。これによりリスクが軽減され、より安全に実験を行えるようになります。
監査や最適化のために十分なテレメトリを収集しつつ、必要に応じて機密性の高いプロンプトデータをマスキングまたは制限します。オブザーバビリティは制御を可能にするためのものであり、新たなリスクを生み出すものであってはなりません。
これらの実践に従うことで、導入が進んでもオンプレミスのLLM Gatewayを安全かつスケーラブルで管理しやすい状態に維持できます。
企業が実験段階を終え、大規模言語モデルを中核システムに組み込むようになるにつれて、「制御(コントロール)」は機能と同等に重要になります。オンプレミスデプロイメントはデータレジデンシー、セキュリティ、コンプライアンスのニーズに対応しますが、中央集権型のアクセスレイヤーがなければ、すぐに断片化しガバナンスが困難になります。
オンプレミスインフラにおけるLLM Gatewayは、その欠けているコントロールプレーンを提供します。アプリケーションとモデルのやり取りを標準化し、一貫したポリシーを適用し、規模に応じた責任あるLLM運用に必要な可視性をもたらします。
オンプレミスデプロイメントに最適なLLM Gatewayを選択するには、単なるリクエストルーティングだけでなく、ガバナンス、パフォーマンス、運用のシンプルさのバランスを考慮することが求められます。
セルフホストされたモデルを孤立したサービスとして扱うのではなく、ゲートウェイファーストのアプローチを採用する組織は、LLMを安全で観察可能、かつ長期的な成長に対応した管理されたエンタープライズインフラへと転換させることができます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























