August 27, 2025
|
5 min read



Blazingly fast way to build, track and deploy your models!
Kubernetes環境におけるスケーラブルなMachine Learningインフラストラクチャの構築とセットアップに関する本シリーズへようこそ。このシリーズでは、Kubernetesクラスタ上でのmachine learningモデルの開発、デプロイ、管理に関連するさまざまなトピックを網羅していきます。
一般的にMLOpsとして知られるMachine Learning Operationsは、machine learningモデルのライフサイクルを管理するために使用されるプラクティスと手法を指します。スケーラブルなMachine Learning Opsインフラストラクチャにより、組織はモデルを大規模に構築、デプロイ、管理できるようになり、データサイエンスへの投資対効果(ROI)を高めることができます。
スケーラブルなMLOpsインフラストラクチャのメリットは以下の通りです:
Airbnbは、初期段階からスケーラブルなMLOpsプラクティスの構築に大規模な投資を行いました。ユーザーデータに基づく検索を通じて検索ランキングアルゴリズムを向上させるためにmachine learningモデルを活用し、その結果、検索体験が向上し、予約数が推定10%増加しました。また、Airbnbはユーザーにパーソナライズされたおすすめを提供するためにもmachine learningモデルを活用しており、ユーザー体験とエンゲージメントの向上に貢献しました!
MLのトレーニングおよびデプロイ用インフラストラクチャの構築において、AWS、Google Cloud Platform(GCP)、Microsoft AzureなどのVirtual Machine(VM)に依存している組織は、いくつかの課題に直面する可能性があります:
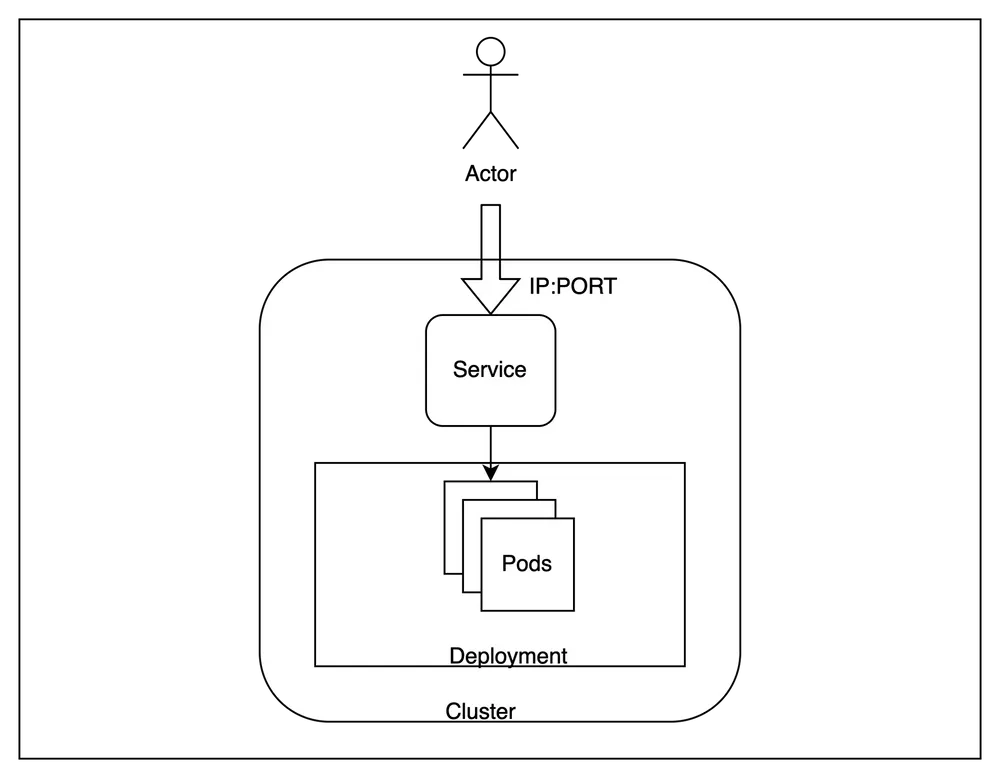
Kubernetesは、コンテナ化されたアプリケーションのデプロイ、スケーリング、管理を自動化する人気のあるオープンソースのコンテナオーケストレーションプラットフォームです。統合されたAPIと宣言的な設定を提供してコンテナ化されたワークロードの管理を簡素化し、組織がMLモデルのトレーニングやデプロイのためのスケーラブルでレジリエント、かつポータブルなインフラを構築できるようにします。Kubernetesは、素のVMと比較して、リソース利用効率の向上、バージョン管理の簡素化、効率的なスケーリングなど、多くのメリットを提供します。さらに、Kubernetesは組み込みのセキュリティ機能や集中型のモニタリングおよびロギング機能を提供しており、組織がMLインフラのセキュリティと信頼性を確保するのに役立ちます。Kubernetesは、長期的にスケーラブルなMachine Learningパイプラインの構築を目指す組織にとって素晴らしい選択肢です。
クラウドプロバイダー(AWS、GCP、Azure)はマネージドKubernetesサービス(それぞれEKS、GKE、AKS)を提供しており、組織はKubernetesクラスタのセットアップ、設定、管理を容易に行うことができます。これにより、Kubernetesの運用やスケーリングに伴う運用オーバーヘッドが削減されます。さらに、クラウドプロバイダーはストレージ、データベース、ネットワーキングなどの他のクラウドサービスとの統合も提供しており、Kubernetes上でのMLワークロードのデプロイと管理をさらに簡素化できます。直接的であれマネージドサービス経由であれKubernetesを採用することで、組織は増大するMLワークロードに対応し、MLモデルの迅速な市場投入を可能にする柔軟でスケーラブルなMLOpsパイプラインを構築できます。
MLトレーニングおよびデプロイパイプラインでKubernetesを使用するメリットについて、さらに詳しく見ていきましょう。
ユースケース例 1:Airbnb
Airbnbは、個人の自宅やアパートを旅行者に貸し出すオンラインマーケットプレイスです。何百万人ものユーザーと分析すべき膨大なデータを抱えるAirbnbは、ユーザー行動を分析し、検索ランキングを向上させ、パーソナライズされたおすすめを提供するために、堅牢でスケーラブルなmachine learningインフラストラクチャを必要としていました。
これを提供するため、AirbnbはKubernetes上にMLOpsインフラストラクチャを構築することに投資し、データサイエンスチームがmachine learningモデルを大規模に開発・デプロイできるようにしました。Kubernetesを使用することで、Airbnbはモデルをコンテナ化してマイクロサービスとしてデプロイできるようになり、ニーズの成長に合わせてインフラの管理やスケーリングを行うことが容易になりました。結果として、Airbnbは検索ランキングを改善し、ユーザーに、より関連性の高いおすすめを提供できるようになり、予約数の増加と収益の向上につながりました。さらに、同社はデータサイエンスワークフローの効率を改善し、チームがより高度なmachine learningモデルの開発に集中できるようになりました。
ユースケース例 2:Lyft
Transportation as a SaaS (TaaS)の大手プロバイダーであるLyftは、当初EC2インスタンスとDockerコンテナを組み合わせて、AWSの上にMLインフラストラクチャを構築していました。特定のMLワークロード要求に応じて、異なるレベルのCPU、メモリ、GPUリソースを持つ仮想マシンをプロビジョニングするためにEC2インスタンスを使用していました。また、MLワークロードをパッケージ化してデプロイし、異なる環境間での一貫性を確保するためにDockerコンテナを使用していました。
しかし、LyftのMLワークロードの複雑さと規模が増大するにつれ、異なる環境やチーム間での一貫性の維持など、いくつかの課題に直面しました。そのため、当初はKubeFlowを、その後は自社開発プラットフォームを使用して、MLインフラをKubernetesベースのインフラに移行することを決定しました。Kubernetesベースのインフラに移行したことで、Lyftはより効率的でスケーラブルなMLインフラを構築でき、MLの開発およびデプロイパイプラインを加速させることができました。さらに、オートスケーリングや効率的なリソース利用といったKubernetesのメリットを活用して、MLワークロードを最適化し、インフラコストを削減することができました。マネージドKubernetesサービスとしては、AWSのEKSを使用しました!
全体として、Kubernetes上のMLOpsインフラストラクチャに投資したことで、AirbnbとLyftは大きな生産性の向上を達成し、最終利益を改善することができました。これは、Kubernetes上のスケーラブルなMLOpsが、machine learningを大規模に活用しようとしている組織にもたらす価値を実証しています。
多くのメリットがある一方で、MLインフラストラクチャにKubernetesを使用することには、独自の課題や複雑さも伴います:
課題は存在するものの、ベストプラクティスに従いKubernetesの機能を活用することで、組織はこれらの課題を克服し、スケーラブルで安全かつ信頼性の高いMLOpsインフラストラクチャを構築できます。
Machine LearningのためのKubernetesは、machine learningワークフローの最適化を目指す組織に数多くの優位性を提供します。Kubernetes上でMLOpsインフラストラクチャを構築・管理することには、リソース管理、セキュリティ、モニタリングなどの課題が存在しますが、Kubernetesとベストプラクティスを深く理解することで、これらの障害を克服することができます。
Kubernetes上のMLに関する本シリーズでは、以下を含むKubernetes環境でのMLインフラ構築とセットアップに関連するさまざまなトピックをカバーしていく予定です:
その他多数...
これらのベストプラクティスを採用し、Kubernetesの力を活用することで、組織は一貫性、信頼性、セキュリティを維持しながらmachine learningモデルをスケールし、デプロイできます。これにより、市場投入の高速化、データサイエンスチームとIT運用チームのコラボレーション向上、そしてデータサイエンス投資におけるROIの改善が実現されます。
GongがKubernetes上にスケーラブルなMachine Learningリサーチインフラを構築した方法をご覧ください
TrueFoundryは、Kubernetes上で動作するMLデプロイPaaSであり、インフラチームの完全なセキュリティと制御を保証しながら、開発者がモデルのテストやデプロイを完全な柔軟性をもって行えるようにして、そのワークフローを加速させます。当社のプラットフォームを通じて、Machine learningチームは100%の信頼性とスケーラビリティ、そして数秒でのロールバック機能を備えた状態で15分以内にモデルをデプロイおよび監視できるようにし、コストの削減と本番環境へのモデルのより迅速なリリースを実現して、真のビジネス価値の創出を可能にします。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.