August 27, 2025
|
5 min read


Blazingly fast way to build, track and deploy your models!
前回の記事では、データサイエンティストのワークフローと、そのためのプラットフォームを構築する上でKubernetesが具体的にどこで有用な基盤となり得るかについて解説しました。
今回の記事では、ハンズオンの経験を得るためにシンプルな例を使って進めていきましょう。
始める前に、デモを実行するためのプレイグラウンドが必要です。これを行うために、ローカルマシン上にKubernetesクラスタをセットアップします。本来、クラスタは耐障害性と高可用性のために複数のノードを含む必要がありますが、素晴らしいツールであるkind (kubernetes-in-docker)を使用してその動作を擬似的に再現します。
このセクションの終わりには、複数のコンテナが実行され、それぞれのコンテナが個別のクラスタノードとして機能するようになります。
こちらに記載されている手順に従ってください。
以下を実行してインストールをテストします。
$ kind --version
kind version 0.14.0
次に、kindを使用してローカルクラスタを起動します。1つのcontrol planeノードと2つのworkerノードを作成します。両方を複数持つことも可能です。
<aside> 💡 Kubernetesは複数のcontrol planeノードとworkerノードを持つことができます。集中管理を行うすべてのクラスタコンポーネントはcontrol planeノード上に配置され、ユーザーのワークロードはworkerノード上で実行されます。詳細はこちらを参照してください。
</aside>
まず、kind-config.yamlというファイルにkind構成を作成します。ファイルはこちらにあります。これにより、クラスタの構造が定義されます -
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
nodes:
- role: control-plane
- role: worker
- role: worker
ここでは、3つのノードを定義し、1つをcontrol planeの役割、残り2つをworkerノードとして割り当てています。
この設定を使用してクラスタを起動します。これには少し時間がかかる場合があります。実行する前にシステム上でDockerデーモンが起動していることを確認してください -
$ kind create cluster --config kind-config.yaml
...
Thanks for using kind! 😊
kubectlを実行してクラスタが稼働していることを確認しましょう -$ kubectl cluster-info
Kubernetes control plane is running at <https://127.0.0.1:63122>
CoreDNS is running at <https://127.0.0.1:63122/api/v1/namespaces/kube-system/services/kube-dns:dns/proxy>
...
これにより、クラスタが実際に稼働していることが確認できます。また、docker psを実行することで、個々のコンテナがノードとして機能している様子も確認できます。
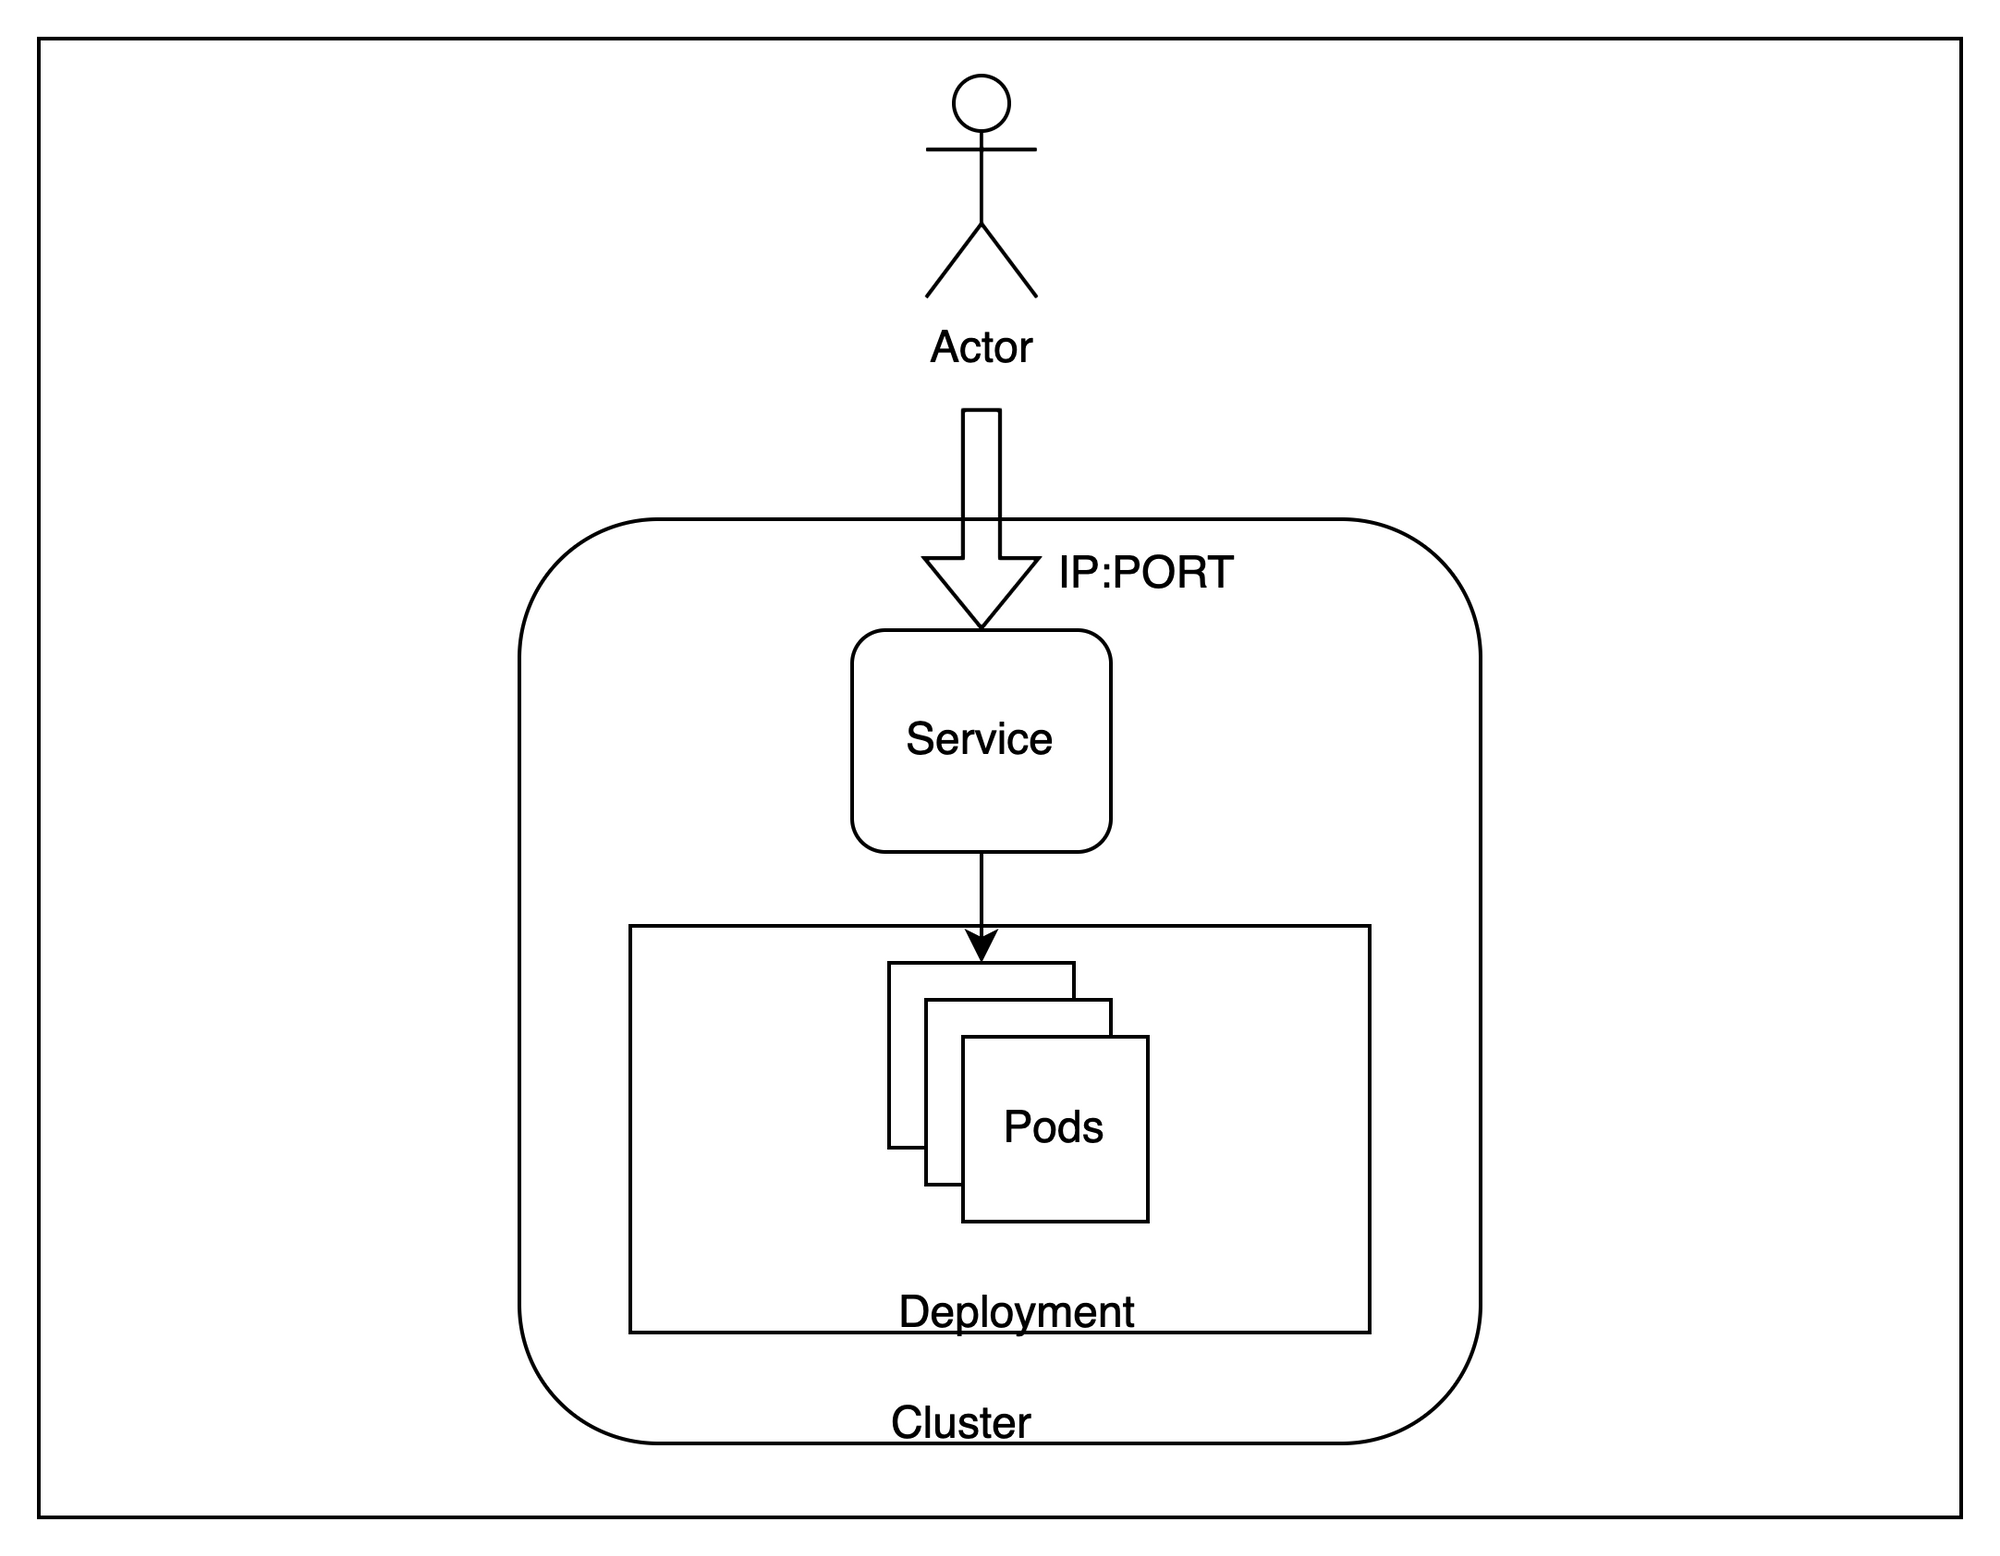
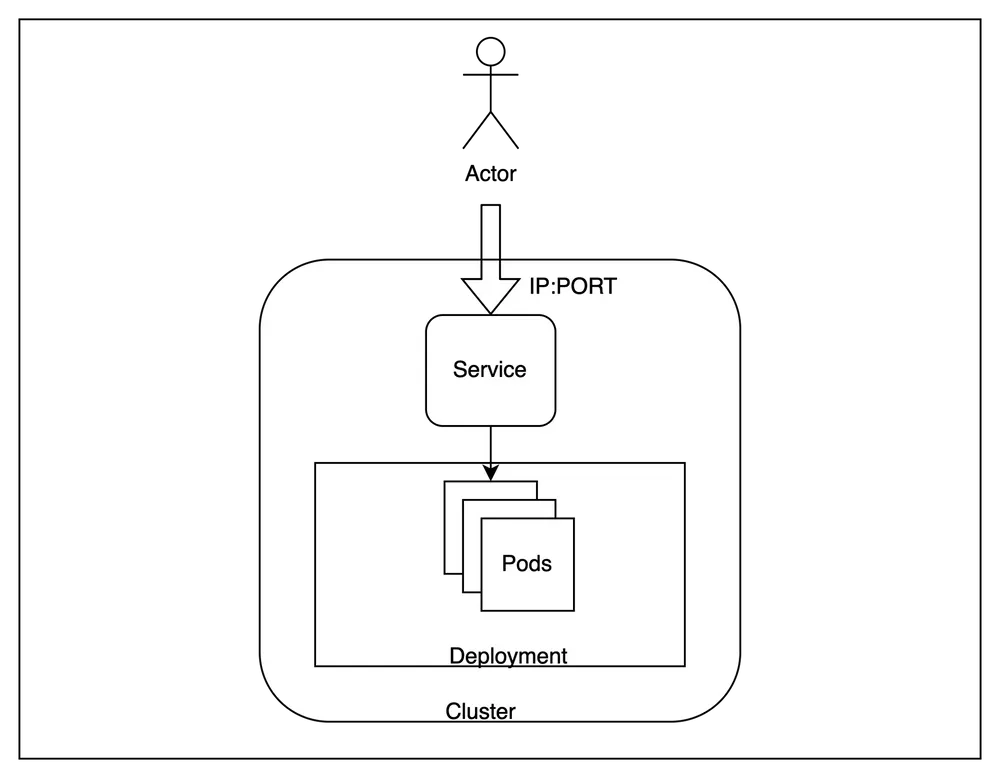
クラスタが起動したので、これからプロビジョニングする構成の大まかなアーキテクチャを見てみましょう。
大まかに言えば、クラスタ内にアプリケーションの複数のレプリカをホストし、異なるインスタンス間でリクエストがロードバランスされた状態で外部からアクセスできるようにします。
これを実現するには、理解しておくべきいくつかのKubernetes固有の用語があります -
Pod - Podは、Kubernetesで作成および管理できる最小のデプロイ可能計算単位です。今回のケースでは、アプリケーションの1つのインスタンスが1つの独立したPod内で実行されます。これらは一時的(エフェメラル)なリソースであり、必要に応じてcontrol planeがノード間で移動させることができます。Deployment - Deploymentは、アプリケーションのレプリカを複数持ちたい場合に役立ちます。Kubernetesは常にレプリカの数がDeploymentで指定された値と等しくなるよう維持しようとします。アプリケーション用に3つの同一のレプリカを作成します。Service - Serviceは、クラスタ上で実行されている一連のPod間でロードバランスを行うのに役立ちます。Podは本質的に一時的であり、いつでも置き換えられる可能性があるため、Serviceはその後ろで実行されているPodにアクセスするための安定したインターフェースを提供します。アプリケーションのテストにはServiceを使用します。これら3つのリソースにより、アプリケーションを配信するためのスケーラブルなエンドポイントをホストできるようになります。
クラスタが起動したら、アプリケーションをデプロイしてテストできます。人気の高いIris分類器データセットを使用してアプリケーションを作成します。
リポジトリはhttps://github.com/shubham-rai-tf/iris-classifier-kubernetesで公開されています。ここには、fastapiを使用して/iris/classify_irisエンドポイントで予測を構築および配信するためのコードがすでに含まれています。
kubernetesに向けて準備するために、このコードをDockerイメージにパッケージ化する必要があります。そのためのDockerfileがリポジトリ(こちら)に用意されています。
このDockerfileは、ポート5000のuvicornサーバーで予測エンドポイントをホストするコンテナを作成するために必要なイメージを指定しています。構文の詳細はこちらで確認できます。
以下のコマンドを実行してローカルイメージをビルドします -
$ docker build . -t iris-classifier:poc
...
$ docker image ls
REPOSITORY       TAG  IMAGE ID      CREATED         SIZE
iris-classifier  poc  549913d5b1f9  12 seconds ago  737MB
名前がiris-classifier、タグがpocのイメージが正常に作成されたことが確認できます。次に、このイメージをクラスタ内で使用するためにクラスタへロードします。
<aside> 💡 新しくビルドしたイメージをプルするためのイメージレジストリがないため、このステップが必要となります。本番環境では、イメージはDockerhubやAWS ECRのようなプライベートレジストリにホストされ、そこからクラスタへ直接プルされるべきです。
</aside>
以下のコマンドを実行して、ローカルでビルドしたイメージをクラスタにロードします -
$ kind load docker-image iris-classifier:poc
Image: "iris-classifier:poc" with ID "sha256:549913d5b1f9456a4beedc73e04c3c0ad70da8691a8745a6b56a4f483c4f0862" not yet present on node "kind-worker2", loading...
Image: "iris-classifier:poc" with ID "sha256:549913d5b1f9456a4beedc73e04c3c0ad70da8691a8745a6b56a4f483c4f0862" not yet present on node "kind-control-plane", loading...
...
3つのコンテナのいずれかでイメージを一覧表示することにより、イメージがロードされたことを確認できます -
$ docker exec -it kind-worker crictl images
IMAGE                                TAG    IMAGE ID         SIZE
docker.io/library/iris-classifier    poc    549913d5b1f94    753MB
Kubernetesは本質的に宣言型のシステムです。つまり、実行したいことの概要を記述すると、control planeコンポーネントが常にその状態に到達するようシステムを動かします。
前述したアーキテクチャを実装するために、意図の記録として機能するyamlファイルの形式で意図を記述します。Kubernetesの用語では、これらはmanifestsと呼ばれます。
すべてのKubernetesマニフェストには以下のフィールドがあります -
apiVersion - 複数のリソースが同じAPIバージョン内にグループ化されます。これにより、Kubernetesのバージョン間でリソースを廃止または昇格させる標準化された方法が提供されます。kind - 作成される正確なオブジェクトタイプを識別します。metadata - 作成されたオブジェクトのメタデータとして機能するフィールドを含みます。apiVersion、kind、およびmetadata.nameフィールドは、namespace内のユニークなリソースをまとめて識別します。spec - このフィールドには、作成されるオブジェクトの仕様(スペック)が含まれます。各kindは独自の実装を持つこのフィールドの構造を独自に定義します。リポジトリ内のmanifestsディレクトリ(こちら)にあるファイル内のマニフェストを使用します。
これは、deployment.yamlとservice.yamlでそれぞれDeploymentとServiceという2つのKubernetesリソースを定義しています。両方のセクションを見ていきましょう。
apiVersion: apps/v1
kind: Deployment
spec:
	# number of replicas
  replicas: 3
  template:
    spec:
      containers:
			# name of the image
      - image: iris-classifier:poc
        name: iris-classifier
deployment.yaml内のDeploymentマニフェストは、主にデプロイしたいPodスペックをイメージ名とレプリカ数の観点から定義しています。これを適用すると、Kubernetesはここで指定したレプリカ数を維持するための手順を継続的に実行します。
apiVersion: v1
kind: Service
spec:
	# Type of the service
  type: ClusterIP
  ports:
	# Port where the service will be accessible
  - port: 8080
		# Port on the container where the traffic is to be forwarded
    targetPort: 5000
    protocol: TCP
  selector:
    app: iris-classifier
service.yaml内のServiceマニフェストは、Deploymentによって作成されたレプリカ間でどのようにロードバランスするかを定義しています。ここでは、Service上のポートをコンテナ上のポートにマッピングする方法を定義しています。アプリケーションはポート5000で動作するため、targetPortは5000に設定されています。Serviceはポート8080で公開されます。8080に送信されたTCPトラフィックは、コンテナ上のポート5000へロードバランスされます。
以下のコマンドを実行して、マニフェストをKubernetesに適用します -
$ kubectl apply -f manifests/
deployment.apps/iris-classifier created
service/iris-classifier created
両方のリソースがクラスタ上に正常に作成されました。以下のコマンドを実行して確認できます -
$ kubectl get service iris-classifier
NAME              TYPE        CLUSTER-IP      EXTERNAL-IP   PORT(S)    AGE
iris-classifier   ClusterIP   10.96.107.238   <none>        8080/TCP   37m
$ kubectl get deployment iris-classifier
NAME              READY   UP-TO-DATE   AVAILABLE   AGE
iris-classifier   3/3     3            3           38m
$ kubectl get pods
NAME                               READY   STATUS    RESTARTS   AGE
iris-classifier-5d97498ff9-77wqw   1/1     Running   0          39m
iris-classifier-5d97498ff9-8twjm   1/1     Running   0          39m
iris-classifier-5d97498ff9-znrz8   1/1     Running   0          39m
確認できる通り、Serviceはポート8080で公開され、指定通り3つのPodが作成されています。
deployment.yamlを編集してレプリカ数を3から2に変更し、再適用してみてください。Kubernetesはスペックに合わせるためにレプリカの1つを削除します。
リソースがクラスタ内に作成されたので、Serviceエンドポイントを使用してモデルを呼び出し、デプロイメントを検証できます。ローカルセットアップを使用しているため、Serviceをローカルマシンのポートにport-forwardする必要があります。
<aside> 💡 クラウドプロバイダーのセットアップでは、このServiceは外部ロードバランサーにバインドされ、必要に応じてインターネットからアクセスできるようになります。
</aside>
以下のコマンドを実行して、Serviceのポートフォワーディングを行います -
$ kubectl port-forward services/iris-classifier 8080
Forwarding from 127.0.0.1:8080 -> 5000
Forwarding from [::1]:8080 -> 5000
モデルの/healthcheckエンドポイントを呼び出して確認できます -
$ curl '<http://localhost:8080/healthcheck>'
"Iris classifier is ready!"
テスト予測を実行するために、サンプル入力を送信して予測を取得します -
$ curl '<http://localhost:8080/iris/classify_iris>' -X POST \\
	-H 'Content-Type: application/json' \\
	-d '{"sepal_length": 2, "sepal_width": 4, "petal_length": 2, "petal_width": 4}'
{"class":"setosa","probability":0.99}
99%の確率でクラスsetosaの予測が得られます。これらの予測を複数回実行することで、リクエストが実際にラウンドロビン方式で異なるPodにルーティングされていることを確認できます。
まず、インストールしたすべてのKubernetesリソースを削除しましょう -
$ kubectl delete -f manifests/
これにより、前のセクションで作成したすべてのKubernetesリソースがクリーンアップされます。これでクラスタも停止できます -
$ kind delete cluster
Deleting cluster "kind" ...
今回の記事では、Kubernetes上でモデルを呼び出し可能なサービスとしてホストする方法について解説しました。今回はローカルでDockerイメージをビルドし、同じマシン上で実行されているクラスタ上で実行するトイストレージの例でしたが、典型的な本番環境のセットアップも同様の原則で動作します。これら2つのリソースだけで多くのことを達成できます。
今後の記事では、Day 2オペレーションに移行する際に不可欠となる、マルチテナンシーやアクセス制御などのその他のより高度な機能を探求していきます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.