



November 5, 2025
|
5 min read


Blazingly fast way to build, track and deploy your models!
近年、機械学習のユースケースが急速に拡大する中で、モデルのトレーニング、デプロイ、モニタリングに関連する運用をスケーリングする必要性が極めて重要になっています。これらの課題の多くは、一般的なソフトウェアのユースケースですでに「解決」された問題と類似しています。Kubernetesは、基盤プラットフォームとして機能することで、基盤となるクラウドネイティブエコシステムを統合してきたオープンソースソフトウェアの代表例です。
そのため、機械学習のユースケースにおいてKubernetesを活用することが有効かどうかを検証することが不可欠となります。まずはKubernetes自体と、その何がそれほど優れているのかについて見ていきましょう。
出典: Kubernetes
💡 Kubernetesは、コンテナ化されたアプリケーションのデプロイ、スケーリング、管理を自動化するためのオープンソースコンテナオーケストレーションエンジンです。
より簡単に言うと、Kubernetesは複数のマシンにわたって動的にスケーリングする必要があるワークロードを実行・運用するための、シンプルで標準化された手段を提供します。
代表的な主要機能をいくつか見ていきましょう:
これらはデフォルトで利用可能な機能のほんの一部に過ぎません。膨大な数のユースケースが、Kubernetesを基盤層として構築されたツール群によって実際に解決されています。特定のツールについては、今後の記事で詳しく取り上げます。
Kubernetesが何であるか、そしてソフトウェア開発シナリオにおいてどのような主要機能を提供するかを理解したところで、データサイエンティストのワークフローにおいて具体的にどのような問題を解決できるのかを掘り下げてみましょう。
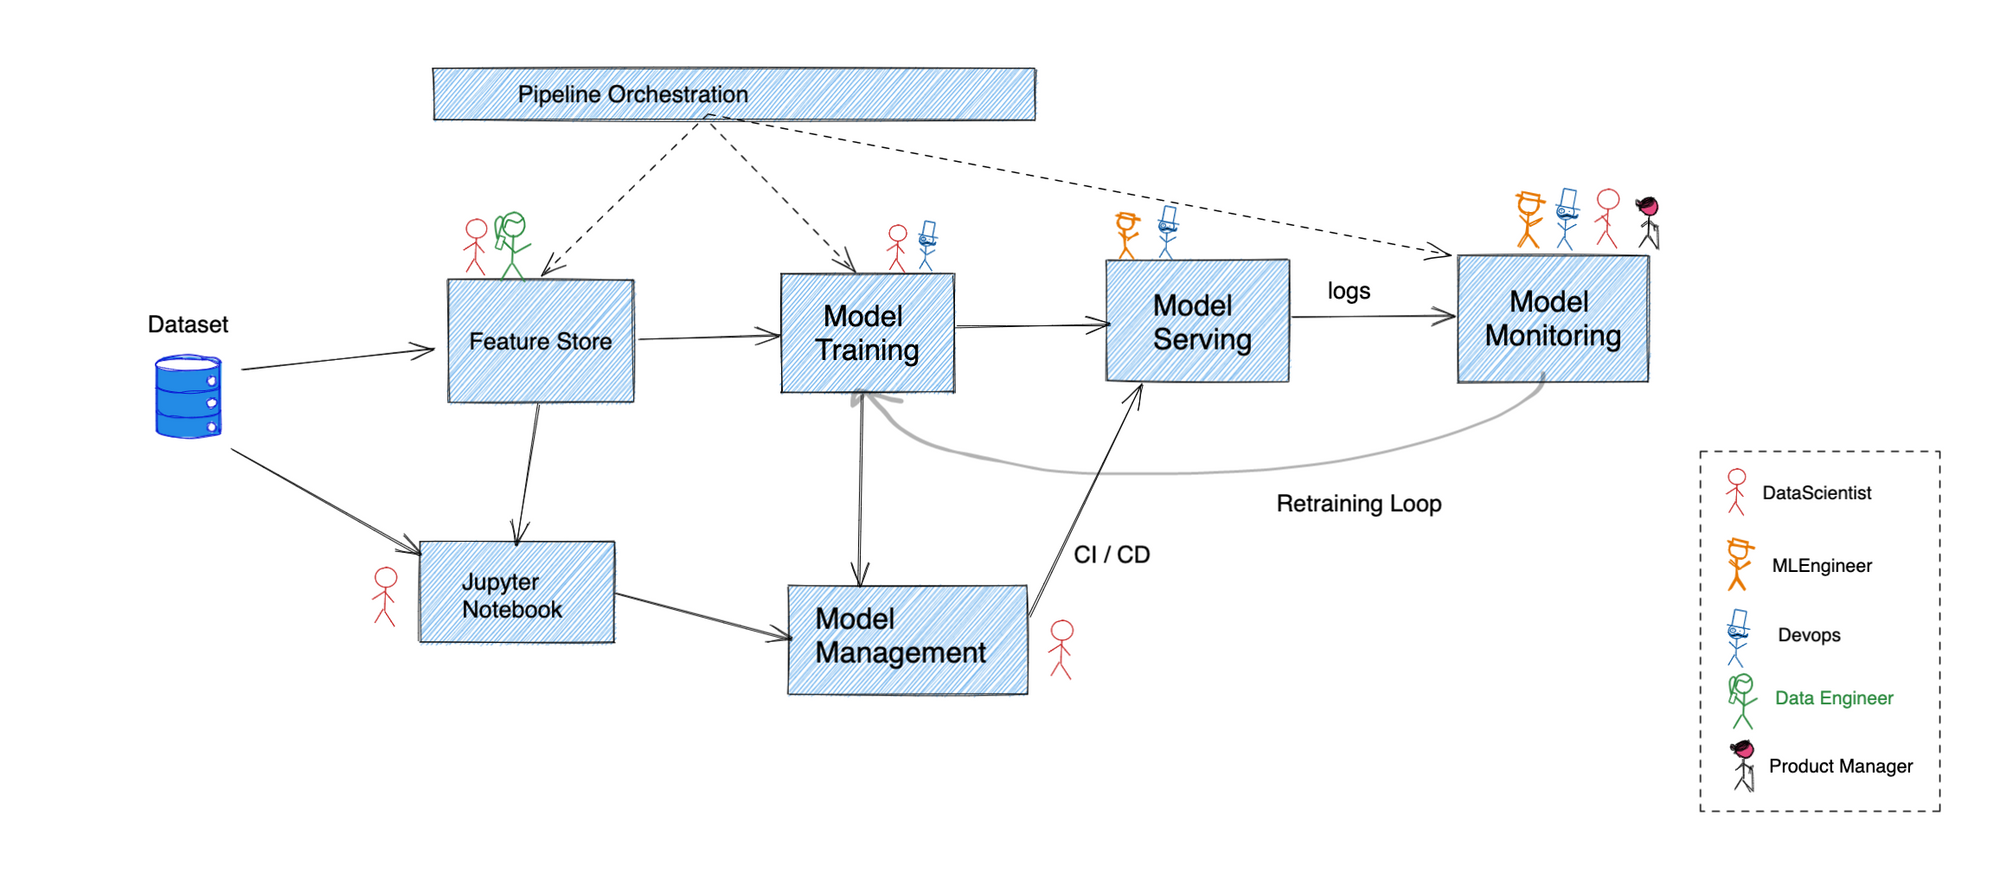
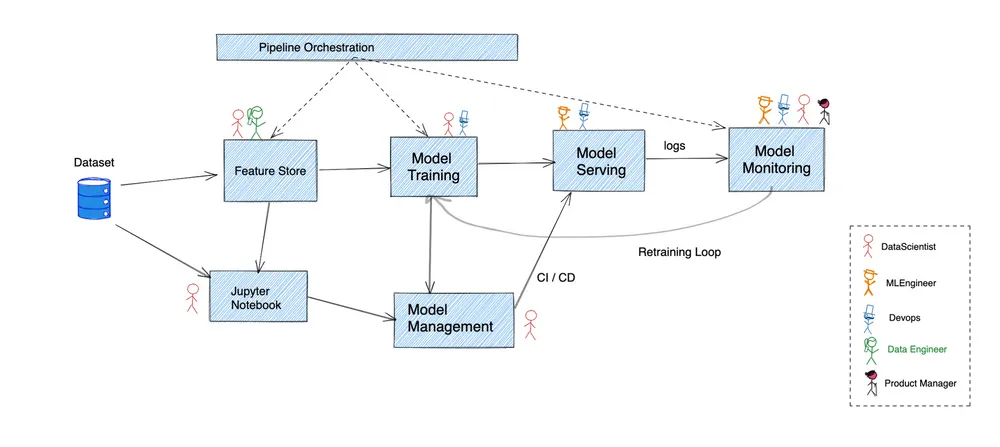
上の図は、一般的なデータサイエンスパイプラインがどのように実行されるかの大まかな概要を示しています。多くの企業は、これらすべてを統合するために、機能が重複する多様なカスタムソリューションを使用することを選択しています。
これらの各ステップを確認し、Kubernetesがどこに適しているのかを紐解いていきましょう:
生データが有用になる前に、まずモデルトレーニングパイプライン向けにクレンジングされた入力データへと変換する必要があります。ここでフィーチャーストアの出番となり、特徴量データの変換、保存、配信を行います。
Kubernetesはステートフルなワークロードのデプロイをサポートしており、クラウドプロバイダーと非常にスムーズに連携して永続性をシームレスに提供します。
ほとんどのモデル開発は、ML EngineerがJupyter Notebookでコードを書くことから始まり、多くのケースにおいてそれだけで十分です。Jupyter NotebookはPythonコードを実行するためのREPLインターフェースを提供します。最初は個人のラップトップ上でホストされることから始まりますが、複数のメンバーが使用できるホスト型Jupyter Notebookの集中プールを運用する方が望ましいと言えます。
Kubernetesの宣言型モデルと永続ストレージシステムのサポートにより、Notebookのプールをホストし、個々のNotebookに対するアクセス制御を適用して効果的なコラボレーションを推進することが容易になります。
Notebook上に書かれたアルゴリズムには、モデルアーティファクトを出力として得るためにトレーニングデータを供給する必要があります。小規模なユースケースではNotebook内でこれを行うことができますが、より大きなデータセットにははるかに強力なパイプラインが必要です。通常、アーティファクトが本番環境での推論に使用される前に、テストデータセットに対する検証もここで行われます。
Kubernetes上でDAGパイプラインをオーケストレーションするためのソリューションは複数存在します。AirflowはKubernetesをネイティブにサポートしており、Kubeflowは完全にKubernetesの上に構築されています。主要なモニタリングソリューションはすべてKubernetesとの高度な統合を提供しており、これは本番レベルのパイプラインを運用するために不可欠です。
このステージでは、データセットとモデルの保存およびバージョン管理を行います。これにより、必要な期間にわたってあらゆるモデルアーティファクトの再現性が保証されます。これは、Gitを使用してコード管理が行われる方法と平行して考えることができます。
このような管理システムの基盤データストアはKubernetes自体にホストすることもできますが、多くの場合、クラウドプロバイダーのマネージドソリューションを使用する方が適しています。そのようなケースでは、ほとんどのクラウドプロバイダーが自社のIAMシステムをKubernetesのIAMシステムとシームレスに統合するため、アクセス資格情報を保持することなくクラスター外部からデータへ安全にアクセスできます。
最後に、本番システムが推論を行えるようにモデルアーティファクトを準備します。これには通常、モデルをAPIフレームワークでラップし、他のサービスがモデルを呼び出して推論を行えるようにすることが含まれます。ここでは、認証/認可、スケーラビリティ、信頼性など、ソフトウェアエンジニアリングと同様の懸念事項が発生します。
これこそがKubernetesの真価が発揮される場所です。前のセクションで述べた機能のほとんどが、このステージで極めて重要になります。
あらゆる本番システムと同様に、現在デプロイされているモデルを継続的に監視することは、システムが期待通りに動作しているかを確認するために不可欠です。監視すべきメトリクスには、実際の予測精度からシステムがサポートできるレイテンシやスループットまで、あらゆるものが含まれます。
多くのモニタリングソリューションがKubernetesと緊密に連携しています。実際にメトリクスを収集するためのターゲットの検出、その上での計算処理の実行、後で使用するための保存処理はすべて、外部依存関係なしで実行できます。
Kubernetesを取り巻くエコシステム全体が急成長しており、すでに多くのツールが存在しています。しかし、組織が全面的に採用する前に留意すべき落とし穴もいくつか存在します。次回の記事では、それらの課題とどのように緩和できるかについて詳しく解説します。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.































