November 5, 2025
|
5 min read


Blazingly fast way to build, track and deploy your models!
ビジネスが成長するにつれて、より多くのトラフィックを処理し、より多くのデータをプロセスし、より多くの顧客をサポートする必要があると言っても過言ではありません。増加する要求に対応するため、インフラストラクチャのスケールが必要になることがよくあります。これは、ビジネスに季節性がある場合にも当てはまります。ブラックフライデーやサイバーマンデーなどの休日中に多くのトラフィックが発生する E コマース Web サイトを想像してみてください。これらの多忙な時期に、Web サイトのトラフィックは劇的に増加する可能性があります。増加した需要を処理できない場合、Web サイトでページの読み込み遅延問題が発生し、ユーザーを不満にさせる可能性があります。その結果、企業は売上の損失や評判の低下を経験する可能性があります。
この問題に対処する 1 つの方法は、インフラストラクチャ内のサーバーの数を手動で増やして、増加したトラフィックを処理することです。ただし、手動でのスケールアップやスケールダウンは時間がかかり、エラーが発生しやすく、管理が困難です。ここで Cluster Autoscaling の出番となります。Cluster Autoscaling は、CPU 使用率、メモリ使用率、または着信リクエストなどの特定の条件に基づいて、インフラストラクチャ内のサーバーの数を自動的に調整します。これは、手動の介入なしで、現在の需要に基づいてインフラストラクチャをスケールアップまたはスケールダウンできることを意味します。
このブログ投稿では、Cluster Autoscaling とは何か、なぜそれが必要なのか、そしてさまざまなクラウドプロバイダーでどのように実装できるかを詳しく説明します。
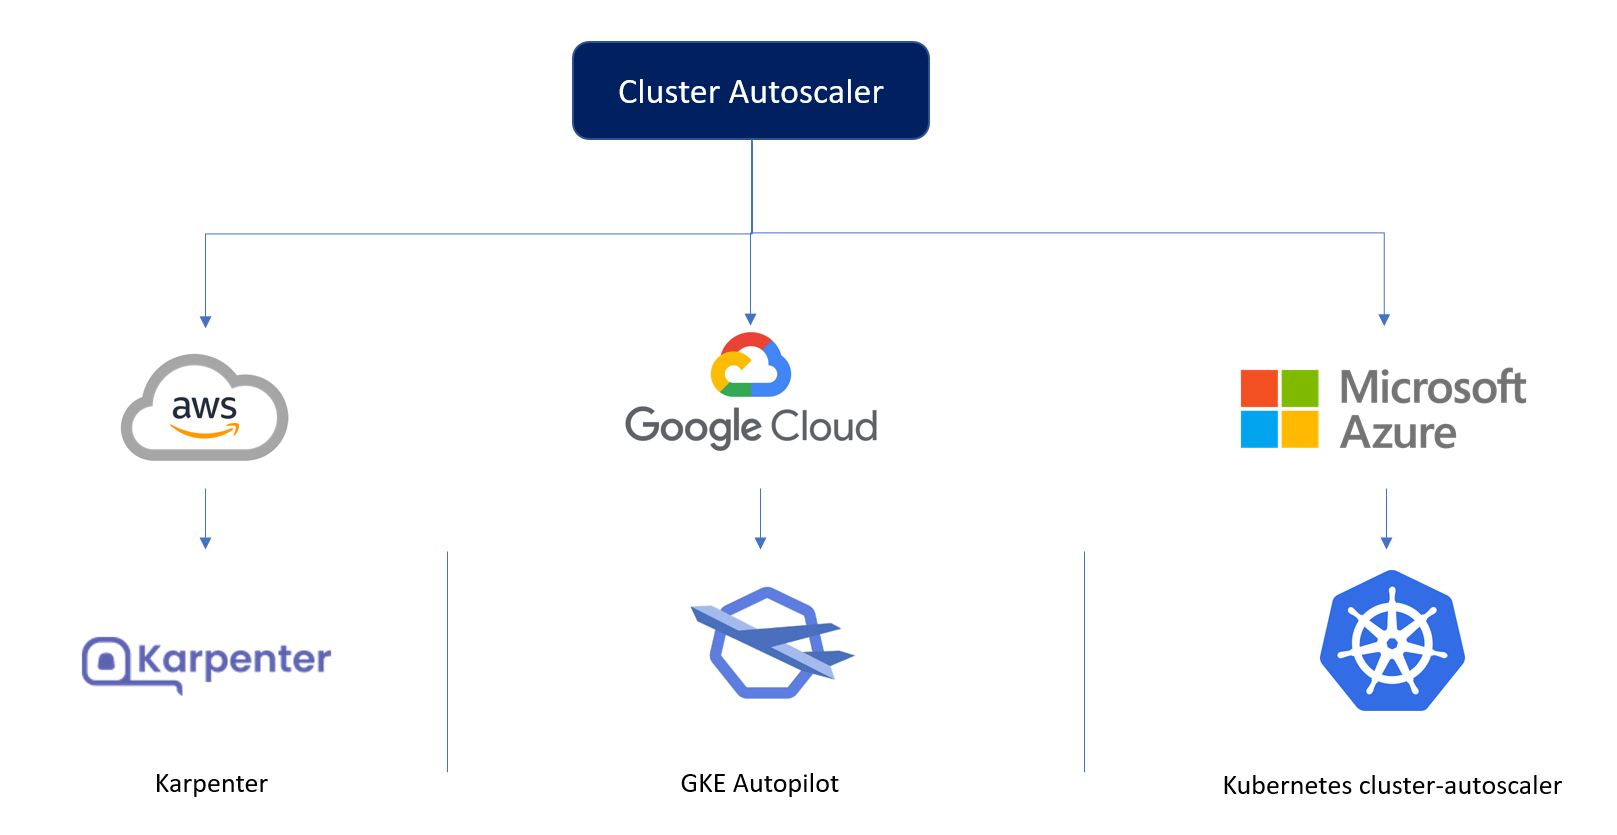
すべての主要クラウドプロバイダーでクラスターを正しく機能させるには、クラスターノードのスケール方法を適応させる必要があります。
💡
AWS では Karpenter を使用します。これにより、最小限の設定で、受信する Pod リクエストに対して最も安価で効率的なノードを選択できます。
💡
GCP では GKE Autopilot に依存しており、リクエストに応じてスケールアップおよびスケールダウンできるマネージドクラスターが提供されます。
💡
Azure にはアドホックなソリューションがなく、Kubernetes cluster-autoscaler を使用します。これは Karpenter よりも最適化されておらず、Autopilot よりも多くの設定が必要です。
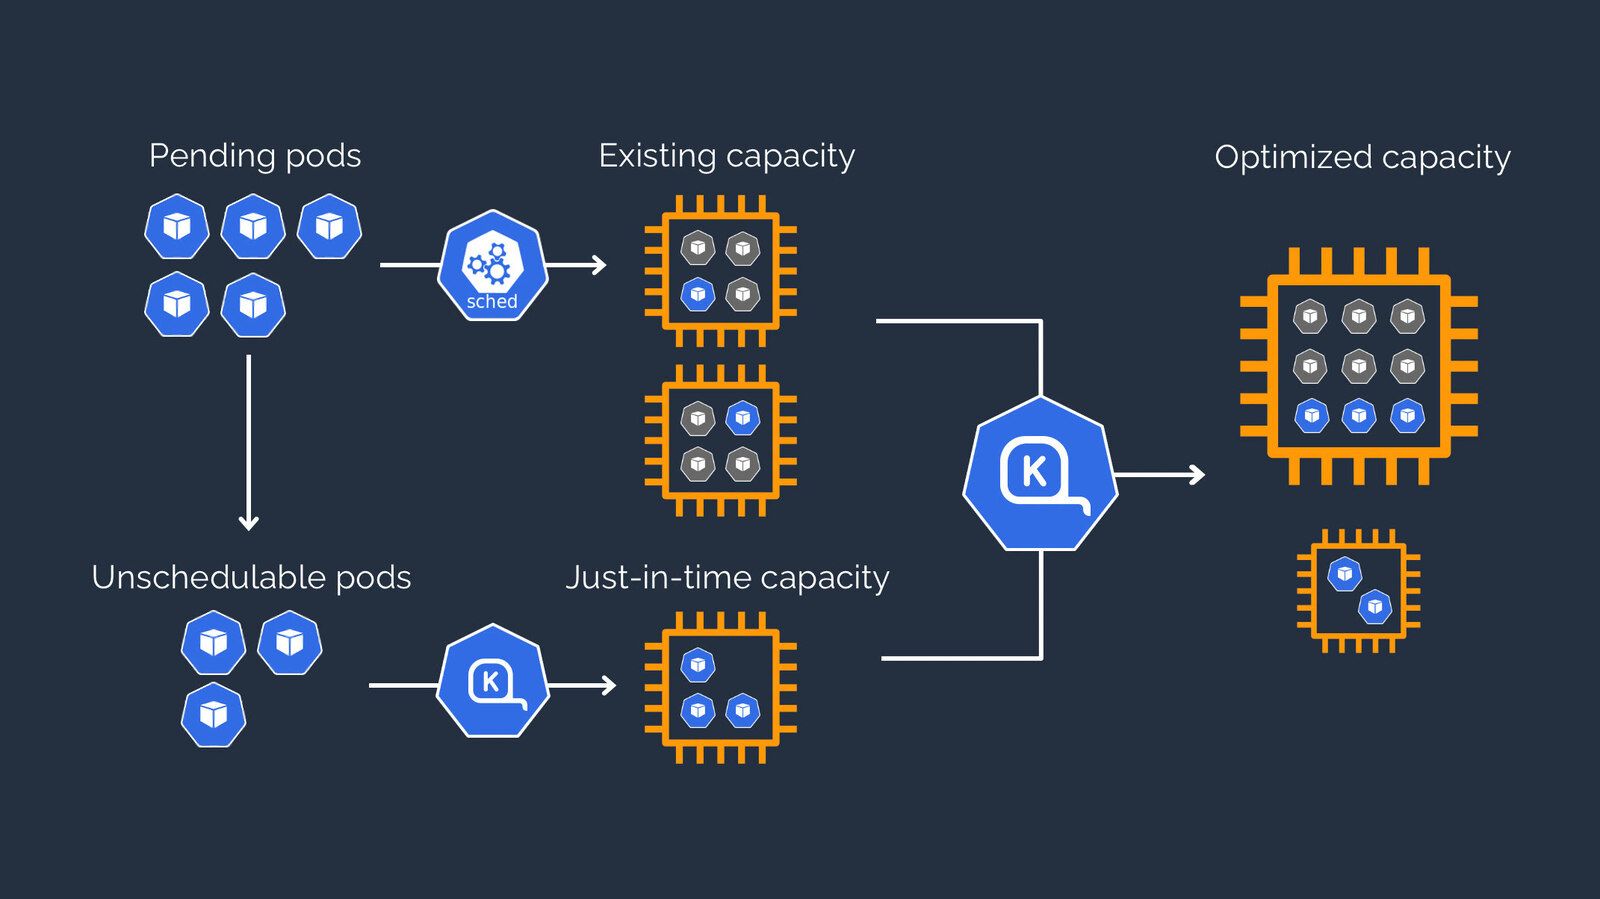
Karpenter は未スケジュールの Pod の集計リソースリクエストを監視し、ノードの起動と終了の決定を行い、スケジューリングのレイテンシとインフラストラクチャコストを最小限に抑えます。
しかし残念ながら、Karpenter は AWS 上でしか動作しません。
Autopilot は、機械学習アルゴリズムを使用して、現在のワークロードに基づいてクラスターの最適なノード数を決定するマネージドサービスです。また、自動アップグレードやパッチ適用などの機能も提供し、クラウドのスケーラビリティをサポートしながら、セキュアなクラスターのメンテナンスを容易にします。
Autoscaling に加えて、Cluster Autopilot は、リソースの過剰プロビジョニングを回避することによるリソース利用率の向上やコスト削減など、その他のメリットも提供します。また、すべての Autoscaling 操作がサービスによって処理されるため、クラスター管理に対するよりハンズオフなアプローチが提供されます。
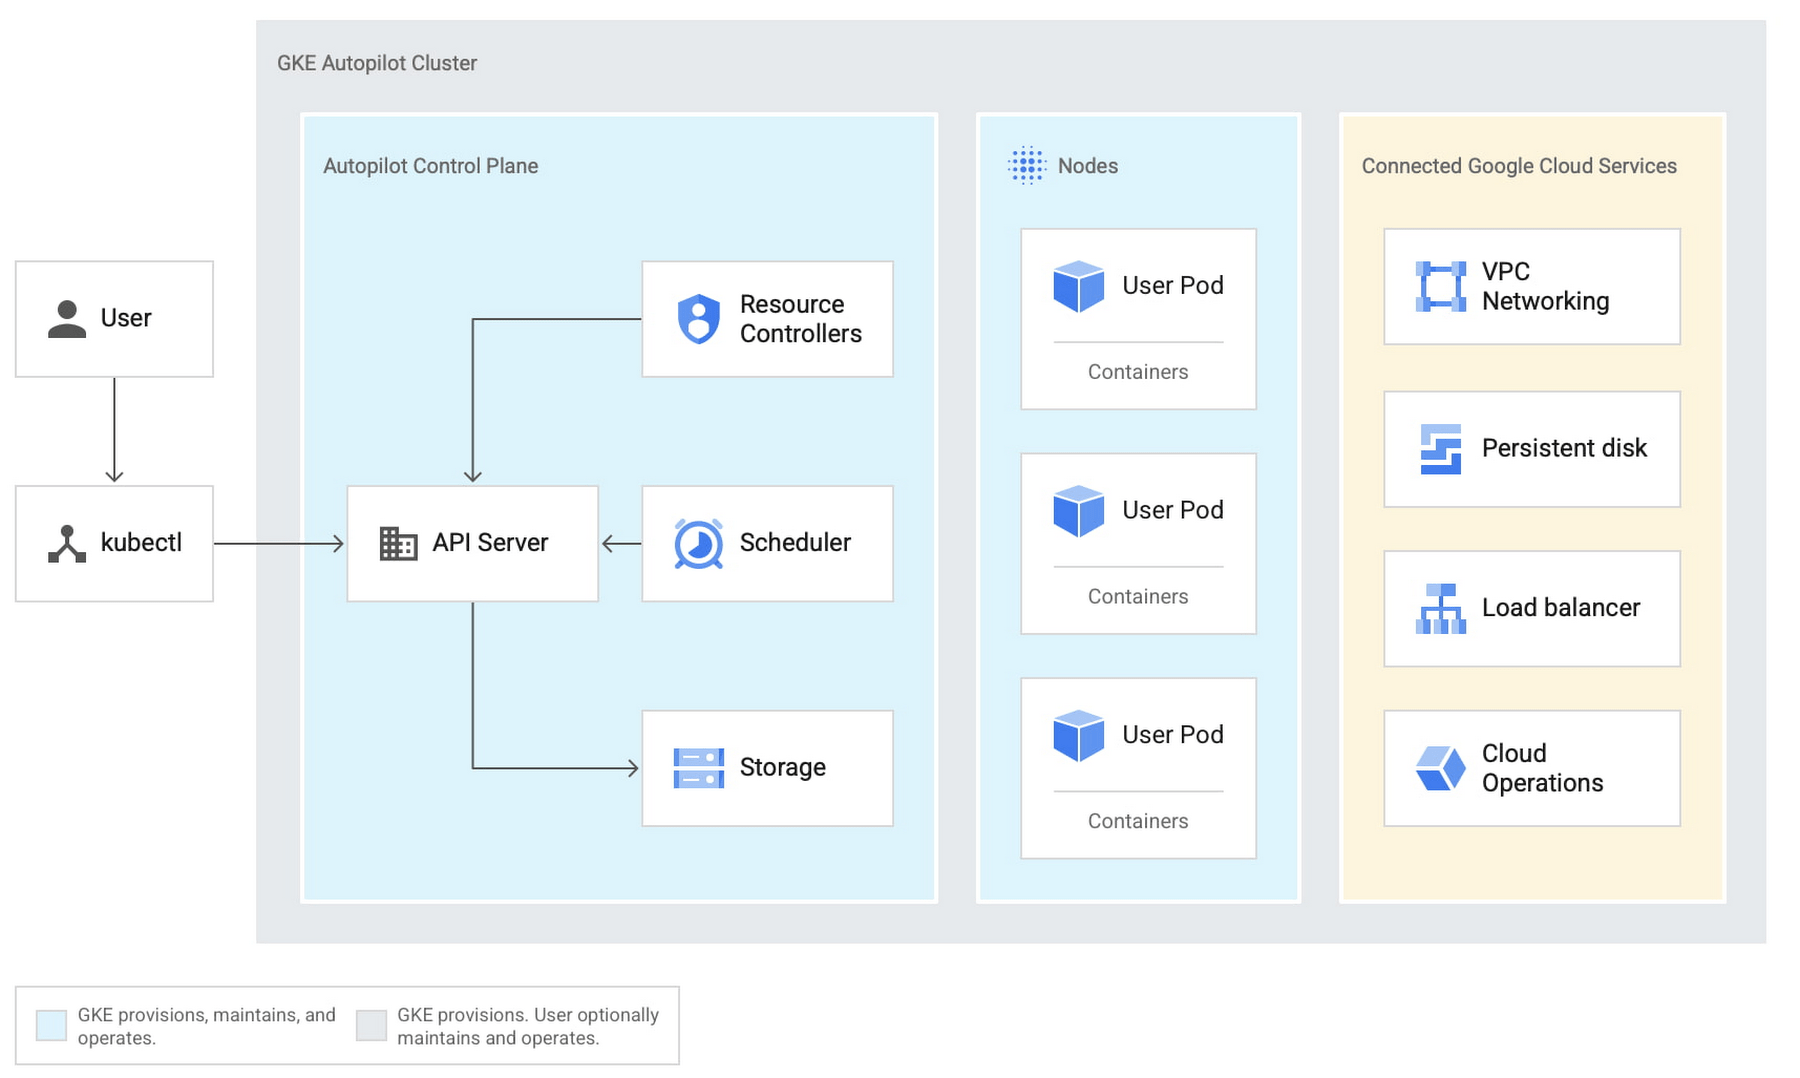
GKE Autopilot のような Azure クラウド上のマネージドサービスや、Karpenter のような Autoscaling へのカスタムアプローチはありません。そのため、cluster-autoscaler に依存しています。
Kubernetes Cluster Autoscaler は、Kubernetes クラスターの自動スケールを可能にするオープンソースツールです。クラスター内で Pod として実行され、クラスターのリソース利用率を監視し、内部で実行されているアプリケーションのニーズを満たすために必要なノード数を調整します。これにより、需要が低いときにリソースの過剰プロビジョニングを回避し、リソース利用率を最適化してコストを削減できます。Cluster Autoscaler には、ノードグループとタイプのマニュアル設定が必要です。
こちらのブログで Kubernetes Autoscaling の詳細を解説しています。
TrueFoundry は Kubernetes 上の ML デプロイメント PaaS であり、インフラチームの完全なセキュリティと制御を確保しながら、モデルのテストとデプロイにおける完全な柔軟性を与え、開発者のワークフローを高速化します。当社のプラットフォームを通じて、機械学習チームは 100% の信頼性、スケーラビリティ、数秒でのロールバック機能により、15 分でモデルをデプロイおよび監視できるようになります。これにより、コストを削減し、モデルを本番環境へ迅速にリリースして、真のビジネス価値の実現が可能になります。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.