



October 10, 2026
|
5 min read


Published: October 10, 2026
Blazingly fast way to build, track and deploy your models!
Claude Sonnet 4.5とGPT-5の議論において、多くの場合は2つの数値が焦点となります。AnthropicはClaude Sonnet 4.5の価格を100万入力トークンあたり3ドル、100万出力トークンあたり15ドルに設定しています。一方、OpenAIはGPT-5をそれぞれ1.25ドル、10ドルとしています。公開されている料金表では、GPT-5が優位に立っています。
しかし、実運用において料金表だけで判断することは困難です。失敗したタスクを2回やり直すコーディングエージェントであれば、すでに節約分以上のトークンを消費しているでしょう。40,000トークンのプレフィックスが安定している要約パイプラインと、ターンごとにコンテキストを書き換えるエージェントとでは、挙動が大きく異なります。
両ベンダーとも、これらのリリースを超えた開発を進めています。OpenAIはGPT-5を従来の推論モデルと位置づけ、開発者にはGPT-5.6を推奨しています。Anthropicも、多くの開発ニーズにおいてClaude Sonnet 4.5よりも新しいClaudeモデルを推奨するようになっています。いずれかのモデル名をハードコードしてしまうと、早期に移行の負債を抱えることになります。
両モデルとも高度な生成AIワークロードをターゲットにしていますが、設計の重点は異なります。単一のリーダーボードを見るよりも、各ベンダーの意図を読み解く方が購入者にとって有益です。Claude Sonnet 4.5とGPT-5の現実的な選択は、主要なユースケースから始まります。
AnthropicはClaude Sonnet 4.5を、要求の厳しいコーディング作業、長時間稼働するエージェント、コンピュータ操作向けに位置づけています。発表ノートでは、実世界のエージェントに向けたメジャーリリースとされており、価格はClaude Sonnet 4と同じく100万入力トークンあたり3ドル、出力15ドルに据え置かれています。APIモデルIDは `claude-sonnet-4-5-20250929` であり、動的なポインタではなく固定されたスナップショットです。
GPT-5は、コーディングやドメイン横断的なエージェントタスクのためのOpenAIの推論モデルであり、Chat Completions APIとResponses APIの両方で利用可能です。スナップショットは `gpt-5-2025-08-07` です。このモデルはテキストと画像の入力を受け付け、テキストを出力します。推論トークンをサポートしており、`minimal`、`low`、`medium`、`high` を指定できる `reasoning.effort` パラメータを備えています。
実用上の違いはすぐに現れます。OpenAIのモデルドキュメントによると、GPT-5はファインチューニングや予測出力(Predicted Outputs)をサポートしていません。一方、Claude Sonnet 4.5は、ツール接続型の推論を行うためのベータヘッダーを通じたインターリーブ思考など、エージェント制御機能を公開しています。
価格面は、両モデルが最も明確に分かれる部分です。以下の料金はすべてベンダーが公開している価格ドキュメントに基づいています。ただし、入力コスト、出力長、キャッシュの挙動、再試行回数が最終的な請求額に影響するため、購入者はワークロードごとにコストをシミュレーションする必要があります。
絶対値よりも2つの比率が重要です。入力コストはClaude Sonnet 4.5の方が2.4倍高く、出力コストは1.5倍高くなっています。これらの差があるため、ワークロードで消費・生成されるトークン数によって、どちらが割高になるかが決まります。
キャッシュなしで、30,000入力トークン、2,000出力トークンのリクエストを1,000回実行する場合を考えます。Claude Sonnet 4.5のコストは入力90ドル、出力30ドルです。GPT-5は入力37.50ドル、出力20ドルです。
これにより、120ドル対57.50ドルという比較になります。この例ではClaudeのコストが2.09倍となります。大量のサポート業務、分類、コンテンツ管理ワークフローなどでは、トークン単価の面でGPT-5のコスト優位性が明確です。
次に、その入力の90%をキャッシュから読み込む場合を考えます。Claude Sonnet 4.5は、キャッシュ読み込みが8.10ドル、新規入力が9.00ドル、出力が30ドルに下がります。GPT-5は27.13ドルとなります。キャッシュによって入力側のコストが削減されるため、価格差は縮まります。
キャッシュの計算には注意が必要です。Anthropicは5分間のキャッシュ書き込みに対して基本入力の1.25倍を請求します。一方、OpenAIのGPT-5の料金表には、キャッシュ書き込み料金は別途記載されていません。そのため、回答トークンの価格やキャッシュの入れ替わり頻度によって、どちらが有利かは変動し得ます。
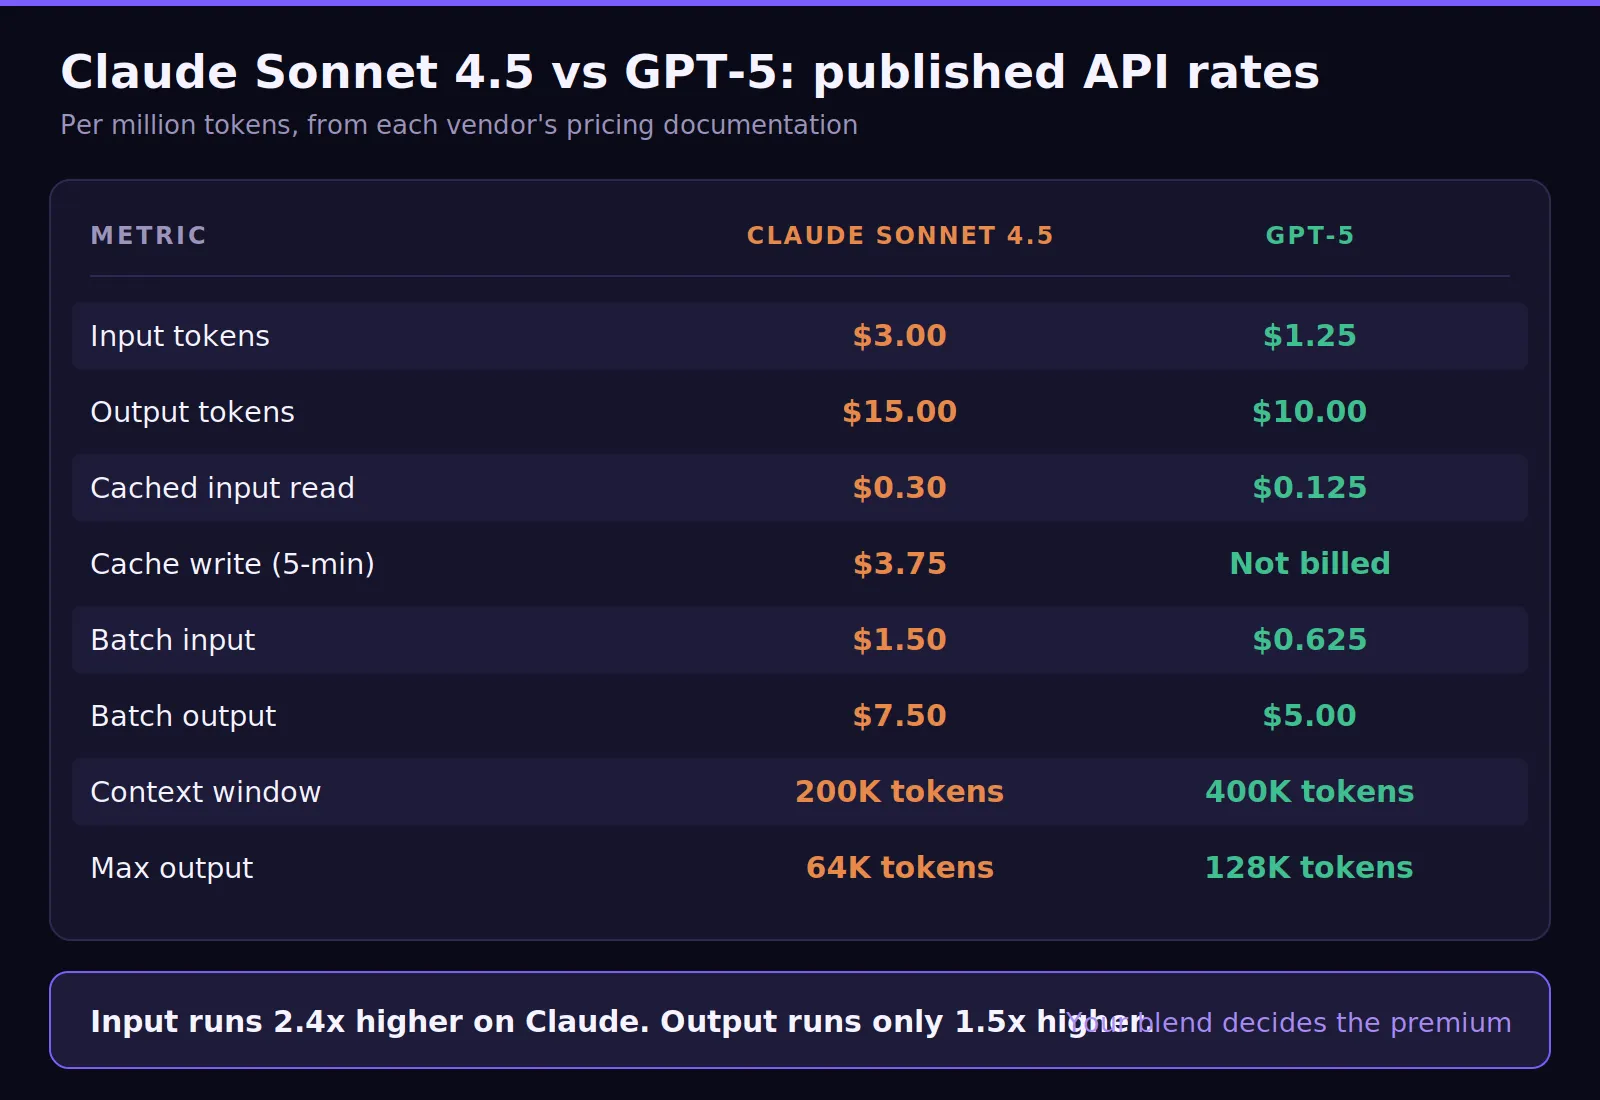
コストは一つの問いに対する答えに過ぎません。AIモデルがタスクを完了するまでメモリ内に保持できるかどうかは、より難しい問いです。Claude Sonnet 4.5とGPT-5を比較する際は、コンテキストウィンドウ、出力制限、推論制御を詳しく検討する必要があります。
コンテキストの差は過小評価されがちです。GPT-5はClaude Sonnet 4.5の2倍の入力を受け付け、2倍の最大出力を生成します。これは、大規模なリファクタリング、膨大なテキスト、複雑なワークフロー、あるいは一つの大きなタスクとして処理される長いエージェントのトレースにおいて重要となります。
Sonnet 4.5は、GPT-5にはない機能を備えています。Anthropicのコンテキスト認識機能は、モデルの残り予算を`<budget:token_budget>200000</budget:token_budget>`としてシステムプロンプトに直接挿入し、ツール呼び出しのたびに`<system_warning>`を表示します。これにより、モデルは容量を推定するのではなく、実際の残り容量に基づいて計画を立てることができます。
Claude Sonnet 4.5は、ベータヘッダーを通じてツールとのインターリーブされた思考(interleaved thinking)もサポートしています。これは、複雑な推論タスク、より深い考察、科学的推論、財務分析、数学的推論、そしてツールによる結果が次のステップに影響を与えるエージェント型のビジネスオペレーションにおいて役立ちます。
GPT-5は、標準モードとより高度な推論設定を通じて、推論の取り組みレベルをサポートしています。これにより、チームはレイテンシ、分析品質、コスト効率を調整する新たな手段を得ることができます。最適なモデルは、依然としてターゲットとなるワークロード内での測定品質によって決まります。
ベンチマークは初期選別の指針にはなりますが、社内テストの代わりにはなりません。Artificial Analysisはインテリジェンス指数やモデル比較を公開しており、他の情報源でもARTパフォーマンス、分析インテリジェンス、専門的な推論スコアなどが扱われています。これらは調達の根拠ではなく、あくまで判断の出発点として捉えてください。
Anthropicのポジショニングは、ソフトウェアエンジニアリング、ツール利用、そして長時間稼働するエージェントワークに重点を置いています。そのため、Claude Sonnet 4.5はエージェントによるコーディング、コード生成、コードレビュー、自律的な運用に適しています。特に、品質向上によってレビューサイクルが短縮される場合に、このモデルは非常に魅力的です。
モデルの品質は、いずれにせよワークロードごとに判断すべきものです。コーディングのベンチマークは公開されたタスクを測定するものですが、エンジニアはプライベートなリポジトリで作業しています。リポジトリの規約、依存関係グラフ、レビュー文化、テスト構造こそが、Claude Sonnetが優れたパフォーマンスを発揮できるかどうかを決定づけます。
両方のモデルで同じ20件の社内チケットを処理し、固定の評価基準でスコアリングしてみてください。失敗した試行、フォローアップのプロンプト、ツールのエラー、承認されたプルリクエストの数をカウントします。1回あたりのコストが高いモデルでも、修正回数が少なければ結果的にコストを抑えられる可能性があります。
一般的なリーダーボードの結果が、そのまま自社に当てはまるとは限りません。あるリポジトリではClaudeが明らかに優れていても、別のリポジトリではGPT-5の方が優れているというケースは珍しくありません。そのため、Claude Sonnet 4.5とGPT-5のどちらを選ぶべきかは、実際のワークロードでの試行を通じて判断する必要があります。
GPT-5の公開されているトークン価格は、入力、出力、キャッシュされた読み取り、バッチ利用のいずれにおいてもClaude Sonnet 4.5を下回っています。これは、大量のデータを扱う本番ワークロードの計算式を大きく変えるものです。サポートの自動化、分類、自然言語の品質チェック、社内ツールなどでは、GPT-5が選ばれる傾向にあります。
400,000トークンというより大きなコンテキストウィンドウは、別の種類のワークロードに役立ちます。ドキュメント処理パイプラインにおいて、応答を分割して結合するのではなく、1回の呼び出しで完結させることが可能になります。チャンク数が減れば、結合の手間や失敗のリスク、運用上の複雑さを軽減できます。
コストだけで判断を下すべきではありません。出力品質、再試行の挙動、キャッシュヒット率、人間によるレビューのコストが総支出に影響します。また、GPT-5の知識カットオフはClaude Sonnet 4.5よりも古いため、新しいフレームワークやAPI、エンタープライズワークフローを扱う場合には注意が必要です。
GPT-5は、一般的なユーザー層や幅広いAIプラットフォームのユースケースにも適している可能性があります。サポート、要約、分析、CMSワークフローなど、多様なコンテンツをサポートできます。Google検索との連携については、Gemini 3 ProやCosmic AIなど、別の専門モデルとの比較が必要になるでしょう。
多くのチームは、どちらか一方に固定しなければならないと考えがちですが、それは通常、誤った捉え方です。ワークロードごとに使い分け、一つのモデルですべてを完結させる必要があるのかを問い直す方が賢明です。そうすることで、GPT-5とClaude Sonnet 4.5の比較は、より運用上の価値を持つようになります。
次のような場合はClaude Sonnet 4.5を選択してください:
GPT-5を選択すべきケース:
ガバナンスを備えたモデルレイヤーを選択すべきケース:
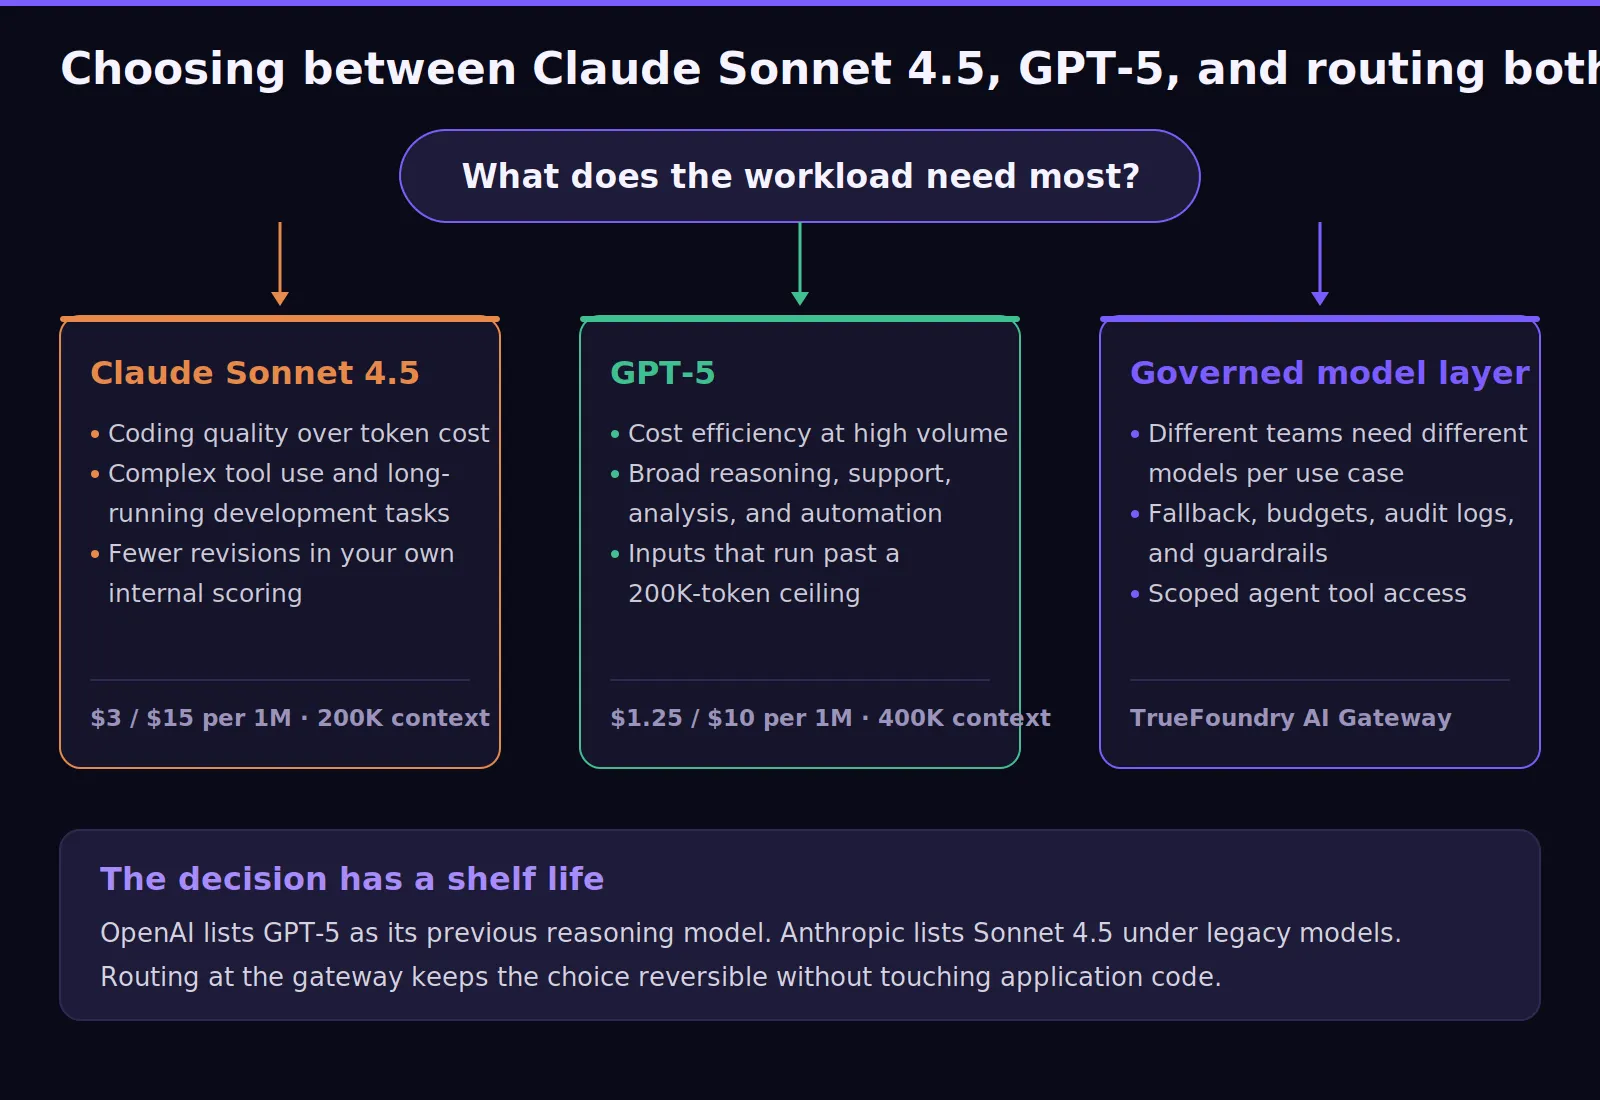
上記の比較には有効期限があります。GPT-5はすでに旧モデルのラベルを冠しており、AnthropicにはClaude Sonnet 4.5以降の新しいモデルが登場しています。AI業界の進化は速く、TrueFoundryはモデルの入れ替わりがアプリケーションコードに影響を与えないようにします。
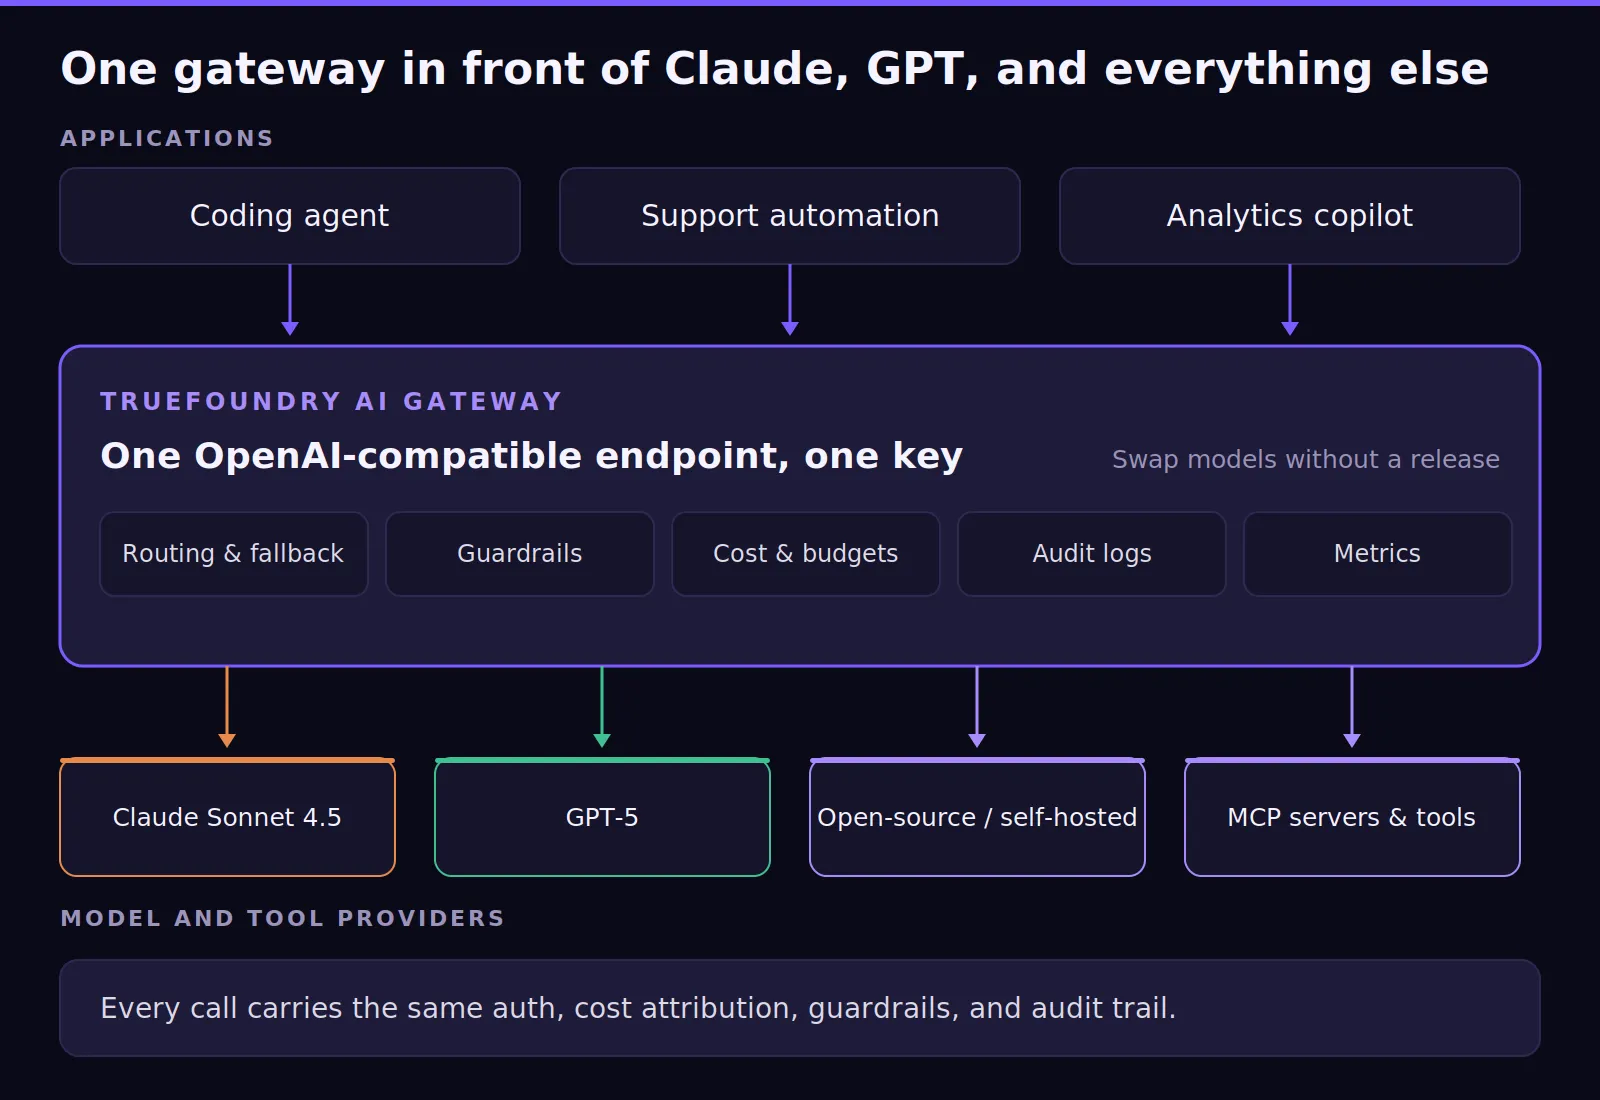
チームは、品質、コスト、レイテンシ、推論の深さに基づいてClaude Sonnet 4.5とGPT-5を比較検討できます。ガバナンスレイヤーは両プロバイダーから独立しているため、各グループはコーディング、サポート自動化、分析、社内コパイロットといった用途に合わせて、それぞれ異なるモデルを運用することが可能です。
AIゲートウェイは、 AIゲートウェイ アプリケーションとモデルプロバイダーの間に位置します。OpenAI互換のエンドポイントを1つ公開しつつ、認証、ログ記録、ガードレール、コスト管理を適用します。この単一のレイヤーで、Claude、GPT、オープンソースモデル、セルフホストモデルを統合的に管理できます。
from openai import OpenAI

client = OpenAI(
    api_key="your-truefoundry-pat",
    base_url="https://{your-gateway-host}/api/llm/api/inference/openai",
)

# Same client, same call shape, different backend model.
for model in ["anthropic-main/claude-sonnet-4-5", "openai-main/gpt-5"]:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Refactor this handler for idempotency."}],
        extra_headers={"X-TFY-METADATA": '{"team":"platform","environment":"staging"}'},
    )
    print(model, response.usage)
マルチモデルルーティングのためのLLMゲートウェイ。 LLMゲートウェイは、 LLMゲートウェイ 単一のインターフェースを通じてプロバイダー間のリクエストをルーティングします。これにより、大量の要約処理にはGPT-5を、コーディングやエージェントのパスにはSonnet 4.5を割り当てるといった使い分けが可能です。仮想モデルを使用することで、モデルに単一の安定した名称を付与でき、ターゲットの切り替えもリリース作業ではなく設定変更のみで完結します。
routing_config:
  type: priority-based-routing
  load_balance_targets:
    - target: anthropic-main/claude-sonnet-4-5
      priority: 0
      retry_config:
        attempts: 2
        delay: 100
        on_status_codes: ["429", "500", "503"]
      fallback_status_codes: ["429", "500", "502", "503"]
    - target: openai-main/gpt-5
      priority: 1
      fallback_candidate: true
ルールは順次評価され、最初に一致したものが適用されます。ターゲットごとの`retry_config`で同一モデルの一時的な障害に対応し、再試行が困難な場合は`fallback_status_codes`でリクエストを転送します。TrueFoundryは、リクエスト数、トークン数、分間エラー数からターゲットの健全性を検知し、問題がある場合は自動的にクールダウンさせます。
安全なツールアクセスのためのMCPゲートウェイ。 MCPゲートウェイは、 MCPゲートウェイ アプリケーションやエージェントがツール、API、データベース、業務システムにアクセスする方法を制御します。ClaudeやGPTを搭載したエージェントが記録の取得、サービスの呼び出し、ワークフローの実行を行う上で、アクセス範囲の制限は不可欠です。
ワークフローレベルのガバナンスを実現するエージェントゲートウェイ。 エージェントゲートウェイは、 エージェントゲートウェイ 自律的なタスク全体にワークフローレベルのガバナンスを追加します。マルチステップの動作、実行制限、エージェント間のメッセージング、セッションを意識したトレーシングを制御します。暴走ループや安全でないアクションをテレメトリとして可視化し、月末の予期せぬ事態を防ぎます。
ガードレール、コスト管理、監査証跡。 これらにより、GPT-5やClaude Sonnet 4.5を統制の取れた本番環境で利用可能にします。メトリクスダッシュボードでは、レイテンシ、最初のトークンまでの時間、推論コスト、入力トークン数、出力トークン数、キャッシュメトリクス、予算制限によるブロック状況などをレポートできます。
この機能により、単なる一時的な比較ではなく、運用に基づいた回答が得られます。トラフィックの10%を別のモデルに振り分け、解決されたタスクあたりのコストを測定することは、料金表を読み解くよりもはるかに有益です。また、チームが根拠に基づいた意思決定を行うための助けとなります。
モデルの選択肢を柔軟に保ちながら、本番環境のガバナンスを維持しましょう。 デモを予約する TrueFoundryがどのようにClaude、GPT、オープンソース、そしてカスタムモデルを単一のガバナンスされたAIゲートウェイ経由でルーティングしているかをご確認いただけます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























