Built for Speed: ~10ms Latency, Even Under Load Blazingly fast way to build, track and deploy your models!
Handles 350+ RPS on just 1 vCPU — no tuning needed Production-ready with full enterprise support 多くのエンジニアリングチームにとって、Amazon SageMakerはAWS上で機械学習を始める際の標準的な出発点です。これは包括的な「ラボ・イン・ア・ボックス」体験を提供し、基盤となるサーバーの管理を不要にします。
しかし、チームが実験的なノートブックから本格的なモデルデプロイメントへと移行するにつれて、月々の請求額は現実と乖離しがちです。「マネージドML」の利便性には、ある程度のコストが伴い、それが静かに利益を蝕む可能性があります。
このガイドでは、SageMakerの料金体系の具体的な構成要素について解説し、コンピューティングインスタンスのマークアップを明らかにし、コスト意識の高い企業がなぜ代替案を探しているのかを説明します。
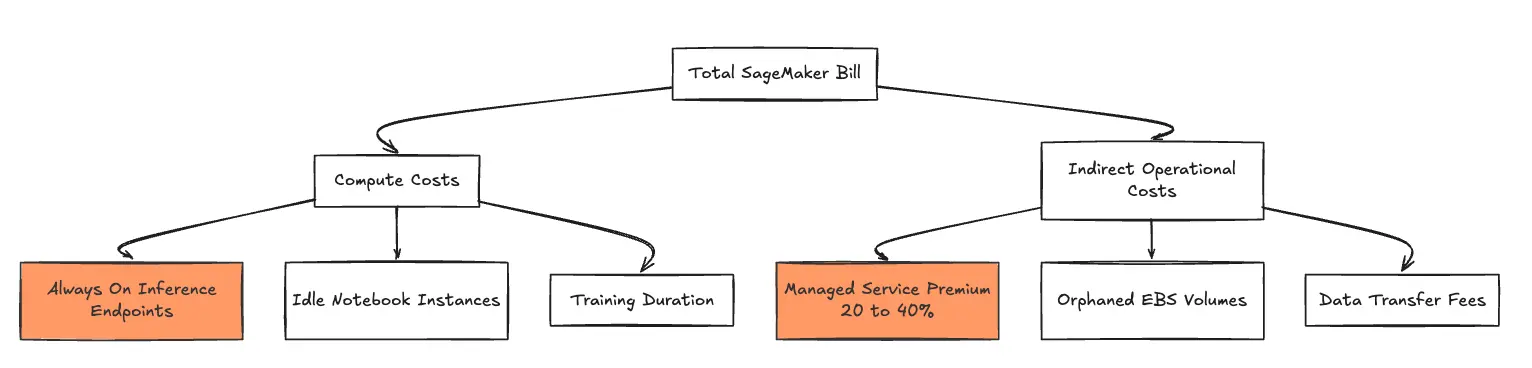
SageMakerの料金モデル:コンポーネントごとの計算 SageMakerは料金を単一のプランにまとめていません。その代わりに、MLライフサイクルの各段階ごとに個別に料金を支払います。ここでは、そのコストの内訳を説明します。
Studioノートブック(開発コスト) SageMaker Studioノートブックは、軽量なテキストエディタと誤解されがちです。実際には、実行中のコンピューティングインスタンスとして課金されます。
時間単位の課金: 開発者は、各Jupyterノートブックセッションを支えるインスタンスに対して時間単位の料金を支払います。「ゾンビ」問題: これらのインスタンスは、夜間や週末に稼働したまま放置されることが頻繁にあります。金曜日の午後にノートブックをシャットダウンし忘れた開発者は、週末全体にわたって課金対象となる時間を発生させてしまいます。隠れたコスト: 厳格な自動シャットダウンポリシーがない場合、アイドル状態の開発環境は「ゾンビノートブック」となり、何の価値も生み出すことなく、静かに SageMakerのコスト を積み上げていきます。トレーニングジョブ(モデル構築コスト) トレーニングコストは、使用された特定のインスタンスタイプと、リソースがアクティブであった期間に基づいて計算されます。
セットアップ時間も課金対象です: トレーニングクラスターの全期間に対して料金が発生します。これには、GPUが計算処理を行っている時間だけでなく、クラスターの起動時間やデータロード時間も含まれます。インスタンスサイズが重要: より大きなインスタンスタイプ(ディープラーニングやLLMに必要とされる)は、時間あたりのコストを劇的に増加させます。データ転送: S3からトレーニングインスタンスへ大量のデータセットをプルする際、見過ごされがちなデータ転送料金が発生することがよくあり、これらは個別の項目として請求されます。推論エンドポイント(デプロイコスト) ほとんどのプロダクションチームにとって、推論は「氷山の一角」であり、 Amazon SageMakerの料金 —を占めています 総請求額の70~80% .
常時課金: リアルタイム推論エンドポイントは、モデルがクエリされているかどうかにかかわらず、24時間365日課金されます。スケーリングコスト: ピーク時のトラフィックを処理するため、チームはリソースを過剰にプロビジョニングすることがよくあります。SageMakerのオートスケーリングは保守的であるため、可用性を確保するためだけに、アイドル状態の容量に対して料金を支払うことになります。SageMakerの料金に隠された「マネージドサービスプレミアム」 高額な料金の最大の要因の1つは AWS SageMakerのコスト マネージドサービスのマークアップです。実際にはAmazon EC2インスタンスを使用していますが、SageMakerはそれらを管理レイヤーでラップし、プレミアム料金を請求します。
「ml.」インスタンスと標準EC2の比較 SageMakerインスタンス(ml.で始まるもの)は通常、費用が 20~40%高くなります 同等の生のEC2インスタンスよりも、同じハードウェアで動作しているにもかかわらず。 マークアップがどのように積み重なるかを簡略化して見てみましょう。
SageMaker vs EC2 Price Comparison
Instance Type
Standard EC2 Price
SageMaker ml.* Price
Managed Service Premium
m5.xlarge
~$0.192
~$0.23
~20%
p3.2xlarge (GPU)
~$3.06
~$3.82
~25%
g4dn.xlarge
~$0.526
~$0.736
~40%
*Pricing estimates based on AWS US-East-1 on-demand rates as of January 2026. Actual costs may vary by region and usage terms.
注:価格は米国東部(バージニア北部)のオンデマンド料金に基づいた推定値であり、変更される可能性があります。 支払いの内訳 この追加料金は根拠のないものではありません。AWSがこの料金を請求するのは、彼らが主要な作業を処理しているためです。
OSのパッチ適用とヘルスチェック。 ドライバーの更新(CUDAなど)。 サービスオーケストレーションとエンドポイント管理。 プラットフォームエンジニアがいない小規模チームにとっては、これは妥当な取引です。しかし、規模が大きくなると、この利便性に対するプレミアムは、インフラ利用に対する繰り返しの税金となり、費用対効果が薄れていきます。
支払う可能性のあるその他の隠れたコスト 主要なコンピューティング料金以外にも、いくつかの運用上の非効率性が最終的な SageMakerの請求額 を膨らませます。これらのコストは、経理部門が予算超過を指摘して初めて明らかになることがよくあります。
EBSボリュームによるストレージのオーバーヘッド すべてのノートブックとトレーニングジョブは、データとコードを保存するために、デフォルトでElastic Block Store (EBS) ボリュームをアタッチします。
孤立したストレージ: ノートブックインスタンスが終了されると、アタッチされたEBSボリュームが常に自動的に削除されるわけではありません。知らぬ間に蓄積: これらのボリュームは残り続け、積極的に監視されていないと静かに蓄積される「孤立したストレージ」料金を発生させます。マルチモデルエンドポイントの制限事項 マルチモデルエンドポイント(MME)は、1つのコンテナで複数のモデルをホストできるようにすることで、コスト削減を約束します。
レイテンシーの罠: 実際には、モデルをオンデマンドでメモリにロードすると、「コールドスタート」レイテンシーが発生します。逆戻り: ユーザーエクスペリエンスの問題を解決するため、チームはしばしば専用エンドポイントに戻し、高額な常時稼働インフラコストを再導入します。推論におけるスポットインスタンスサポートの制限 AWSスポットインスタンスは最大90%の割引を提供しますが、SageMakerでの推論にはリスクが伴います。
信頼性の問題: SageMakerには、スポットノードが回収された場合にオンデマンドインスタンスに即座に切り替えるための、堅牢なネイティブのフォールバックメカニズムがありません。高額な費用負担: 信頼性を確保するため、チームは本番環境での推論のために高価なオンデマンドインスタンスに頼らざるを得ず、大幅な潜在的コスト削減の機会を逃しています。大規模になるにつれてSageMakerの料金管理が難しくなる理由 AIの導入が進むにつれて、 SageMakerの料金は 予測と最適化がますます困難になります。
コストは、ノートブック、トレーニングジョブ、エンドポイント、ストレージ、およびモニタリング(CloudWatch)に分散されます。予算管理はAWSアカウントレベルで運用されるため、特定のコストを特定のモデルや研究チームに帰属させることは困難です。この可視性の欠如は、アイドル状態のリソースや過剰にプロビジョニングされたエンドポイントにつながり、月々の支出を無期限に膨らませます。
モデル開発のためにSageMaker Ground Truth、SageMaker Clarify、SageMaker Debuggerなどの高度な機能を使用するチームは、これらの機能が総コストに複雑さを加えることが多いと感じています。
スケーリングするチームがコンピューティングを自社で処理する理由 SageMakerのマネージドサービスにかかる追加費用が、もはや維持できなくなる明確な転換点があることがよくあります。
月々のAI関連費用が 1万ドルから2万ドルのしきい値 を超えると、その上乗せ料金は無視できないものとなります。この段階になると、エンジニアリングリーダーは通常、マネージドサービスによる追加費用なしで、純粋なインフラ料金を求めます。高度なチームは、GPUの種類、リザーブドインスタンス、セービングスプランに対するきめ細かな制御を望みますが、これらの最適化はSageMakerのエコシステム内では制限されるか、より複雑になることがよくあります。
TrueFoundry:SageMakerに代わるより良い選択肢 TrueFoundryのAI Gateway は、 オーケストレーション と インフラの所有 を分離することで、根本的に異なるアプローチを提供します。
TrueFoundryは、コンピューティングに上乗せ料金を付けて再販するのではなく、お客様自身のEKS (Kubernetes) およびEC2クラスター上でワークロードを直接オーケストレーションします。
上乗せ料金なし: お客様はAWSインフラの原価料金を支払います。TrueFoundryはプラットフォームに対して課金し、コンピューティング使用量の割合で課金することはありません。自動的なコスト削減: アイドル状態のリソースは、利用状況に基づいたポリシーを使用して自動的にシャットダウンされ、ゾンビノートブックを排除します。信頼性の高いスポット推論: TrueFoundryは、小規模なオンデマンドバッファを維持し、中断を適切に処理することで、スポットインスタンスでの信頼性の高い推論を可能にし、生産コストを大幅に削減します。当社のオーケストレーションレイヤーがAWSマネージドエコシステムとどのように比較されるかについての並行技術評価については、こちらの詳細な分析をご覧ください。 SageMakerとTrueFoundryの比較 .
Amazon SageMaker vs TrueFoundry: コスト構造比較 この比較は、機能の同等性ではなく、ユニットエコノミクスに焦点を当てています。
SageMaker vs TrueFoundry Cost Comparison
Cost Component
Amazon SageMaker
TrueFoundry
Compute Rate
Bundled pricing model vs. raw EC2 rates.
Raw EC2 pricing with no added service premium.
Idle Resource Management
Requires manual intervention to manage idle resources.
Automated scale-to-zero when not in use.
Inference on Spot
Complex configuration requiring custom interruption handling.
Native spot support with automatic on-demand fallback.
Development Environment
Integrated exclusively with SageMaker Studio.
Flexible environments: VS Code, Jupyter, Kubernetes-native.
Vendor Dependencies
Dependency on proprietary AWS-native tooling.
None. Runs on your cloud with standard Kubernetes primitives.
*Comparison based on standard product documentation and AWS US-East-1 pricing availability as of January 2026. Features and pricing subject to change by providers.
さまざまな支出規模における実世界の節約とユニットエコノミクスの詳細な分析をご覧になりたい場合は、弊社の SageMakerとのコスト比較 。
長期的なAI規模拡大のための適切なプラットフォームの選択 AIインフラの決定は、長期的なコストと運用目標に合致している必要があります。
Amazon SageMaker に最適です。
小規模チームまたは個人データサイエンティスト。 最小限のセットアップで迅速に開始できること。 インフラのコストよりもデプロイの速度が重視されるプロジェクト。 TrueFoundry に最適です。
予測可能なコストを必要とするAIアプリケーションの規模拡大。 クラウドコンピューティングに月額1万ドル以上を費やすチーム。 インフラの柔軟性を必要とし、マネージドサービスの追加料金を避けたい企業。 しかし、特定のユースケース向けに異なるAWSネイティブサービス間でまだ迷っている場合は、弊社のガイド AWS Bedrock vs. AWS SageMaker 考慮すべき柔軟性と管理における主要な違いを探ります。
上乗せ料金を支払うのはもうやめにしませんか? SageMakerは初期段階の実験には優れていますが、長期的なAIの成功にはコスト規律が不可欠です。クラウド費用がモデルのパフォーマンス向上よりも速く増加している場合、インフラ戦略を見直す時期です。
マネージドサービスの高額な上乗せ料金から脱却し、貴社がインフラ費用をどれだけ削減できるか正確に知りたいとお考えなら、 デモを予約する TrueFoundryと本日、潜在的な節約額を計算するために。
よくある質問 SageMakerの費用はいくらですか? SageMakerの料金はリージョンと使用量によって異なります。コンピューティングインスタンス(1時間あたり)、ストレージ(1GBあたり/月)、データ転送に対して個別に料金が発生します。インスタンスの価格は、基本的なCPUの場合1時間あたり数セントから、高度なGPUインスタンスの場合1時間あたり28ドル以上まで幅があります。
SageMakerのコストを削減する方法は? 削減するには、 AWS SageMakerのコスト 、アイドル状態のノートブックインスタンスをシャットダウンし、トレーニングジョブにスポットインスタンスを使用し、推論エンドポイントを適切なサイズにし、未アタッチのEBSボリュームを削除するようにしてください。あるいは、TrueFoundryのようなオーケストレーションプラットフォームに移行することで、マネージドサービスの上乗せ料金を完全に排除できます。
SageMakerはAWSで無料ですか? SageMakerは最初の2ヶ月間、無料枠を提供しており、小規模インスタンスタイプでのノートブック使用、トレーニング、推論の制限された時間数が含まれます。これらの制限を超えると、通常の料金が適用されます。
TrueFoundryはAmazon SageMakerよりもどのように費用対効果が高いですか? TrueFoundryは、標準のEC2インスタンスを使用して自身のクラウドアカウントでワークロードを実行できるため、より費用対効果が高いです。これにより、SageMakerが課す20〜40%の上乗せ料金を回避できます。また、アイドル状態のリソースを自動的にシャットダウンし、推論にスポットインスタンスを確実に使用するための自動化機能も提供します。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.