August 31, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
AI Gateway内のGuardrailsは、強力な言語モデルと重要なアプリケーションの間の安全網として機能し、すべてのリクエストと応答が組織のセキュリティ、品質、コンプライアンスの基準を満たすようにします。TrueFoundryプラットフォームのこれらのguardrailsを使用すると、個人特定情報(PII)のマスキング、許可されていないトピックのフィルタリング、不適切なワードのブロックなど、精密なルールを定義できます。これにより、機密データが漏洩することなく、コンテンツが常にブランドボイスや法的要件に合致しているという確信を得られます。構成可能なポリシーに対して各入力と出力を評価することで、TrueFoundryのguardrailsはハルシネーションを防ぎ、コンテンツ基準を適用し、すべてのLLM駆動型ワークフロー全体で一貫した動作を維持します。
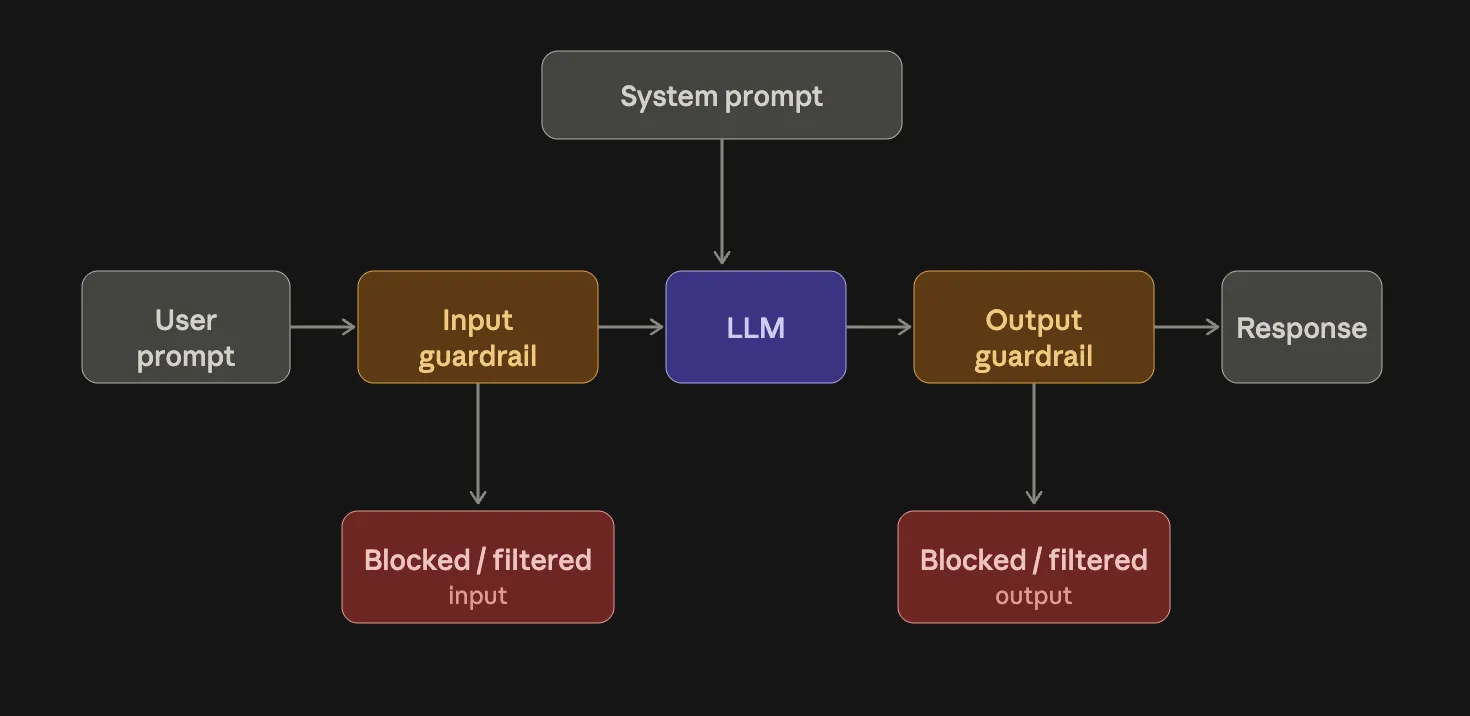
エンタープライズは、カスタマーサポートの自動化、マーケティングコピーの生成、内部ワークフローの合理化のために、大規模言語モデルへの依存を強めています。Guardrailsがなければ、これらのモデルは予測不可能な出力を生成し、組織を法律、評判、運用のリスクに晒す可能性があります。
第一に、データプライバシーの適用は譲れない条件です。Guardrailsを使用すると、システムから出る前に個人特定情報(PII)を自動的に検出して匿名化できます。これにより、メールアドレス、社会保障番号、その他の機密情報の偶発的な開示を防ぎ、GDPRやHIPAAなどの規制の遵守に役立ちます。
第二に、guardrailsはブランドの整合性とユーザーの信頼を保護します。エンタープライズ向けのチャットボットが突然侮辱的な言葉や偏見のある発言で応答すると、顧客を遠ざけ、ブランドを傷つける可能性があります。拒否されたトピックのリストやカスタムワードフィルターに対して出力を検証することで、一貫したトピックを維持し、ブランドにそぐわない言語を回避できます。このレベルのコンテンツガバナンスは、複数のチームが同じAI gatewayにアクセスする場合に不可欠です。
第三に、運用の安定性は予測可能なモデルの動作に依存します。エンタープライズにおけるAI guardrailsにより、メタデータ、ユーザーロール、サービスコンテキストに基づいて異なるルールを適用し、どのモデルが特定のリクエストを処理するかを細かく制御できます。本番ログで問題を発見したり、怒っているユーザーから話を聞いたりするのではなく、応答がポリシーに違反したときに迅速に失敗(fail-fast)させることができます。
第四に、guardrailsは監査可能性と説明責任をサポートします。ルールがトリガーされるたびに、どの入力または出力チェックが呼び出されたか、どの変換が適用されたか、どのユーザーまたはサービスが呼び出しを開始したかを示す構造化ログが記録されます。これらのログは、セキュリティレビュー、コンプライアンス監査、事後分析のための明確な監査証跡を形成します。
最後に、guardrailsはコストのかかるハルシネーションのリスクを軽減します。意味的なトピックフィルターに対して出力を検証することで、モデルが法的条項、医学的助言、またはその他のハイリスクなコンテンツを捏造するのを阻止します。規制対象の業界では、この安全網がAIの導入成功と損害をもたらすデータ侵害の分かれ目となる可能性があります。
Guardrailsは、強力だが予測不可能なLLMを、信頼性とコンプライアンスを備えたエンタープライズツールに変えます。すべてのリクエストと応答がセキュリティ、品質、ガバナンスの基準に合致していることを確認しながら、最先端のAIを自信を持って活用できます。
AIアプリケーションごとに直面するリスクが異なるため、エンタープライズはAIワークフローの複数のポイントでguardrailsを必要とします。エンタープライズにおけるAI guardrailsは、入力、出力、機密情報、コンテンツ、プロンプト、およびAIツールへのアクセスを制御できます。
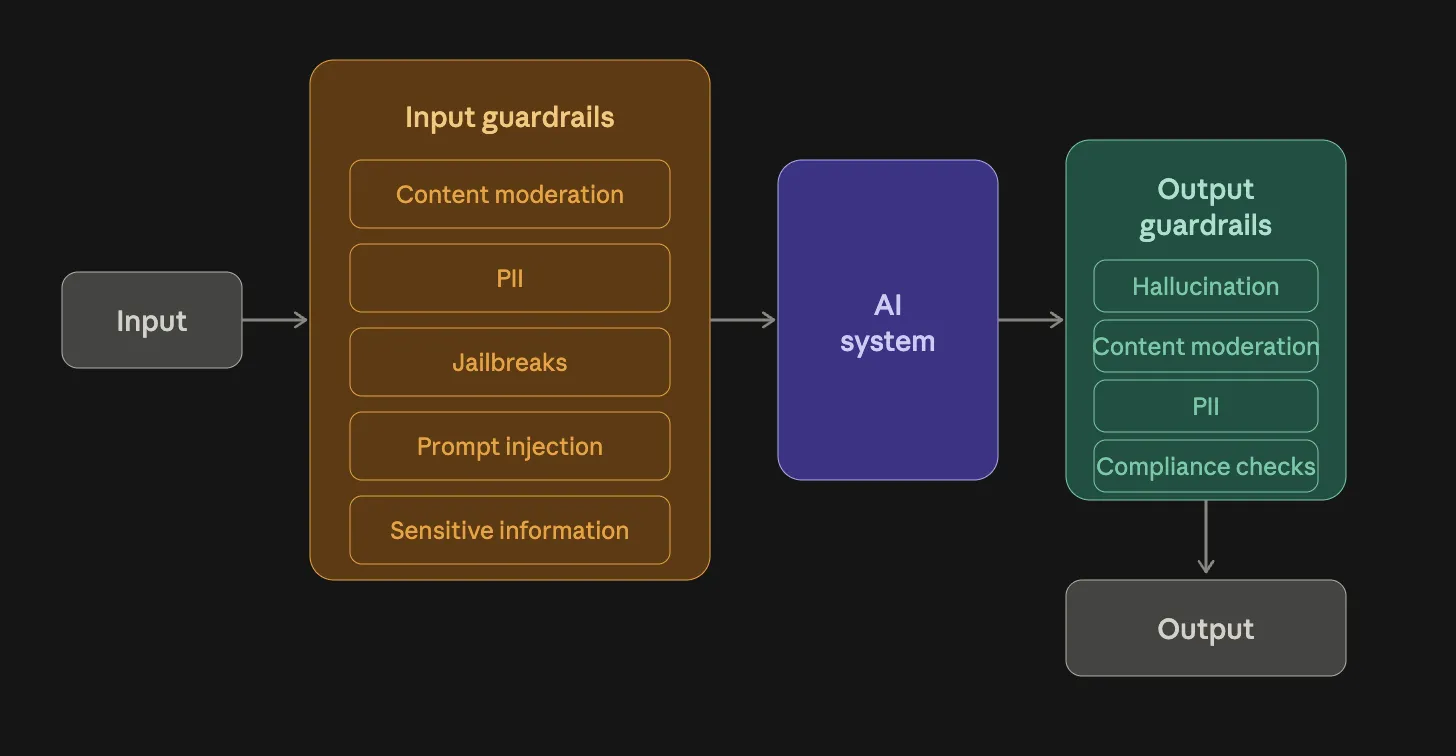
TrueFoundryのAI GatewayのGuardrailルールを使用すると、言語モデルのインタラクションの両端でポリシーを適用できます。各ルールには識別子、一致条件のセット、および入力・出力guardrailsの2つのセクションがあります。TrueFoundryはルールを順番に評価し、各リクエストに対して最初に一致したものだけを適用するため、複数のポリシーが該当する場合でも予測可能な適用が保証されます。
入力guardrailsは、モデルに入力されるすべてのものに適用されます。一般的なシナリオには、LLMに到達する前に個人特定情報(PII)をマスキングまたは検証することが含まれます。例えば、アクションがtransformであるタイプpiiの入力guardrailは、メールアドレス、電話番号、または社会保障番号を自動的に匿名化します。また、タイプword_filterの入力guardrailを使用して、ユーザープロンプトから不要なフレーズを除去したり、企業用語を強制したりすることもできます。問題を早期に捕捉することで、ポリシー違反やコストのかかる監査の可能性を減らします。
出力guardrailsは、モデルの応答を管理します。医療アドバイス、ヘイトスピーチ、不適切な言葉などの拒否されたトピックのリストに対して出力を検証し、コンテンツがポリシーに違反している場合は即座に失敗させることができます。あるいは、出力を変換して機密情報をリダクションしたり、許可されていない単語をプレースホルダーに置き換えたりすることもできます。個別のしきい値設定により、システムがテキストをどの程度アグレッシブにフラグ付けまたは修正するかを制御できるため、ユーザーエクスペリエンスとコンプライアンスのバランスを柔軟に取ることができます。
各ルールにはwhenブロックを含めることができ、それが適用されるモデル、メタデータタグ、またはサブジェクト(ユーザー、チーム、または仮想アカウント)を指定できます。例えば、顧客向けチャットボットには厳格なPIIリダクションを適用し、内部アナリティクスパッチにはより寛容なフィルターを使用することができます。モデルIDやサブジェクトによってターゲットを絞ることで、他のワークロードを過度に制限することなく、適切なレベルのガバナンスが確保されます。
TrueFoundryは、ルールの評価と適用のためのREST APIを公開するguardrails_service_urlを介して、これらのポリシーをguardrailsサービスに接続します。すべてのリクエストはguardrailsエンジンを経由してルーティングされ、実行されるたびにログが記録され、変換または検証がリアルタイムで適用されます。入力ルールと出力ルールがこのように明確に分離されているため、LLMデプロイメントを強力かつ安全に維持する、堅牢で保守しやすいポリシーを簡単に設計できます。
TrueFoundryのPII guardrailsは、受信用プロンプトと送信用応答の両方に含まれる個人特定情報を自動的に特定して処理し、機密データが露出するのを防ぎます。
input_guardrailsとoutput_guardrailsをタイプpiiで構成することにより、コンプライアンスのニーズに基づいて、検出されたエンティティを検証(validate)または変換(transform)することを選択できます。
Guardrailエンジンは、メールアドレス、電話番号、社会保障番号、クレジットカードの詳細、住所、政府発行の識別子(パスポート、運転免許証、納税者番号など)を含むがこれらに限定されない、包括的なPIIカテゴリーのセットを認識します。
TrueFoundryは、英国のNHS番号、インドのAadhaar ID、オーストラリアのTFNなどの地域変種もサポートしており、グローバルなデプロイメント全体で広範なカバー率を保証します。
各PII guardrailルール内で、optionsブロックはターゲットにするエンティティタイプを指定します。
action: transformを設定すると、検出されたエンティティがモデルに到達する前に匿名化されたプレースホルダーに置き換えられます。あるいは、action: validateを設定すると、許可されていないPIIを含むリクエストが拒否され、プロンプトを転送する代わりにエラーが返されます。
変換のメリット
PII guardrailsは、エンタープライズAIアプリケーションが機密性の高い個人情報を扱うあらゆる場所で役立ちます。主なユースケースは以下の通りです:
AIインフラストラクチャ層にPII guardrailsを適用することで、個々のアプリケーションチームに別々の制御の実装を依存するのではなく、LLMアプリケーション全体で機密情報を一貫して検出、変換、またはブロックできます。
トピックフィルタリングguardrailsは、AIが許可されていない主題について議論するのを防ぐ意味的ルールを適用します。禁止されたトピックの構成可能なリストに対して受信用プロンプトと送信用応答の両方を検査することにより、エンタープライズはすべてのインタラクションが定義されたコンテンツ境界内に留まることを保証し、ブランドの評判を保護し、規制コンプライアンスを維持できます。
ブロックする主題領域は自由に決定できます。一般的なユースケースは以下の通りです:
各トピックのguardrailの下で、optionsブロックに2つの主要なパラメーターを指定します:
メリット
Gateway層でトピックフィルターを適用することで、TrueFoundryは各アプリケーションに独自のトピック検出ロジックの実装や保守を要求することなく、AIアプリケーション全体でコンテンツポリシーを適用する集中型の方法をエンタープライズに提供します。
TrueFoundryのワードフィルタリングguardrailsを使用すると、AI Gatewayを通過するすべての単語やフレーズを精密に制御できます。カスタムブロックリストを定義することで、独自用語、不適切な言葉、またはあらゆる機密言語を、モデルに到達する前と生成された後の両方で検出して処理できます。これにより、LLM駆動型アプリケーションが許可されていない用語を露出させたり、ブランドにそぐわない言語に陥ったりすることがなくなります。
各word_filter guardrailの下で、word_list、case_sensitive、whole_words_only、およびreplacementオプションを指定してフィルタリング動作を調整します。word_listは、検出したい用語やフレーズの配列です。
case_sensitive: falseを設定すると照合で大文字と小文字が無視され、whole_words_only: trueを設定すると独立した単語のみがフラグ付けされ、長い単語の内部での意図しない一致を回避できます。replacementフィールドは、action: transformが選択されている場合に使用されるプレースホルダーテキスト(例:「[REMOVED]」)を定義します。あるいは、action: validateを選択すると、ブロックリストに登録された単語を含むリクエストが拒否され、モデルにコンテンツを転送する代わりにエラーが返されます。
以下は、入力と出力の両方にワードフィルタリングを適用し、独自の用語ブロックリストを使用してGPT-4デプロイメントをターゲットにするサンプル構成です:
ワードフィルターが起動するたびに、TrueFoundryはトリガーされたルール、元のテキストと変換後のテキスト、およびユーザーまたはサービスのコンテキストの詳細を含むイベントをログに記録します。これらの監査ログは、セキュリティチームやコンプライアンスチームがインシデントをレビューし、ブロックリストを調整し、内部ポリシーや業界規制への準拠を証明するのに役立ちます。
Gatewayでワードフィルタリングを集中管理することで、開発者はアプリケーションコードにアドホックなチェックを散りばめる必要がなくなります。ポリシーは一元管理され、更新が容易で、すべてのLLMワークロード全体に一貫して適用されます。
AI governanceは、組織が自社のAIシステムに遵守することを期待するポリシーと制御を定義します。AI guardrailsは、それらのポリシーをリアルタイムの制御に変換し、プロンプト、モデルの応答、およびAIのアクションをそれらが発生したときにチェックします。
これにより、guardrailsはガバナンス要件と日々のAIの動作との間の運用層となります。文書化されたポリシーや手動レビューのみに依存するのではなく、エンタープライズはセキュリティ、コンプライアンス、またはビジネスのリスクになる前に、違反を自動的に検出して対処できます。
エンタープライズにとって、これによりguardrailsはAIガバナンスの重要な実行層となります。TrueFoundryのようなプラットフォームは、これらの制御をAIインフラストラクチャ層にもたらし、チームがLLMアプリケーションおよびデプロイメント全体でセキュリティ、データ保護、およびポリシー適用を一貫して適用できるようにします。
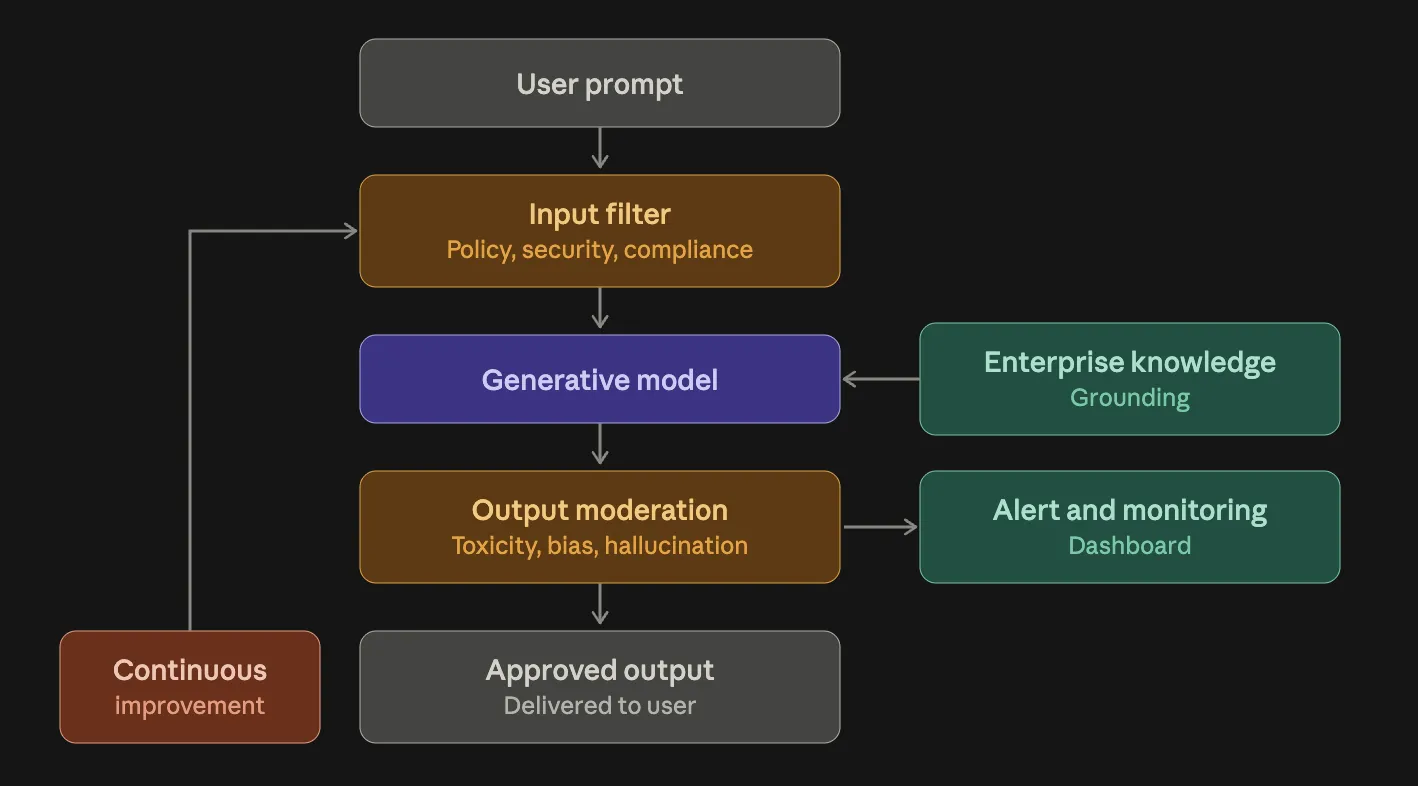
エンタープライズにおけるAI guardrailsは、組織のリスクプロファイルやユースケースと緊密に連携しているときに最もよく機能します。まず、機密データ、規制コンプライアンス、ブランドボイスなど、保護する必要があるものを明確に定義することから始め、各要件をPII、トピック、またはワードフィルターなどの特定のguardrailタイプにマッピングします。法務、コンプライアンス、プロダクトチームのステークホルダーを早期に巻き込み、ポリシーが現実世界の制約を反映し、重要なワークフローを誤ってブロックしないようにします。
次に、ルールをできるだけ絞り込んだものにします。広範な「すべて拒否」リストは過度の偽陽性を引き起こし、ユーザーをイライラさせる可能性があります。代わりに、関連するポリシーをコンテキストごとにスコープされた個別のルールにグループ化し、whenブロックを使用して特定モデル、チーム、またはメタデータをターゲットにします。
例えば、顧客向けボットには厳格なPIIリダクションを適用し、内部アナリティクスアシスタントにはより自由な記述を許可します。このモジュール化されたアプローチにより、エンタープライズAI guardrailsの維持と進化が時間の経過とともに容易になります。
しきい値の調整も重要なプラクティスです。重要度の低い環境で保守的な感度レベルから始めてルールの起動頻度を観察し、実際の使用状況に基づいてしきい値を上下に調整します。各guardrailイベントのログを使用して、偽陽性や見逃された違反のパターンを特定し、設定を反復改善します。既知のポリシー違反をプロンプトと期待される応答に注入する自動テストスイートは、更新を本番環境にプッシュする前にルールのカバー率を検証するのに役立ちます。
ドキュメント化と可観測性(observability)は不可欠です。各ルールの目的と範囲を明確に記述した、guardrail構成の集約リポジトリを維持します。ログに、どのルールがトリガーされたか、一致したコンテンツ、および適用された変換が確実に記録されるようにします。これらのログをモニタリングツールと統合し、ルールの起動率が予期せず急上昇したときにアラートを出し、潜在的な悪用やユーザー行動の変化をシグナルとして検知します。
最後に、ユーザーや開発者とのフィードバックループを確立します。エンドユーザーやアプリケーションチームが過剰なブロックや欠落しているポリシーを報告できるメカニズムを提供します。フィードバック、使用状況メトリクス、セキュリティ監査の結果を定期的にレビューして、guardrailsを洗練させます。明確な目標、ターゲットを絞ったルール、反復的な調整、強力な可観測性を組み合わせることで、イノベーションを妨げることなくエンタープライズを保護するguardrailフレームワークを構築できます。
Guardrailsは、すべてのインタラクションでコンテキストを認識した明確なポリシーを適用することにより、強力でありながら予測不能なLLMを、信頼性の高いエンタープライズグレードのサービスに変換します。機密性の高いPIIのマスキング、許可されていないトピックのブロック、独自用語のフィルタリングなど、簡潔な入力・出力ルールを定義することで、アプリケーションコードに触れることなく、データプライバシーを維持し、ブランドボイスを維持し、規制要件を満たすことができます。
whenブロックを介してスコープされたモジュールルールにより、モデル、チーム、またはワークフローごとに適用をカスタマイズでき、しきい値の調整と堅牢なログ記録により、保護と使いやすさのバランスが保証されます。
TrueFoundryのguardrailsを使用すると、中央集権的な制御、継続的な監査可能性、およびすべてのリクエストと応答がガバナンス基準に合致していることを確信しながら、AIを大規模にデプロイする自信が得られます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.