


noviembre 21, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
El motor de inferencia decide con qué eficiencia su GPU sirve los tokens. El mismo modelo en el mismo hardware puede ofrecer un rendimiento, una latencia y un coste muy diferentes en función del motor y de cómo estén ajustados su batching y su almacenamiento en cache.
No existe un ganador universal. vLLM, SGLang y TensorRT-LLM están en desarrollo activo y convergen en muchas técnicas, como continuous batching, cache KV paginada, prefix caching y cuantización. La elección adecuada depende de su modelo, GPU, longitudes de secuencia, tamaño de lote (batch size) y concurrencia.
vLLM está desarrollado en torno a PagedAttention, que gestiona la cache key-value de la atención en páginas no contiguas, de forma similar a como un sistema operativo gestiona la memoria virtual. Esto reduce la fragmentación de la memoria y permite que el servidor agrupe más secuencias concurrentes en una sola GPU.
Es una excelente opción de uso general para un servicio de alto rendimiento con continuous batching, amplia cobertura de modelos y un servidor compatible con OpenAI fácil de usar. Elija esta opción cuando busque un amplio soporte de modelos y un rendimiento sólido sin necesidad de un paso de compilación. Para obtener una visión más detallada, consulte nuestra explicación sobre vLLM.
SGLang se basa en RadixAttention, que reutiliza la cache KV entre solicitudes que comparten un prefijo mediante un árbol radix. Esto beneficia a las cargas de trabajo con un alto grado de uso compartido de prompts, como los prompts few-shot, los prompts de sistema compartidos largos, las conversaciones multiturno basadas en agentes y la técnica tree-of-thought.
También ofrece salidas estructuradas rápidas y fiables, incluida la decodificación restringida por JSON, regex y gramática, lo que resulta de gran ayuda en pipelines complejos de prompting y tool calling. Recurra a SGLang cuando la reutilización de prefijos y la generación restringida predominen en su tráfico.
TensorRT-LLM es la librería de NVIDIA que compila modelos en motores optimizados para un objetivo de GPU específico, utilizando kernels fusionados, atención optimizada, cuantización en hardware compatible y batching en marcha (in-flight batching) a través de Triton.
Suele tener como objetivo la menor latencia y la mejor eficiencia por GPU en GPU de NVIDIA, a costa de requerir un paso de compilación explícito y de generar motores vinculados al tipo y cantidad exactos de GPU para los que fueron creados. Como señala la documentación, dado que TRT-LLM optimiza el modelo para el tipo y número de GPU objetivo, es importante que el tipo y el número de GPU coincidan durante el despliegue.
| Motor | Idea central | Ideal para | Compromiso (tradeoff) |
| --- | --- | --- | --- |
| vLLM | Cache KV PagedAttention | Alto rendimiento general, amplio soporte de modelos | Excelente opción por defecto, no siempre la latencia más baja |
| SGLang | Reutilización de prefijos RadixAttention | Prompts compartidos, agentes, salidas estructuradas | Las mayores ventajas requieren reutilización de prefijos |
| TensorRT-LLM | Motores compilados de NVIDIA | Menor latencia en GPU de NVIDIA | Paso de compilación, motor vinculado a la GPU |
Cualquier cifra de rendimiento es específica de cada carga de trabajo. Realice pruebas de rendimiento en su propio tráfico antes de tomar una decisión. TrueFoundry es compatible con los tres motores, por lo que el motor se puede adaptar a la carga de trabajo.
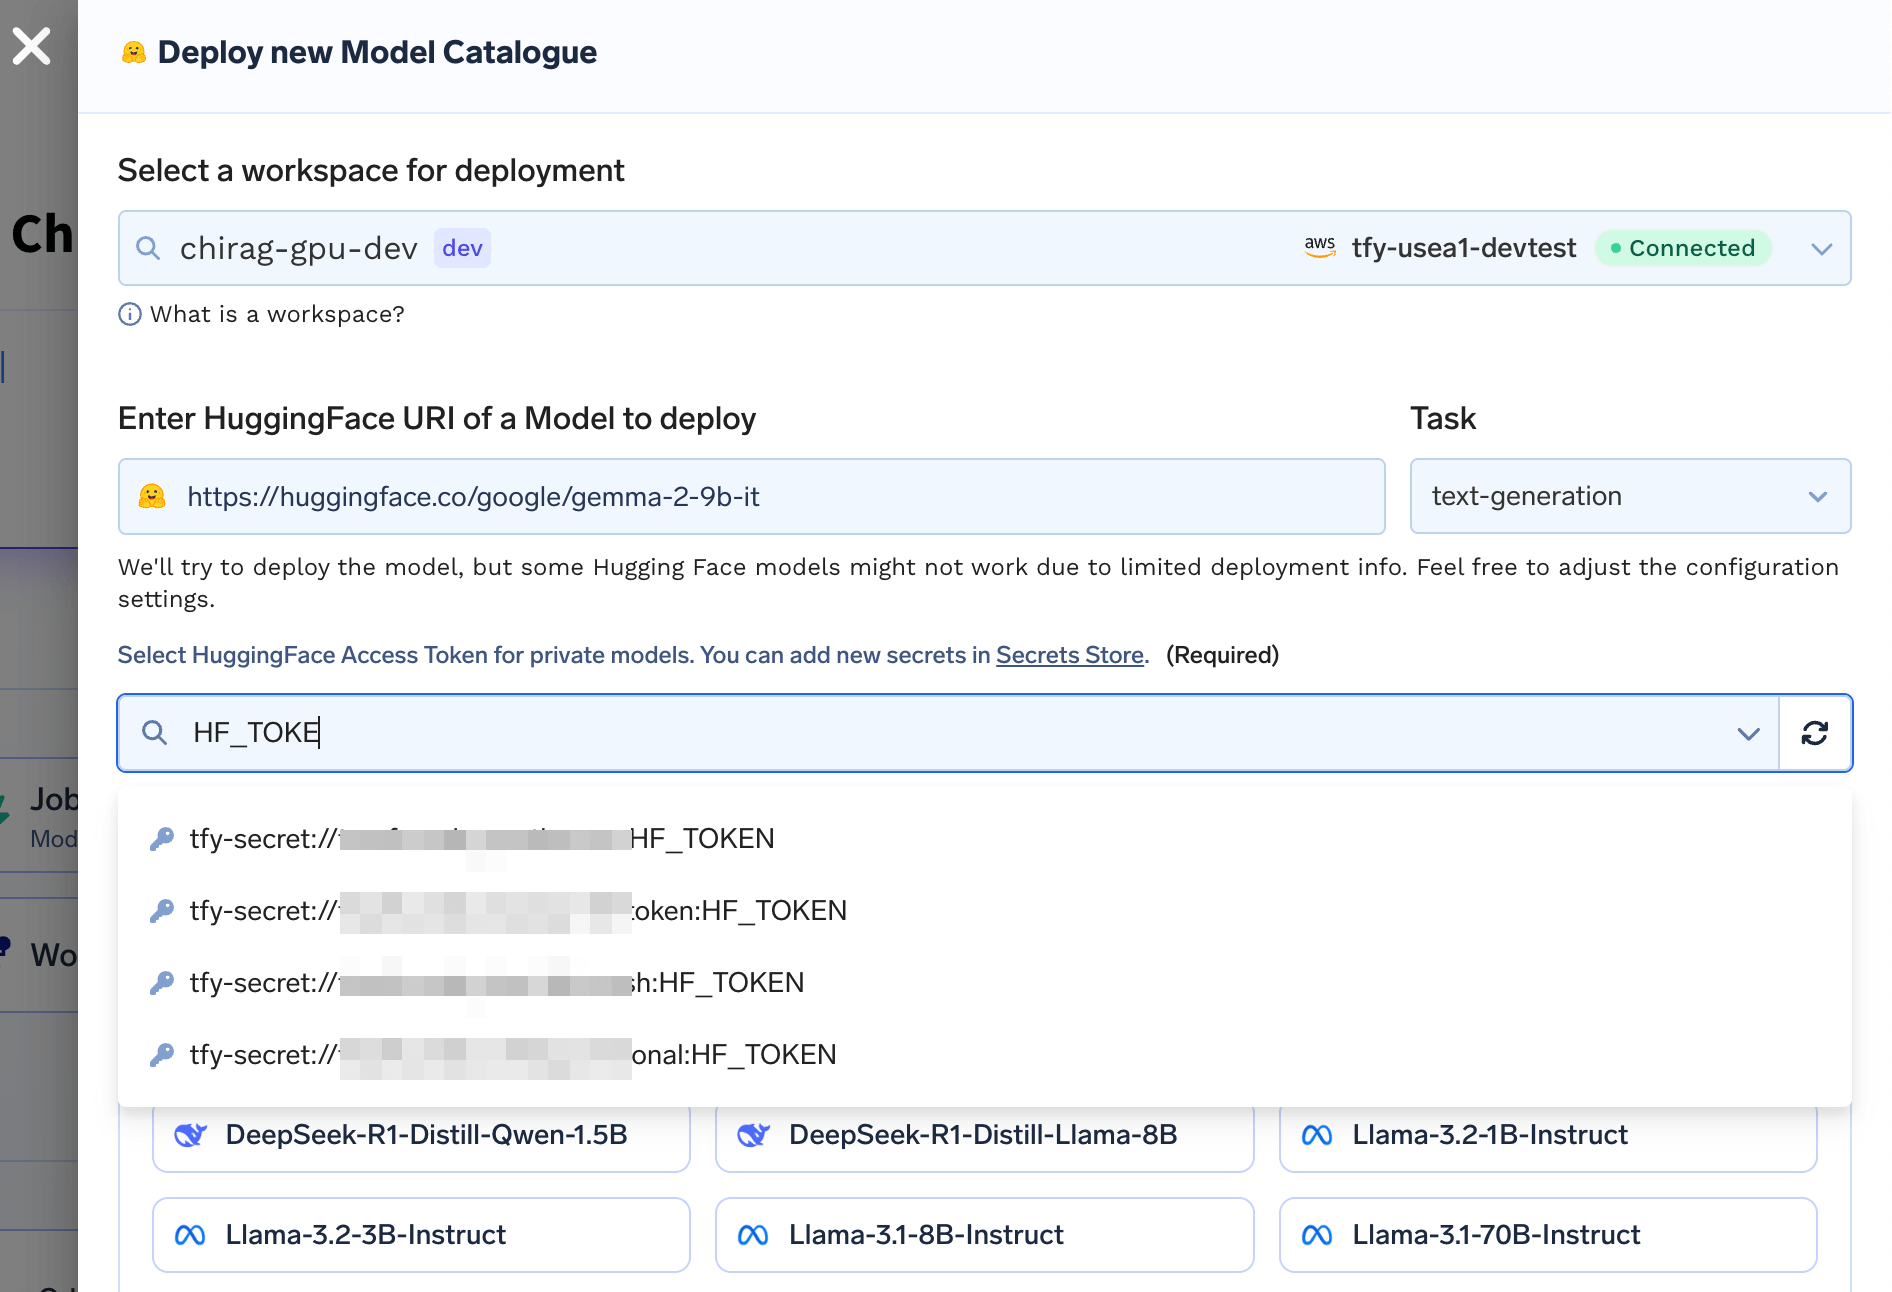
Para vLLM y SGLang, la vía es el catálogo de modelos. Tal como indica la documentación, TrueFoundry simplifica el proceso de despliegue de un LLM al determinar automáticamente la forma más óptima de desplegarlo y configurar el conjunto correcto de GPU.
Puede elegir uno de los modelos del catálogo de LLM o pegar una URL de un modelo de Hugging Face. TrueFoundry analiza las etiquetas y los archivos del modelo para comprender el framework de despliegue y genera los manifiestos de despliegue. Usted conserva total flexibilidad para elegir el servidor de modelos más óptimo, lo que garantiza una inferencia más rápida. La plataforma también utiliza streaming y almacenamiento en cache de imágenes, lo que proporciona tiempos de descarga 3 veces más rápidos para las imágenes de vLLM y SGLang.
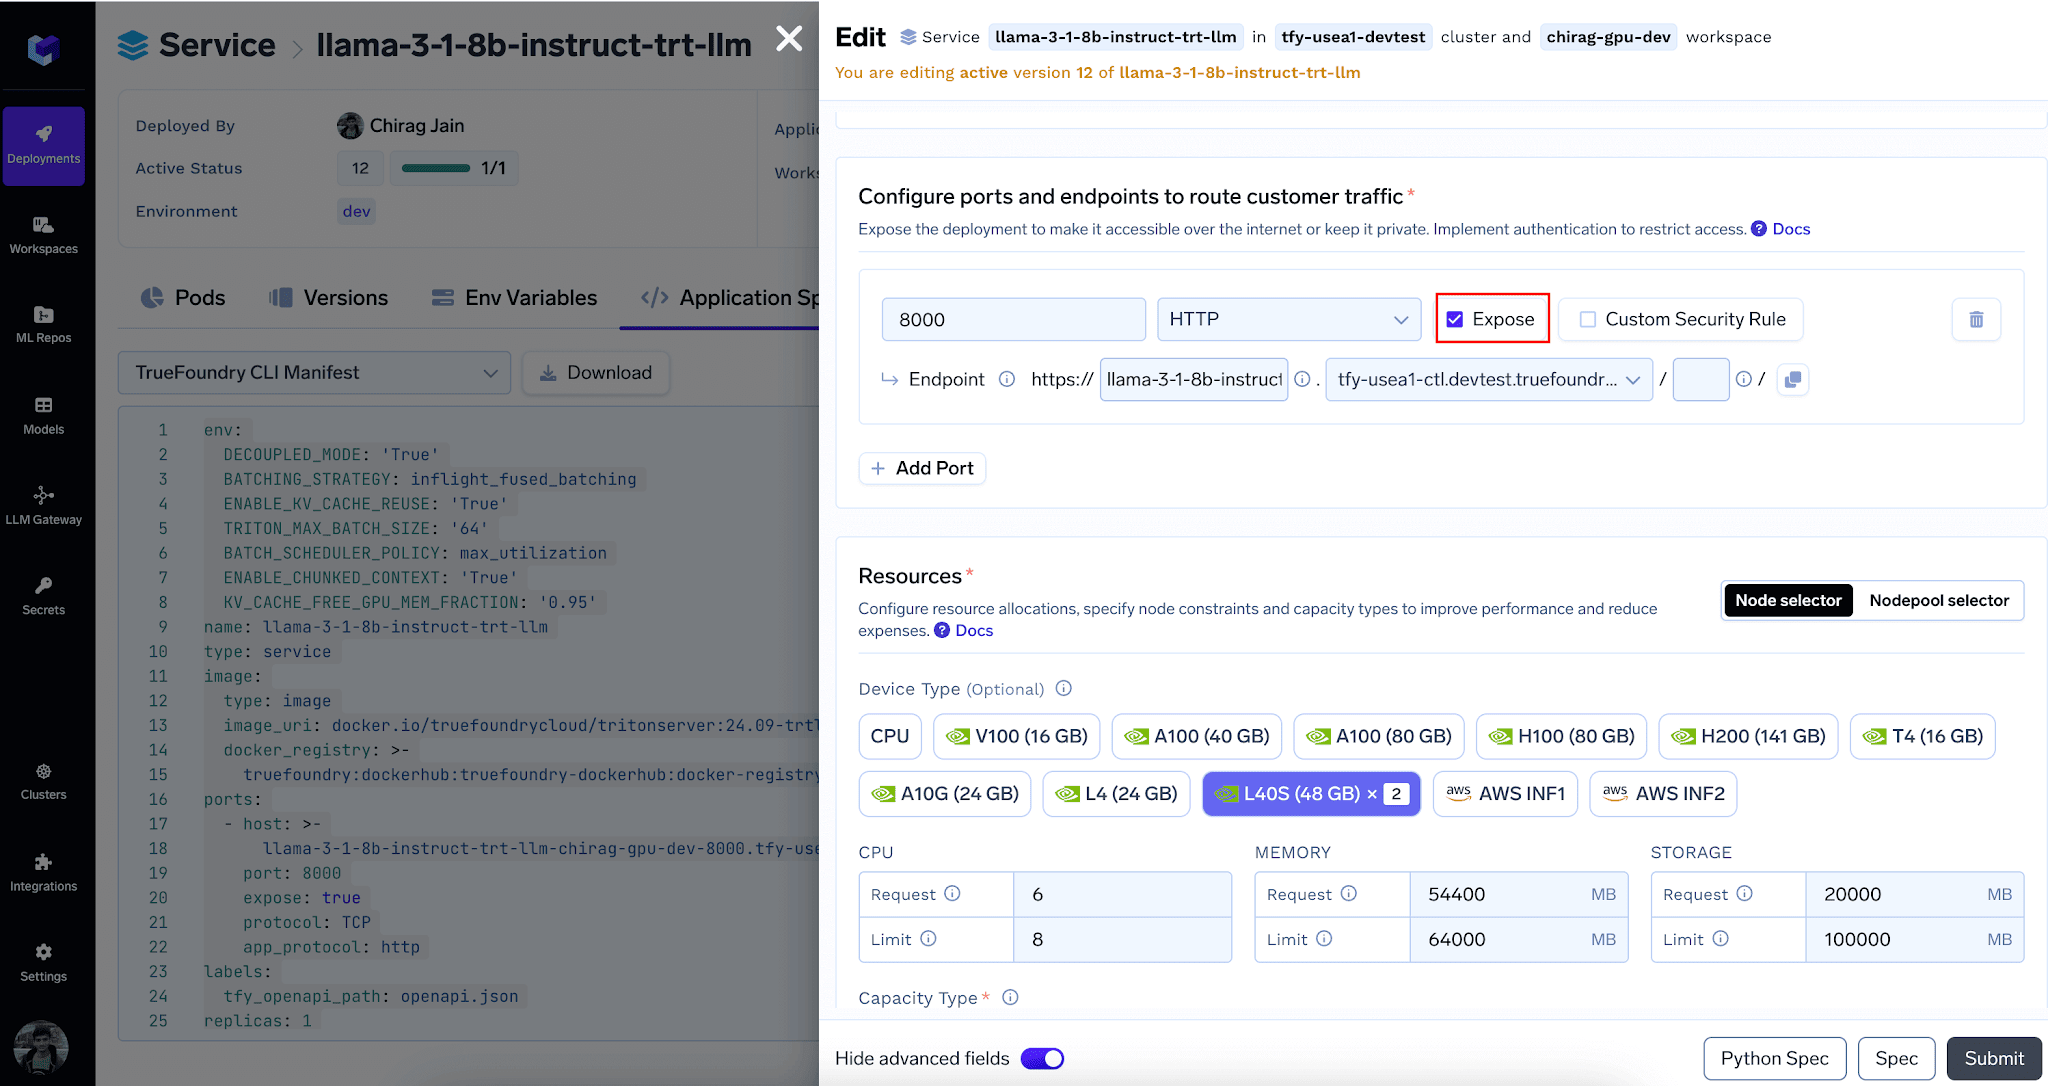
TensorRT-LLM no se activa con un solo clic, ya que los motores deben compilarse para la GPU objetivo. La guía dedicada utiliza un flujo de compilación y posterior servicio.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.






It depends on the model, GPU, and workload. TensorRT-LLM often reaches lower latency on NVIDIA GPUs because it compiles a model specific engine, while vLLM offers excellent throughput and broader model coverage with no build step. Benchmark both on your own traffic.
Choose SGLang when your prompts share long prefixes, such as shared system prompts or agentic multi turn flows, or when you need fast, reliable structured outputs like JSON or grammar constrained decoding. Its RadixAttention is designed for prefix reuse.
Yes. TrueFoundry supports vLLM, SGLang, and TRT-LLM as model servers. vLLM and SGLang are selectable in the catalogue flow, and TensorRT-LLM has a dedicated build and serve guide. Any OpenAI compatible endpoint can be added to the AI Gateway.
Because TensorRT-LLM compiles the engine for a specific GPU type and count, the serving deployment must use the same GPU type and count as the builder job. This is what lets it reach its latency and efficiency targets.



Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada














