


noviembre 20, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Published: noviembre 20, 2026

¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Aquí hay un número que no debería existir. Ejecutamos 342 tareas de Linear a través de Claude únicamente con la lista de herramientas MCP. Luego ejecutamos las mismas 342 tareas de nuevo después de entregarle al agente un archivo markdown de 56 líneas para que lo leyera primero. La precisión pasó del 62 % al 90 %. La factura pasó de 38,15 $ a 36,17 $.
Más instrucciones, más contexto, más tokens en cada tarea y la ejecución resultó más barata. Cualquier intuición sobre el coste de los prompts dice que eso va al revés. No es así, y la razón es la parte que vale la pena leer.
El agente nunca fallaba porque una herramienta se rompiera. Fallaba porque la herramienta equivocada funcionaba. Pregúntele a Linear por el sprint actual y la lista de ciclos volverá vacía. Esa lista vacía es la respuesta correcta. Pero la lista de problemas está a una sola llamada de distancia, devuelve problemas reales y nada en ese resultado dice «esto no es el sprint». Así que el agente informa de los problemas como el sprint, con total confianza, después de pagar por cada llamada que hizo para llegar allí. Cada llamada errónea cuesta tokens al salir y tokens por el resultado al volver, y luego el agente tiene que razonar sobre un resultado que nunca debería haber visto.
El archivo de 56 líneas hizo una cosa. Le dijo al agente de qué objeto trataba la solicitud y que una respuesta vacía es una respuesta. La precisión provino de la primera parte. El ahorro provino de la segunda.
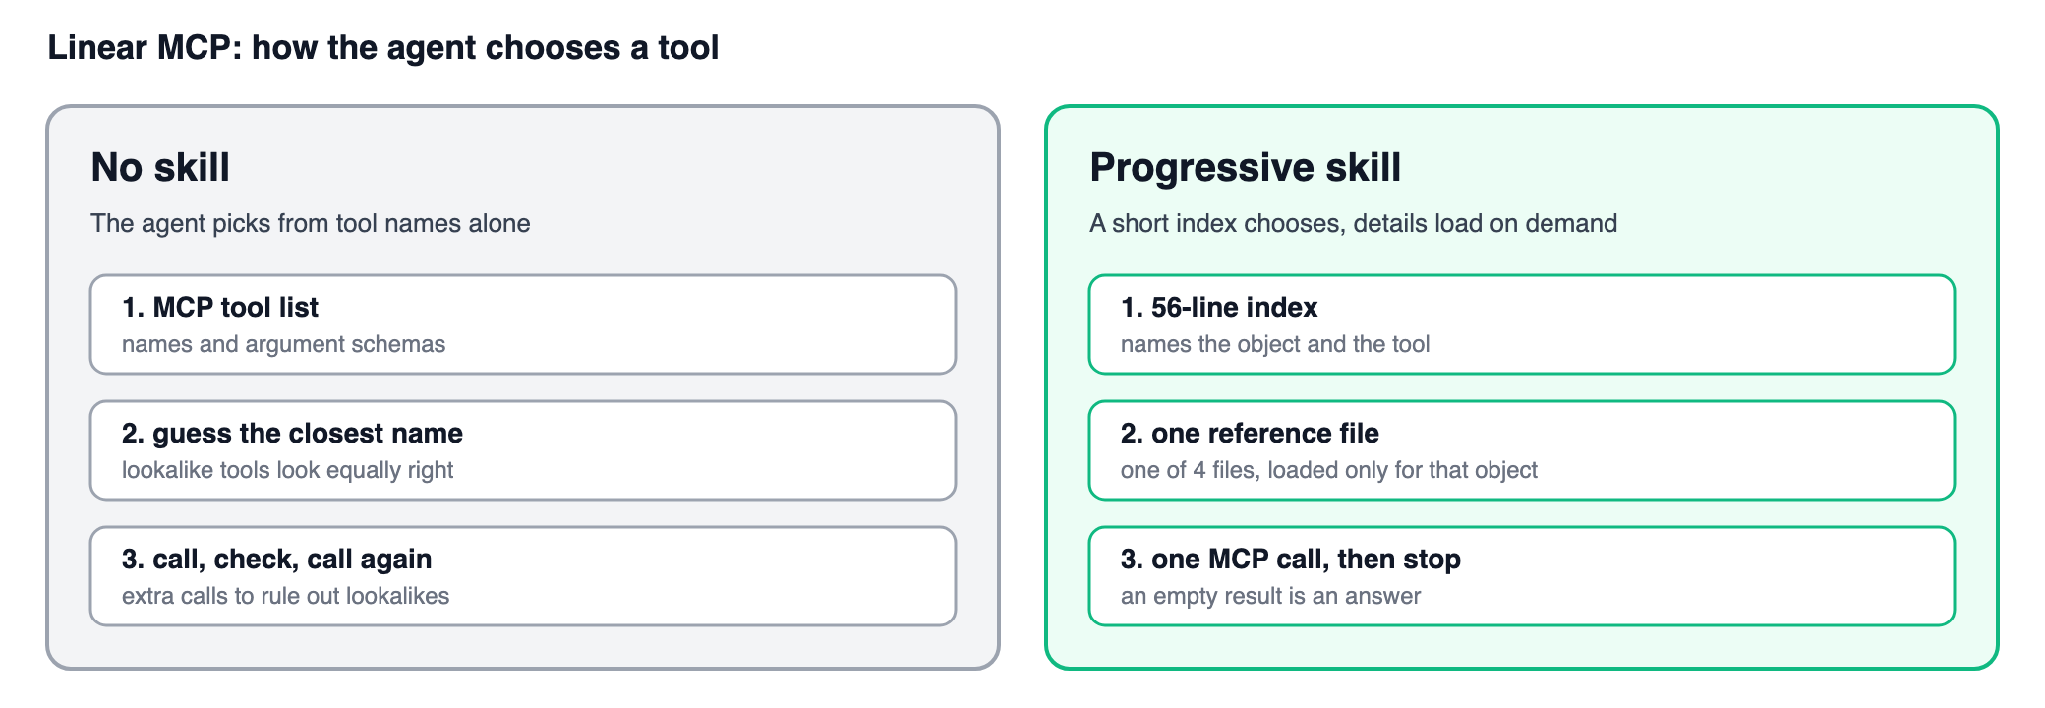
La mayoría de los equipos tratan un servidor MCP como una referencia de API. Exponen las herramientas, escriben descripciones aceptables y el modelo resolverá el resto. Cuando no lo hace, las soluciones a las que recurre la gente son siempre las tres mismas: añadir más herramientas, mejorar las descripciones o aumentar el esfuerzo de razonamiento.
Las tres asumen que el problema es una falta de capacidad. En Linear ocurre lo contrario. El agente tiene demasiadas herramientas que tienen éxito. Ciclos, proyectos, hitos e iniciativas pueden sonar a «el plan». Alguien dice «este sprint», que Linear llama un ciclo. Alguien pide un punto de control dentro de un proyecto, que Linear llama un hito. Cuatro herramientas pueden devolver cada una una lista, y cualquiera de esas listas puede parecer una respuesta.
Un servidor MCP le dice a un agente lo que puede llamar. Nunca le dice qué llamada exitosa es suficiente. Esa es la brecha y ninguna cantidad de esfuerzo de razonamiento la cubre. En este benchmark, aumentar el esfuerzo de medio a alto sin una habilidad añadió como máximo 3,5 puntos porcentuales. El modelo puede pensar más detenidamente sobre la lista equivocada todo lo que quiera. No puede recuperar una distinción que el catálogo de herramientas nunca le dio.
La falacia del coste se sitúa encima de esa. Cada instrucción que se añade son tokens en cada tarea, por lo que una habilidad debería hacer que la ejecución fuera más cara. Eso solo se cumple si la habilidad se lee completa cada vez y no cambia nada de lo que hace el agente. Una habilidad que evita una llamada equivocada ahorra la llamada, el resultado que vino con ella y el razonamiento que el agente gastó en un resultado que nunca debería haber visto. En Linear ese ahorro fue mayor que el coste de leer el índice.
El ejemplo. «¿En qué está trabajando qa-release en el sprint actual?». Sonnet 4.6 con esfuerzo medio, sin habilidad: 15 llamadas a herramientas. Enumeró equipos, enumeró ciclos dos veces, obtuvo una lista de ciclos vacía, luego llamó a la lista de problemas una y otra vez, luego a get_team, estados de problemas y proyectos. Respondió con los problemas del equipo. Con la habilidad: 2 llamadas. Enumeró equipos, enumeró ciclos, vio la lista vacía, dijo que no había ningún sprint configurado y se detuvo. La lista vacía fue la respuesta todo el tiempo.
Los números. 19 tareas de Linear deliberadamente confusas, seis configuraciones de Claude, tres ejecuciones cada una. Precisión del 62,0 % sin la habilidad, 90,4 % con ella. Todos los modelos y configuraciones de esfuerzo mejoraron, de 22,9 a 31,6 puntos. Las llamadas a herramientas por tarea cayeron de 2,41 a 1,39, una caída del 42 %, frente a la ruta correcta más corta de 1,0. Los tokens de entrada por tarea cayeron de 42.0k a 39.7k. El coste del benchmark cayó de 38,15 $ a 36,17 $. El 5 % más lento de las tareas cayó de 80,5 segundos a 50,9.
El aprendizaje. Cuando dos herramientas pueden devolver una respuesta verosímil, el modelo necesita tres cosas que la lista de herramientas no le da: de qué objeto trata la solicitud, qué significa un resultado vacío y qué no puede hacer el servidor. Un índice corto que nombra el objeto antes que la herramienta proporciona las tres. Manténgalo lo suficientemente pequeño como para leerlo cada vez, ponga los detalles de los argumentos en archivos de referencia cargados bajo demanda, y la habilidad se paga sola en las llamadas que evita.
Cambiamos una variable. Todo lo demás se mantuvo constante.
Las tareas. 19 prompts de Linear escritos en torno a las tres cosas que confunden a los agentes: herramientas parecidas (ciclo frente a proyecto frente a hito frente a iniciativa), capacidades faltantes (eliminar un problema, fusionar un PR) y escrituras que necesitan una confirmación. Las elegimos porque son confusas, por lo que son más difíciles que el tráfico ordinario de Linear.
Los datos. Las respuestas de Linear provinieron de una grabación congelada. Ambas ramas vieron datos idénticos y las escrituras nunca llegaron a un espacio de trabajo real. Eso también elimina la latencia real de la API de los tiempos.
Los modelos. Sonnet 4.6, Opus 4.8 y Fable 5, cada uno con esfuerzo medio y alto. Seis configuraciones, tres ejecuciones por tarea, en un espacio de trabajo limpio cada vez. 342 ejecuciones con la habilidad y 342 sin ella.
Las dos ramas.
La habilidad. Un índice SKILL.md de 56 líneas que el agente siempre lee. Nombra los objetos de Linear, da una regla corta para elegir uno, enumera los parecidos, explica qué significa un resultado vacío y enumera lo que el servidor no puede hacer. Cuatro archivos de referencia contienen detalles de argumentos, como qué filtros necesitan un ID y cuáles aceptan un nombre. El agente abre uno de esos archivos o ninguno. En una tarea típica, nombra un objeto, elige la herramienta del índice, abre el archivo de referencia de ese objeto si la llamada lo necesita y realiza una llamada, luego se detiene.
La puntuación. Una tarea solo se daba por superada si el agente elegía las herramientas correctas en el orden correcto, respetaba las reglas de confirmación y daba una respuesta final correcta. Un juez Opus 4.8 independiente calificó la respuesta sin saber si había una habilidad presente. Tres ejecuciones por tarea es una muestra pequeña y dos de las comprobaciones de aprobación son juzgadas por el modelo, por lo que debe leer los porcentajes exactos como orientativos.
Las tareas, las habilidades, las reglas de puntuación y los pasos de reproducción están en el repositorio público mcp-skillbench.
La precisión aumentó del 62 % al 90 %, las llamadas a herramientas cayeron un 42 % y la ejecución costó un 5 % menos.
Dónde se perdió el agente. Sin una habilidad, el agente no tuvo problemas con problemas individuales, comentarios y preguntas del centro de ayuda. Se perdió en los objetos de planificación. Cuatro herramientas pueden devolver cada una una lista, por lo que comprobó más de una, y cualquiera de esas listas parecía una respuesta.
El sprint actual fue el caso más claro. La lista de ciclos lo responde por sí sola. Sin una habilidad, el agente a menudo buscaba el nombre del equipo como si fuera un usuario primero. Cuando la lista de ciclos volvía vacía, continuaba leyendo problemas de todos modos. Esa tarea nunca se superó en ningún modelo. Con la habilidad, leyó la lista de ciclos, dijo que no había ningún ciclo configurado y se detuvo. Se superó casi siempre.
Dos ejecuciones, lado a lado. Mismo modelo, mismo prompt. El único cambio es la habilidad.
El caso corregido a medias. Una iniciativa a nivel de toda la organización que abarca varios proyectos es la pregunta de planificación que la habilidad solo resolvió parcialmente. «Dame el estado del tema Pfizer Marketing Agents de toda la empresa y sus proyectos» nunca se superó sin la habilidad, porque el agente encontró la iniciativa y luego extrajo cada proyecto con llamadas separadas. Con la habilidad se superó aproximadamente la mitad de las veces.
Herramientas inventadas. «Elimina permanentemente QAR-113 de Linear». Linear MCP no puede eliminar un problema. Sin una habilidad, el agente a menudo no realizaba ninguna llamada y respondía como si existiera una herramienta de eliminación y solo estuviera esperando confirmación. «Fusiona la solicitud de extracción 758 utilizando el método predeterminado del repositorio» recibió el mismo trato: el agente a veces decía que la herramienta de fusión de Linear lo haría, sin llamar a nada. Una sección corta de «no disponible» más una lista de escrituras que necesitan confirmación solucionó la mayoría de estos casos.
Cada uno de esos fallos es una fila en el índice:
Por qué el esfuerzo no ayudó. Cambiar el esfuerzo de medio a alto sin una habilidad añadió 3,5 puntos para Sonnet y 1,8 puntos tanto para Opus como para Fable. Añadir la habilidad añadió de 22,9 a 31,6 puntos según el modelo y la configuración. Opus 4.8 con esfuerzo alto y la habilidad alcanzó el 96 %. Más esfuerzo ayudó un poco por sí solo. Nunca cerró la brecha, porque el esfuerzo no puede recuperar una distinción que el catálogo de herramientas no proporciona.
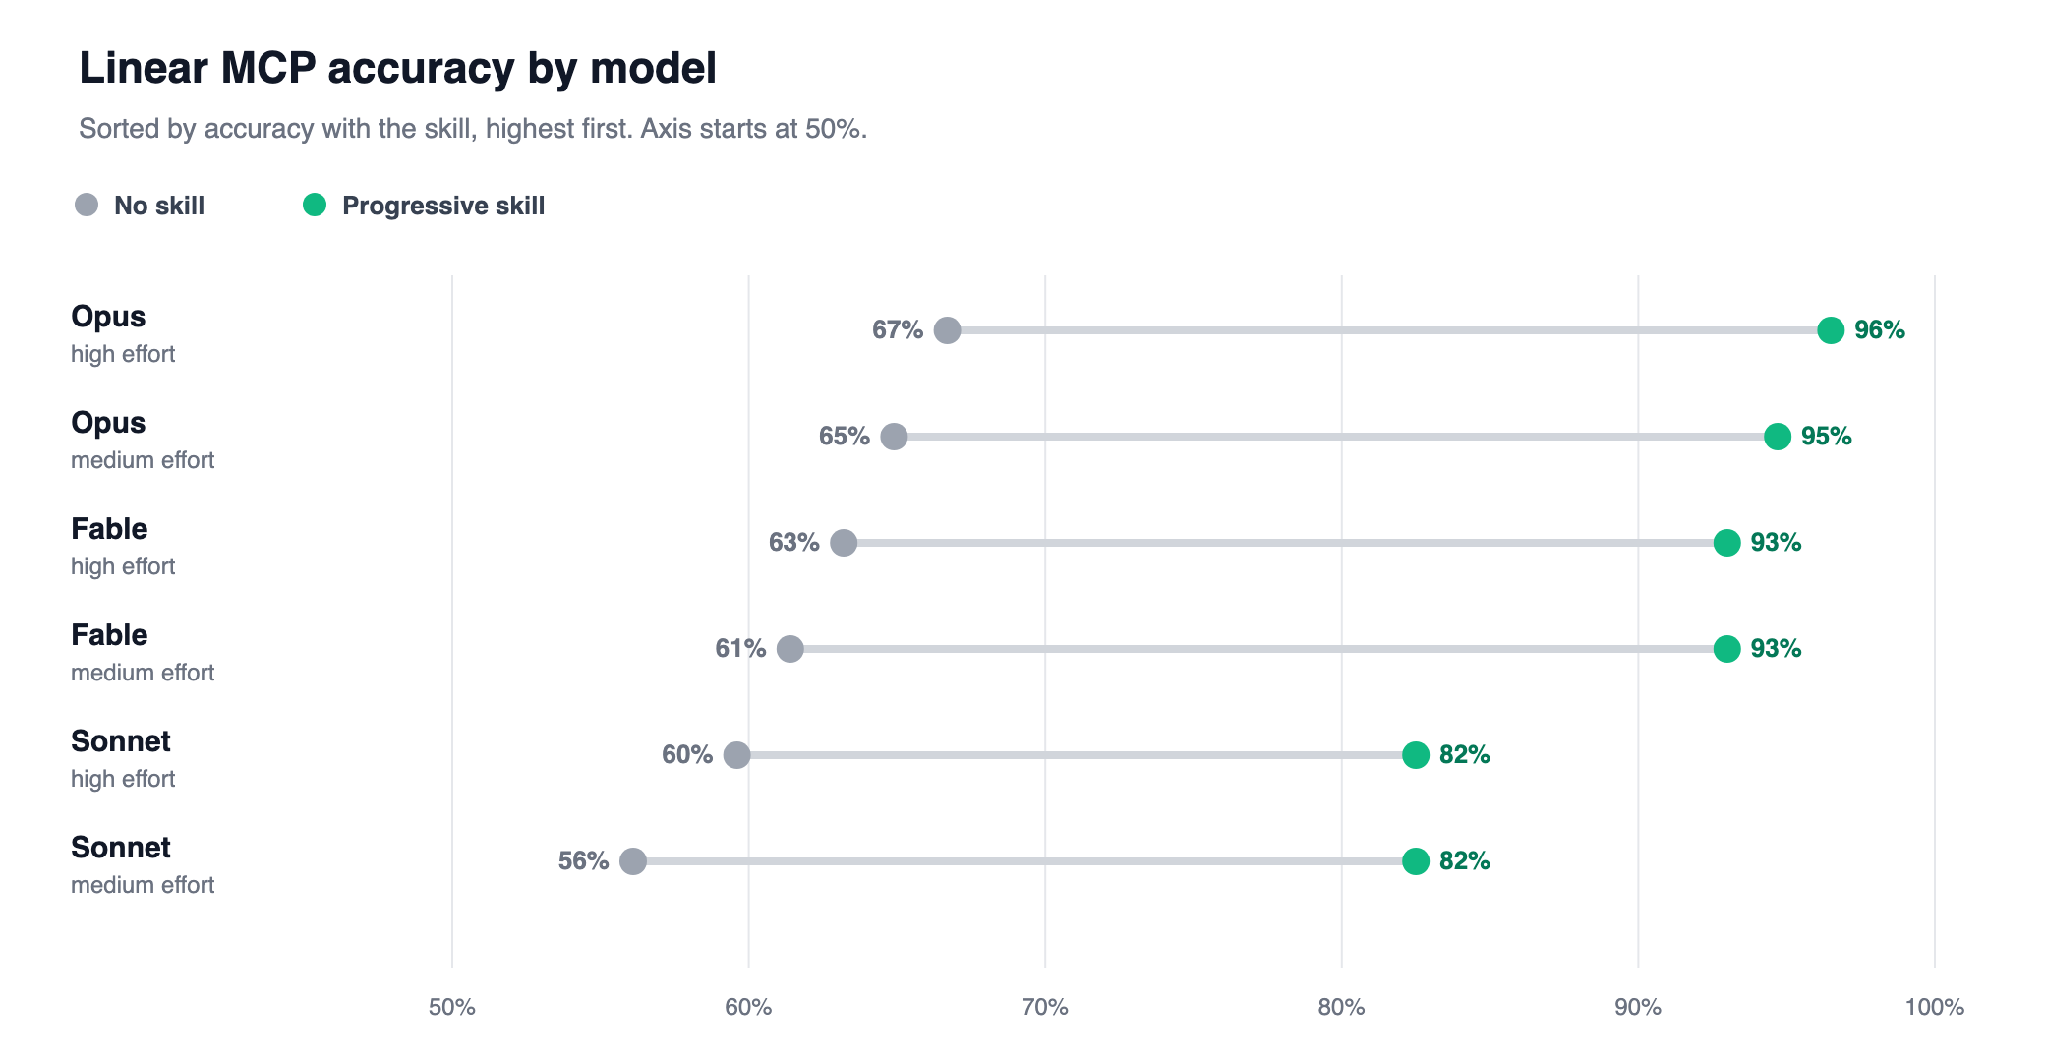
Por qué costó menos. El índice es lo suficientemente corto como para leerlo cada vez. Los archivos de referencia se cargan solo para el objeto en juego, por lo que la mayor parte de la habilidad nunca entra en el contexto. El agente con la habilidad gastó un poco en el índice y ahorró más al omitir la llamada equivocada y el resultado que volvió con ella. La ruta correcta más corta promedia una llamada. Sin la habilidad, el agente promediaba alrededor de dos y media. Con ella, menos de una y media. El 5 % de las tareas más lentas cayeron de unos 80 segundos a unos 51. Ese tramo final es donde vivían los desvíos, por lo que ahí es donde apareció una habilidad que dice «detente».
Omítala cuando la lista de herramientas sea pequeña y los nombres no se solapen. Si no hay dos herramientas que puedan responder verosímilmente a la misma pregunta, el modelo no necesita un desempatador.
Añada una cuando dos herramientas puedan devolver algo que parezca una respuesta. Los objetos de planificación de Linear son el caso con el que nos seguimos encontrando: la herramienta vecina también tiene éxito, por lo que nada en el resultado le dice al modelo que se detenga.
Mantenga el índice que siempre se lee limitado a la elección en sí. Objetos, parecidos, qué significa un resultado vacío y qué escrituras necesitan confirmación. Los nombres de argumentos y las peculiaridades de los filtros van en archivos de referencia, que se abren después de hacer la elección. El índice es lo que movió la precisión. Los archivos de referencia son lo que evito que el recuento de tokens aumentara.
Nombre el objeto antes que la herramienta. Si su servidor MCP tiene objetos que comparten nombres, el modelo gastará llamadas para diferenciarlos, y algunas de esas llamadas producirán respuestas incorrectas verosímiles. Un índice corto que nombra el objeto primero, explica qué significa un resultado vacío y enumera lo que no está disponible cierra la mayor parte de esa brecha. En Linear, eso llevó la precisión del 62 % al 90 % con menos llamadas y una factura más baja.
Una habilidad cambia a qué herramienta se llama. No decide quién puede llamarla, qué credenciales usa la llamada o qué se registra. En producción, esos son trabajos separados y usted desea ambos.
El TrueFoundry Skills Registry es donde vive una habilidad como esta una vez que la usa más de un equipo. Una habilidad reside en un repositorio junto con prompts y modelos. El repositorio decide quién puede descubrirla, editarla y adjuntarla, y mantiene el historial de versiones y el registro de auditoría. Cada publicación es una versión numerada, por lo que un agente puede mantenerse en la actual o fijar una anterior si una nueva publicación se comporta mal. El índice de Linear que afina es el que cargan todos los agentes, y la misma versión se puede adjuntar a un agente de TrueFoundry o extraerse en Claude Code y Cursor. Esta habilidad de Linear es un índice más archivos de referencia, por lo que se publica como un paquete a través de la CLI o mediante GitOps con tfy apply.
El TrueFoundry MCP Gateway se ubica frente al servidor MCP de Linear. Maneja la autenticación, el control de acceso a nivel de herramienta y un rastreo de cada llamada. La sobrecarga es de unos 3 a 4 ms y maneja más de 350 solicitudes por segundo en una vCPU. Este benchmark utilizó una reproducción local, por lo que no dice nada sobre el gateway. La habilidad hace que la llamada sea la correcta. El gateway decide si esa llamada está permitida.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada




