


noviembre 20, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Published: noviembre 20, 2026

¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Elija casi cualquier producto de LLM lanzado en los últimos tres años e inspeccione su API. Es muy probable que acepte una solicitud con un campo model, un array messages de objetos {role, content} y temperature, y devuelva un array choices con un bloque usage que cuenta los tokens. Esa estructura no proviene de un organismo de normalización. Proviene de la API Chat Completions de OpenAI, y se impuso.
Para un equipo de plataforma, "compatible con OpenAI" es una frase estructural. Es la razón por la que puede evaluar un nuevo modelo de código abierto el viernes y tenerlo sirviendo tráfico el lunes sin reescribir su aplicación. También es una frase que promete sutilmente más de lo que da: dos puntos de enlace pueden ser "compatibles con OpenAI" y, aun así, diferir en cómo devuelven las llamadas a herramientas, cómo cuentan los tokens y si el parámetro que ha configurado realmente hace algo.
Esta publicación explica qué es realmente el estándar, qué garantiza la "compatibilidad" y qué no, y cómo una pasarela convierte a muchos proveedores parcialmente compatibles en un único punto de enlace sobre el que puede construir con total confianza.
¿Desea un único punto de enlace compatible con OpenAI en todos los proveedores, con conmutación por error y seguimiento de costes? Reserve una demostración.
Los estándares suelen imponerse por una de dos razones: se mandan de forma obligatoria o llegan primero y se adoptan antes de que nadie diseñe una alternativa. El esquema Chat Completions pertenece claramente al segundo tipo.
OpenAI publicó el punto de enlace /v1/chat/completions y, lo que es más importante, distribuyó SDK oficiales de Python y JavaScript que lo integraban. Esos SDK se incorporaron en tutoriales, plantillas de inicio, integraciones de frameworks y bases de código en producción en toda la industria. Para cuando los proveedores competidores tuvieron modelos que valía la pena ofrecer, la superficie de integración ya se había estandarizado en la práctica: millones de líneas de código ya sabían cómo llamar a client.chat.completions.create(...).
Un nuevo proveedor se enfrentaba entonces a una decisión. Definir su propia API elegante y pedir a todo el ecosistema que la aprendiera, o implementar el esquema de OpenAI y heredar todos los SDK, frameworks y herramientas de forma gratuita. Casi todos eligieron la segunda opción. Las infraestructuras de despliegue de modelos de código abierto la adoptaron para que cualquier elemento que se ejecutara sobre ellas fuera accesible al instante desde el código existente. El resultado es un estándar de facto sin un documento oficial de especificaciones: el esquema es "lo que el SDK de OpenAI envía y espera recibir".
Por este motivo, la frase importa más de lo que parece. La compatibilidad no es una función adicional que un proveedor incluye por cortesía. Es el billete de entrada a un ecosistema y determina cómo se puede diseñar la arquitectura en torno a la elección del modelo.
En esencia, la compatibilidad es un contrato que abarca cuatro aspectos: el punto de enlace, la estructura de la solicitud, la estructura de la respuesta y la transmisión de datos (streaming).
El punto de enlace. Un servicio compatible acepta POST /v1/chat/completions con una cabecera Authorization: Bearer <key>. Muchos también implementan /v1/models, /v1/embeddings y /v1/completions. La URL base cambia según el proveedor; la ruta permanece inalterada.
La estructura de la solicitud. Como mínimo: una cadena model y un array messages de objetos con un rol role (system, user, assistant, tool) y un contenido content. Los parámetros opcionales que el cliente puede enviar incluyen temperature, top_p, max_tokens (los modelos de OpenAI más recientes usan max_completion_tokens), stream, stop, tools, tool_choice y response_format.
La estructura de la respuesta. Un objeto JSON con un array choices; cada opción tiene un index, un objeto message con role y content (y tool_calls cuando el modelo llama a una función), y un motivo de finalización finish_reason (stop, length, tool_calls, content_filter). Un objeto usage reporta prompt_tokens, completion_tokens y total_tokens.
Transmisión de datos (streaming). Con stream: true, la respuesta es un flujo text/event-stream de eventos enviados por el servidor (SSE). Cada línea data: contiene un fragmento cuyo objeto choices[].delta incluye los tokens incrementales. La transmisión finaliza con un literal data: [DONE].
Aquí se observa el beneficio concreto. Este cuerpo de solicitud se dirige a OpenAI:
POST https://api.openai.com/v1/chat/completions
Authorization: Bearer sk-...

{
  "model": "gpt-4.1",
  "messages": [
    {"role": "system", "content": "You are a terse assistant."},
    {"role": "user", "content": "Summarize MCP in one sentence."}
  ],
  "temperature": 0.2,
  "stream": false
}
Para ejecutar el mismo prompt contra un proveedor diferente a través de un punto de enlace compatible, basta con cambiar dos elementos: la URL base y el valor de model. Los campos messages, temperature y stream permanecen intactos. Su código de procesamiento, que lee choices[0].message.content y usage.total_tokens, no cambia en absoluto. Esa es toda la propuesta de valor resumida en una diferencia: la elección del modelo se convierte en una cadena de texto, no en una reescritura de código.
La respuesta, independientemente del backend que la haya procesado, se devuelve como:
{
  "id": "chatcmpl-...",
  "choices": [
    {"index": 0,
     "message": {"role": "assistant", "content": "MCP is an open protocol..."},
     "finish_reason": "stop"}
  ],
  "usage": {"prompt_tokens": 24, "completion_tokens": 18, "total_tokens": 42}
}
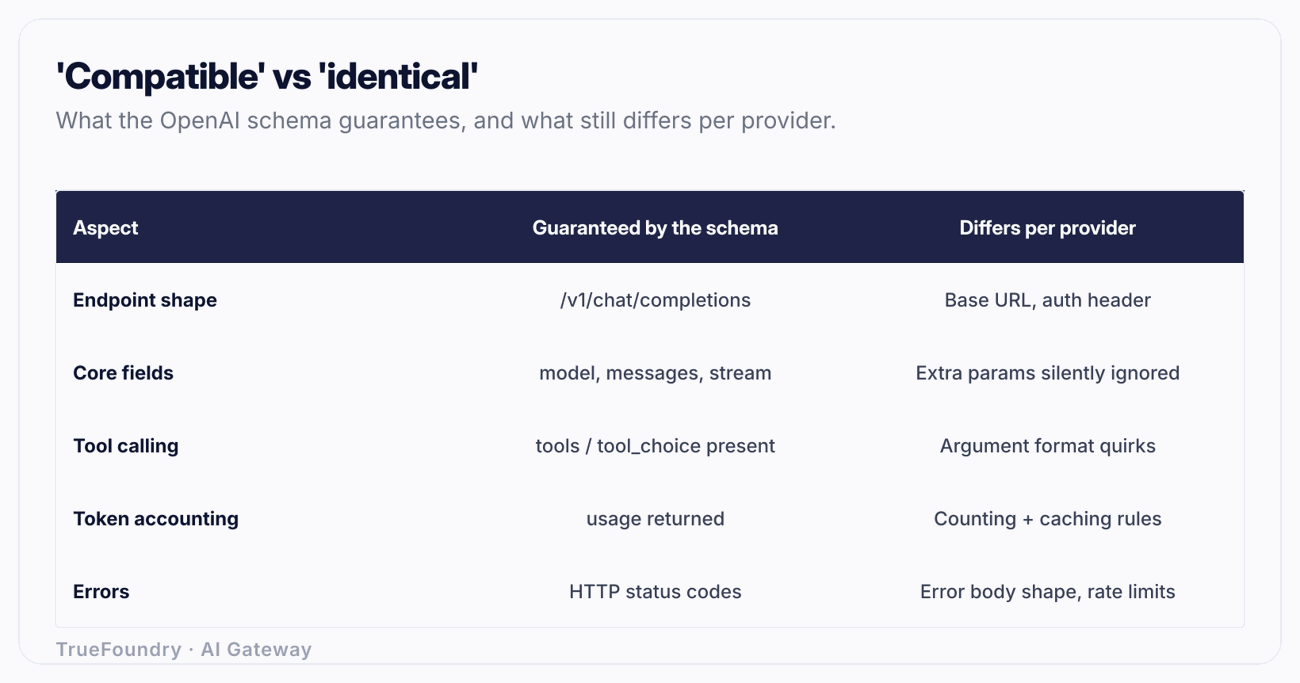
Aquí es donde los equipos suelen encontrar problemas. "Compatible con OpenAI" es una afirmación sobre el esquema, no una garantía de un comportamiento idéntico. La estructura externa coincide; sin embargo, el contenido puede diferir de formas que solo salen a la luz bajo carga de trabajo o en casos límite.
Dialectos de llamada a herramientas. Es la mayor divergencia. OpenAI devuelve las llamadas a funciones en message.tool_calls, cada una con un id, un type y un objeto function cuyo arguments es un bloque JSON convertido en cadena que se debe procesar. Algunos backends compatibles devuelven los argumentos como un objeto ya procesado, emiten el campo único más antiguo function_call, transmiten los cambios incrementales de llamadas a herramientas de forma distinta o gestionan las llamadas paralelas de manera inconsistente. El código que aplique JSON.parse a los argumentos sin verificar generará un error en un backend que ya los haya procesado.
Contabilidad de tokens. Los recuentos de usage los calcula el tokenizador propio de cada proveedor. El mismo prompt enviado a dos modelos genera un número diferente de prompt_tokens debido a las diferencias entre sus tokenizadores. Peor aún, algunos backends omiten usage por completo en las respuestas transmitidas a menos que se configure una marca específica, por lo que el seguimiento de costes que depende de ello registra cero silenciosamente.
Parámetros inoperantes que no generan error. Es posible enviar seed, logit_bias, frequency_penalty, presence_penalty o response_format: {type: "json_schema"} a un punto de enlace compatible y recibir una respuesta 200 OK, ignorando el parámetro por completo. El punto de enlace aceptó el campo porque el esquema lo permite; simplemente, el backend no lo implementa. Esta es la clase de error más compleja porque nada falla de forma explícita. Su flujo "determinista" que depende de seed se vuelve indeterminado sin previo aviso.
Tratamiento de mensajes de sistema y roles. Algunos backends integran el mensaje de system en el primer turno del usuario, admiten un único mensaje de sistema o tratan un valor de content vacío de forma diferente. El comportamiento en conversaciones de varios turnos puede variar.
Semántica del motivo de finalización. Cuando un modelo se detiene porque necesita llamar a una herramienta, OpenAI indica finish_reason: "tool_calls". No todos los backends utilizan la misma cadena, lo que interrumpe los bucles de agentes que toman decisiones según ese valor.
La siguiente tabla distingue lo que el estándar ofrece de manera fiable de lo que se debe verificar en cada proveedor.
La conclusión no es que "la compatibilidad sea falsa". Es que "la compatibilidad le resuelve el 90 % de forma directa y debe probar el 10 % restante en cada proveedor". Ese 10 % final es precisamente el trabajo que una pasarela puede absorber para que su aplicación no tenga que gestionarlo nunca.
Descubra cómo TrueFoundry le permite cambiar modelos por nombre sin modificar el código de su aplicación. Reserve una demostración.
Si todos los proveedores son casi compatibles pero ligeramente diferentes, la arquitectura idónea consiste en evitar que la aplicación se comunique directamente con cada uno de ellos. Se sitúa un único punto de enlace compatible con OpenAI frente a todos los proveedores y se permite que esa capa gestione la traducción y la normalización.
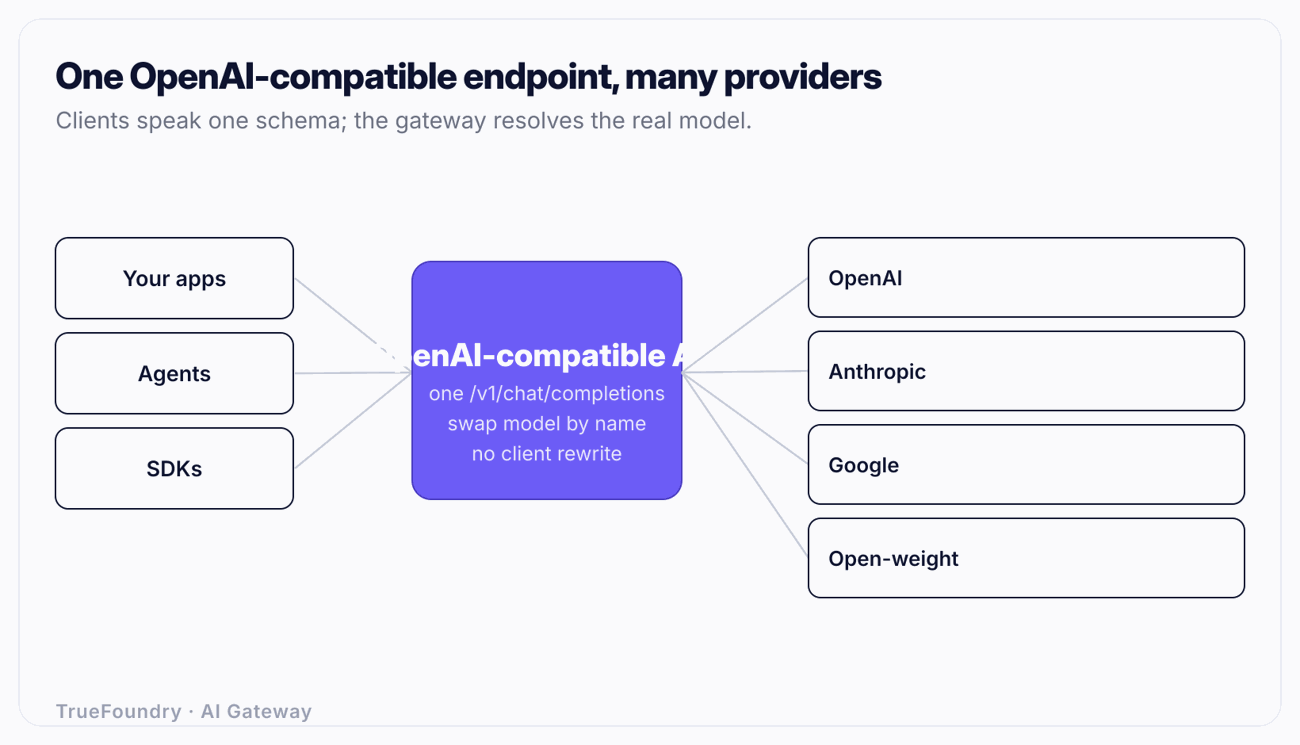
Esto es lo que hace una pasarela de IA y es estructuralmente la misma idea que un proxy de LLM: una única puerta de entrada lógica con múltiples backends detrás. TrueFoundry expone una API unificada compatible con OpenAI frente a todos los proveedores. Su aplicación continúa enviando la estructura Chat Completions que ya utiliza. Para cambiar de modelo, basta con modificar el valor de model por un nombre lógico que la pasarela resuelve; todo lo demás (cuerpo de la solicitud, SDK, procesamiento) permanece constante.
Como la pasarela normaliza las diferencias descritas anteriormente, su código deja de preocuparse por si un backend convierte los argumentos de las llamadas a herramientas en cadenas o si reporta usage en las transmisiones. La pasarela ofrece un dialecto consistente. Las bibliotecas de código abierto como LiteLLM popularizaron esta capa de traducción en código; nuestra guía explicativa sobre qué es LiteLLM analiza ese enfoque y muestra dónde una pasarela gestionada va un paso más allá.
Sin embargo, la razón para adoptar este patrón no es solo disponer de una interfaz ordenada. Una vez que todas las solicitudes fluyen a través de un único punto de enlace, se habilitan capacidades imposibles de añadir en integraciones dispersas por proveedor:
Enrutamiento. Un nombre lógico de modelo puede estar respaldado por varios destinos reales, y la pasarela selecciona entre ellos por latencia, peso o prioridad. consulte qué es un enrutador de LLM para conocer la selección de modelos basada en costes y calidad.
Conmutación por error (fallback). Si un proveedor devuelve un error 500 o agota el tiempo de espera, la pasarela reintenta la solicitud en tiempo real contra un destino secundario, de modo que la caída de un proveedor no se traduzca en un error para el usuario. Este tema se detalla en conmutación por error de LLM.
Almacenamiento en caché. El almacenamiento en caché exacto y el almacenamiento en caché semántico en la pasarela reducen tanto la latencia como el gasto en prompts repetidos o casi idénticos, de forma transparente y bajo el mismo punto de enlace.
Observabilidad y atribución de costes. Como cada solicitud pasa por un único punto, se obtienen métricas de costes, tokens y latencia por solicitud, etiquetadas por usuario, equipo y modelo, que alimentan la observabilidad de LLM y la atribución de costes a los presupuestos de los equipos. Una integración directa por proveedor no ofrece nada de esto sin una instrumentación a medida en cada uno.
Ninguna de estas ventajas requiere adoptar una nueva API. Propiamente provienen de estandarizar la interfaz que ya utiliza. Si está evaluando opciones, la guía sobre cómo elegir una pasarela de IA detalla los criterios clave.
La decisión no es dogmática; depende del número de proveedores con los que trabaje y del nivel de exigencia en cuanto a resiliencia y visibilidad de costes.
La integración directa es una opción válida cuando se trabaja con un único proveedor y no hay planes de incorporar otro. En el momento en que se necesita un segundo modelo, mayor resiliencia ante caídas o una fuente centralizada de control de costes, la pasarela justifica plenamente su adopción.
Asumir que compatible significa idéntico. El esquema coincide; el comportamiento no siempre. Los equipos migran un prompt a un backend más económico, comprueban que "funciona" y lo despliegan, para descubrir semanas después que seed se ignoró y los resultados nunca fueron reproducibles. Pruebe los parámetros de los que realmente depende en cada backend.
Confiar enusagepara los costes sin verificar la transmisión (streaming). Varios backends omiten el bloque usage en las respuestas transmitidas a menos que se solicite de forma explícita. Los paneles de control de costes basados en este campo marcan cero y parecen correctos hasta que llega la factura real. Verifique que el uso esté presente en el estilo exacto de solicitud que ejecuta en producción.
Codificar de forma rígida la URL base y el SDK por proveedor. Esto vuelve a generar la dispersión que el estándar debía eliminar. Cada nuevo modelo se convierte en un proyecto de integración y cada caída del proveedor se convierte en su propia caída. Estandarice en un único punto de enlace y haga que la elección del modelo sea una configuración, no código.
Procesar argumentos de llamadas a herramientas sin validar el formato. Algunos backends devuelven arguments como una cadena de texto y otros como un objeto. Aplicar JSON.parse directamente generará un fallo en estos últimos. Normalice la estructura antes de procesarla o permita que una pasarela lo haga por usted.
Tratar la pasarela como una simple infraestructura de red. El punto de enlace es la parte sencilla. El valor radica en las funciones que permite habilitar en un único punto centralizado: enrutamiento, conmutación por error, almacenamiento en caché, presupuestos y atribución de costes, aspectos difíciles de incorporar a posteriori en múltiples integraciones directas.
El esquema OpenAI Chat Completions se convirtió en el estándar no por decreto, sino por haber sido el primero en llegar y lograr una adopción masiva. "Compatible con OpenAI" es la vía de acceso a ese ecosistema: enviar la estructura de solicitud habitual y procesar la respuesta esperada. Ofrece un gran margen de maniobra (la selección de modelos pasa a ser una cadena de configuración), siempre que se tenga en cuenta que compatibilidad no implica identidad y se verifiquen los comportamientos críticos.
La forma más eficiente de aprovechar estas ventajas evitando inconvenientes es estandarizar un único punto de enlace compatible con OpenAI frente a todos los proveedores. Su aplicación mantiene la interfaz que ya conoce y la pasarela gestiona las particularidades de cada proveedor, añadiendo funciones de enrutamiento, conmutación por error, almacenamiento en caché, presupuestos y atribución de costes que resultarían complejas de implementar en integraciones independientes. Una sola interfaz de entrada; cualquier modelo por detrás.
Unifique todos los proveedores de LLM tras una única API compatible con OpenAI. Reserve una demostración.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada




