


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Wenn Sie an OpenRouter-Rate-Limits gestoßen sind, liegt der Grund normalerweise nicht am Traffic. OpenRouter begrenzt Anfragen pro Schlüssel und pro Konto, und der Spielraum, den Sie erhalten, ist an die Höhe des von Ihnen gekauften Guthabens gekoppelt. Ein niedriges Guthaben bedeutet also ein niedriges Rate Limit. Das ist eine Abrechnungseigenschaft, die die Funktion einer Verfügbarkeitssteuerung übernimmt – und es ist der erste Hinweis darauf, dass das Kostenmodell von OpenRouter und das Kostenmodell eines Plattform-Teams für unterschiedliche Zielgruppen entwickelt wurden.
Dieser Beitrag behandelt das Thema Kostenkontrolle und -optimierung aus unserer Serie TrueFoundry vs. OpenRouter: Rate Limits, Budgets und ob sie warnen oder blockieren, Quoten und Rücksetzfenster, kostenbewusstes Routing und wie die Preistabelle verwaltet wird, Caching sowie die Zuordnung für Verrechnungen (Chargeback). Er richtet sich an Ingenieure, die LLM-API-Kosten senken sollen, und an Plattformverantwortliche, die diese berichten müssen. Jede Aussage basiert auf den öffentlichen Dokumentationen der beiden Anbieter. Um zu verstehen, wo sich ein LLM Gateway in diesem Bild einfügt, beginnen Sie mit unserer Einführung.
OpenRouter begrenzt die Rate nach Anfragen, und die Limits sind an Ihr Guthaben gebunden. Kostenlose Modellvarianten sind auf 20 Anfragen pro Minute beschränkt; Konten mit weniger als 10 $ an kumulierten Guthabenkäufen erhalten 50 kostenlose Modellanfragen pro Tag. Dieser Wert steigt dauerhaft auf 1.000 pro Tag, sobald 10 $ ausgegeben wurden, wobei fehlgeschlagene Anfragen möglicherweise weiterhin auf das Limit angerechnet werden. Über den Free Tier hinaus hängen die Rate Limits kostenloser Modelle vom gekauften Guthaben ab. Der Durchsatzspielraum ist somit eine Funktion des Kontoguthabens und nicht einer veröffentlichten Quote pro Tenant. Token-basierte Limits und Nebenläufigkeitslimits sind nicht dokumentiert. Rate Limits werden sofort ohne Warteschlange abgelehnt.
Daraus ergeben sich zwei Konsequenzen. Erstens ist ein OpenRouter-Guthabenlimit sowohl eine Ausgabensteuerung als auch eine Verfügbarkeitssteuerung: Wenn das Guthaben knapp wird, wird auch das Rate Limit enger; fällt es auf Null, stoppt der Traffic. Zweitens: Da Guthaben auf Kontoebene angesiedelt sind, während Workspaces darunter liegen, verbraucht der Traffic eines Workspaces möglicherweise den Spielraum, der mit jedem anderen Workspace in der Organisation geteilt wird, ohne dass das Produkt dies isoliert.
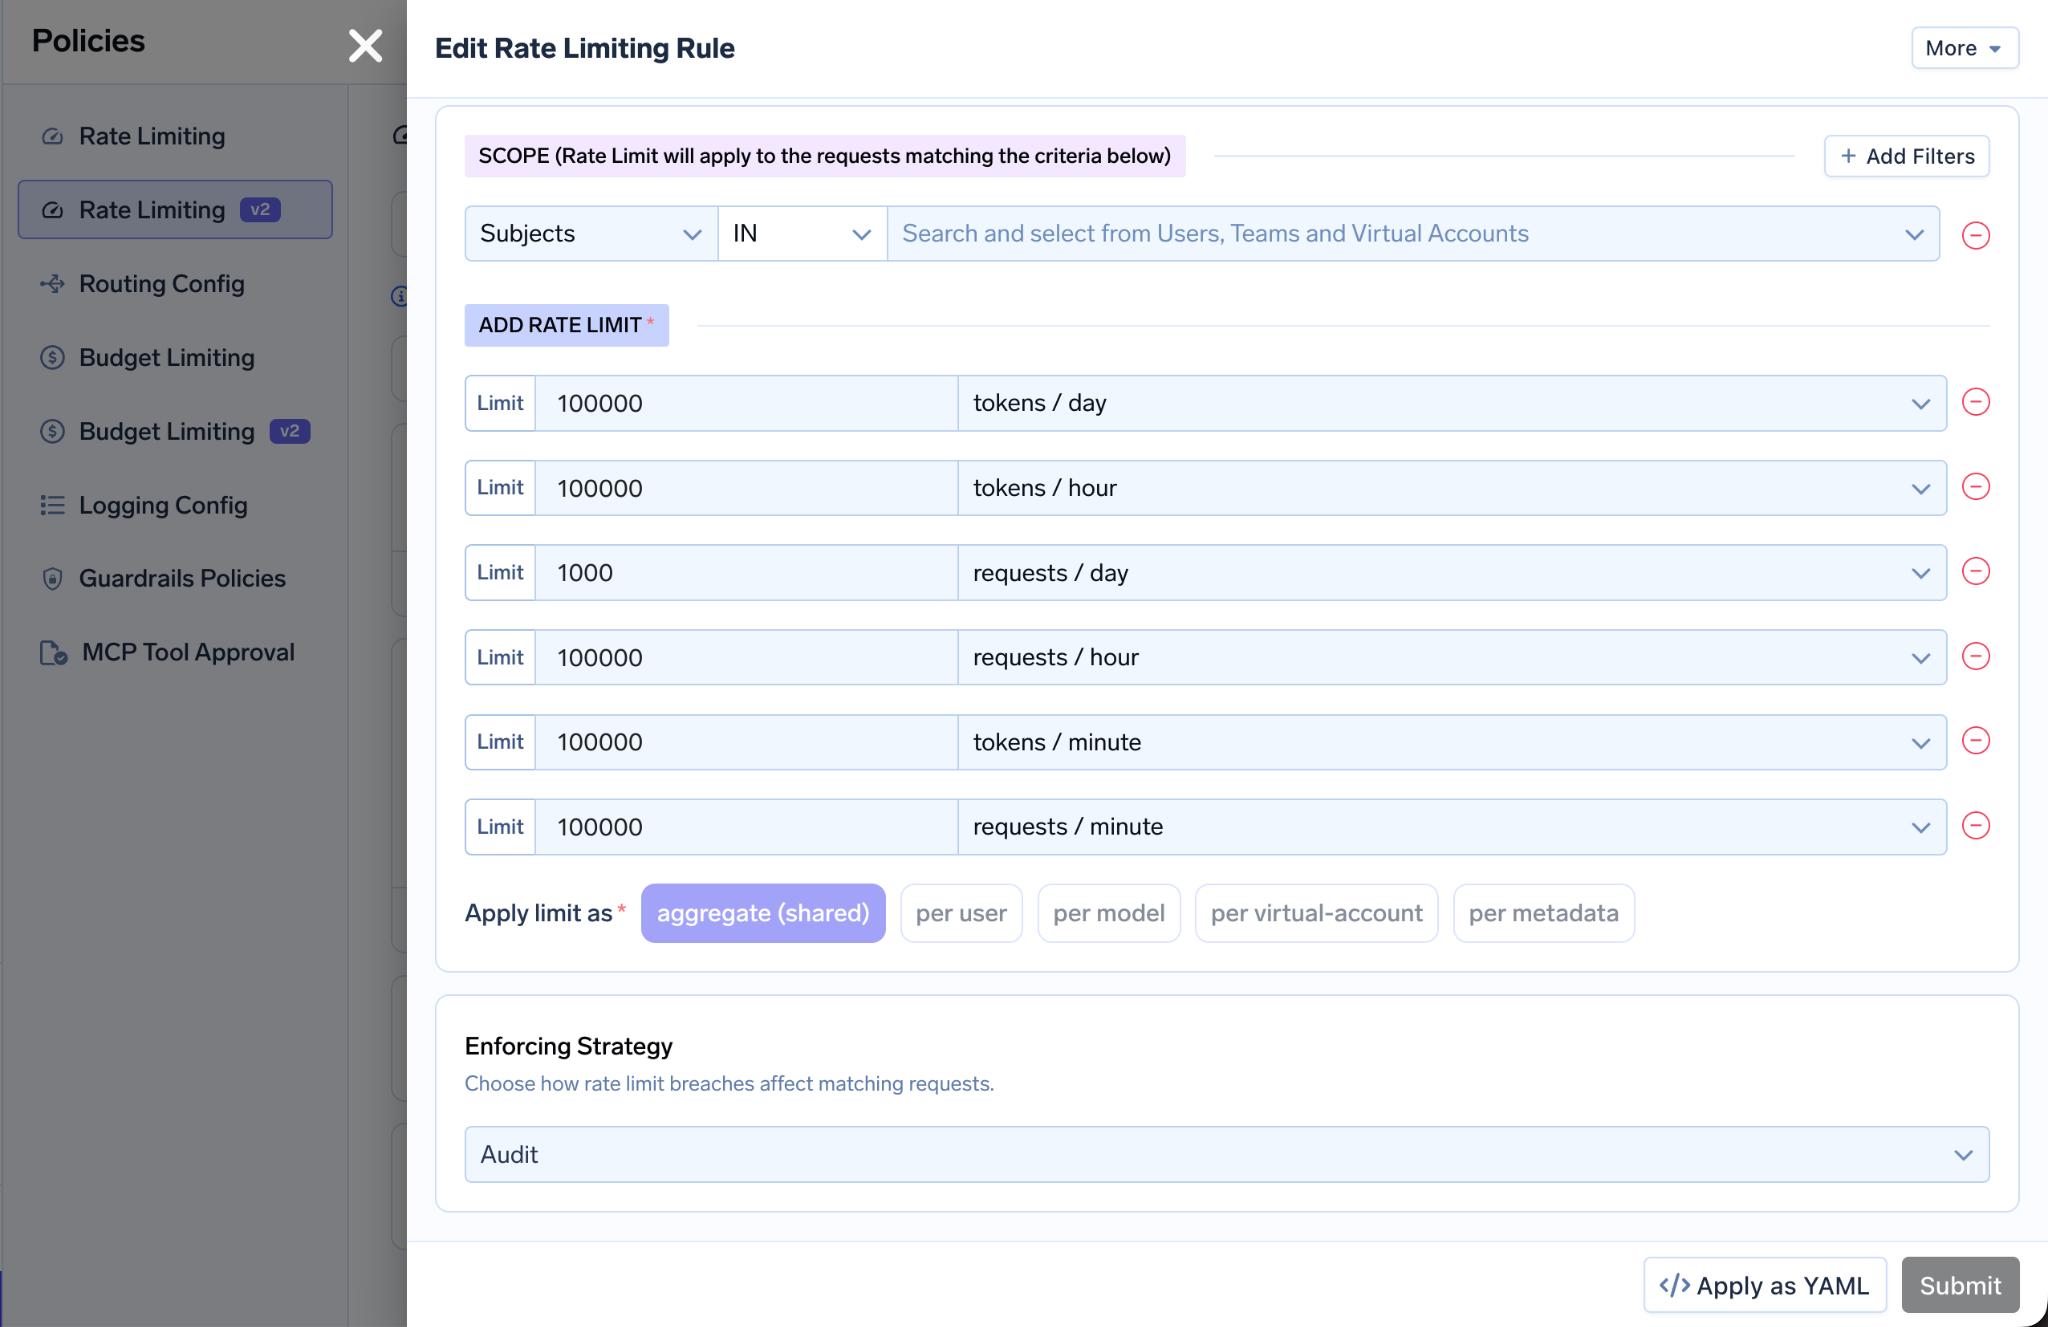
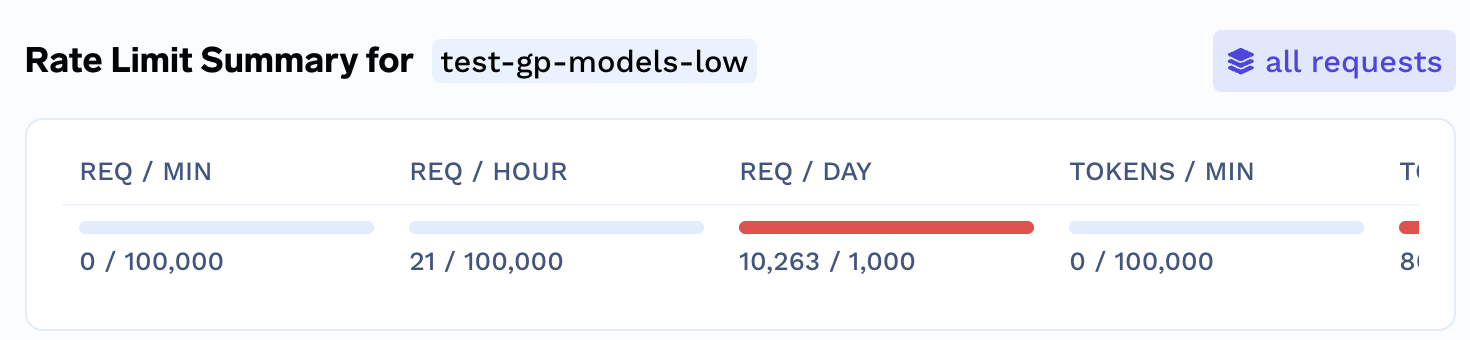
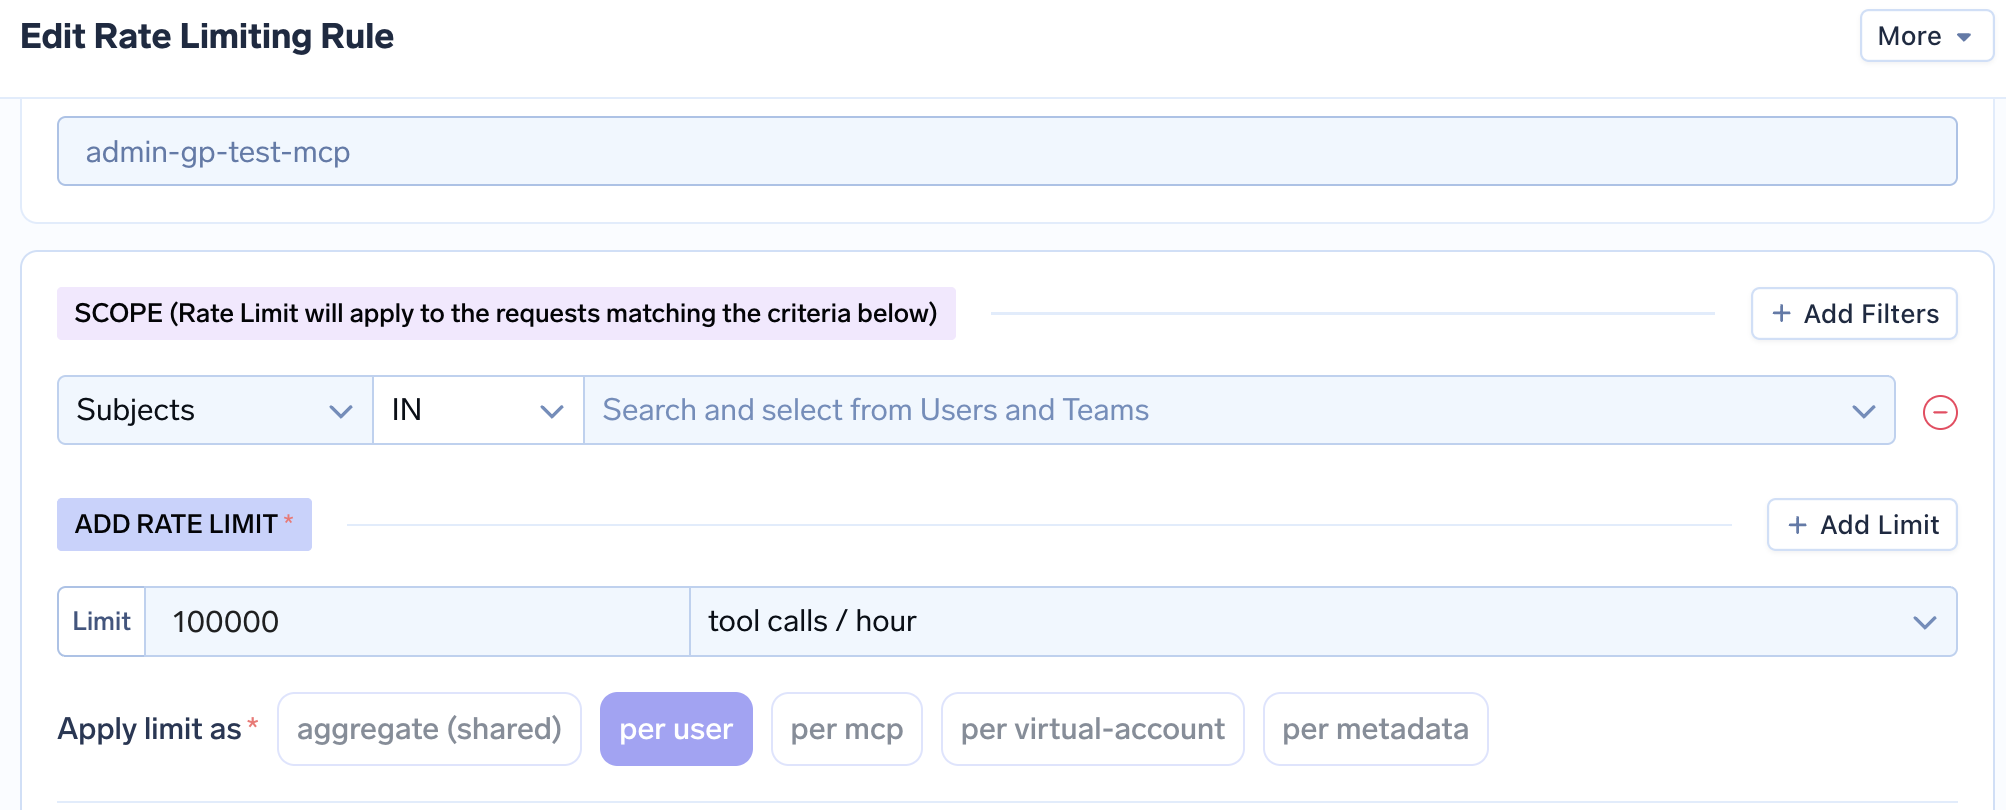
TrueFoundry begrenzt die Rate nach Anfragen und nach Tokens, pro Minute, Stunde oder Tag, mit Regeln, die pro Benutzer, Team, virtuelles Konto, Modell oder Anfrage-Metadaten angewendet werden, wobei die Semantik „erste übereinstimmende Regel gewinnt“ gilt (rate limiting). Die Limits sind unabhängig von dem, was Sie an uns gezahlt haben, und vom Traffic anderer Teams, da das Gateway die Regeln im Arbeitsspeicher vorhält und für das Bedienen einer Anfrage niemals ein Guthaben abfragt. Nebenläufigkeitslimits sind auch auf unserer Seite nicht dokumentiert; das ist die einzige Zeile, in der beide Produkte getestet statt nur nachgelesen werden sollten. Unser Leitfaden zu rate limiting in an LLM gateway beschreibt, wie die Regeln dimensioniert werden.
Ein OpenRouter-Budget existiert auf drei Ebenen: Pro Schlüssel gibt es ein Guthabenlimit mit einem optionalen täglichen, wöchentlichen oder monatlichen Reset um Mitternacht UTC und einer automatischen Deaktivierung, wenn der Schlüssel dieses überschreitet. Pro Mitglied und pro Workspace gibt es Guardrails zur Budgetdurchsetzung, die Schlüsseln oder Mitgliedern zugewiesen werden können, wobei die Richtlinie auf Kontoebene als Obergrenze dient, die ein Workspace nur verengen kann. Workspace Budgets ist ein primäres Feature mit eigener API, verschachtelbaren Intervallen (Lebensdauer, monatlich, wöchentlich, täglich), Limits, die mit kleiner werdendem Intervall strikt abnehmen müssen, und einem include_byok_in_budgets-Schalter, der entscheidet, ob Bring-Your-Own-Key-Inferenz angerechnet wird.
Drei Designentscheidungen sind hierbei wichtig: Budgets werden niemals zusammengelegt (gepoolt). Dieselbe tägliche Budget-Guardrail, die auf drei Mitglieder angewendet wird, gibt jedem von ihnen dieses Budget separat, und eine Anfrage zählt sowohl für das Budget des Schlüssels als auch für das des zugehörigen Mitglieds. Pro Modell und pro Anwendung gibt es keinen direkten Mechanismus; ein App-Budget funktioniert nur dort, wo die App der Schlüssel ist. Und Budgets bedeuten stets Hard-Stop, nicht Warnung: Ein Nur-Warnungs-Modus ist nicht dokumentiert, und eine Anfrage über dem Limit gibt HTTP 403 zurück – was typischerweise der Weg ist, wie ein Team feststellt, dass sein Budget aufgebraucht ist.
TrueFoundry Budget Limiting V2 definiert Regeln auf Tenant- oder Team-Ebene, gefiltert nach Benutzern, Teams, virtuellen Konten, Modellen (konkret oder virtuell), Provider-Konten und Anfrage-Metadaten über den X-TFY-METADATA-Header. Ein Budget pro App ist somit nur ein virtuelles Konto oder ein Metadaten-Tag entfernt (budget limiting v2). Regeln laufen im Durchsetzungsmodus (Anfrage blockiert) oder im Nur-Warnungs-Modus; mehrere Regeln werden per UND verknüpft; Limits gelten insgesamt oder pro Benutzer, pro virtuelles Konto, pro Modell oder pro Metadatenwert; und die Zeiträume sind täglich, wöchentlich, monatlich, vierteljährlich oder lebenslang und können innerhalb einer Regel kombiniert werden (z. B. 0,50 $ pro Tag und 2 $ pro Quartal; jede Verletzung blockiert). Meilenstein-Warnungen werden bei 75, 90, 95 und 100 Prozent per E-Mail, Slack-Webhook oder Slack-Bot ausgelöst. Einen Fallstrick sprechen wir offen an: Das Tracking beginnt, wenn die Regel erstellt wird, nicht zu Beginn des Zeitraums, sodass frühere Ausgaben nicht rückwirkend angerechnet werden.
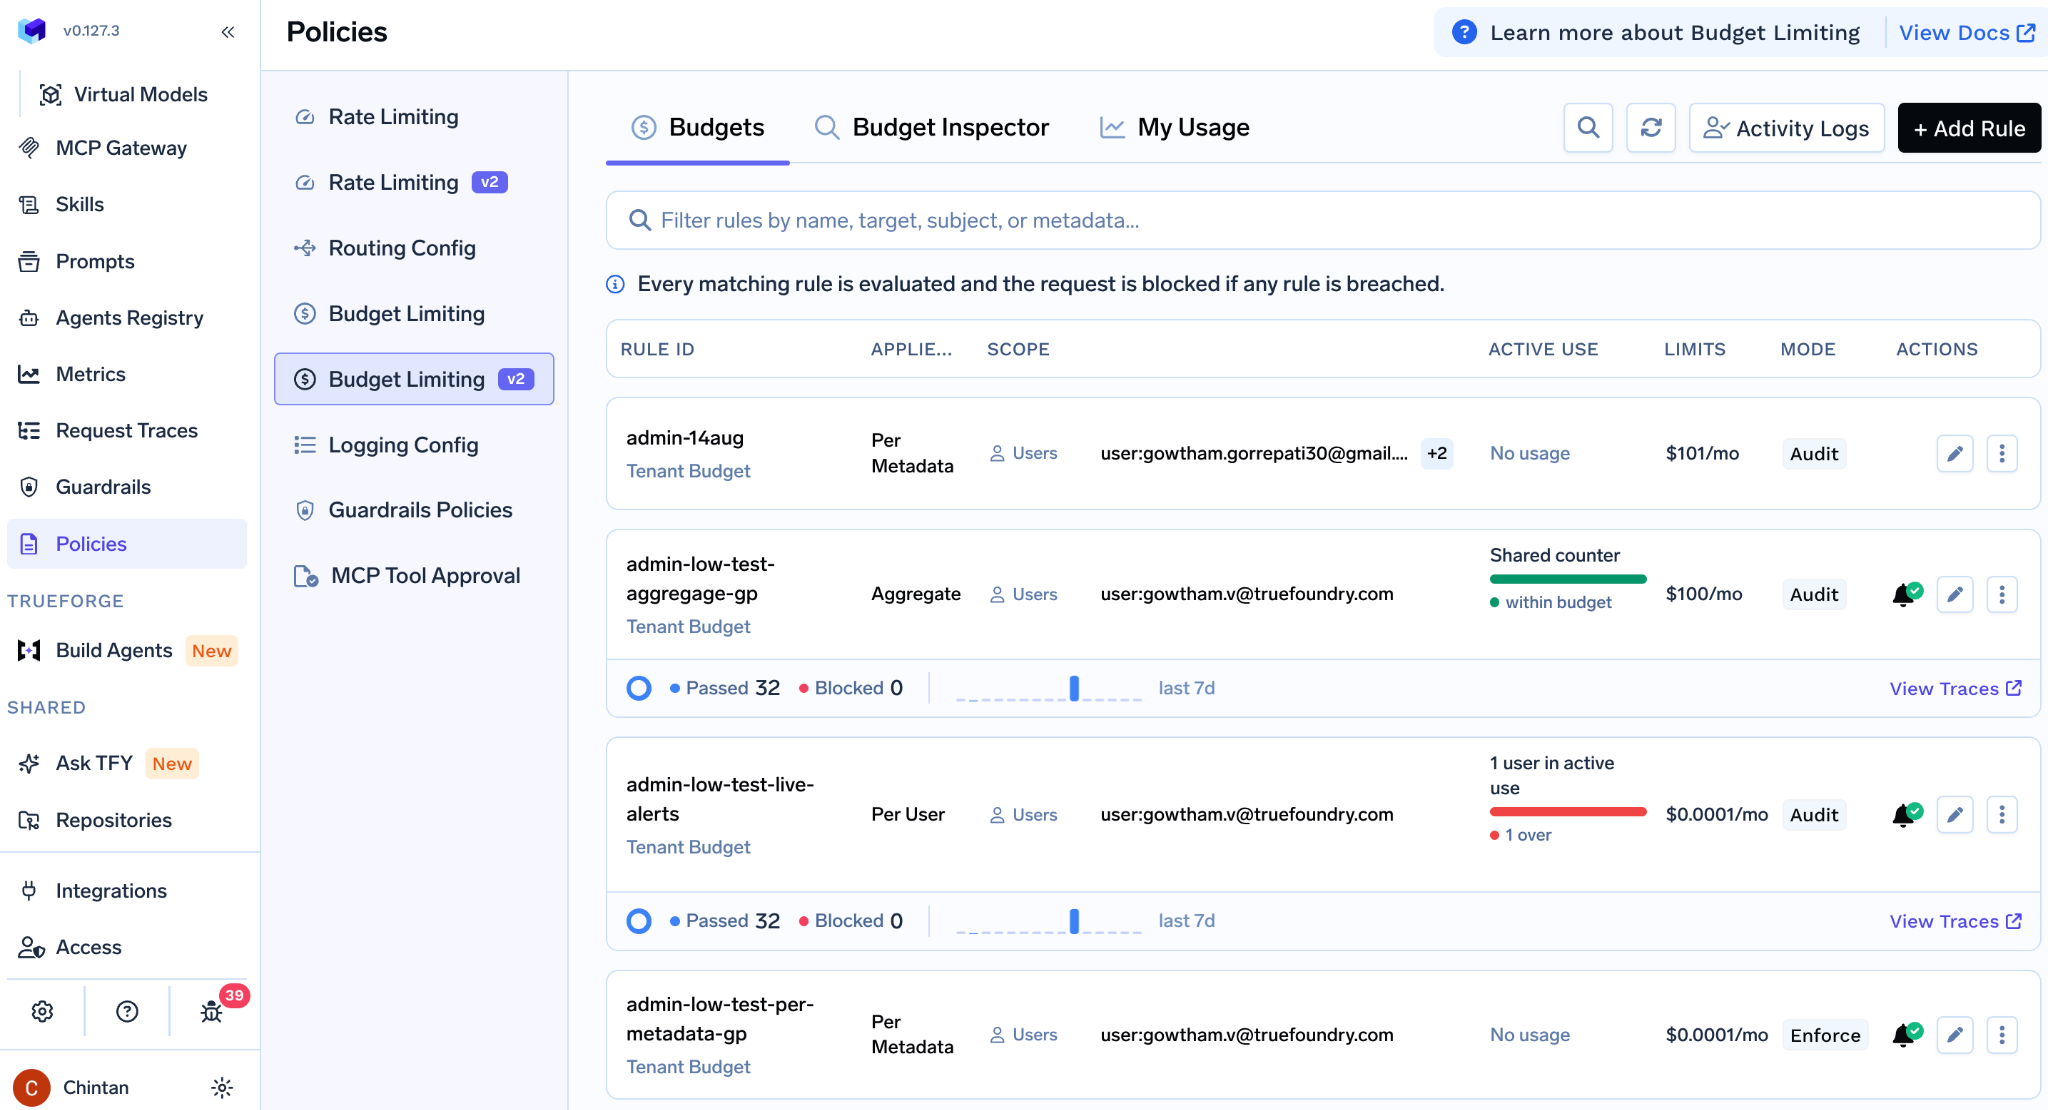
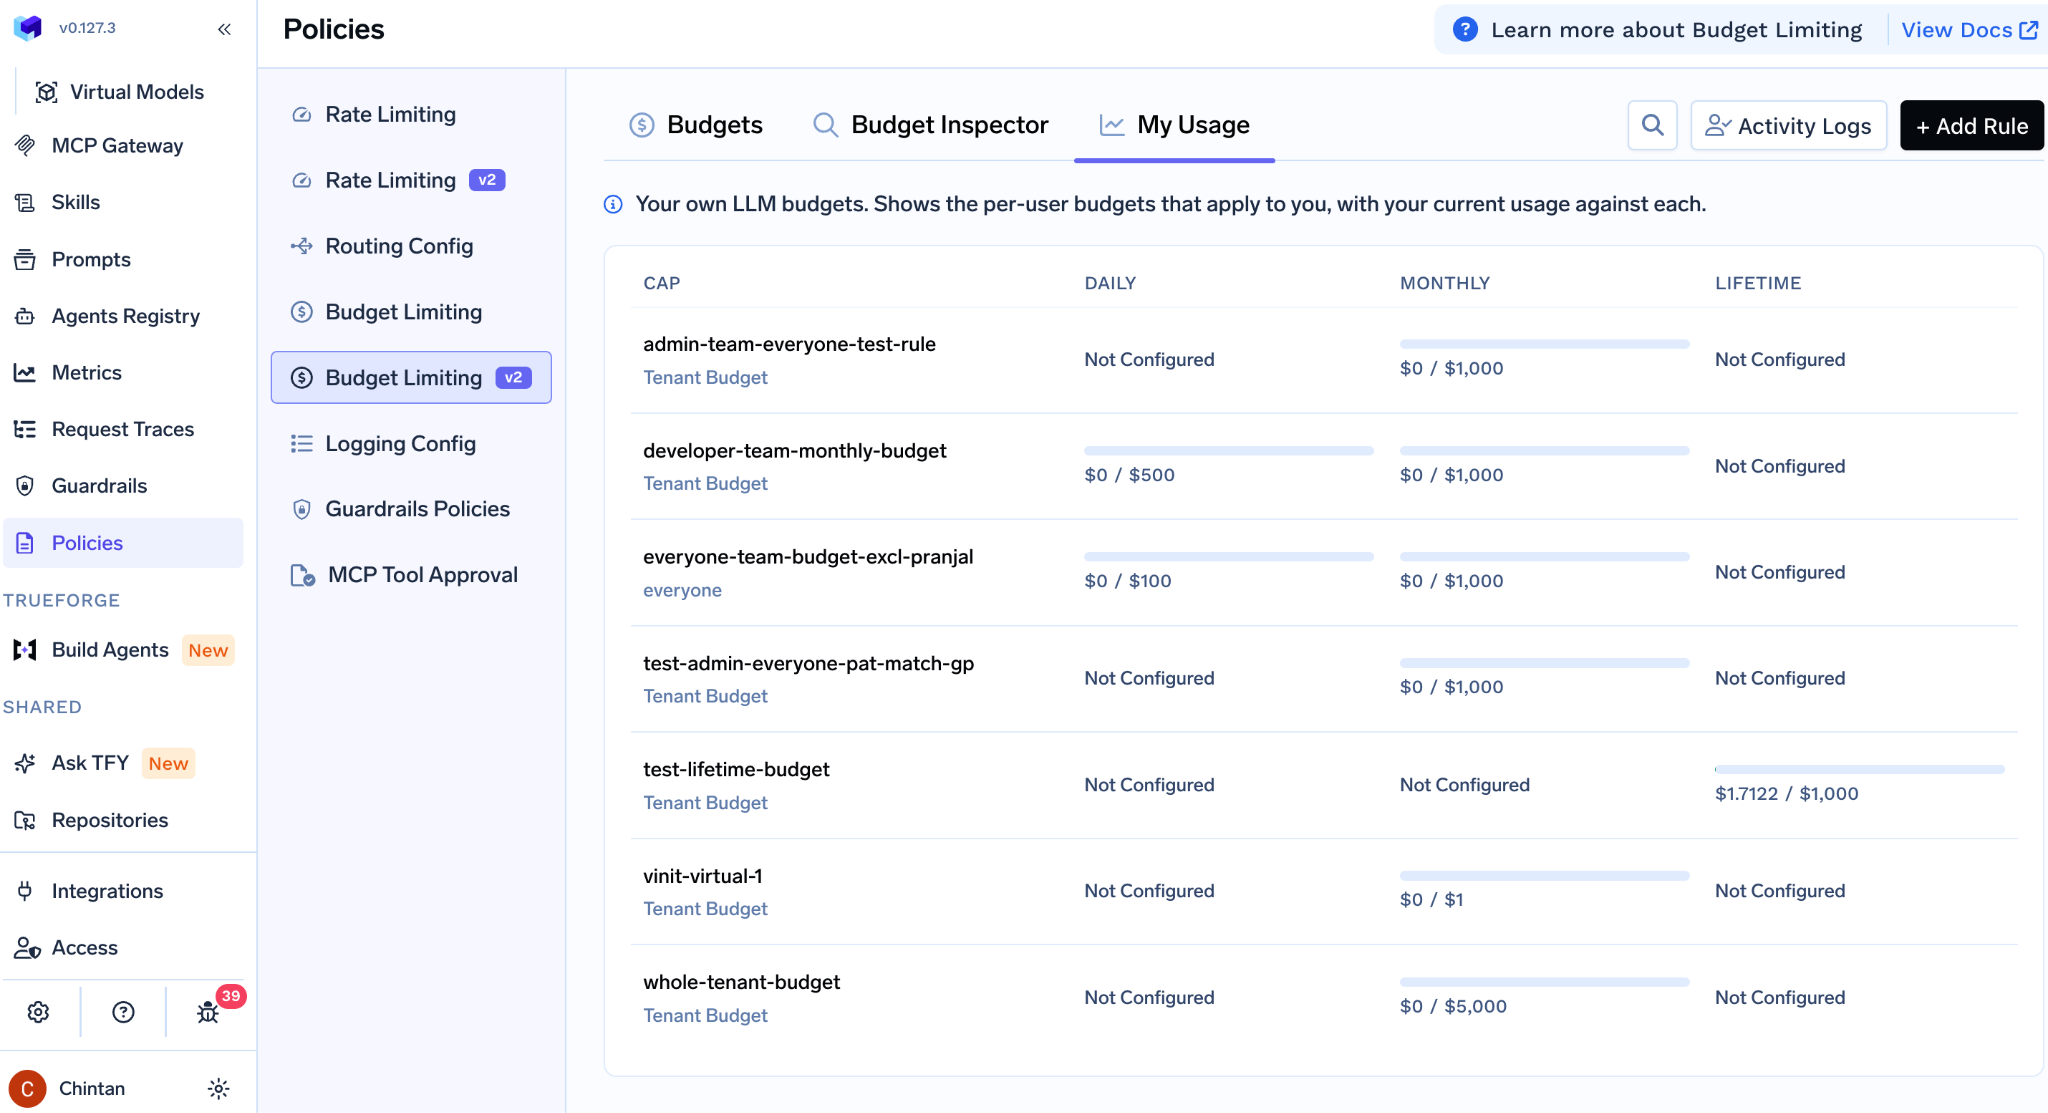
Der praktische Unterschied: Bei TrueFoundry wird ein Team bei 75 Prozent gewarnt und kann über 100 Prozent hinaus weiterarbeiten, wenn die Regel auf Nur-Warnung steht. Bei OpenRouter erfährt das Team davon, wenn Anfragen den Fehler 403 zurückgeben.
Zwei verschiedene Dinge werden hier als Caching bezeichnet, und diese zu verwechseln, ist der häufigste Fehler, den wir bei Kostenprüfungen sehen.
Provider Prompt Caching bedeutet, dass der Modell-Provider weniger für gecachte Input-Tokens berechnet. OpenRouter reicht dies durch und leitet darum herum: Ein Cache-Lesevorgang kostet je nach Provider etwa das 0,1- bis 0,5-fache des normalen Input-Preises, und session_id hält eine Sitzung bei dem Provider aufrecht, der den warmen Cache hält. TrueFoundry reicht das Prompt Caching der Provider ebenfalls durch, und unsere Dokumentation beschreibt explizit die Kombination mit Gateway-Caching (caching). Keiner der beiden Anbieter hat dies erfunden; beide lassen Sie es nutzen.
Gateway Response Caching bedeutet, dass das Gateway die Anfrage selbst beantwortet, ohne den Provider aufzurufen. Das Response Caching von OpenRouter (derzeit in der Beta-Phase) basiert auf exakter Übereinstimmung (Exact-Match): Zwei Anfragen sind nur dann identisch, wenn sie denselben API-Schlüssel, dasselbe Modell, denselben Endpunkttyp, denselben Streaming-Modus und denselben vollständigen Anfrage-Body teilen. Es ist pro Anfrage über den X-OpenRouter-Cache: true-Header optional aktivierbar (Opt-in), modellunabhängig und deckt Chat-Completions, Responses, Messages und Embeddings ab – jedoch keine Legacy-Completions, TTS, STT, Rerank oder Video. Bei einem Treffer wird die Antwort ohne Abrechnung und ohne Token-Verbrauch zurückgegeben. Zwei Eigenschaften sind positiv hervorzuheben: Cache-Treffer werden nicht auf die Rate Limits der Provider angerechnet, und Treffer sind im Activity-Log sichtbar. Eine Eigenschaft schränkt es ein: Der OpenRouter-Cache ist auf einen einzelnen API-Schlüssel beschränkt. Verschiedene Schlüssel unter demselben Konto teilen ihn sich also nicht, und eine Flotte von Diensten, von denen jeder seinen eigenen Schlüssel hält, zieht keinen Nutzen aus dem Traffic der jeweils anderen. Semantisches Caching wird nicht angeboten. In unseren eigenen Tests haben wir eine Trefferquote von 100 Prozent bei identischen erneuten Anfragen gemessen, mit 58,5 ms bei einem Treffer gegenüber 2.866,8 ms bei einem Cache-Miss sowie einer Time-to-Live zwischen zwei und fünf Minuten.
TrueFoundry bietet sowohl exaktes als auch semantisches Caching am Gateway, unterstützt durch Redis. Ein Treffer gibt die vollständige Antwort ohne Provider-Aufruf und ohne Provider-Kosten über alle Provider hinweg zurück. Der Cache wird über alle Aufrufer hinweg geteilt und nicht pro Schlüssel isoliert, sodass das zweite Team, das eine Frage stellt, vom ersten profitiert. Eine Strategie für semantisches LLM-Caching ist für die Workloads wichtig, bei denen exakte Übereinstimmungen niemals zutreffen: Kundensupport-Assistenten, interne Suchen und jede Prompt-Vorlage mit einem variablen Feld. Wir veröffentlichen keine gemessenen Trefferquoten, da diese vollständig von Ihrem Traffic abhängen. Der richtige Test ist eine Woche mit Ihren eigenen Prompts.
Wenn keine Routing-Anweisungen festgelegt sind, optimiert OpenRouter den Preis bereits in drei Schritten: Provider mit erheblichen Ausfällen in den letzten 30 Sekunden zurückstufen, aus den stabilen Anbietern die kostengünstigsten Kandidaten gewichtet mit dem inversen Quadrat des Preises auswählen und den Rest als Fallback bereithalten. Explizite Steuerungen lassen sich darüberlegen: provider.sort: "price" oder das Kürzel :floor leiten nach dem günstigsten Preis zuerst, :nitro leitet nach Durchsatz, provider.max_price setzt eine strikte Obergrenze in Dollar pro Million Tokens, die sich mit einer Sortierung kombiniert, und Einstellungen für provider.only, ignore sowie Quantisierung schränken die Kandidatenmenge ein. Die Preistabelle kann nicht veralten, da OpenRouter der Verkäufer ist: Seine Preisliste ist der Preis. Zwei ehrliche Grenzen: Dies ist Provider-Arbitrage für ein bestimmtes Modell, keine Modell-Substitution, und nach Preis sortiertes Routing geht zu Lasten der Qualitätskonsistenz, da günstigere Provider möglicherweise andere Quantisierungen desselben Modells bereitstellen.
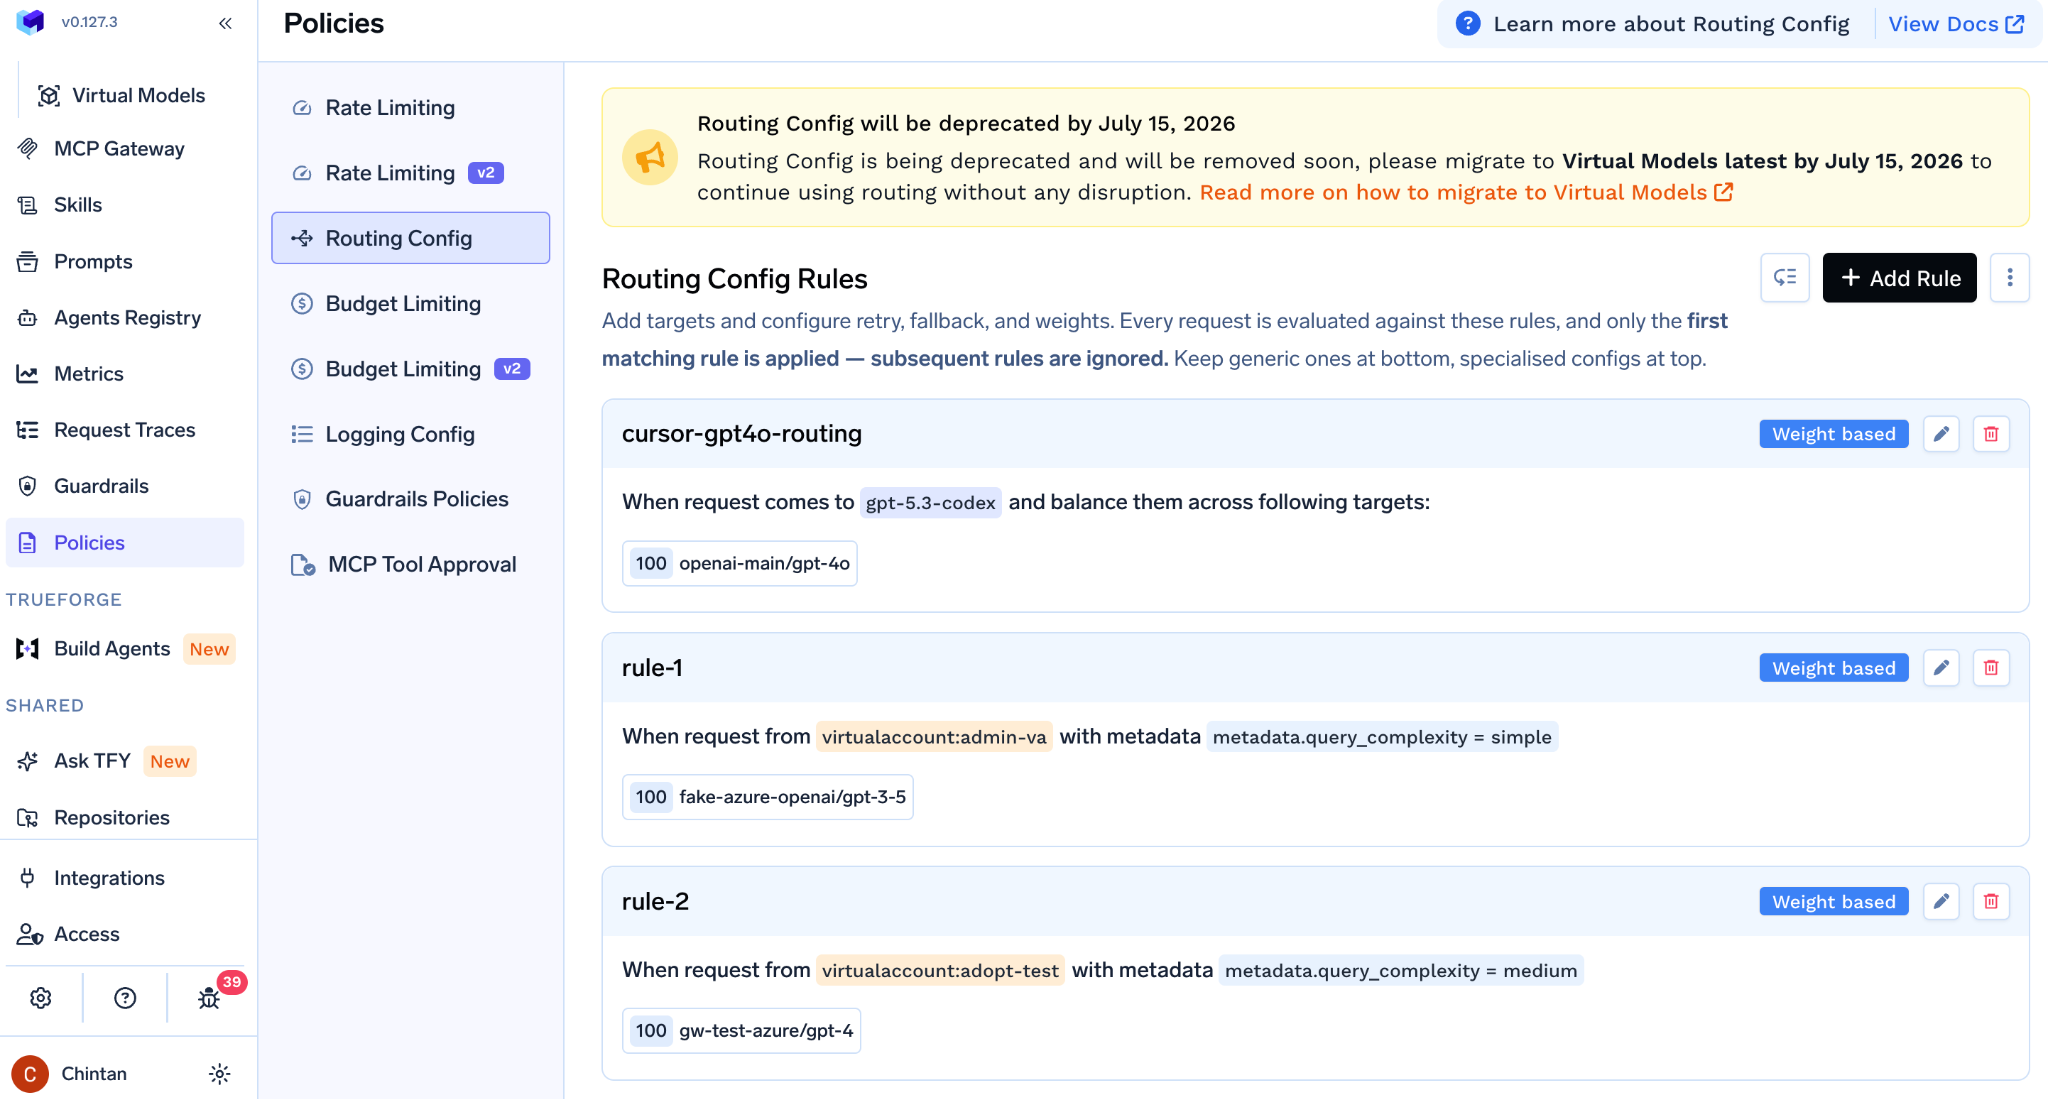
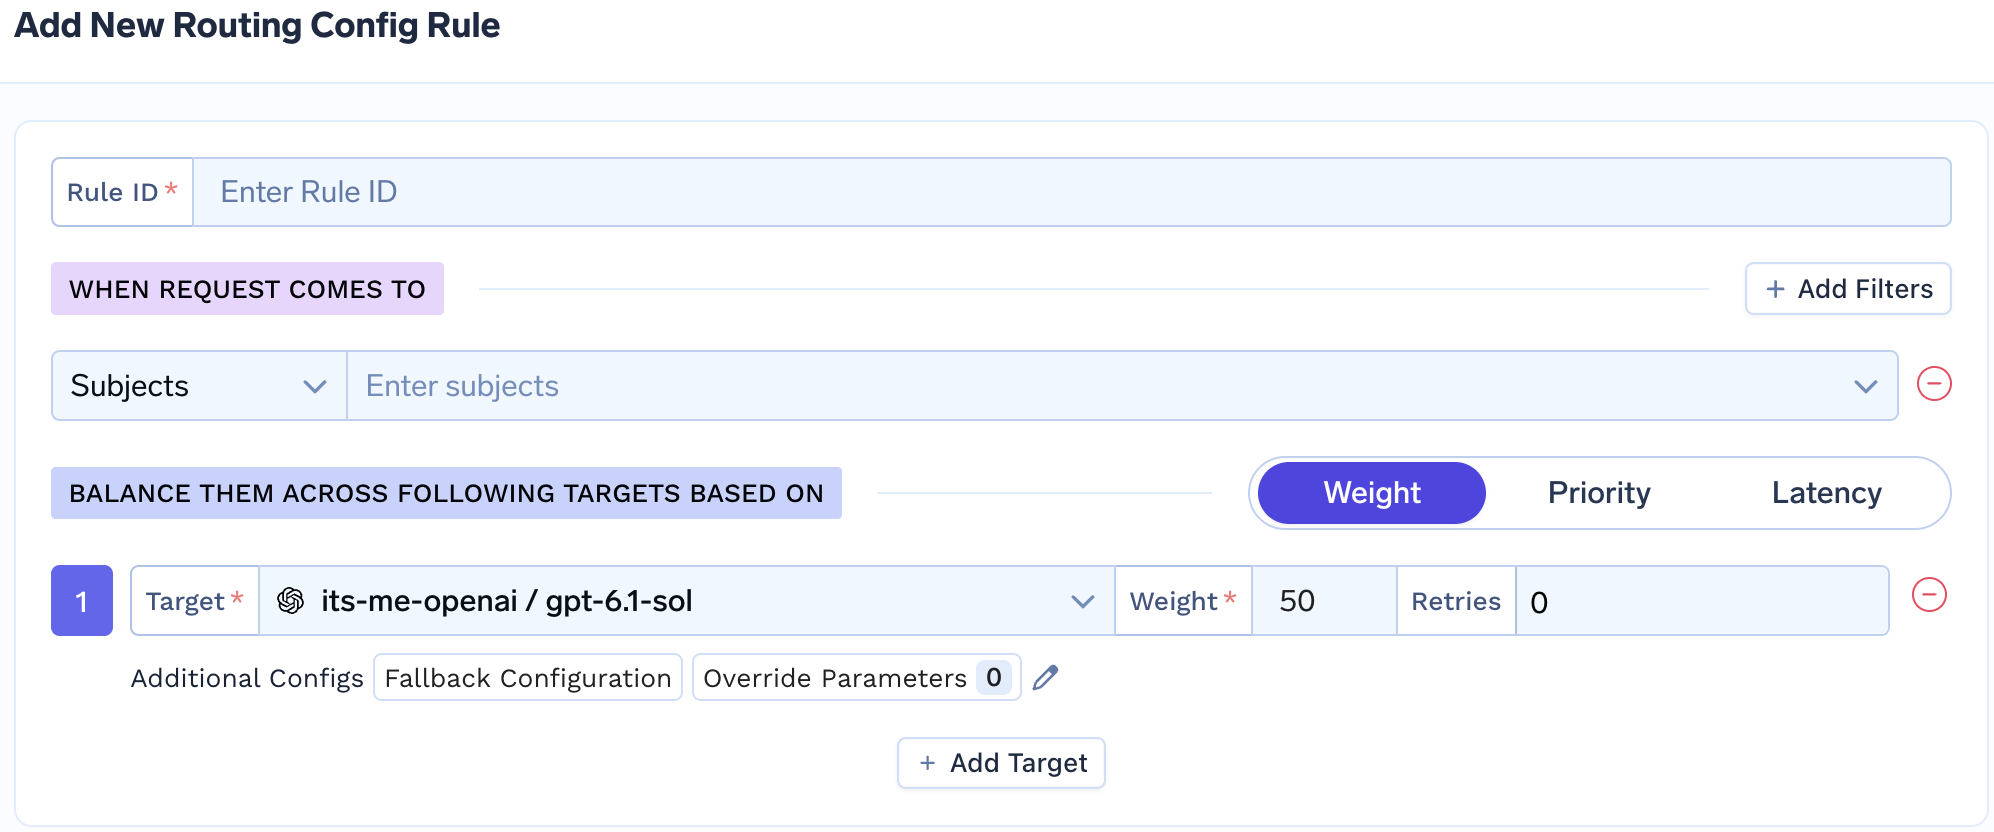
TrueFoundry führt keine über Preistabellen gesteuerte Provider-Arbitrage durch. Was wir bieten, ist komplexitätsbasiertes Routing: Das Gateway klassifiziert jede Anfrage als einfach, mittel oder komplex und leitet sie an das Modell weiter, das Sie für diese Stufe konfiguriert haben, mit Session-Stickiness. Sie wählen also das günstige Modell pro Stufe und das Gateway wählt die Stufe (auto routing). Darum herum liegen gewichts-, latenz- und prioritätsbasiertes Lastausgleichen über Ziele hinweg sowie eine Fallback-Kette für virtuelle Modelle, die jedes Ziel überspringt, dessen Budget überschritten ist, was als Kosten-Schutzschalter fungiert. Preisdaten stammen aus einem Open-Source-Katalog sowie aus privaten Tarifen für verhandelte Verträge und feingetunte Modelle (cost tracking). Die ehrliche Zusammenfassung gilt also in beide Richtungen: Günstigstes akzeptables Modell: ja; günstigster Provider für dieses Modell: nein. Wie die beiden Ansätze in ein Routing-Design passen, wird in unserer Erklärung zum LLM router behandelt.
Die Steuerung von Ausgaben beginnt mit dem Wissen, wer sie getätigt hat. TrueFoundry ordnet Kosten und Tokens nach Benutzer, Team, virtuellem Konto, Modell, Provider-Konto und beliebigen Metadaten-Schlüsseln zu. Der X-TFY-METADATA-Header dient dabei als Verrechnungs-Aufhänger: Eine mit einer Kostenstelle oder Anwendungs-ID getaggte Anfrage wird darunter ausgewiesen, Dashboards schlüsseln die Ausgaben nach jeder dieser Dimensionen auf, und die Budget-APIs legen die Nutzung sowie eine Rangliste der Top-Verbraucher offen (cost tracking, budgets API). Dieselbe Gateway-Ebene, die diese Regeln im Arbeitsspeicher durchsetzt, hält den Overhead bei etwa 3–4 ms und über 350 Anfragen pro Sekunde pro vCPU über mehr als 1.000 LLMs hinweg. Die Zuordnung ist also nichts, wofür Sie mit Latenz bezahlen. Für die finanzbezogene Seite dieses Themas siehe unseren Leitfaden für eine LLM cost tracking solution.
OpenRouter ordnet nach Schlüssel (mit beschreibenden Labels), Workspace, Modell und Provider zu. Activity und Logs bieten eine Ansicht auf Kontoebene mit optionaler Workspace-Filterung, usage: {include: true} gibt die Nutzung pro Anfrage im Antwort-Body zurück, Activity Export erstellt CSV- oder PDF-Dateien gruppiert nach Modell, Schlüssel oder Mitglied, und ein User-Tracking-Feature sowie Custom Classifiers fügen Dimensionen pro Benutzer und Kategorie hinzu. Die Abrechnung erfolgt über eine einzige Rechnung für alle Workspaces. Eine Zuordnung pro Anwendung oder Kostenstelle ist erreichbar: nativ über benutzerdefinierte User-IDs und Klassifikatoren oder nachgelagert über Broadcast-Metadaten in Ihre Observability-Plattform.
Das ist die Struktur der LLM-Kostenoptimierung auf beiden Seiten. Wenn das Ziel darin besteht, die LLM-API-Kosten für eine einzelne Anwendung zu senken, erledigt das Routing von OpenRouter die Hauptarbeit automatisch. Wenn das Ziel darin besteht, sie für eine gesamte Organisation zu senken, müssen Sie wissen, welches Team Ausgaben tätigt, dieses warnen, bevor es abgeschnitten wird, und die einfachen Anfragen an das günstige Modell leiten – was der Struktur von TrueFoundry entspricht.
Die Funktionen von TrueFoundry stammen aus unserer Dokumentation; die Funktionen von OpenRouter spiegeln die zum Zeitpunkt der Erstellung öffentlich dokumentierten Funktionalitäten wider.
Keiner der beiden Anbieter dokumentiert Ausgabenprognosen oder Anomalieerkennung; TrueFoundry listet Anomaliewarnungen als „demnächst verfügbar“ auf seiner Roadmap für Agent-Governance, und OpenRouter verfügt über ein Benachrichtigungs-Feature, dessen Warnungstypen nicht dokumentiert sind. Planen Sie auf beiderlei Seite ein Budget für ein FinOps-Tool ein und lesen Sie unseren Leitfaden zu OpenRouter alternatives für einen breiteren Überblick.
Die Rate Limits, Budgets und Caching-Funktionen von OpenRouter sind für Entwickler konzipiert, die einen einzelnen Schlüssel steuern: Limits, die sich nach dem Guthaben richten, Budgets, die stoppen statt zu warnen, und ein Cache, der zum Schlüssel gehört – im Gegenzug erhalten Sie die beste automatische Provider-Arbitrage am Markt. Die Kostenkontrollen von TrueFoundry sind für Plattform-Teams entwickelt, die gegenüber der Finanzabteilung berichtspflichtig sind: Limits nach Anfragen und Tokens, Budgets, die warnen, bevor sie blockieren und auf Teams, Modelle sowie Anwendungen angewendet werden können, ein semantischer Cache, der über alle Aufrufer hinweg geteilt wird, sowie eine Verrechnung nach Kostenstelle direkt ab Werk. Keines von beidem bietet Prognosen oder erkennt Anomalien, planen Sie dies also auf beiden Seiten ein. Die praktische Trennlinie ist, ob die Person, die den Budgetbericht liest, ein Entwickler oder ein Partner aus der Finanzabteilung ist.
Um zu sehen, wie Budgets, Limits und Caching für ein teamübergreifendes Rollout konfiguriert werden, erkunden Sie das TrueFoundry AI Gateway oder book a demo, wenn Sie Kostenkontrollen für die Produktion dimensionieren.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





