


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
LiteLLM hat sich seine Popularität verdient. Es steht unter der MIT-Lizenz, unterstützt über 100 Provider hinter einer einzigen OpenAI-kompatiblen API, lässt sich in Minuten installieren und bringt ein kleines Team fast ohne Aufwand von „drei Provider mit drei SDKs aufrufen“ zu „einen Endpunkt aufrufen“. Für viele Projekte ist es die richtige erste Wahl, und nichts in diesem Beitrag spricht dagegen.
Die Gründe, warum Teams davon weg migrieren, sind struktureller Natur und treten ab einer vorhersehbaren Größenordnung auf. Wenn aus einem Dutzend Ingenieuren hundert werden, aus einer App dreißig, wenn aus „wir sollten wahrscheinlich Ausgaben verfolgen“ die Anforderung „Finanzen benötigt Kosten pro Team“ und „Security benötigt einen Audit-Trail“ wird, stößt ein einzelprozessbasierter Python-Proxy an Aufgaben an seine Grenzen, für die er nie konzipiert wurde. Nimmt man die Supply-Chain-Vorfälle in der LiteLLM-Distributionskette im Jahr 2026 hinzu, verschiebt sich die Diskussion von „es funktioniert“ zu „wer kontrolliert unseren Modellzugriff, und wie weisen wir das nach?“
Dies ist ein Migrationsleitfaden, keine Kritik. Er benennt die spezifischen Signale, die zeigen, dass Sie aus LiteLLM herausgewachsen sind, ordnet jedes LiteLLM-Konzept seinem Äquivalent im Governed Gateway zu und beschreibt einen Schritt-für-Schritt-Cutover, der genau deshalb risikoarm ist, weil beide Seiten die OpenAI-kompatible API sprechen. In den meisten Fällen ändert sich Ihr Anwendungscode um genau eine Zeile: die Base-URL.
Aus LiteLLM herausgewachsen? Erfahren Sie, wie Sie mit einem Wechsel der Base-URL zu einem Governed Gateway wechseln. Demo buchen.
Seien Sie präzise bei den Auslösern. Vage Geschichten nach dem Motto „es hat nicht skaliert“ helfen Ihnen nicht bei der Planung; spezifische Fehlermodi hingegen schon.
Die GIL-Durchsatzgrenze. Der Proxy von LiteLLM basiert auf Python. Pythons Global Interpreter Lock bedeutet, dass ein Prozess Python-Bytecode jeweils nur auf einem Thread ausführt. Für einen I/O-gebundenen Proxy, der hauptsächlich auf Antworten von Providern wartet, ist dies bei geringer Nebenläufigkeit akzeptabel. Aber mit steigendem parallelem Anfragevolumen konkurrieren Anfrageverarbeitung, Serialisierung, Logging und Policy-Prüfungen um diesen einzigen Lock. Das Ergebnis: Die Latenz steigt und der Durchsatz flacht ab – unabhängig davon, wie viel Hardware Sie hinzufügen. Sie können über viele Prozesse und Instanzen hinweg sharden, aber dann tragen Sie die Verantwortung für die Orchestrierung und das dadurch entstehende Shared-State-Problem.
Secret-Konzentration und Schadensradius. Der Proxy hält die API-Keys für jeden Provider, den er vorgelagert hat. Das ist der Sinn eines Proxys, bedeutet aber auch: Ein kompromittierter Proxy oder eine geleakte Konfiguration legt OpenAI, Anthropic, Ihre Cloud-Modell-Endpunkte – einfach alles auf einmal – offen. Ohne zentrales Secret Management, Rotation und zugriffsweitenbasierten Zugriff (scoped access) ist der Schadensradius jedes Vorfalls „alles“.
Deployment-Wildwuchs und Patching. Da es trivial auszuführen ist, läuft LiteLLM am Ende überall: eine Kopie auf dem Laptop jedes Entwicklers, eine in der CI, mehrere in der Produktion. Wenn eine Schwachstelle auftaucht, müssen Sie jede Instanz finden und patchen. Es gibt keine einzelne Control Plane, die besagt: „Jeder Aufrufer geht durch diesen einen verwalteten Endpunkt.“ So wird „Patchen des Proxys“ zur Schnitzeljagd.
Aufwand für selbst gehostete HA. Einen Proxy auszuführen ist einfach. Ihn mit Failover, Zero-Downtime-Upgrades, Health-Checking und horizontaler Skalierung unter SLA zu betreiben, ist Platform-Arbeit, die Sie nun vollständig selbst tragen. Viele Teams erreichen einen Punkt, an dem sich dieser undifferenzierte Aufwand nicht mehr lohnt.
Zwei Ereignisse im Jahr 2026 machten diese strukturellen Bedenken zu dringenden Aufgaben. Sie verdienen eine sachliche Betrachtung ohne Alarmismus.
Im März 2026 führte eine Kompromittierung der CI dazu, dass bösartige LiteLLM-Releases (Versionen 1.82.7 und 1.82.8) auf PyPI veröffentlicht wurden. Die bösartigen Pakete stahlen Credentials von Systemen, die sie installierten. Das offizielle Docker-Image war nicht betroffen. Im Oktober 2026 kam es zu einem zweiten Vorfall, bei dem ein bösartiges Release (1.107.0) unter Verwendung gestohlener GitHub-Tokens sowohl auf PyPI als auch auf Docker hochgeladen wurde. Unabhängig davon gab es bei LiteLLM mehrere CVEs, darunter eine im CISA Known Exploited Vulnerabilities Catalog aufgeführte (ein Pfad zur Remote-Code-Ausführung, der von Inhabern eines API-Keys ausgenutzt werden konnte) sowie ein Problem, bei dem eine MCP-Sitzung mit jedem beliebigen Bearer-Token aufgebaut werden konnte.
Das Minderungsmuster war in jedem Fall dasselbe: Versionen pinnen, aus einem bekannten korrekten Release neu bauen und alle Secrets rotieren. Die Lehre daraus lautet nicht „LiteLLM ist unsicher“ – Open-Source-Projekte werden genau deshalb angegriffen, weil sie weit verbreitet sind. Die Lehre lautet, dass Secret-Konzentration gepaart mit Versions-Wildwuchs jedes einzelne Supply-Chain-Ereignis in einen flächendeckenden Vorfall verwandelt. Das ist ein starkes Argument für eine verwaltete Control Plane, bei der Versionen, Secrets und Zugriffe zentral verwaltet und auditierbar sind. Eine kompromittierte Abhängigkeit lässt sich weit einfacher eindämmen, wenn bereits jeder Aufrufer über einen einzigen verwalteten Endpunkt mit rotierten, zugriffsweitenbeschränkten Credentials und einem vollständigen Audit-Trail geroutet wird.
Ein Governed AI Gateway bewahrt alles, was LiteLLM Ihnen geboten hat – einen OpenAI-kompatiblen Endpunkt über viele Provider hinweg – und fügt die Ebene hinzu, die ein leichtgewichtiger Proxy nicht in den Mittelpunkt stellt:
TrueFoundry bietet dies als eine einheitliche Control Plane. Entscheidend ist, dass die Bereitstellung als SaaS, In-VPC, On-Premise oder Air-Gapped erfolgen kann, wobei die Data Plane innerhalb Ihres Netzwerks verbleibt. „Governed“ bedeutet also nicht, „dass Sie Ihren Datenverkehr an einen Drittanbieter übergeben“. Allgemeine Auswahlkriterien finden Sie unter Auswahl eines AI Gateways, und den architektonischen Rahmen unter Was ein LLM Proxy ist und leistet.
Erfahren Sie, wie TrueFoundry Ihre LiteLLM-Keys, Budgets und Modelle in eine verwaltete Policy überführt. Demo buchen.
Die Migration erfolgt bewusst schrittweise. Sie stellen niemals die gesamte Organisation auf einmal um.
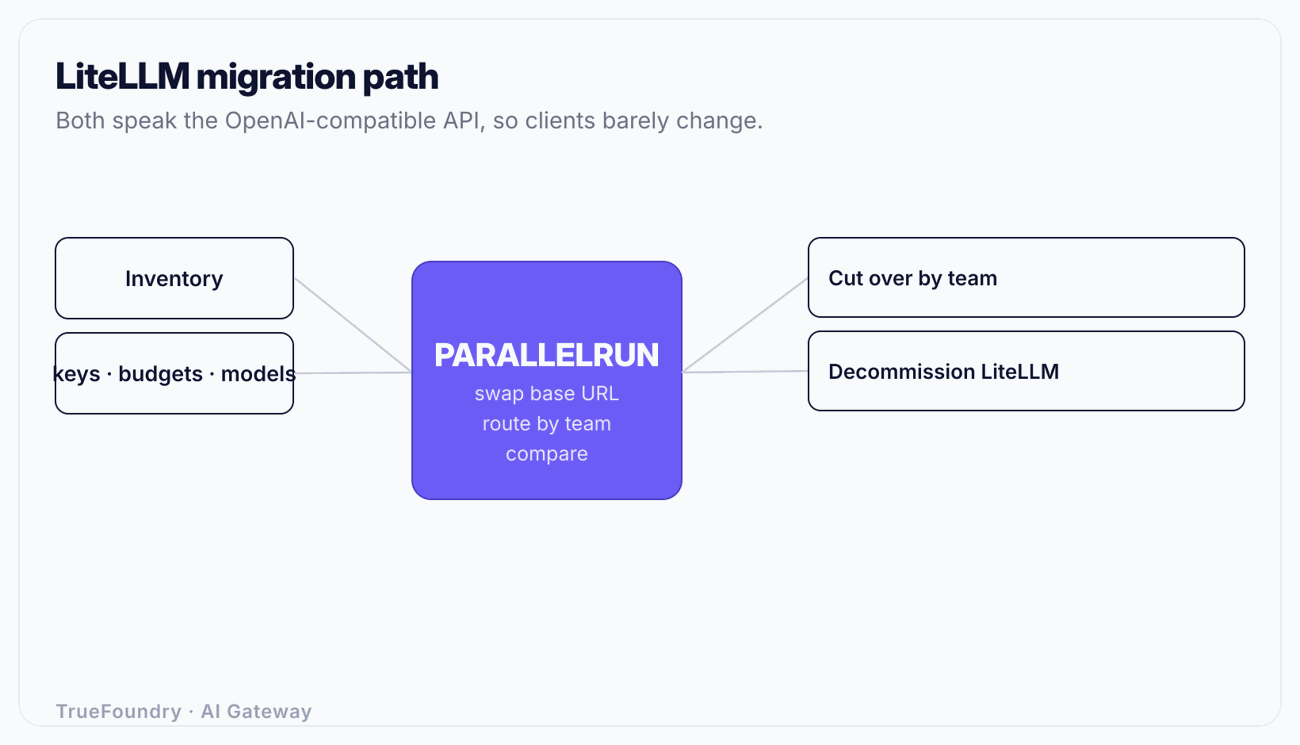
Bevor Sie etwas ändern, katalogisieren Sie, was LiteLLM heute für Sie erledigt:
Die Aufrufer-Bestandsaufnahme ist der Schritt, den Teams am häufigsten überspringen und später bereuen. Sie können keinen Datenverkehr umstellen, von dessen Existenz Sie nichts wussten. Durchsuchen Sie Ihre Codebasen und Ihre Infrastruktur per Grep nach dem Hostnamen des Proxys.
Sie bauen nicht neu; Sie übersetzen. Jedes LiteLLM-Konzept hat ein Äquivalent im Governed Gateway.
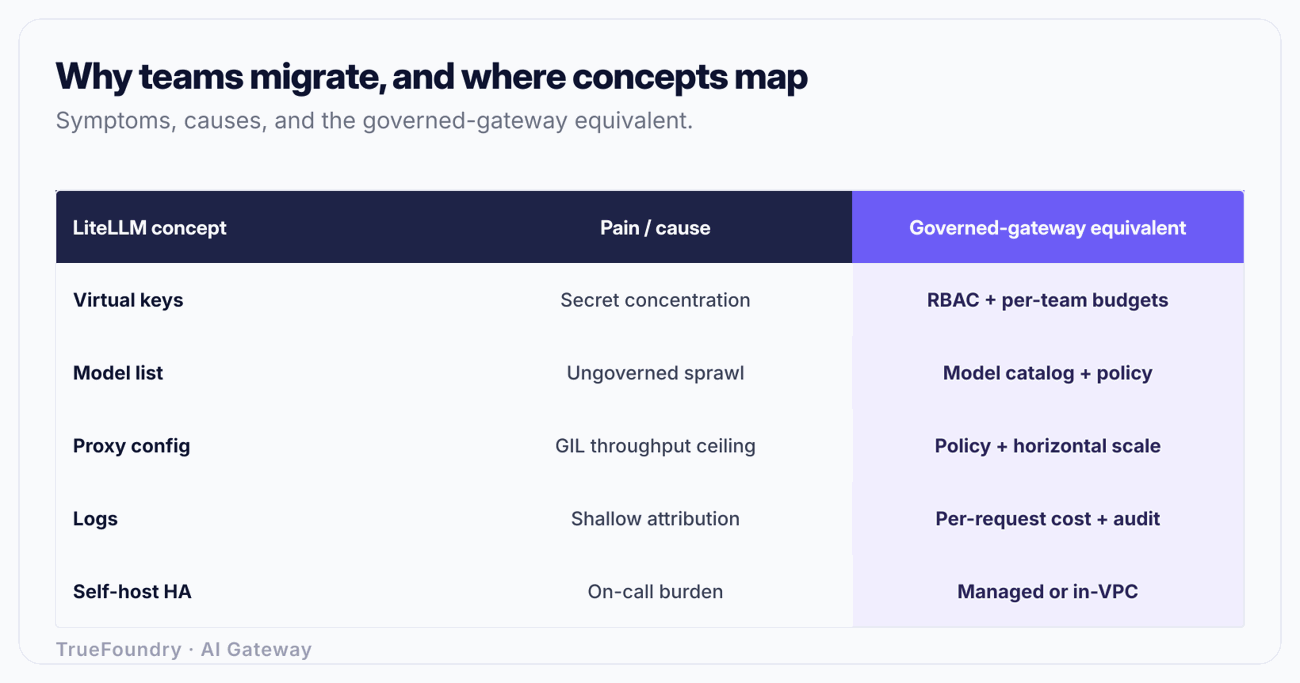
Die Übersetzung ist hauptsächlich ein gedankliches Umdenken: LiteLLM denkt in Keys und einer Konfigurationsdatei; ein Governed Gateway denkt in Identitäten, Teams, Katalogen und Policies. Die Funktionen überschneiden sich stark, weshalb die Migration risikoarm ist.
Dies ist der Schritt, der das gesamte Vorhaben sicher macht. Sowohl LiteLLM als auch das Governed Gateway stellen eine OpenAI-kompatible API bereit. Das bedeutet, dass die einzige Änderung, die ein Client benötigt, die Base-URL ist – von der URL des LiteLLM-Proxys zum Endpunkt des Gateways. Kein SDK-Wechsel, kein Umschreiben der Anfragestruktur, keine Änderung beim Parsing der Antworten.
Bauen Sie das Governed Gateway parallel zu LiteLLM auf. Leiten Sie einen einzelnen, risikoarmen Dienst auf die neue Base-URL um. Überprüfen Sie, ob die Antworten identisch sind, ob die Observability den Datenverkehr mit korrekter Kostenzuordnung anzeigt und ob sich Budgets sowie Guardrails wie konfiguriert verhalten. Da beide Endpunkte live sind, können Sie sie direkt vergleichen und einen Dienst in Sekundenschnelle auf die alte Base-URL zurücksetzen, falls etwas unerwartet verläuft.
Ein konkretes Beispiel: Angenommen, Ihr Inferenz-Dienst liest OPENAI_API_BASE aus einer Umgebungsvariable. Die Migration für diesen Dienst besteht darin, eine Umgebungsvariable zu ändern und den Dienst neu zu starten. Das Rückgängigmachen besteht darin, sie wieder zurückzuändern. Das ist der gesamte clientseitige Schadensradius dieser Migration, wenn beide Seiten dieselbe API sprechen.
Migrieren Sie den Datenverkehr nun in Wellen, organisiert nach Teams oder Anwendungen – nicht alles auf einmal:
Die teamweise Umstellung bietet Ihnen eine saubere Rollback-Grenze und ermöglicht es, Budgets und Zugriffe Schritt für Schritt pro Team korrekt zu definieren, anstatt ein Geflecht geteilter Keys in einem einzigen riskanten Sprung zu migrieren. Zudem verteilt es den Prüfaufwand: Jedes Team bestätigt die Korrektheit seines eigenen Datenverkehrs, bevor Sie fortfahren.
Sobald jeder Aufrufer auf das Gateway verweist und das System lange genug stabil gelaufen ist, legen Sie LiteLLM still: Stoppen Sie die Proxy-Instanzen, entfernen Sie die Provider-Secrets aus dessen Konfiguration und – ganz wichtig – rotieren Sie diese Provider-Credentials, damit die Kopien des alten Proxys ungültig werden. Entfernen Sie den Proxy aus CI- und Entwickler-Setups, damit der Deployment-Wildwuchs nicht leise wieder entsteht. Die Migration ist abgeschlossen, wenn es genau einen verwalteten Pfad zu jedem Modell gibt und kein verwaister Proxy mehr aktive Keys hält.
Migrieren von geteilten Keys, anstatt den Zugriff pro Team neu zu definieren. LiteLLM-Deployments akkumulieren geteilte virtuelle Keys, die von mehreren Teams genutzt werden. Diese eins zu eins zu übernehmen, stellt genau den ungesteuerten Wildwuchs wieder her, den Sie durch die Migration eigentlich beseitigen wollten. Nutzen Sie den Cutover, um den Zugriff pro Team gegenüber Ihrem Identitäts-Provider zu definieren – das ist einer der Hauptgründe für den Wechsel.
Überspringen der Bestandsaufnahme der Aufrufer. Teams migrieren die Anwendungen, an die sie sich erinnern, und lassen ein Notebook, einen Cron-Job oder einen CI-Schritt auf den alten Proxy verweisen. Dann legen sie LiteLLM still, und irgendwo bricht im Stillen etwas ab. Durchsuchen Sie alles per Grep nach dem alten Hostnamen, bevor Sie den Proxy abschalten.
Vergessen der Secret-Rotation bei der Stilllegung. Wenn Sie LiteLLM herunterfahren, aber die darin enthaltenen Provider-Keys nicht rotieren, sind diese Credentials weiterhin gültig. Sie befinden sich nun in einem stillgelegten, unüberwachten System – genau der Zustand veralteter Secrets, den die Vorfälle von 2026 ausgenutzt haben. Rotieren Sie jedes Credential, das der alte Proxy hielt.
Den Wechsel der Base-URL als die gesamte Migration betrachten. Der Wechsel der Base-URL macht die Client-Seite trivial. Aber Governance, RBAC, Budgets, Katalog-Scoping und Audits sind der eigentliche Grund für Ihre Migration. Das Auswechseln von URLs ohne tatsächliche Konfiguration der Governance hinterlässt Sie mit einem neuen Proxy und den alten Problemen.
Big-Bang-Umstellung. Die Umstellung der gesamten Organisation in einem einzigen Schritt nimmt Ihnen die Möglichkeit eines gezielten Rollbacks. Parallelbetrieb und teamweise Umstellung existieren, damit jedes Problem auf ein einziges Team beschränkt bleibt und mit einer einzigen Änderung der Base-URL rückgängig gemacht werden kann. Überspringen Sie diese Schritte nur, wenn Sie Freude an nächtlichen Incident-Calls haben.
Aus LiteLLM herauszuwachsen ist ein Zeichen von Erfolg, kein Fehler bei der ursprünglichen Auswahl. Die Auslöser sind spezifisch und strukturell: die Durchsatzgrenze eines Python-Proxys bei Nebenläufigkeit, die Konzentration aller Provider-Secrets an einem Ort, die Ausbreitung von Kopien über Umgebungen hinweg, die volle Last einer selbst gehosteten HA und ein Jahr 2026 im Bereich der Supply-Chain-Sicherheit, das Secret-Konzentration und Versions-Wildwuchs sehr viel weniger abstrakt erscheinen ließ.
Die Migration selbst ist risikoarm, da beide Seiten die OpenAI-kompatible API sprechen. Die Änderung am Client beschränkt sich daher meist auf eine einzige Base-URL. Erfassen Sie Ihren Bestand, ordnen Sie Keys RBAC und Budgets zu, die Modellliste einem Katalog und die Konfiguration den Policies. Betreiben Sie beide Systeme parallel, stellen Sie Team für Team um und schließen Sie das Projekt mit einer vollständigen Secret-Rotation ab. Auf diese Weise tauschen Sie einen praktischen Proxy ohne Code-Rewrite gegen eine verwaltete Control Plane ein – und haben am Ende Zugriff, Kosten und Audits vollständig im Griff.
Migrieren Sie von LiteLLM mit minimalen Änderungen an Ihren Anwendungen. Demo buchen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





