


November 21, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Kundensupport-Chats leaken Sozialversicherungsnummern in Prompts. Interne Entwickler fügen AWS-Zugriffsschlüssel in einen Coding-Assistenten ein. Eine toxische Antwort gelangt zurück an den Endbenutzer. Jeder dieser Fälle ist ein realer LLM-Betriebsausfall – und jeder einzelne kann von einem kleinen lokalen Klassifizierer in wenigen Millisekunden erfasst werden, ganz ohne LLM-Roundtrip. Die schwierigere Frage ist, wie diese Prüfungen über Hunderte von Anwendungen und Dutzende von Modellanbietern hinweg direkt im Anfragepfad eingebunden werden können, ohne für jede App einen eigenen Validierungs-Stack neu zu erfinden. Die Integration zwischen Guardrails AI und dem TrueFoundry AI Gateway bündelt die Antwort an einem zentralen Ort.
Jede LLM-gestützte Anwendung innerhalb einer Organisation stößt irgendwann auf dieselbe Frage: Wo sollten die Sicherheitsprüfungen angesiedelt sein? Werden sie direkt in jede App eingebaut, fragmentieren sie mit jedem Deployment und weichen zwischen den Teams ab. Werden sie vor den jeweiligen Modellanbieter geschaltet, vervielfachen sie sich über verschiedene Vendor hinweg und erlangen keine Kontrolle über Apps, die sie umgehen. Das TrueFoundry AI Gateway löst dieses Problem, indem es als einzige Ausführungsschicht fungiert, die der gesamte LLM-Datenverkehr passiert – es stellt nach außen eine OpenAI-kompatible API bereit, verteilt die Anfragen im Hintergrund an jeden Modellanbieter und führt alle übergreifenden Belange (Authentifizierung, Rate Limits, Observability, Policy) in der Mitte aus. Ein einzelner Pod bewältigt 250+ RPS auf 1 vCPU mit nur etwa 3 ms zusätzlicher Latenz, zustandslos und CPU-gebunden, wobei die Konfiguration über NATS synchronisiert wird, sodass der Anfragepfad null externe Aufrufe tätigt.
Die Zentralisierung des Anfragepfads sorgt dafür, dass sich Guardrails nahtlos einfügen. Das Gateway bietet vier Hooks – llm_input, llm_output, mcp_pre_tool, mcp_post_tool – und an jeden Hook kann eine beliebige Anzahl von Guardrails angehängt werden. Das Gateway führt sie bei derselben Anfrage parallel aus, sodass ein PII-Detektor, ein Secret-Scanner und ein Toxizitäts-Klassifizierer denselben Prompt gleichzeitig auswerten, ohne dass sich serielle Latenzen aufsummieren. Input-Rails laufen parallel zum Modellaufruf. Wenn eine davon blockiert, wird der laufende Modellaufruf abgebrochen, bevor Token abgerechnet werden – ein echter Kostenvorteil, wenn Validatoren tatsächliche Richtlinienverstöße im Kundenverkehr abfangen. Ein benutzerdefiniertes HTTP-Plugin ermöglicht es jedem Drittanbieter oder internen Dienst teilzunehmen, solange er das Verdict-Agreement des Gateways unterstützt – genau die Schnittstelle, an die Guardrails AI andockt.
Guardrails AI ist ein Open-Source-Python-Framework zur Validierung von LLM-Eingaben und -Ausgaben. Seine primäre Abstraktion ist der Guard – ein Wrapper um einen oder mehrere Validatoren aus dem Guardrails Hub, einem Register vorgefertigter Prüfimplementierungen. Der Hub-Katalog umfasst PII-Erkennung, Secret-Erkennung, Toxizitätsklassifizierung, Profanitätsfilter, Themenbeschränkungen, Halluzinations-Grounding und mehr. Die meisten Validatoren sind lokale Heuristiken oder kleine Klassifizierer; ein kleiner Teil ruft zum Validierungszeitpunkt ein externes LLM auf.
Das v1-Bundle für diese Integration verwendet vier lokale Validatoren: DetectPII (ein Microsoft Presidio-Wrapper für E-Mails, Telefonnummern, US SSN, Kreditkarten, IBAN, US-Reisepass / Führerschein / ITIN), SecretsPresent (Yelps detect-secrets für AWS-Keys, OpenAI-Tokens, GitHub-Tokens, JWTs, private Schlüssel), ToxicLanguage (Unitary's Detoxify-Klassifizierer von Hugging Face) und ProfanityFree (ein Wortlisten-Filter für Antworten des Assistenten). Keiner von ihnen erfordert einen LLM-Aufruf. Die mediane Validierungslatenz auf einem aufgewärmten Pod liegt unter 100 ms pro Validator.
Die Integration behandelt Guardrails AI als Bibliothek, verpackt sie in einen FastAPI-Dienst und registriert den Dienst als benutzerdefiniertes HTTP-Guardrail in TrueFoundry. Um ein bekanntes v0.9.3-Verhalten zu vermeiden, bei dem sich verkettete Guard.use()-Aufrufe gegenseitig überschreiben, stellt der Wrapper einen POST-Endpunkt pro Validator und Richtung bereit – /detect-pii-input, /secrets-present-output, /toxic-language-input usw. – und führt jeden Guard isoliert aus. Administratoren wählen im Dashboard aus, welche Validatoren an welches Modell angehängt werden sollen.

Hub-Validatoren werden zur Docker-Build-Zeit über ein Build-Argument installiert, das das Hub-Token überträgt. Das Token wird im Build-Layer verbraucht und ist in der Laufzeitumgebung nicht vorhanden. Die Validator-Versionen sind auf den Stand fixiert, den der Hub zur Build-Zeit bereitgestellt hat; das Aktualisieren des Bundles erfolgt über eine Anpassung der Dockerfile und ein Re-Deployment.
Die Antwortstruktur des Wrappers sieht wie folgt aus:
Wrapper meldetGateway interpretiertHTTP 200 + {"verdict": true}Zulassen – Validator hat nicht angeschlagenHTTP 200 + {"verdict": false, "message": "<validator>: ..."}Blockieren – Gateway leitet die Nachricht weiterHTTP 5xxTatsächlicher Fehler – geroutet über die Fail on error-Policy des Dashboards
Der HTTP-Status signalisiert "abgeschlossen vs. fehlerhaft"; die Entscheidung (Verdict) befindet sich im JSON. Rail-Blockaden und vorübergehende Ausfälle sind unterscheidbar, weshalb Fail on error: false der sichere Standard ist.
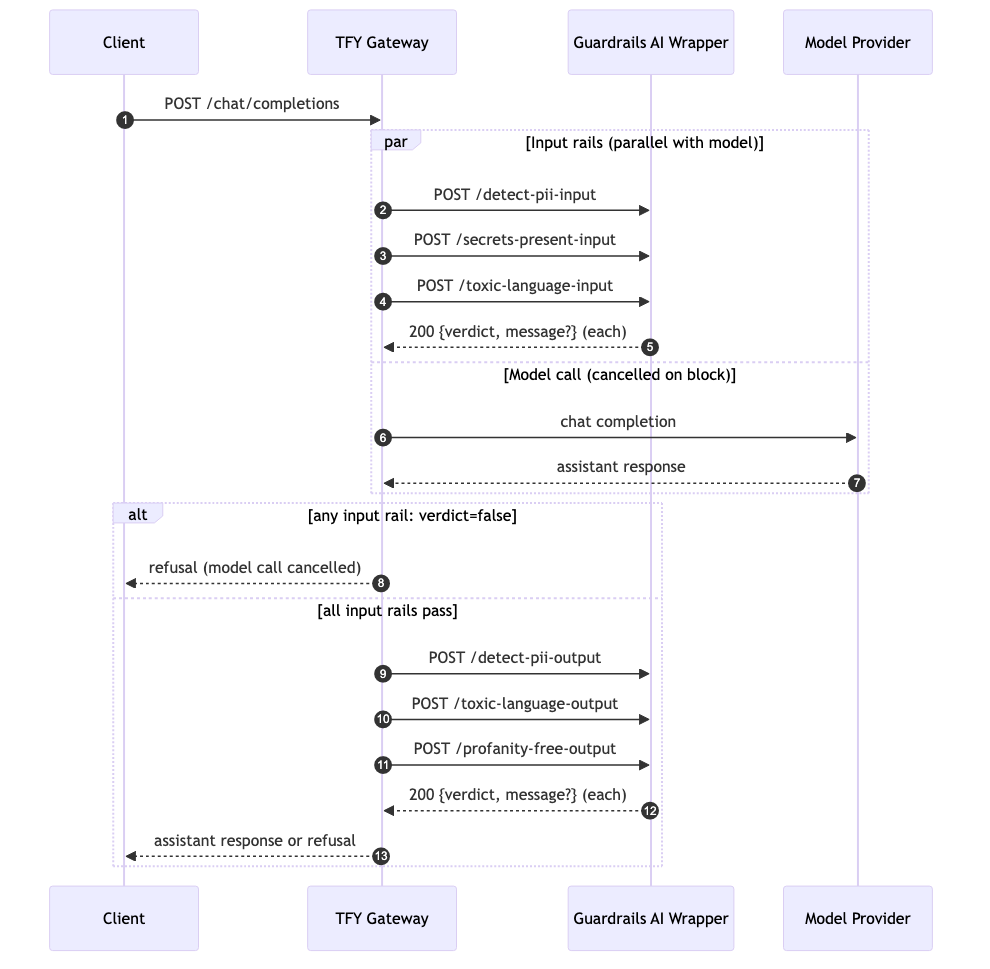
X-TFY-GUARDRAILS-Header ausgewählt werden).{"verdict": false, "message": "<validator>: <reason>"} zurück; alle, die erfolgreich prüfen, geben {"verdict": true} zurück.Da kein Validator ein externes LLM aufruft, wird die zusätzliche Latenz pro Rail hauptsächlich durch die Python-Ausführung und die Klassifizierer-Inferenz bestimmt – typischerweise weit unter 100 ms auf einem aufgewärmten Pod, ohne externe Abhängigkeiten, die ausfallen könnten.
Der Wrapper wird als einzelner FastAPI-Dienst bereitgestellt, der über das Standard-TrueFoundry-Python-SDK deploybar ist. Konfigurieren Sie die URL und den Bearer-Key des Wrappers als Custom Guardrail pro Validator im Dashboard, hängen Sie die Rails an ein Modell an oder wählen Sie sie pro Anfrage aus – die Validatoren laufen inline bei jedem Aufruf. Die Referenzimplementierung befindet sich unter integrations/guardrails-ai/ im integrations-custom-guardrails-Repository; Informationen zum Dashboard-Ablauf finden Sie in der TrueFoundry Custom Guardrail Dokumentation und weitere Validatoren im Guardrails Hub-Katalog.
Das architektonische Prinzip ist die saubere Trennung der Komplexität der Validatoren von der Ausführung im Gateway. Das Gateway bleibt zustandslos, CPU-gebunden und frei von externen Abhängigkeiten im Anfragepfad. Presidio-Analysatoren, detect-secrets-Plugins und Hugging Face-Inferenz befinden sich alle hinter einer einzigen HTTP-Grenze. Das Ersetzen durch eine andere Validator-Engine in der Zukunft erfordert lediglich eine Anpassung des Wrappers – die Dashboard-Konfiguration, der Vertrag und die aufrufenden Apps bleiben exakt so, wie sie sind.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet














