


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Direkte Modellvergleiche stellen meist die falsche Frage. „Terra oder Flash?“ impliziert, dass Sie sich an eines binden müssen. GPT-6.1 Terra und Gemini 3.6 Flash besetzen jedoch dieselbe Stufe der Leiter: Mid-Tier, großer Kontext, starke (aber nicht Flaggschiff-) Coding-Modelle mit Preisen, die nah beieinander liegen. Wenn zwei Modelle so nah beieinander liegen und so austauschbar sind, ist es ein teurer Fehler, eines auszuwählen und fest im Code zu verankern. Der günstige, belastbare Schritt besteht darin, zwischen ihnen zu routen, jedes dort einzusetzen, wo es besser oder günstiger ist, und auf das andere auszuweichen, wenn ein Anbieter einen Ausfall hat.
Dieser Beitrag vergleicht die beiden Modelle in den entscheidenden Dimensionen (Preis, Kontext, Coding, Geschwindigkeit) – alle auf Berichten basierend und unter Vorbehalt – und bringt dann das eigentliche Argument auf den Punkt: Betrachten Sie sie als austauschbare Ziele in einer Routing-Richtlinie, mit einem Flaggschiff-Modell darüber für die wirklich schwierigen Aufgaben.
Hinweis zur Genauigkeit: Abgesehen von den Claude-Zahlen, die als Referenz dienen, stammen alle unten genannten Spezifikationen aus Berichten von Drittanbietern mit Stand November 2026, und einige Quellen widersprechen sich. Überprüfen Sie die Zahlen auf den offiziellen Seiten von OpenAI und Google, bevor Sie darauf aufbauen.
Möchten Sie zwischen Mid-Tier-Modellen nach Aufgabe und Preis routen, inklusive automatischem Fallback? Buchen Sie eine Demo.
GPT-6.1 Terra wurde laut Berichten um den 26. Oktober 2026 als Mid-Tier-Mitglied der GPT-6.1-Reihe von OpenAI veröffentlicht. Gemeldetes Profil: $1 pro 1M Input-Token, $5 pro 1M Output-Token, etwa 1,05M Kontextfenster und ein Coding Index von ca. 48. Das bemerkenswerte Merkmal ist der Preis: Mit gemeldeten $1 / $5 liegt es bei etwa der Hälfte der Kosten pro Token von GPT-6.1 Sol (gemeldet $2 / $10), während es Berichten zufolge einen Großteil der Coding-Fähigkeiten von Sol beibehält.
Gemini 3.6 Flash wurde laut Berichten um den Juli 2026 als geschwindigkeitsoptimiertes Mid-Tier-Modell von Google veröffentlicht. Gemeldetes Profil: $1.50 pro 1M Input-Token, $7.50 pro 1M Output-Token, ein 1M-Kontextfenster, ein Durchsatz nahe 280 Token pro Sekunde, ein Intelligence Index nahe 50 und ein SWE-Bench Pro von ca. 58,7 %. Das bemerkenswerte Merkmal ist die Kombination aus Coding-Leistung und Geschwindigkeit zu einem Mid-Tier-Preis.

Preise/Benchmarks wie im November 2026 berichtet; überprüfen Sie diese vor Verlass auf den offiziellen Preisseiten der jeweiligen Anbieter — Modell-Spezifikationen ändern sich häufig. Claude-Zahlen, wo an anderer Stelle erwähnt, sind die einzigen erstparteiisch bestätigten Werte.
Einige ehrliche Vorbehalte zum Lesen dieser Tabelle:
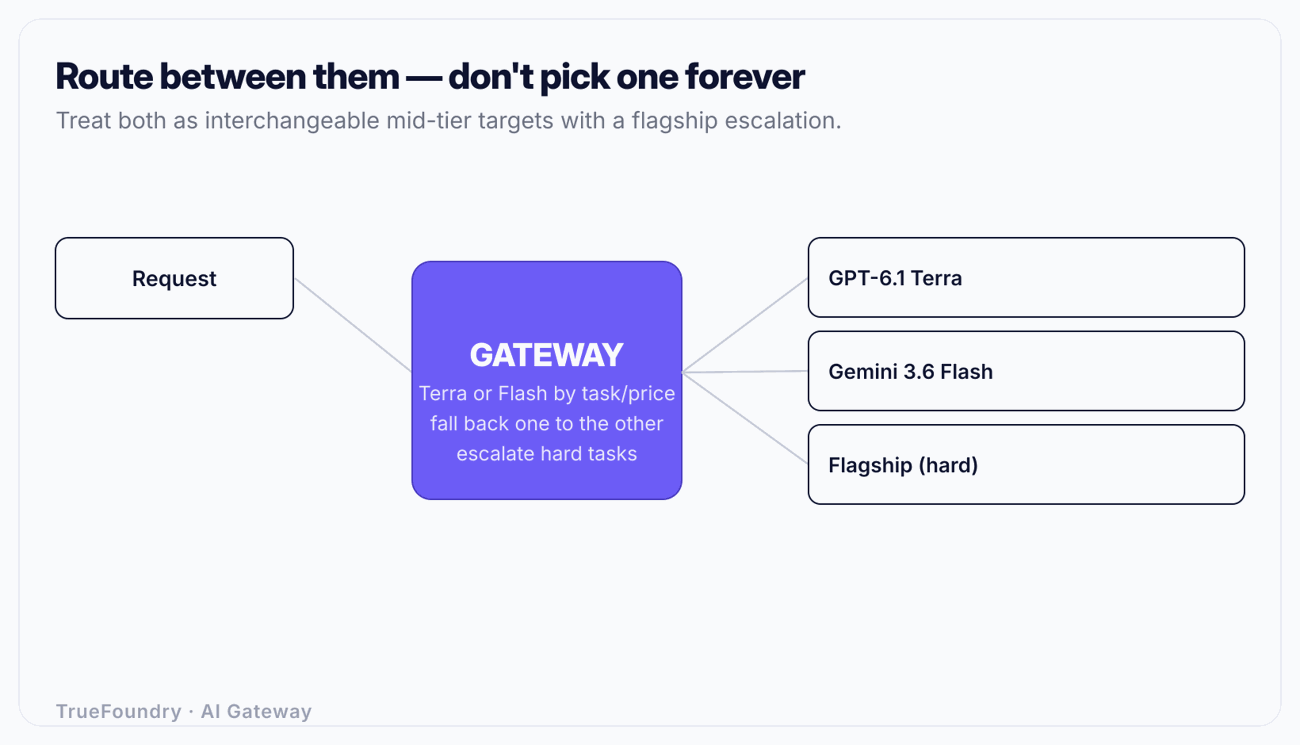
Die Schlussfolgerung, auf die die Tabelle hinweist, lautet nicht „Terra gewinnt“ oder „Flash gewinnt“. Sie zeigt, dass diese beiden Modelle nah genug beieinander liegen, um als Ersatz füreinander zu dienen – und genau zwischen solchen Alternativen möchte man routen.
Wenn zwei Modelle gegeneinander austauschbar sind, bringt Ihnen die Festlegung auf eines keinen Vorteil, kostet Sie aber zwei Dinge: Sie verlieren die Möglichkeit, das für die jeweilige Aufgabe besser geeignete Modell zu nutzen, und Sie gehen das Ausfallrisiko eines einzelnen Anbieters ein. Das Routing zwischen den Modellen löst beide Probleme.
Der laut Berichten niedrigere Preis von Terra macht es zum Standard für output-intensive, kostensensible Anfragen: Massengenerierung, lange Chats, alltägliches Coding in hohem Volumen. Der berichtete Vorsprung von Flash bei Coding und Geschwindigkeit macht es zum bevorzugten Ziel für coding-intensive Anfragen oder latenzkritische Pfade, bei denen ~280 Token/Sek. eine Rolle spielen. Sie müssen sich nicht global entscheiden; Sie entscheiden pro Aufgabenklasse. Das ist kosten- und qualitätsbewusste Modellauswahl, und der Mechanismus dahinter ist ein LLM-Router.
Da sie austauschbar sind, ist jedes Modell ein natürlicher Fallback für das andere. Konfigurieren Sie Terra als primäres Modell mit Flash als Fallback (oder umgekehrt), und ein Anbieterfehler, eine Zeitüberschreitung oder ein Rate-Limit bei dem einen wird vom anderen aufgefangen. Der Benutzer sieht eine geringfügig langsamere Antwort, aber keinen Fehler. Das ist der Kernwert von LLM-Fallback: Zwei austauschbare Mid-Tier-Modelle bieten Ihnen eine Anbieter-Redundanz nahezu kostenlos, da Sie ohnehin eines von ihnen betreiben wollten.
Keines der beiden ist ein Flaggschiff. Für komplexe agentische Coding-Aufgaben oder tiefgründiges Reasoning sollten beide an eine Flaggschiff-Stufe eskaliert werden (Claude Opus 5.5 ist ein bestätigt starker Standard; GPT-6.1 Sol und Gemini 3.1 Pro sind laut Berichten gleichwertig). Das Mid-Tier-Paar übernimmt den Großteil; das Flaggschiff fängt die schwierigen Fälle ab. Die Steuerung erfolgt über eine Routing-Regel.
Erfahren Sie, wie TrueFoundry austauschbare Modelle als eine einzige Routing-Richtlinie behandelt. Buchen Sie eine Demo.
Preise/Benchmarks wie im November 2026 berichtet; überprüfen Sie diese vor Verlass auf den offiziellen Preisseiten der jeweiligen Anbieter — Modell-Spezifikationen ändern sich häufig.
Beachten Sie, dass die meisten Zeilen die beiden Modelle als primäres Modell und Fallback kombinieren, anstatt eines exklusiv auszuwählen. Das ist das Designziel: Sie wählen keinen einzelnen Sieger, sondern weisen Rollen zu, die getauscht werden können.
Die obige Richtlinie ist nur nützlich, wenn sie einfach zu definieren und leicht zu ändern ist. Ein AI Gateway mit einer einheitlichen, OpenAI-kompatiblen API bietet Ihnen genau das. Ihre Anwendung ruft einen stabilen Alias auf; das Gateway entscheidet, ob die Anfrage bei Terra, Flash oder einem Flaggschiff landet und was im Fehlerfall zu tun ist.
Da beide Modelle über Aliase angesprochen werden, ist das Erscheinen von GPT-6.2 oder Gemini 3.7 – oder eine Preissenkung bei einem der Modelle – nur eine Anpassung der Konfiguration. Ihre Routing-Richtlinie passt sich an; Ihre Anwendung bleibt unverändert.
Nehmen wir ein Developer-Tooling-Produkt, das monatlich 4 Millionen Mid-Tier-Coding-Anfragen sendet, die stark output-lastig sind (ca. 600 Input- und 1.500 Output-Token pro Anfrage, da Code-Generierung viele Token erzeugt).
Der Output dominiert hier, daher ist der Output-Preis der entscheidende Hebel. Bei Terras gemeldeten $5 / 1M Output kosten 1.500 Output-Token pro Anfrage etwa $0,0075 beim Output. Bei Flashs gemeldeten $7.50 / 1M kostet dieselbe Anfrage etwa $0,01125 beim Output – ungefähr 50 % mehr. Bei 4 Millionen Anfragen ist dieser Unterschied erheblich.
Flash codet jedoch Berichten zufolge etwas besser und läuft schneller. Die Richtlinie lautet also nicht „alles an Terra“. Sie lautet: Routen Sie den Großteil der Routine-Generierung an Terra, um den Output-Preisvorteil zu nutzen, routen Sie die schwierigeren oder latenzkritischen Coding-Anfragen an Flash und nutzen Sie bei Fehlern jeweils das andere Modell als Fallback. Anschließend überwachen Sie die Kosten und Qualität pro Modell in der Observability-Lösung und feineinstellen die Verteilung. Wenn Terras Qualität bei Ihrem Traffic ausreicht, setzen Sie verstärkt darauf; wenn sich der Coding-Vorsprung von Flash in weniger Wiederholungsversuchen niederschlägt, ändert das die Berechnung. Der einzige Weg, dies herauszufinden, ist Messung – weshalb Routing und Observability ein einzelnes System bilden sollten, keine zwei getrennten.
Wiederholungsversuche (Retries) verändern diese Rechnung auf eine Weise, die reine Preistabellen verbergen. Wenn Terras Output 33 % günstiger ist, aber ein falsches Ergebnis liefert, das 5 % öfter als bei Flash eine zweite Anfrage erfordert, frisst diese Retry-Rate einen Teil des Preisvorteils auf, da eine wiederholte Anfrage doppelt bezahlt wird. Deshalb ist ein rein flacher Preisvergleich irreführend und Sie müssen die effektiven Kosten pro erfolgreicher Antwort messen, nicht die Kosten pro Aufruf. Ein Modell, das nominell günstiger ist, aber mehr Wiederholungen benötigt, kann bei realem Traffic teurer werden – und der einzige Weg, dies zu erkennen, ist eine Modell-Observability, die sowohl Kosten als auch Fehlerraten bei Ihren eigenen Anfragen nachverfolgt.
Um zu verhindern, dass eine Eskalationsstufe unbemerkt zu hohe Kosten verursacht, begrenzen Sie die Flaggschiff-Stufe mit Token-Rate-Limiting und Budgets, sodass eine ausufernde Eskalation einen HTTP-429-Fehler statt einer überraschend hohen Rechnung zurückgibt.
GPT-6.1 Terra und Gemini 3.6 Flash stehen nicht in einem Duell mit einem eindeutigen Sieger. Es sind zwei austauschbare Mid-Tier-Arbeitstiere mit Preisen innerhalb eines Drittels voneinander, beide mit ~1M Kontext und jeweils mit einem kleinen gemeldeten Vorteil, den das andere nicht hat: Terra beim Preis, Flash bei Coding und Geschwindigkeit. Wenn Modelle so nah beieinander liegen, lautet die Frage nicht, welches gekrönt werden soll, sondern wie man beide nutzt.
Routen Sie zwischen ihnen nach Aufgabe und Kosten, nutzen Sie das eine als Fallback für das andere für nahezu kostenlose Anbieter-Redundanz und eskalieren Sie nur für die schwierigen Fälle an ein Flaggschiff. Drücken Sie all dies als Richtlinie an einem Gateway hinter einer einzigen OpenAI-kompatiblen API aus – und das nächste Release oder die nächste Preissenkung eines Anbieters wird zu einer bloßen Konfigurationsänderung statt zu einer Migration. So holen Sie das Beste aus beiden heraus, ohne Ihre Architektur auf eines von beiden zu verwetten.
Routen Sie zwischen Terra und Flash, anstatt sich auf eines festzulegen. Buchen Sie eine Demo.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





