


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Die meisten Teams haben kein Flaggschiff-Problem. Sie haben ein Standardmodell-Problem. Das Modell, das die durchschnittliche Anfrage beantwortet – die Anfrage, die den Long Tail von Chat, Zusammenfassungen, täglichem Coding und Retrieval-Augmented Generation (RAG) abdeckt –, verursacht die eigentlichen Kosten, weil dort das Volumen liegt. Gemini 3.6 Flash ist genau deshalb interessant, weil es für diese Standardrolle gebaut wurde: leistungsfähig genug, dass Benutzer keinen Qualitätsverlust gegenüber einem Flaggschiff bemerken, und günstig genug, um den Haupt-Traffic darauf zu leiten.
Dieser Beitrag behandelt, was Gemini 3.6 Flash ist (wie im November 2026 berichtet), wie es sich zwischen extrem günstigen kleinen Modellen und den Flaggschiffen einordnet, wann Sie es wählen sollten und wann nicht, sowie das Gateway-Muster, mit dem Sie es als Standard festlegen und gleichzeitig die Anfragen eskalieren können, die wirklich mehr Leistung benötigen.
Ein Hinweis zur Genauigkeit vorab: Abgesehen von den Claude-Zahlen stammen die folgenden Spezifikationen aus Berichten von Drittanbietern und Quellen, die sich teilweise widersprechen. Betrachten Sie sie als Ausgangspunkt und überprüfen Sie sie anhand der offiziellen Modell- und Preisübersichten von Google, bevor Sie darauf aufbauen. Modell-Spezifikationen ändern sich häufig.
Möchten Sie den Großteil des Traffics auf ein Modell der Flash-Klasse leiten und nur komplexe Anfragen eskalieren? Buchen Sie eine Demo.
Berichten zufolge wurde Gemini 3.6 Flash um Juli 2026 als geschwindigkeitsoptimiertes Mittelklasse-Modell in Googles Gemini 3.x-Reihe veröffentlicht. Das berichtete Profil:
Die Kurzzusammenfassung: Ein Modell, das den Großteil des alltäglichen Nutzens eines Flaggschiffs zu einem Mittelklasse-Preis bietet – kombiniert mit einem Kontextfenster der Flaggschiff-Klasse und hohem Durchsatz. Genau diese Kombination macht ein ideales Standardmodell aus.
Preise/Benchmarks wie im November 2026 berichtet; überprüfen Sie diese vor der Verwendung auf der offiziellen Preisseite des jeweiligen Anbieters — Modell-Spezifikationen ändern sich häufig.
Falls Ihr Konto oder Ihre Region 3.6 Flash noch nicht anzeigt, ist Gemini 3.5 Flash der sichere, allgemein verfügbare Fallback. Betrachten Sie 3.6 als Ziel und 3.5 GA als Absicherung, bis Sie 3.6 direkt bestätigen können.
Am besten stellt man sich Flash als die mittlere Sprosse einer dreistufigen Leiter vor. Darunter liegt die Klasse der extrem günstigen Modelle. Darüber stehen die Flaggschiffe. Jede Stufe hat ihre Berechtigung.
Extrem günstige Stufe (ca. $ 0,10–$ 0,25 Input). Claude Haiku 5.5 ist ab $ 0,10 / $ 0,50 bestätigt. Das berichtete GPT-6 Luna liegt bei $ 0,10 / $ 0,50 und Gemini 3.1 Flash-Lite bei nahe $ 0,25 / $ 1,50. Diese eignen sich für Klassifizierung, Extraktion, Routing und andere kurze, eindeutige Aufgaben. Beim Input-Preis sind sie etwa 15-mal günstiger als Flash. Sie sind nicht so leistungsfähig und auch nicht dafür gedacht.
Arbeitspferd der Flash-Klasse (ca. $ 1–$ 2 Input). Gemini 3.6 Flash zu berichteten $ 1,50 / $ 7,50, zusammen mit Alternativen wie Claude Sonnet 5.5 (bestätigt $ 2 / $ 10) und dem berichteten GPT-6.1 Terra ($ 1 / $ 5). Das ist die Standardstufe: Chat, Zusammenfassungen, RAG-Antworten, alltägliches Coding – alles, was echte Kompetenz erfordert, aber kein tiefgehendes Reasoning.
Flaggschiff-Stufe (ca. $ 2–$ 10 Input, hoher Output-Preis). Gemini 3.1 Pro (berichtete $ 2 / $ 12), Claude Opus 5.5 (bestätigt $ 4 / $ 20), das berichtete GPT-6 Astra ($ 10 / $ 50). Diese rechtfertigen ihren Preis nur bei schwierigen Aufgaben: langwieriges agentisches Coding, tiefes Reasoning, komplexe Analysen.

Der Sinn dieser Stufen liegt darin, dass jede Ebene etwa eine Größenordnung bei Preis oder Leistung voneinander entfernt ist. Die Weiterleitung einer Anfrage an die falsche Stufe ist in der einen Richtung teuer und führt in der anderen zu unzureichender Qualität. Flash ist die Stufe, auf die der Großteil Ihres Traffics gehört.
Flash ist der richtige Standard, aber nicht die passende Antwort für jede Aufgabe. Hier ist die Entscheidungshilfe.
Preise/Benchmarks wie im November 2026 berichtet; überprüfen Sie diese vor der Verwendung auf der offiziellen Preisseite des jeweiligen Anbieters — Modell-Spezifikationen ändern sich häufig. Claude-Zahlen sind vom Anbieter bestätigt.
Erfahren Sie, wie TrueFoundry standardmäßig günstige Modelle nutzt und automatisch Fallbacks ausführt. Buchen Sie eine Demo.
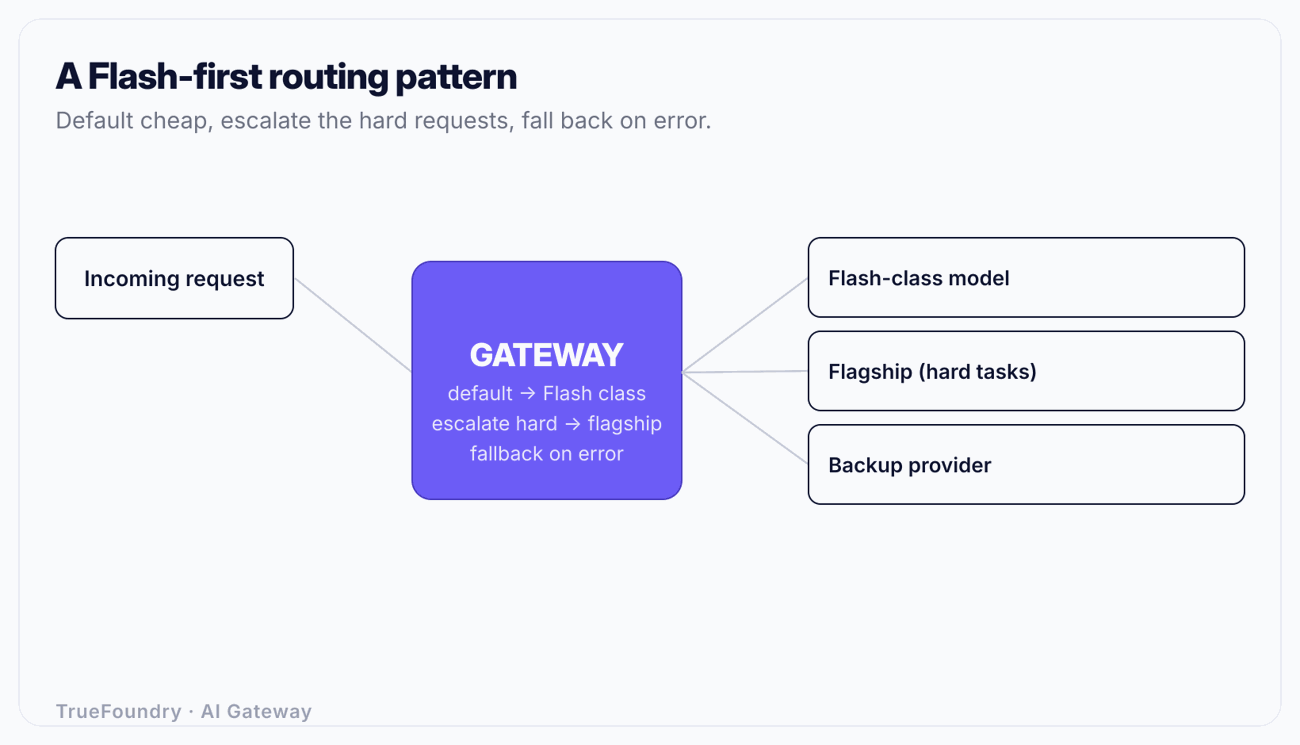
Zu wissen, dass Flash Ihr Standard sein sollte, reicht nicht aus. Sie benötigen einen Mechanismus, der den Großteil des Traffics an Flash sendet, anspruchsvollere Anfragen erkennt, nur diese eskaliert und auch dann funktioniert, wenn Google kurzzeitige Ausfälle hat. Dieser Mechanismus ist ein AI Gateway mit einer einheitlichen, OpenAI-kompatiblen API.
Hier ist das Muster in vier Schritten:
1. Flash als Standard-Route festlegen. Weisen Sie in der Gateway-Konfiguration ein Modell-Alias (z. B. default-chat) auf Gemini 3.6 Flash zu. Ihre Anwendung ruft default-chat auf; sie verwendet niemals einen hartkodierten String wie „gemini-3.6-flash“. Wenn Sie Sonnet 5.5 oder Terra als Standard testen möchten, ändern Sie eine einzelne Konfigurationszeile und verlagern einen Teil des Traffics – ganz ohne Anwendungs-Deployment. Das ist kosten- und qualitätsbewusste Modellauswahl in der Praxis, und das zugrundeliegende Prinzip entspricht der Funktionsweise eines LLM-Routers.
2. Komplexe Anfragen eskalieren. Markieren Sie Anfragen, die mehr Leistung benötigen (ein Komplexitätssignal aus Ihrer App, ein spezifischer Endpoint oder ein Retry nach einer Antwort mit niedriger Confidence), sodass das Gateway sie stattdessen an ein Flaggschiff-Alias leitet. Der meiste Traffic bleibt bei Flash; nur der kleine, komplexe Teil zahlt Flaggschiff-Preise. Die Steuerung erfolgt über eine Routing-Regel und nicht über im Code verteilte Verzweigungen.
3. Fallback bei Fehlern nutzen. Konfigurieren Sie Flash so, dass es auf einen zweiten Anbieter ausweicht, wenn Google einen Fehler zurückgibt oder ein Timeout auftritt. Eine Anfrage der Flash-Klasse kann auf Claude Sonnet 5.5 oder GPT-6.1 Terra ausweichen. Durch Retries innerhalb der Anfrage und Anbieter-Fallbacks wird ein Ausfall beim Provider lediglich zu einer kurzen Latenzspitze statt zu einem Systemausfall. Lesen Sie mehr dazu unter Was ist ein LLM-Fallback.
4. Cachen und messen. Exaktes und semantisches Caching verhindern, dass Sie für dieselbe Frage zweimal an Flash zahlen; siehe Semantisches Caching. Jeder Aufruf wird mit Tokens, Latenz und Kosten erfasst – getaggt nach Benutzer, Team und Modell. So können Sie nachweisen, dass Flash das Hauptvolumen trägt und das Flaggschiff nur für komplexe Fälle genutzt wird. Siehe LLM Observability Tools.
Nehmen wir ein Produkt mit 5 Millionen Anfragen pro Monat – hauptsächlich Chat und RAG, mit einem kleineren Anteil an komplexem Reasoning. Nehmen wir an, die Verteilung liegt bei 75 % alltäglichen Anfragen (für Flash geeignet), 20 % trivialen Anfragen (für extrem günstige Modelle geeignet) und 5 % komplexen Anfragen (für Flaggschiffe geeignet), bei durchschnittlich 800 Input- und 400 Output-Tokens.
Wenn alles auf einem Flaggschiff für $ 2 / $ 12 läuft, zahlen Sie den Flaggschiff-Output-Preis für alle 5 Millionen Anfragen – einschließlich der 3,75 Millionen Anfragen, die Flash genauso beantwortet hätte, und der 1 Million Anfragen, die ein $ 0,10-Modell identisch gelöst hätte.
Routen Sie stattdessen nach Stufen:
Der triviale 20 %-Anteil senkt die Input-Kosten um das 15-Fache, indem er von Flash auf die günstigste Stufe wechselt. Der alltägliche 75 %-Anteil sinkt beim Output von den Flaggschiff-Kosten ($ 12) auf Flash-Kosten ($ 7,50) – eine Ersparnis von fast 40 % beim Hauptkostenfaktor. Der komplexe 5 %-Anteil nutzt weiterhin das Flaggschiff. Unter dem Strich sinkt die Gesamtrechnung bei den meisten Token-Kombinationen um weit mehr als ein Drittel – ohne Qualitätsverlust, da jede Anfrage von einem genau passenden Modell verarbeitet wird. Den genauen Betrag können Sie durch die Erfassung der Kosten pro Stufe nachweisen. Deshalb sind Observability und Kostenzuordnung genauso wichtig wie das Routing selbst.
Damit die Flaggschiff-Stufe das Budget nicht unbemerkt überschreitet, setzen Sie Obergrenzen mit Token-Rate-Limiting und Budgets: Das Gateway gibt ein HTTP 429 zurück, wenn ein Team oder Modell sein Limit erreicht. So kann ein Eskalationspfad nicht zu unkontrollierten Ausgaben führen.
Gemini 3.6 Flash ist genau für den Bereich konzipiert, in dem der Großteil Ihrer Ausgaben entsteht: die durchschnittliche Anfrage. Mit berichteten $ 1,50 / $ 7,50, einem 1M-Kontextfenster und hohem Durchsatz bietet es den Großteil des alltäglichen Nutzens eines Flaggschiffs ohne dessen Preis – und hebt sich deutlich von der günstigsten Modellstufe ab, die weiterhin triviale Aufgaben übernehmen sollte. Das richtige Denkmodell ist eine Stufenleiter, und Flash ist die Sprosse, auf die der meiste Traffic gehört.
Machen Sie es an einem Gateway zu Ihrem Standard, eskalieren Sie nur komplexe Anfragen an ein Flaggschiff, weichen Sie auf einen zweiten Anbieter aus, wenn Google Probleme hat, und messen Sie die Kosten pro Modell, um den Erfolg der Strategie zu belegen. Auf diese Weise wird die Nutzung von Gemini 3.6 Flash von einer einmaligen Entscheidung zu einer flexiblen Routing-Policy, die Sie anpassen können, sobald das nächste Modell oder die nächste Preissenkung ansteht.
Routen Sie zum günstigsten Modell, das gut genug ist. Buchen Sie eine Demo.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





