


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
„Was ist das beste LLM für Coding?“ ist die falsche Frage, weil es darauf keine dauerhafte Antwort gibt. Das Modell, das die sauberste 40-Zeilen-Funktion schreibt, ist nicht dasjenige, das Sie Tokens bei einem Refactoring über 30 Dateien verbrennen lassen wollen. Und das Modell, das einen extrem kniffligen Concurrency-Bug löst, ist Overkill für die Autovervollständigung eines Getters. Benchmarks ändern sich alle paar Wochen. Ein Team, das im Januar ein einzelnes Modell fest in seine Tools einprogrammiert, stellt diese Entscheidung bis April wieder infrage.
Die bessere Frage lautet: An welches Modell route ich Anfragen für diese spezifische Art von Programmieraufgabe bei diesem Budget – und wie halte ich Ausgaben und Sicherheit unter Kontrolle, wenn hundert Entwickler diese Frage jeweils unterschiedlich beantworten? Genau diese Frage beantwortet dieser Beitrag. Wir stellen die Kandidaten basierend auf ihren tatsächlichen Stärken vor, bieten Ihnen ein Entscheidungsframework von Aufgabe zu Modell, das jeden einzelnen Benchmark überdauert, und behandeln dann den Teil, den die meisten Teams überspringen: die Routing- und Governance-Schicht, die die Modellwahl zu einem Konfigurationswert statt zu einem Code-Rewrite macht.
Ein Hinweis zur Genauigkeit vorweg: Die unten stehenden Preise für Anthropic Claude sind auf dem Stand von November 2026 verifiziert. Die Benchmark-Zahlen der Mitbewerber basieren auf gemeldeten oder aggregierten Daten; wir kennzeichnen diese mit Quellen und Datum. Bitte überprüfen Sie diese Angaben beim jeweiligen Anbieter, bevor Sie Budget investieren.
Möchten Sie Kosten pro Entwickler nachverfolgen und Guardrails für jedes Coding-Modell einrichten? Buchen Sie eine Demo.
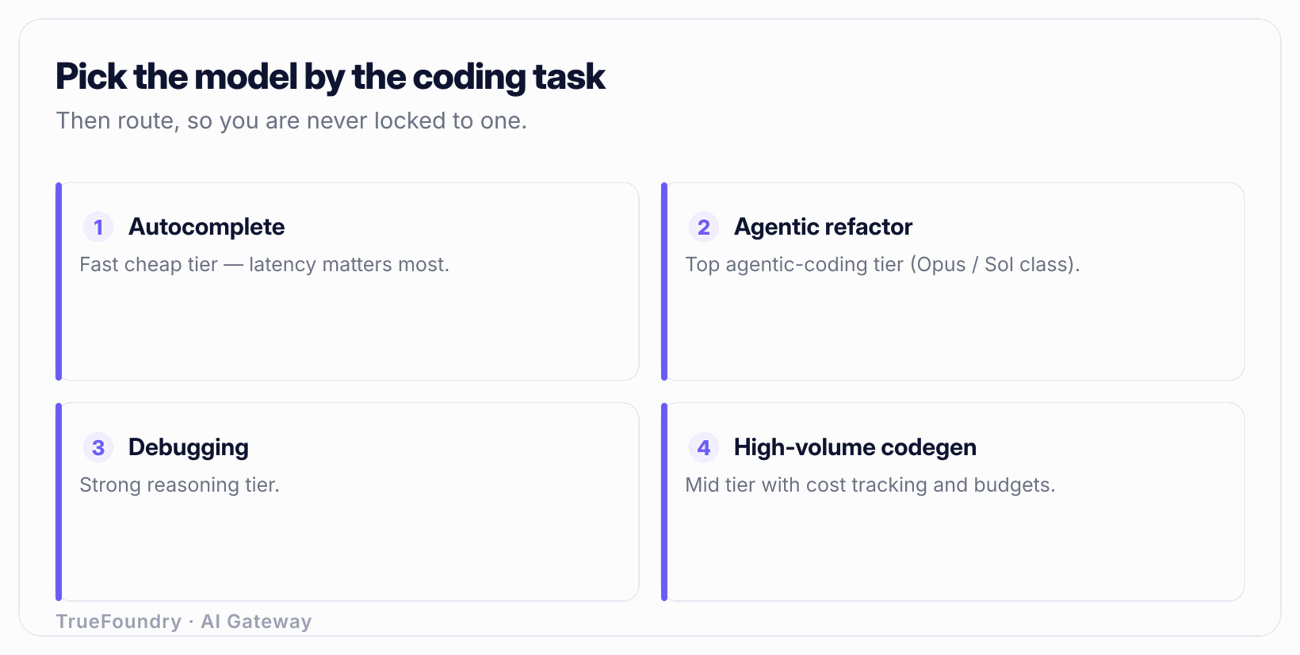
Bevor Sie ein Modell auswählen können, müssen Sie die genaue Aufgabe definieren. Die meisten Vergleiche zum „besten Coding-LLM“ scheitern, weil sie den Durchschnitt über Aufgaben bilden, die völlig gegensätzliche Anforderungen haben. Teilen Sie Coding in vier Kategorien ein, wird die Wahl deutlich klarer.
Autovervollständigung / Inline-Completion. Das Modell sagt die nächsten Zeilen voraus, während Sie tippen. Latenz ist hier alles – alles über etwa 300–500 ms unterbricht den Workflow. Der Kontext ist klein (die aktuelle Datei plus einige benachbarte). Da Sie Tausende dieser Aufrufe pro Entwickler und Tag durchführen, dominieren die Stückkosten. Sie benötigen ein schnelles, günstiges Modell, nicht das klügste.
Agentenbasiertes Multi-File-Refactoring. Das Modell plant, liest viele Dateien, bearbeitet mehrere, führt Tests aus und iteriert – eine Schleife, die Minuten dauern und Hunderte von Tausenden Tokens in einer einzigen Aufgabe verbrauchen kann. Hier zahlen sich Gedankentiefe, Kohärenz bei langem Kontext und die Fähigkeit aus, über viele Schritte hinweg am Plan festzuhalten. Hier ist ein schwaches Modell auch am teuersten, weil es unnötig Tokens verbrennt und Ihnen am Ende einen fehlerhaften Diff liefert.
Tiefgehendes Debugging. Ein schwerwiegendes Problem: eine Race Condition, ein Speicherleck, ein Heisenbug, der nur unter Last auftritt. Das Volumen ist gering, aber der Wert einer korrekten Lösung ist hoch. Sie wollen maximale Reasoning-Qualität und sind bereit, pro Vorfall dafür zu zahlen.
High-Volume-Codegen. Scaffolding, Boilerplate, Test-Stubs, Migrationsskripte, Docstrings – große Mengen an einfachem Code. Die Qualitätsanforderungen sind moderat; Durchsatz und Kosten pro Generierung stehen im Vordergrund. Ein Modell der mittleren Kategorie gewinnt hier meist bei den Gesamtkosten (TCO).
Diese vier Kategorien lassen sich selten mit einem einzigen Modell abdecken. Derselbe Entwickler möchte in derselben Stunde ein schnelles, günstiges Modell für Vervollständigungen, ein tiefgehendes Reasoning-Modell für einen hartnäckigen Bug und ein starkes Agentenmodell für ein im Hintergrund gestartetes Refactoring. Das ist der strukturelle Grund, warum die Standardisierung auf ein einziges Modell scheitert.
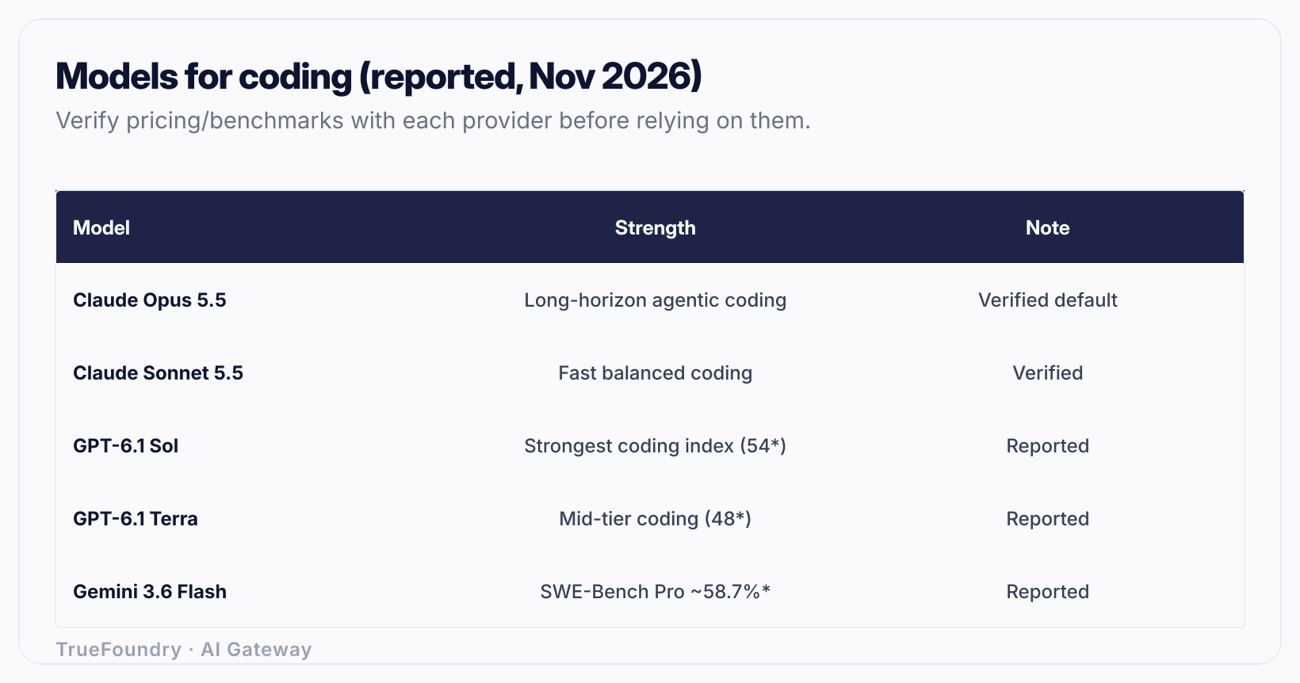
Hier ist der ehrliche Stand der Dinge im November 2026. Die Preise für Claude sind verifiziert; die übrigen Angaben basieren auf Berichten und sollten erneut überprüft werden.
Die 5.5-Generation von Claude lässt sich sauber auf die oben genannten Aufgabenarten aufteilen:
Das praxiserprobte Muster ist eine Tiering-Strategie innerhalb des Claude-Ökosystems: Haiku für Vervollständigungen und Bulk-Aufgaben, Sonnet für die meiste Agentenarbeit, Opus für komplexe Refactorings und schwierige Debugging-Sessions.
Mit Stand November 2026 liegt GPT-6.1 Sol laut Berichten an der Spitze der allgemeinen Programmierfähigkeiten mit einem aggregierten „Coding Index“ von etwa 54. GPT-6.1 Terra folgt knapp dahinter bei etwa 48. Sol wird als Frontier-Coding-Modell positioniert; Terra als schnellere, günstigere Stufe. Betrachten Sie die Indexzahlen als Orientierung – sie stammen aus Aggregationen von Drittanbietern, nicht aus einem einzelnen standardisierten Testfeld. Die Preise und Tier-Namen von OpenAI sollten Sie vor der Budgetvergabe auf deren Website bestätigen.
Gemini 3.6 Flash erreicht laut Berichten etwa 58,7 % bei SWE-Bench Pro, einem Benchmark, der reale Korrekturen im Pull-Request-Stil an echten Repositories misst. Wenn sich diese Zahl bestätigt, ist Flash bei praktischen Software-Engineering-Aufgaben in einer auf Geschwindigkeit und Kosten optimierten Leistungsklasse äußerst konkurrenzfähig. Auch hier gilt: Stand November 2026, bitte bei Google verifizieren.
SWE-Bench und Coding-Indizes messen die Fähigkeit eines Modells, ein korrektes Patch für kuratierte Probleme zu erstellen. Sie messen nicht, wie sich ein Modell innerhalb Ihres Agenten, in Ihrem Codebase, mit Ihren Tools und Kontextgrenzen verhält. Ein Modell, das auf einem öffentlichen Benchmark zwei Punkte höher schneidet, kann in der Praxis unterlegen sein, wenn es langsamer ist, ein kleineres effektives Kontextfenster hat oder Ihre Sprache und Ihr Framework schlechter verarbeitet. Nutzen Sie Benchmarks für eine Shortlist und führen Sie dann eigene Evals mit Aufgaben durch, die Ihrer tatsächlichen Arbeit entsprechen.
Hier ist die gemeldete Landschaft in einer Übersicht. Bitte lesen Sie den Hinweis unter der Tabelle, bevor Sie diese Zahlen zitieren.
Hinweis: Die Preise für Claude sind auf dem Stand von November 2026 verifiziert. Alle Zahlen der Mitbewerber sind gemeldete oder aggregierte Werte von Drittanbietern (Stand: November 2026) und nicht direkt über verschiedene Testumgebungen hinweg vergleichbar. Bitte überprüfen Sie Spezifikationen, Verfügbarkeit und Preise bei den jeweiligen Anbietern.
Statt „das beste Modell“ zu wählen, definieren Sie ein Standardmodell pro Aufgabentyp und einen Eskalationspfad. Das ist der Ansatz, der auch dann noch gültig ist, wenn sich das Leaderboard im nächsten Monat verschiebt.
Die Logik: Starten Sie jede Aufgabe auf der günstigsten Stufe, die zuverlässig funktioniert, und eskalieren Sie nur bei einem konkreten Signal – Tests schlagen fehl, der Diff ist zu groß, der Agent befindet sich in einer Endlosschleife. Ein Refactoring, das ein mittleres Modell in zehn teuren Iterationen fehlerhaft ausführt, ist auf einem Top-Modell günstiger, das es in zwei Durchgängen erledigt. Eine Vervollständigung, die ein Top-Modell perfekt beherrschen würde, ist dennoch die falsche Stelle für hohe Ausgaben, da Sie diesen Aufruf zehntausendmal am Tag tätigen.
Beachten Sie, was dieses Framework operational erfordert: Die Fähigkeit, verschiedene Anfragen basierend auf Aufgabentyp und Signalen an unterschiedliche Modelle zu senden, ohne die Anwendung neu zu schreiben. Das ist Routing, und hier kommt ein Gateway ins Spiel. Erfahren Sie unter kosten- und qualitätsbewusste Modellauswahl, wie diese Logik umgesetzt wird, und lesen Sie was ein LLM-Router ist für die technischen Details.
Erfahren Sie, wie TrueFoundry Coding-Traffic routet und Ausgaben pro Entwickler deckelt. Buchen Sie eine Demo.
Stellen Sie sich eine Organisation mit 200 Entwicklern vor. Einige arbeiten in Cursor, einige in Claude Code, einige schwören auf Copilot in VS Code, und das Data-Science-Team ruft Modelle direkt aus Notebooks auf. Jedes Tool nutzt standardmäßig andere Modelle, und jeder Entwickler hat eigene Präferenzen. Selbst wenn Sie heute ein einziges Modell vorschreiben würden, erscheint in sechs Wochen ein besseres – und Ihre besten Ingenieure werden Vorgaben umgehen.
Das ist kein Mangel an Disziplin. Es ist der logische Zielzustand. Verschiedene Aufgaben erfordern unterschiedliche Modelle, verschiedene Tools binden unterschiedliche Modelle ein, und der Stand der Technik verändert sich monatlich. Gegen diese Fragmentierung anzukämpfen ist aussichtslos. Der beste Weg ist, nicht mehr das Modell zu standardisieren, sondern den Kontrollpunkt vor den Modellen.
Konkret bedeutet das: Jeder Coding-Agent in der Organisation – Claude Code, Cursor, Copilot, eigene Skripte – greift auf einen einzelnen OpenAI-kompatiblen Endpunkt zu, anstatt direkt die API des jeweiligen Anbieters aufzurufen. Hinter diesem Endpunkt steuern Sie das Routing, behalten den Überblick über jede Anfrage und setzen Richtlinien durch. Das Modell wird zu einem Konfigurationswert. Der Wechsel von Sonnet zu einem neueren Modell oder das Hinzufügen von GPT-6.1 Sol als Eskalationsstufe für Debugging wird zu einer bloßen Konfigurationsänderung statt zu einer systemweiten Code-Migration.
Ein AI Gateway sitzt zwischen Ihren Coding-Agenten und den Modell-Anbietern und stellt eine einheitliche, OpenAI-kompatible API bereit. Speziell beim Coding sind vier Funktionen entscheidend.
Kostenzuordnung pro Entwickler, Team und Modell. Coding-Agenten verbrauchen Tokens in Ausmaßen, die Finanzabteilungen überraschen können. Ein agentenbasiertes Refactoring kann in einer einzigen Aufgabe über 300.000 Tokens verbrennen. Ohne Zuordnung erhalten Sie eine Gesamtrechnung des Anbieters und wissen nicht, ob die Ausgaben durch die Refactorings des Plattform-Teams oder die Endlosschleife eines einzelnen Entwicklers entstanden sind. Das Gateway versieht jede Anfrage mit Tags für Benutzer, Team und Modell. So können Sie bis auf die einzelne Anfrage genau beantworten, wer wie viel für welches Modell ausgegeben hat. Das bildet die Grundlage für Kostenzuordnung und Team-Budgets sowie für FinOps für KI im Allgemeinen.
Budgets und Rate Limits pro Entwickler oder Team. Legen Sie ein monatliches Budget in Euro/Dollar pro Team und ein Rate Limit für Anfragen pro Entwickler fest. Wird ein Limit überschritten, gibt das Gateway einen HTTP-429-Fehler zurück, anstatt die Rechnung unbemerkt in die Höhe zu treiben. Das verhindert, dass ein falsch konfigurierter Agent in einer Schleife über Nacht vierstellige Kosten verursacht. Die genaue Funktionsweise wird unter Token Rate Limiting und Budgets beschrieben.
Guardrails gegen den Abfluss vertraulicher Daten (Secrets). Coding-Agenten lesen Ihren Quellcode. Quellcode enthält oft hartcodierte Zugangsdaten, interne Hostnamen, Kundendaten in Fixtures und PII in Testdateien. Jede dieser Informationen kann über einen Prompt an den Modell-Anbieter übermittelt werden. Ein Gateway kann ausgehende Anfragen auf Secrets und PII scannen und diese blockieren oder schwärzen, bevor sie Ihr Netzwerk verlassen. Für regulierte Unternehmen ist dies oft der entscheidende Faktor zwischen „genehmigt“ und „verboten“. Siehe AI Guardrails für die verfügbaren Erkennungstypen.
Audit und Observability. Ein zentrales Protokoll für jede Anfrage – wer, welches Modell, wie viele Tokens, Latenz, Kosten, Pass/Fail bei Guardrails. Wenn die IT-Sicherheit fragt, ob im letzten Quartal Quellcode an ein externes Modell durchgesickert ist, haben Sie eine präzise Antwort statt einer ungewissen Vermutung. Kombinieren Sie das Gateway-Log mit Ihren LLM Observability Tools für langfristiges Latenz- und Qualitäts-Tracking.
Das AI Gateway von TrueFoundry bietet genau diese Control Plane – eine einheitliche OpenAI-kompatible API mit Routing nach Latenz/Gewichtung/Priorität, automatischen Fallbacks und In-Request-Retries, exaktem sowie semantischem Caching, Budgets und Rate Limits pro Benutzer/Team/Modell, vollständiger Observability pro Anfrage und Guardrails für PII, Secrets und Prompt-Injection. Es kann als SaaS, in Ihrer VPC, On-Premises oder Air-Gapped bereitgestellt werden, sodass die Data Plane mit Ihrem Quellcode innerhalb Ihres Netzwerks verbleibt.
Ein konkretes Szenario. Drei Entwickler, eine Woche, unterschiedliche Aufgaben:
Drei Entwickler, drei Aufgabentypen, drei Tiers und Gesamtausgaben von knapp 40 $ pro Woche – wobei das tiefe Refactoring von Dev C etwa 14-mal so viel kostet wie die Vervollständigungen von Dev A. Stellen Sie sich nun 200 Entwickler ohne Zuordnung vor: Sie erhalten eine Gesamtrechnung und können nützliche Nutzung nicht von Fehlversuchen unterscheiden. Mit dem Gateway sehen Sie, dass das Refactoring von Dev C teuer und seinen Preis wert war, die Vervollständigungen von Dev A effizient sind, und falls der Agent eines vierten Entwicklers um 2 Uhr morgens in eine Schleife gerät, stoppt das Budget-Limit den Vorgang per 429-Fehler, bevor hoher Schaden entsteht.
Die obigen Zahlen nutzen verifizierte Claude-Preise und gerundete Werte zur Veranschaulichung; Ihre tatsächlichen Token-Mengen werden abweichen. Entscheidend ist die Struktur: Der Aufgabentyp bestimmt das Tier, das Tier bestimmt die Kosten, und die Attributierung macht aus einer unübersichtlichen Gesamtsumme eine kontrollierbare Position.
Dem Leaderboard hinterherlaufen. Teams wählen bei jedem Benchmark-Update ihr „einziges Coding-Modell“ neu und passen jedes Mal ihre Tool-Konfigurationen an. Die Abweichungen im Benchmark sind meist geringer als die Kosten des ständigen Wechsels. Definieren Sie Standards pro Aufgabentyp, routen Sie die Anfragen und lassen Sie das Gateway Modelländerungen als reine Konfiguration abfangen.
Alles an das Top-Modell routen. Opus 5.5 oder GPT-6.1 Sol für Autovervollständigung zu nutzen mag sicher wirken, ist aber finanziell unrentabel – Sie zahlen Frontier-Preise für die Aufrufe mit dem höchsten Volumen und dem geringsten Einzelwert. Passen Sie das Tier an die Aufgabe an. Das günstigste Modell, das zuverlässig funktioniert, ist die richtige Wahl.
Keine Kostenzuordnung vor Rechnungseingang. Viele Teams bemerken die Ausgaben für Coding-Agenten erst, wenn die Finanzabteilung nachfragt. Zu diesem Zeitpunkt lässt sich nicht mehr nachvollziehen, welches Team oder welches Verhalten die Kosten verursacht hat. Kostenzuordnung muss eingerichtet sein, bevor Sie Lizenzen skalieren.
Ignorieren von Secret- und PII-Abflüssen aus dem Code. Das größte Risiko bei Coding-Agenten ist nicht fehlerhafter Code, sondern der ungewollte Abfluss von Daten. Quelldateien enthalten Zugangsdaten und Kundendaten, die Agenten an externe Modelle senden. Ohne ausgehende Guardrails riskieren Sie den Abfluss von Secrets, den Sie möglicherweise erst bei einer Sicherheitsüberprüfung bemerken.
Modellauswahl als Anwendungslogik behandeln. Wenn Modellnamen und API-Keys fest in jedes Tool und jeden Dienst einprogrammiert sind, erfordert jede Modelländerung ein Deployment. Platzieren Sie die Wahl hinter einem Gateway-Endpunkt: So wird die Modellauswahl zu einer zentralen Konfigurationsentscheidung, die einmal getroffen und überall angewendet wird.
Das „beste LLM für Coding“ ändert sich fortlaufend. Versuchen, ihm ständig hinterherzulaufen, erzeugt unnötigen Aufwand. Die nachhaltige Strategie besteht darin, nicht mehr auf ein einziges Modell zu setzen, sondern ein Portfolio zu verwalten: eine günstige, schnelle Stufe für Vervollständigungen und Bulk-Aufgaben, eine ausgewogene Stufe für die tägliche Agentenarbeit und eine Frontier-Stufe für schwere Refactorings und tiefgehendes Debugging – mit klaren Eskalationskriterien dazwischen. Die Aufteilung von Claude in Opus/Sonnet/Haiku deckt dieses Framework heute nahezu ab, und die gemeldeten Werte von GPT-6.1 und Gemini bieten Ihnen Optionen zur Eskalation und zum Vergleich, die Sie per Konfiguration einbinden können.
Erst die Schicht vor den Modellen macht dieses Portfolio beherrschbar. Routen Sie jeden Coding-Agenten über ein zentrales AI Gateway: So wird die Modellauswahl zu einem Konfigurationswert, Kosten werden pro Entwickler und Team zuordenbar, Budgets verhindern unkontrollierte Ausgaben per 429-Fehler, und Guardrails schützen die Secrets Ihres Quellcodes vor dem Abfluss an Drittanbieter. So nutzen Sie den aktuellen Stand der Technik, ohne die Kontrolle über Kosten oder Sicherheitsrisiken zu verlieren.
Steuern Sie die Modellnutzung Ihrer Coding-Agenten über ein zentrales Gateway. Buchen Sie eine Demo.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





