



November 5, 2025
|
5 min read


Blazingly fast way to build, track and deploy your models!
実験追跡(Experimentation Tracking)は、機械学習開発における非常に重要なプロセスであり、プラクティショナーが実験の進行状況を効率的に管理・追跡できるようにします。実験追跡には、モデルのパフォーマンス、ハイパーパラメータ、トレーニングデータなどのさまざまな要因を記録および監視することが含まれ、これにより機械学習モデルのパフォーマンスに関するインサイトを得ることができます。
モデルの複雑さ、大規模なデータ量、機械学習開発で使用される多様なツールやフレームワークにより、実験の管理や結果の追跡は機械学習プラクティショナーにとって困難なタスクとなり得ます。ここでは、実験管理や結果の追跡においてプラクティショナーが直面する主な課題をいくつか紹介します。
Weights & Biases (W&B) は、機械学習プラクティショナーが実験を効果的に管理および追跡できるように設計されたプラットフォームです。実験の追跡、可視化、コラボレーションのためのツールセットを提供し、堅牢でスケーラブルな機械学習モデルの開発を容易にします。
W&B プラットフォームの主な機能とメリットは以下の通りです。
実験追跡のために W&B をセットアップする手順は以下の通りです。
wandb.init() 関数を呼び出して W&B を初期化する必要があります。この関数は W&B ライブラリを初期化し、新しい Run(実行)をセットアップします。wandb.log() 関数を呼び出すことで、損失(Loss)や精度(Accuracy)などのメトリクスをログに記録できます。この関数はメトリクスの辞書を入力として受け取り、W&B ダッシュボードに記録します。wandb.config 関数を呼び出すことで、学習率(Learning Rate)やバッチサイズ(Batch Size)などのハイパーパラメータも記録できます。この関数はハイパーパラメータの辞書を入力として受け取り、W&B ダッシュボードに記録します。wandb.log() 関数を呼び出すことで、画像やプロットなどの可視化データを記録できます。W&B は、3Dビジュアライゼーション、混同行列、散布図など、多様な可視化ツールを提供しています。W&B を使用してメトリクス、モデル、ハイパーパラメータ、および可視化データを記録する例を以下に示します。
import wandb
import numpy as np
import matplotlib.pyplot as plt
import tensorflow as tf

# Step 1: Initialize W&B
wandb.init(project="my-project")

# Step 2: Log hyperparameters
config = {
    "learning_rate": 0.001,
    "batch_size": 32,
    "epochs": 10
}
wandb.config.update(config)

# Step 3: Train model and log metrics
model = tf.keras.models.Sequential([
    tf.keras.layers.Dense(10, activation='relu', input_shape=(10,)),
    tf.keras.layers.Dense(1)
])
model.compile(optimizer=tf.keras.optimizers.Adam(config['learning_rate']),
              loss=tf.keras.losses.MeanSquaredError(),
              metrics=[tf.keras.metrics.MeanAbsoluteError()])
for epoch in range(config['epochs']):
    # ... train model ...
    history = model.fit(x_train, y_train, batch_size=config['batch_size'])
    loss = history.history['loss'][-1]
    mae = history.history['mean_absolute_error'][-1]
    wandb.log({"epoch": epoch, "loss": loss, "mae": mae})

# Step 4: Log visualizations and model
x = np.linspace(0, 10, 100)
y = np.sin(x)
fig, ax = plt.subplots()
ax.plot(x, y)
wandb.log({"my_plot": wandb.Image(fig)})
wandb.save('my_model.h5')

# Step 5: Finish run
wandb.finish()
c
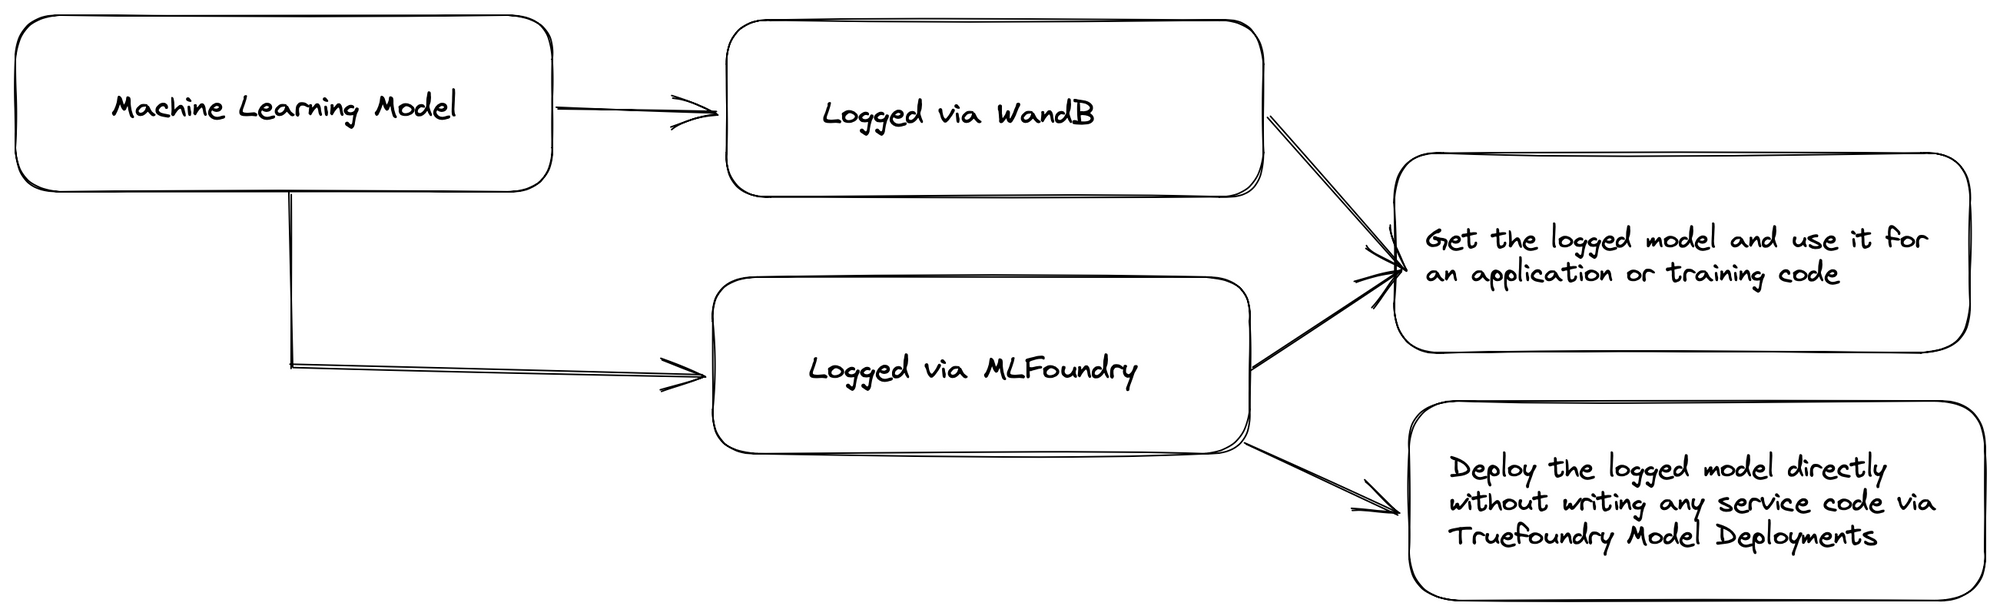
TrueFoundry は Weights & Biases Model Registry とシームレスに統合されており、TrueFoundry を使用して Weights & Biases にログ記録されたモデルを Kubernetes クラスターにデプロイできます。
📌
モデル管理や実験追跡に Weights & Biases を使用するだけでなく、TrueFoundry の実験追跡ツールである MLFoundry を使用することも可能です。
📌
以下の Colab ノートブックを使用して、下のコードを実際に試すこともできます。
Colab ノートブック
ステップ 1 - インストールとセットアップ:
pip install wandb -qU
import wandb
wandb.login()
pip install -U "servicefoundry"
sfy login
ステップ 2 - モデルのトレーニングとログ記録:
まず wandb.init() を使用してプロジェクトを初期化します。
次に、ML モデルをトレーニングして joblib ファイルとして保存します。
その後、wandb.save() を介して joblib ファイルを wandb に保存します。
import wandb
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report
import joblib

# Initialize W&B
wandb.init(project="iris-logistic-regression")

# Load and preprocess the data
X, y = load_iris(as_frame=True, return_X_y=True)
X = X.rename(columns={
        "sepal length (cm)": "sepal_length",
        "sepal width (cm)": "sepal_width",
        "petal length (cm)": "petal_length",
        "petal width (cm)": "petal_width",
})

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# Initialize the model
clf = LogisticRegression(solver="liblinear")

# Fit the model
clf.fit(X_train, y_train)

# Evaluate the model
preds = clf.predict(X_test)

# Log the model and the evaluation metrics to W&B
joblib.dump(clf, "model.joblib")
wandb.save("model.joblib")

# Finish the run
wandb.finish()
ステップ 3 - 推論アプリケーションと依存関係ファイルの作成:
truefoundry にデプロイするには、アプリケーションコードを含む app.py ファイルと、依存関係を含む requirements.txt ファイルの2つのファイルを作成する必要があります。
.
├── app.py
├── deploy.py
└── requirements.txt
c
wandb.restore() に以下の引数を渡す必要があります: <name_of_saved_file> および "username/project/run_id"wandb.restore("model.joblib", "adityajha-tfy/iris-logistic-regression/00r5xvyv")import os
import wandb
import joblib
import pandas as pd
from fastapi import FastAPI
wandb.login(key=os.environ["WANDB_API_KEY"])
# Retrieve the model from W&B
model_joblib = wandb.restore(
'model.joblib',
run_path="adityajha-tfy/iris-logistic-regression/00r5xvyy",
)
model = joblib.load(model_joblib.name)
# Load the model
app = FastAPI(root_path=os.getenv("TFY_SERVICE_ROOT_PATH"))
@app.post("/predict")
def predict(
sepal_length: float, sepal_width: float, petal_length: float, petal_width: float
):
data = dict(
sepal_length=sepal_length,
sepal_width=sepal_width,
petal_length=petal_length,
petal_width=petal_width,
)
prediction = int(model.predict(pd.DataFrame([data]))[0])
return {"prediction": prediction}
fastapi
joblib
numpy
pandas
scikit-learn
uvicorn
wandb
ステップ 4 - TrueFoundry の Python SDK を使用してデプロイを構成する
import argparse
import logging
from servicefoundry import Build, PythonBuild, Service, Resources, Port

# Setup the logger
logging.basicConfig(level=logging.INFO)

# Setup the argument parser
parser = argparse.ArgumentParser()
parser.add_argument("--workspace_fqn", required=True, type=str)
parser.add_argument("--wandb_api_key", required=True, type=str)
args = parser.parse_args()

service = Service(
    name="fastapi",
    image=Build(
        build_spec=PythonBuild(
            command="uvicorn app:app --port 8000 --host 0.0.0.0",
            requirements_path="requirements.txt",
        )
    ),
    ports=[
        Port(
            port=8000,
            host="ml-deploy-aditya-ws-8000.demo.truefoundry.com",
        )
    ],
    resources=Resources(
        cpu_request=0.25,
        cpu_limit=0.5,
        memory_request=200,
        memory_limit=400,
        ephemeral_storage_request=200,
        ephemeral_storage_limit=400,
    ),
    env={
        "WANDB_API_KEY": args.wandb_api_key
    }
)
service.deploy(workspace_fqn=args.workspace_fqn)
ステップ 5 - TrueFoundry 経由でサービスをデプロイする
以下のコマンドを実行し、ご自身の値を渡します。
python deploy.py --workspace_fqn "<Your Workspace FQN>" --wandb_api_key "<Your Wandb API Key>"
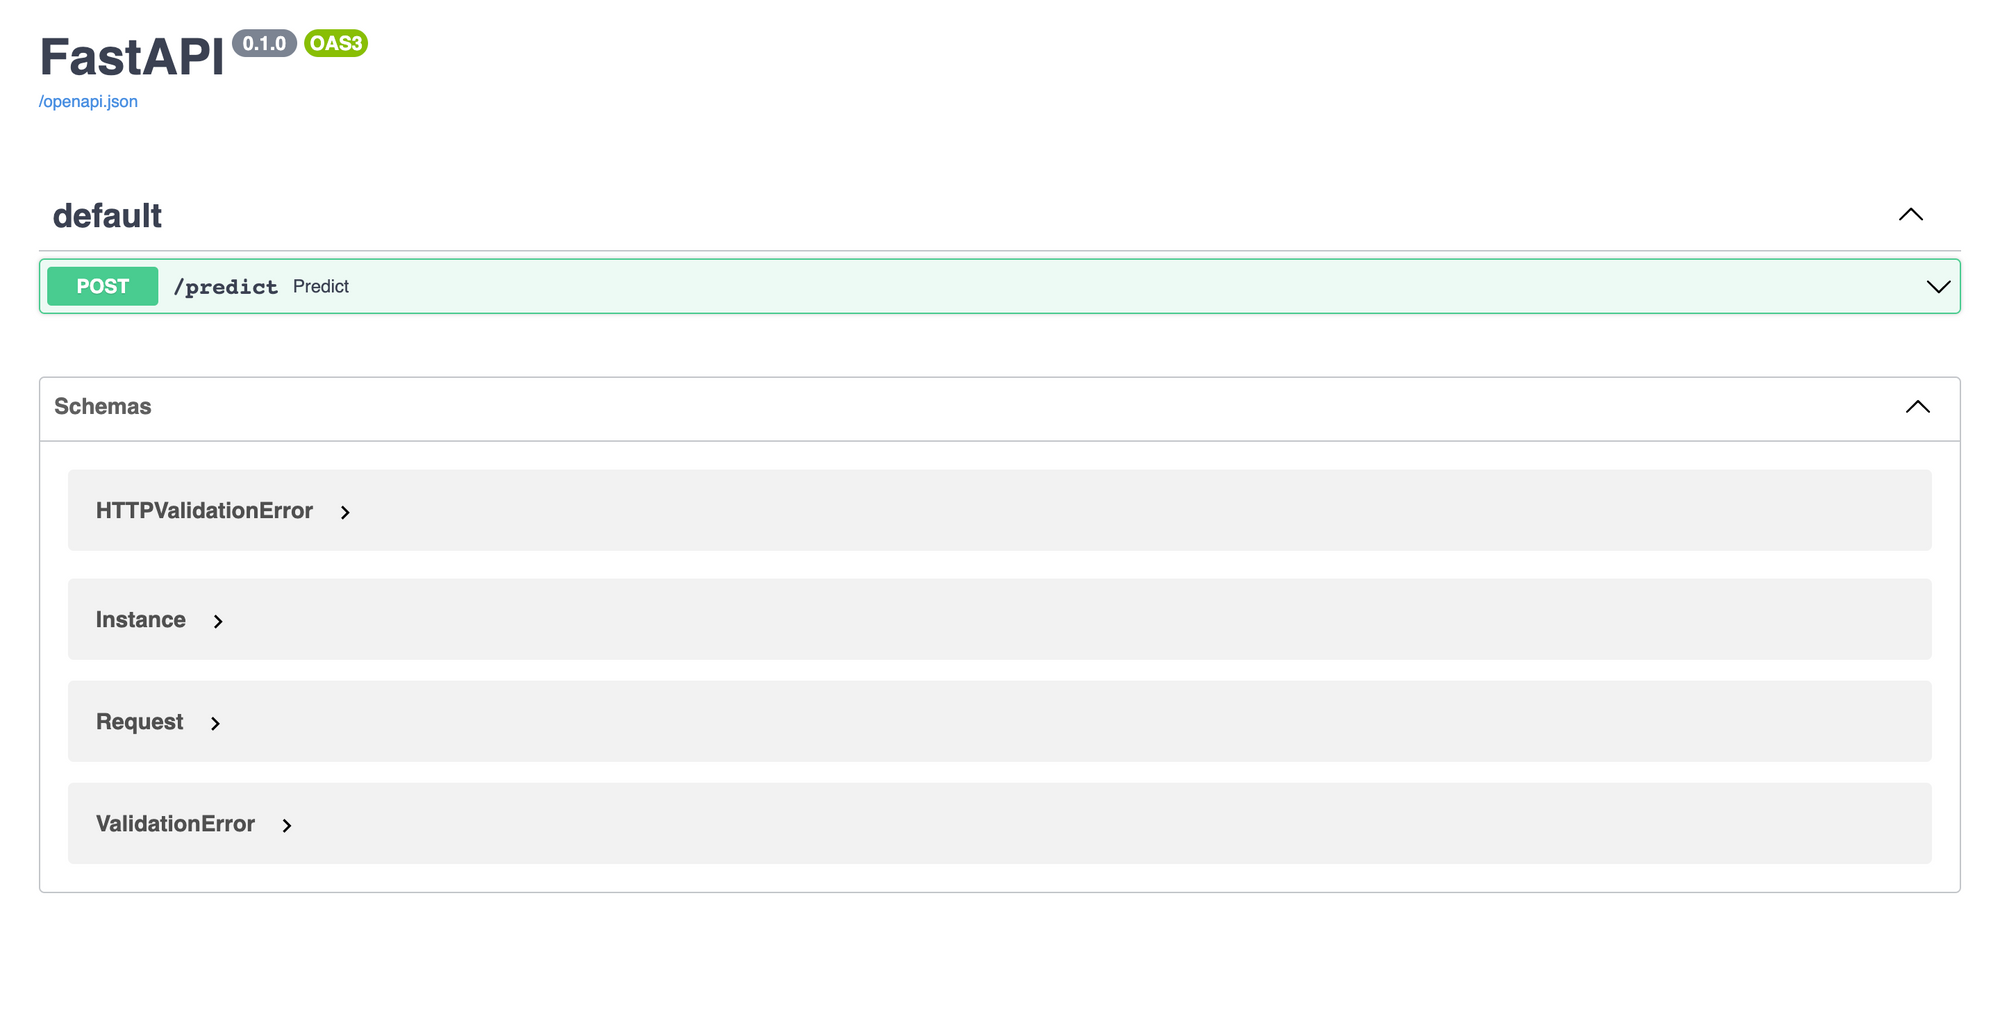
これで完了です!ログ内でデプロイされたサービスのダッシュボードを確認できます。そして右上隅に、デプロイされたアプリケーションのエンドポイントが表示されます。
TrueFoundry は、Kubernetes 上で動作する ML デプロイ PaaS であり、開発者のワークフローを高速化すると同時に、モデルのテストやデプロイにおける完全な柔軟性を提供し、インフラチームのための完全なセキュリティと管理性を確保します。当社のプラットフォームを通じて、機械学習チームはモデルを100%の信頼性と拡張性で15分以内にデプロイおよび監視できるようになり、数秒でのロールバックも可能です。これによりコストを削減し、モデルのプロダクションリリースを迅速化して、実質的なビジネス価値の実現を後押しします。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.































