



November 5, 2025
|
5 min read


Blazingly fast way to build, track and deploy your models!
Data Version Control (DVC) は、機械学習プロジェクトにおける大規模なデータセットやモデルを管理・バージョン管理するための強力なツールです。
DVCはオープンソースのツールであり、ローカルディスク、ネットワークファイルシステム、Amazon S3、Google Cloud Storageなど、広範なストレージオプションに対応しています。DVCは、TensorFlow、PyTorch、scikit-learnなどの人気のある機械学習フレームワークと組み合わせて使用できます。
データやモデルの変更を追跡するだけでなく、DVCはコード、データ、モデルなど、機械学習プロジェクトの異なるコンポーネント間の依存関係の管理にも役立ちます。これらの依存関係を記録しておくことで、DVCは機械学習実験の再現や、他者とのプロジェクト共有を容易にします。
機械学習におけるバージョン管理は、以下の理由からソフトウェアエンジニアリングと比較してより困難なタスクとなります:
DVCは、機械学習プロジェクトにおけるデータとモデルの両方をバージョン管理するためのシンプルで効率的な方法を提供することで、これらの問題を解決します。DVCを使用すると、コードだけでなくデータやモデルもバージョン管理し、それらの関係性を追跡できます。DVCを活用すれば、過去の実験を簡単に再現したり、チームメンバーと協力したり、ワークフローを自動化して開発プロセスを合理化したりできます。
DVCを開始するには、ローカルマシンにインストールしてセットアップする必要があります。このセクションでは、さまざまなクラウドストレージサービスで動作するようにDVCを構成する方法や、新しいDVCプロジェクトを作成する方法など、ステップバイステップの手順を説明します。
dvc init
これにより、現在のディレクトリに新しいDVCプロジェクトが作成されます。
dvc remote add -d <remote-name> <storage-url>
たとえば、"my-s3-remote" という名前のAmazon S3リモートを追加したい場合は、次のコマンドを実行します:
dvc remote add -d my-s3-remote s3://my-bucket-name
これにより、Amazon S3と連携するように構成された新しいリモートがDVCプロジェクトに追加されます。
dvc add <path-to-data-file>
これにより、データファイルがDVCプロジェクトに追加され、データの変更を追跡する対応するDVCファイルが作成されます。
dvc push
これにより、データまたはモデルに加えた変更がリモートストレージにプッシュされます。
DVCは、機械学習プロジェクトを管理およびバージョン管理するための便利なコマンドを多数提供しています。以下は、最もよく使用されるDVCコマンドのリストです:
dvc init:現在のディレクトリに新しいDVCプロジェクトを初期化します。dvc add <path-to-file>:DVCにファイルを追加し、ファイルの変更を追跡するための対応するDVCファイルを作成します。dvc run:DVCトラッキングを有効にしてコマンドまたはスクリプトを実行し、入力と出力がDVCによって追跡されるようにします。dvc repro:DVCで追跡されたコマンドまたはスクリプトを再現し、すべての依存関係が最新であることを確認します。dvc push:すべてのデータファイルとモデルファイルをAWS S3やGoogle Cloud Storageなどのリモートストレージにプッシュします。dvc pull:すべてのデータファイルとモデルファイルをリモートストレージからローカルマシンにプルします。dvc status:追跡対象ファイルの状態(変更、追加、削除されたかどうかなど)を表示します。dvc log:ファイルのすべてのバージョンのリストを、対応するコミットメッセージやその他のメタデータとともに表示します。DVCを使用する最も重要な利点の1つは、機械学習実験を再現できる能力です。DVCを使用すると、コード、データ、モデル間の依存関係を定義および追跡し、dvc reproコマンドを使用して以前の実験を再現できます。
ワークフローの例:
.yamlファイルを使用したsklearn irisデータセットのワークフロー例を以下に示します:
dvc initコマンドを実行して新しいDVCプロジェクトを初期化します。dataディレクトリを作成し、このディレクトリにsklearn irisデータセットをダウンロードします。dvc add data/iris.csv.yamlファイルを作成します。例:iris.yaml。このファイルには、前処理、トレーニング、モデル評価のためのコマンドが含まれます。.yamlファイル内にステップを定義します。例:stages:
preprocess:
cmd: python preprocess.py data/iris.csv data/preprocessed.csv
deps:
- data/iris.csv
outs:
- data/preprocessed.csv
train:
cmd: python train.py data/preprocessed.csv models/model.pkl
deps:
- data/preprocessed.csv
outs:
- models/model.pkl
evaluate:
cmd: python evaluate.py models/model.pkl data/iris.csv
deps:
- models/model.pkl
- data/iris.csv
dvc repro iris.yaml.yamlファイルでパイプラインを定義し、dvc reproコマンドを使用することで、実験を簡単に再現し、データとモデルのバージョンを追跡し、機械学習プロジェクトでチームメンバーと協力することができます。
以下はワークフローの例です:
dvc remote add -d s3remote s3://your-s3-bucket-name/path/to/models
dvc pull -r s3remote path/to/models/model.pkl
scp path/to/models/model.pkl user@target-remote-server:/path/to/models/
# Load the model
import pickle
with open('/path/to/models/model.pkl', 'rb') as f:
    model = pickle.load(f)

# Make predictions
X_test = [[5.1, 3.5, 1.4, 0.2], [7.7, 3.0, 6.1, 2.3], [6.0, 3.0, 4.8, 1.8]]
y_pred = model.predict(X_test)
print(y_pred)
このワークフローは、S3サーバーに必要な資格情報とエンドポイント情報が設定されており、ローカルサーバーとターゲットのリモートサーバーの両方にアクセスできることを前提としています。特定のニーズやセットアップに基づいてワークフローを変更できます。
TrueFoundryはDVC Model Registryとシームレスに統合されており、DVCにログ記録されたモデルをTrueFoundryを使用してKubernetesクラスタにデプロイできます。
📌
モデル管理や実験追跡のためにDVCを使用するだけでなく、Truefoundryの実験追跡機能であるMLFoundryを使用することもできます。
ステップ 1 - インストールとセットアップ:
# Install DVC and S3 support
pip install dvc dvc-s3

# Initialize Git in the local directory
git init

# Initilize DVC in the local directory
dvc init

# Set DVC remote storage as your bucket
dvc remote add s3://<your_bucket_name>
注: これを動作させるには、s3 cliを構成する必要があります
import dvc
x
pip install -U "servicefoundry"
sfy login
ステップ 2 - モデルのトレーニングとログ記録:
MLモデルをトレーニングし、joblibファイルとして保存します
次に、**`dvc add`**を使用してモデルと評価メトリクスを追加します
その後、**`dvc push`**経由でjoblibファイルをdvcにプッシュします
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report
import joblib
import os

# Load and preprocess the data
X, y = load_iris(as_frame=True, return_X_y=True)
X = X.rename(columns={
        "sepal length (cm)": "sepal_length",
        "sepal width (cm)": "sepal_width",
        "petal length (cm)": "petal_length",
        "petal width (cm)": "petal_width",
})

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# Initialize the model
clf = LogisticRegression(solver="liblinear")

# Fit the model
clf.fit(X_train, y_train)

# Evaluate the model
preds = clf.predict(X_test)

# Save the model using joblib and DVC
joblib.dump(clf, "model.joblib")
os.system("dvc add model.joblib")

# Log the evaluation metrics
report = classification_report(y_test, preds, output_dict=True)
with open("classification_report.txt", "w") as f:
    f.write(str(report))

# Push the model and evaluation metrics to the remote storage
os.system("dvc push")
ステップ 3 - 推論アプリケーションと依存関係ファイルの作成:
truefoundryにデプロイするには、アプリケーションコードを含むapp.pyファイルと、依存関係を含むrequirements.txtファイルの2つのファイルを作成する必要があります。
.
├── app.py
├── deploy.py
└── requirements.txt
import os
import joblib
import pandas as pd
from fastapi import FastAPI

# Retrieve the model from S3 using DVC
os.system("dvc pull model.joblib.dvc")

# Load the model
model = joblib.load("model.joblib")

# Load the model
app = FastAPI()

@app.post("/predict")
def predict(
    sepal_length: float, sepal_width: float, petal_length: float, petal_width: float
):
    data = dict(
        sepal_length=sepal_length,
        sepal_width=sepal_width,
        petal_length=petal_length,
        petal_width=petal_width,
    )
    prediction = int(model.predict(pd.DataFrame([data]))[0])
    return {"prediction": prediction}
fastapi
pandas
joblib
dvc
ステップ 4 - TrueFoundryのPython SDKの使用とデプロイの構成
import argparse
import logging
from servicefoundry import Build, PythonBuild, Service, Resources, Port

# Setup the logger
logging.basicConfig(level=logging.INFO)

# Setup the argument parser
parser = argparse.ArgumentParser()
parser.add_argument("--workspace_fqn", required=True, type=str)
args = parser.parse_args()

service = Service(
    name="fastapi",
    image=Build(
        build_spec=PythonBuild(
            command="uvicorn app:app --port 8000 --host 0.0.0.0",
            requirements_path="requirements.txt",
        )
    ),
    ports=[
        Port(
            port=8000,
            host="ml-deploy-aditya-ws-8000.demo.truefoundry.com",
        )
    ],
    resources=Resources(
        cpu_request=0.25,
        cpu_limit=0.5,
        memory_request=200,
        memory_limit=400,
        ephemeral_storage_request=200,
        ephemeral_storage_limit=400,
    ),
)
service.deploy(workspace_fqn=args.workspace_fqn)
ステップ 5 - TrueFoundry経由でサービスをデプロイする
次のコマンドを実行し、以下を指定します
python deploy.py --workspace_fqn your_workspace_fqn
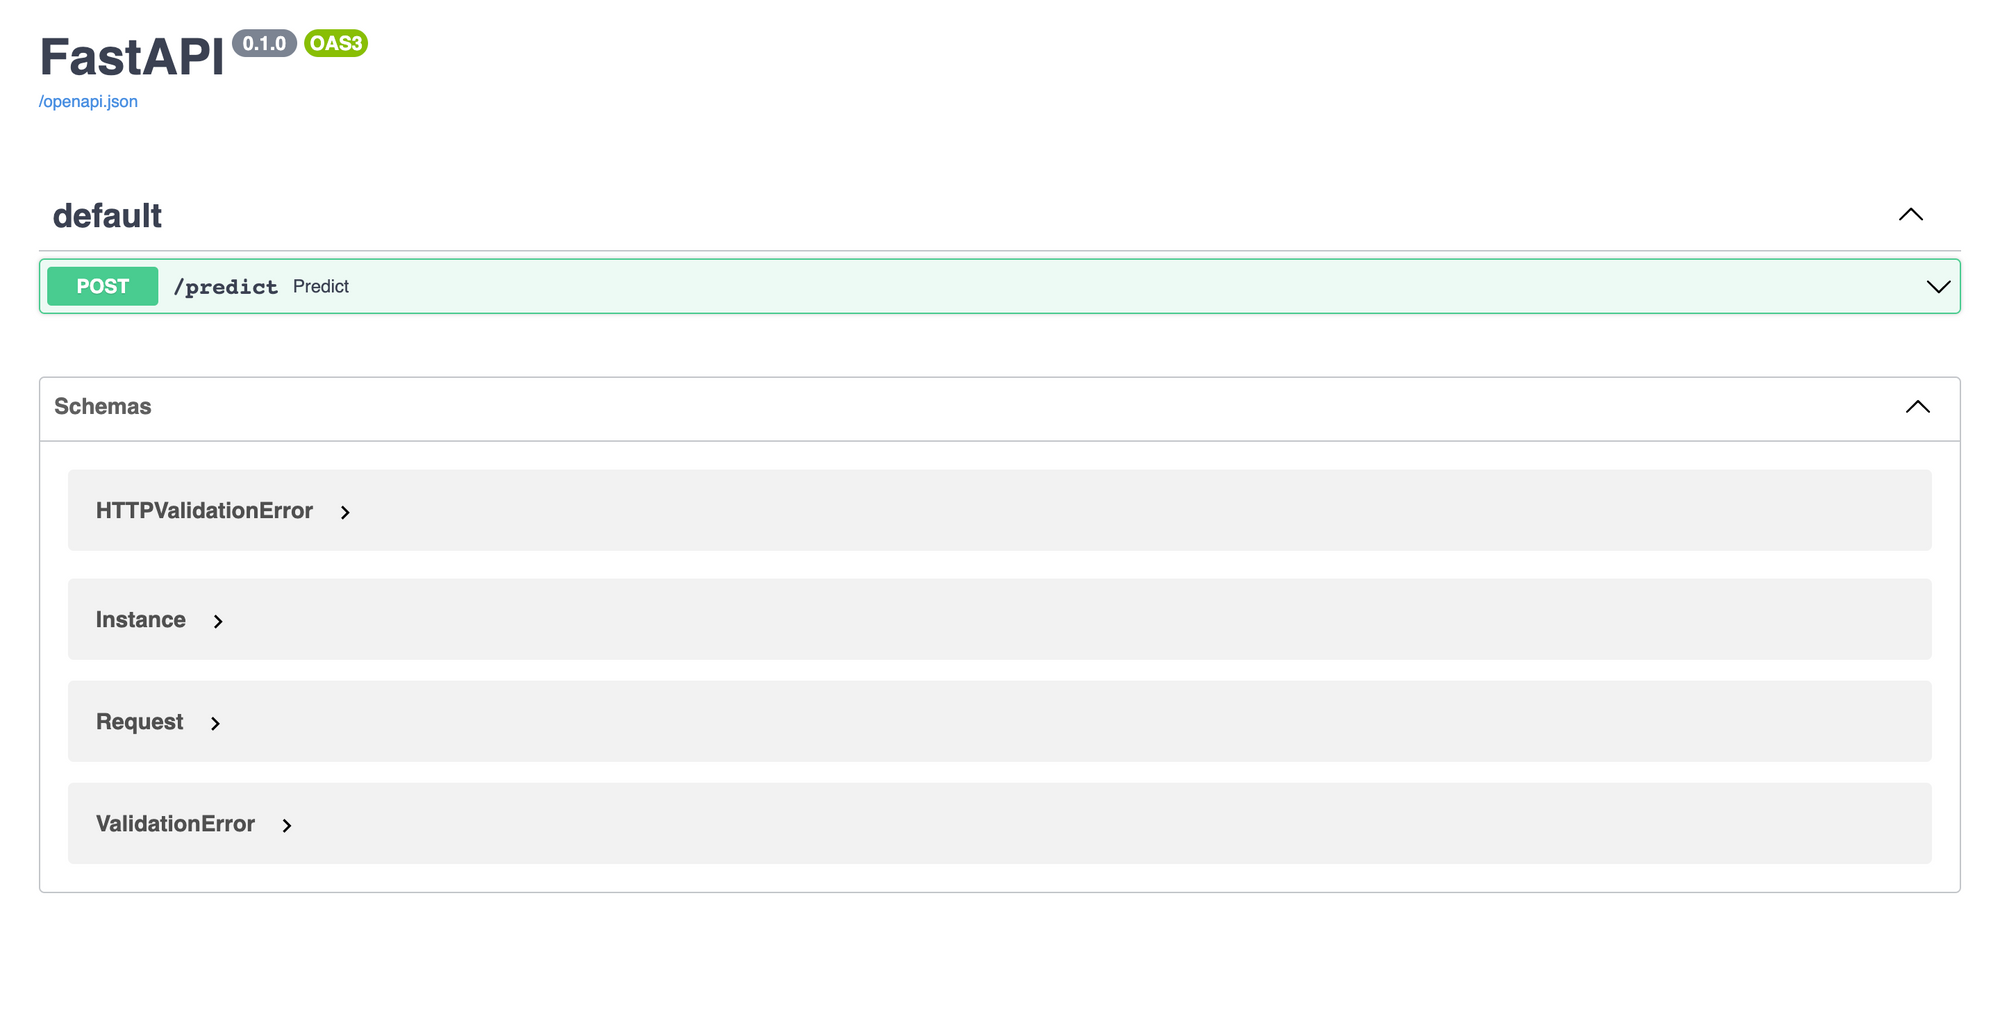
これで完了です! ログ内にデプロイされたサービスのダッシュボードが表示されます。そして右上隅にデプロイされたアプリケーションのエンドポイントが表示されます。
TrueFoundryは、Kubernetes上で動作するMLデプロイPaaSであり、インフラチームに完全なセキュリティとコントロールを確保しながら、開発者のワークフローを高速化し、モデルのテストとデプロイにおける完全な柔軟性を提供します。当社のプラットフォームを通じて、機械学習チームは100%の信頼性と拡張性を持ち、数秒でロールバック可能な環境で、15分でモデルのデプロイとモニタリングを行えるようになり、コストを削減し、モデルをより迅速に本番環境にリリースして、真のビジネス価値を実現できます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.































