


11月 20, 2026
|
5 min read

Blazingly fast way to build, track and deploy your models!
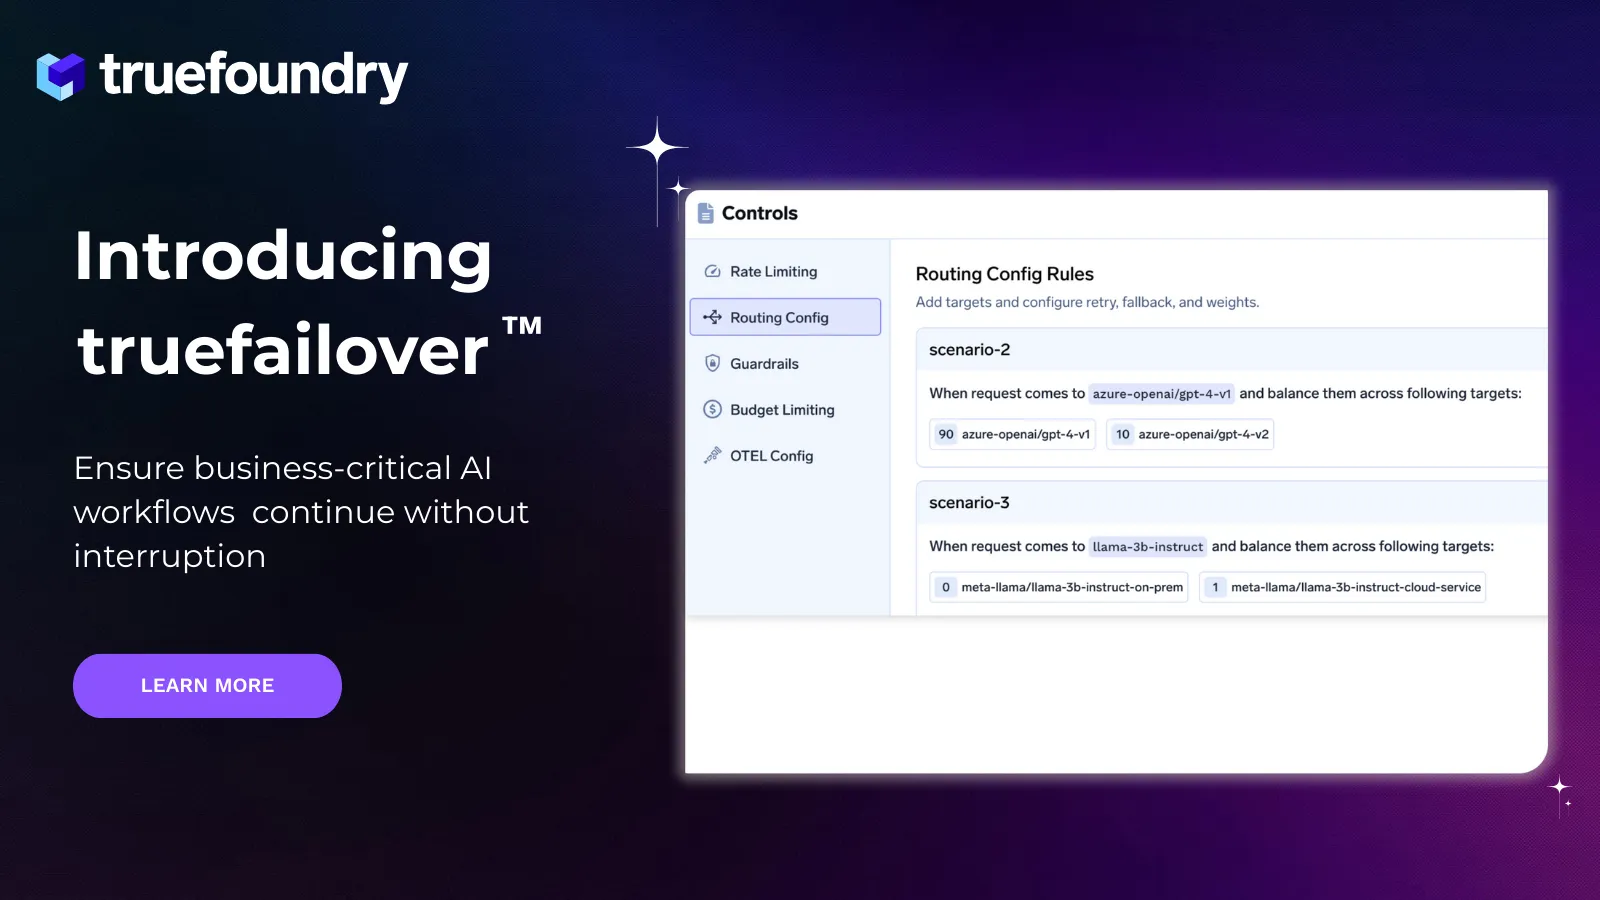
AIの停止はより頻繁に発生しており、本番システムに深刻な影響を与えています。 truefailover は、モデルの停止、リージョン障害、APIの劣化を自動的に回避してルーティングすることで、AIアプリケーションをオンライン状態に保つ、当社の新しいレジリエンス機能です。
2025年11月、Google Meetの停止により、世界中で会議、面接、顧客との通話が中断されました。 2025年10月のAWSの停止は クラウドインフラに依存する数千もの本番システムに影響を与えました。数週間後、 2025年11月のCloudflareの停止は インターネット全体に広範な不安定性をもたらしました。そして、 2026年1月、影響を与えた停止は AnthropicのClaude AI 企業内のAIを活用したワークフローを直接停止させました。
注目すべきは、これらの停止が発生したことだけではありません。それは どこで 発生したかです。これらは、最新のアプリケーションが常に利用可能であると想定している中核的な構成要素でした。本番環境でAIを運用するチームにとって、これらのインシデントは、ワークフローの停止、SLAの未達、サポートキューの滞留、そして顧客が窮地に陥るという結果につながりました。
「モデルがダウンしている」という状況はもはや許容できる障害モードではないため、私たちはtruefailoverを開発しました。
今日のほとんどのAIアプリケーションは、単一のモデル、単一のプロバイダー、または単一のリージョンに強く依存しています。その依存関係が機能しなくなったり、速度が低下したりすると、アプリケーションも同様に機能しなくなります。
これは特にリスクが高いです。なぜなら、AIの障害はめったに明確な形で現れないからです。それらはしばしば次のような形で現れます。
外からはシステムが「稼働している」ように見えますが、ユーザーはタイムアウト、一貫性のない応答、または中断されたフローを経験します。
TrueFoundryの共同創設者兼CEOであるNikunj Bajaj氏は次のように説明しています。「あまりにも多くのチームが、継続性ではなく機能性を重視してアーキテクチャを設計しています。彼らは机上では最高のモデルを選びますが、火曜日の午後3時にそれが利用できなくなった場合に何が起こるかを決して問いません。」
truefailoverは、TrueFoundry AI Gatewayに組み込まれた専用の障害復旧モジュールです。
これは、アプリケーションと、それらが依存するAIプロバイダーの間に位置し、ヘルスシグナルを継続的に監視し、リアルタイムのルーティング決定を行います。モデル、リージョン、またはプロバイダーが異常になった場合、アプリケーションチームがコードを変更したり、手動で介入したりすることなく、トラフィックは自動的に健全な代替手段に切り替えられます。
停止がインシデントになるのではなく、ルーティングイベントとして処理されます。
truefailoverの核となるのは、マルチモデル、マルチリージョン実行とヘルスアウェアルーティングの組み合わせです。
チームは、プライマリ実行パス (例えば、優先モデルやリージョン)と、1つ以上のフォールバックを定義します。truefailoverは、これらのオプション全体でレイテンシ、エラー率、その他のヘルスシグナルを継続的に評価します。許容可能なしきい値を超えて状態が悪化すると、トラフィックは自動的に再ルーティングされます。これは、エンドユーザーが障害を認識しないほど迅速に行われます。
以下の機能により、これが可能になります。
1. プロバイダーをまたいだマルチモデルフェイルオーバー
truefailoverを使用すると、OpenAI、Anthropic、Gemini、Groq、Mistralなどのプロバイダー、またはセルフホスト型モデル間でフォールバックモデルを設定できます。プライマリモデルが利用できない、レート制限されている、または性能が低下している場合、リクエストはシームレスに次の最適なオプションに流れます。
これは、顧客向けのAIにとって特に重要です。「モデルが停止しています」という応答は許容されないからです。
2. マルチリージョンおよびマルチクラウドのレジリエンス
truefailoverは、リージョンやクラウドをまたいでAIエンドポイントの実行をサポートし、ヘルスベースのルーティングにより障害が発生したゾーンからトラフィックを迂回させます。これにより、リージョン障害がグローバルに連鎖することなく隔離され、ユーザーは低遅延の応答を引き続き受け取ることができます。
3. 劣化対応ルーティング
すべての障害が完全に停止するわけではありません。truefailoverは、完全な停止だけでなく、速度低下や部分的な障害にも対応し、「技術的には稼働しているが使用できない」という、ユーザーエクスペリエンスとSLAを静かに損なうシナリオを防ぎます。
4. 組み込みの可観測性と追跡可能性
すべてのルーティング決定は可観測です。チームは、障害の発生源、トラフィックの移行方法、どのモデルが負荷を吸収したかを確認できます。これにより、インシデント分析が迅速になり、プラットフォームチームはフェイルオーバーが実際に機能したという確信を得られます。
5. キャッシングとレート保護
アップストリームの不安定性やトラフィックスパイク発生時、truefailoverは戦略的なキャッシングとレート保護を利用して、連鎖的な障害を防ぎます。これにより、システムはプロバイダーの制限や需要の急増を、突然の機能低下(ブラウンアウト)なしに乗り切ることができます。
truefailoverは、TrueFoundry AI Gatewayおよびプラットフォームのアドオンレジリエンスモジュールとして提供されます。近日中にデザインパートナー向けの早期アクセスプログラムを開始し、その後、一般提供を拡大する予定です。
早期アクセスにご興味のある方は、お問い合わせください。 こちら。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.











