



November 5, 2025
|
5 min read


Blazingly fast way to build, track and deploy your models!
前職では、EC企業向けに製品レコメンダーシステムを構築していました。つまり、私たちのAPIは顧客のウェブサイトのすべてのページでライブで動作していたのです。初めて7桁の金額規模となる大型の新規顧客を獲得した際、私たちは非常に慎重になり、当初は3月にルールベースのレコメンデーションでオンボーディングを行いました。立ち上げたばかりのMachine Learningモデルによってユーザーエクスペリエンスが損なわれるリスクを避けたかったのです。
その後4月に、Machine Learningモデルを構築し、大規模なオフラインテストと広範な手動QAを実施しました。最終的にモデルが十分なパフォーマンスを発揮するという確信を持ち、リリースを行いました。すると、2つの事象が発生しました。-
全体として、これにより多くの火消し作業が発生し、信頼性を大きく損ない、顧客を危うく失うところでした。その後の社内レトロスペクティブを通じて、#1は単なる手動の手違いであったものの、#2のような問題をオフラインで検知することはほぼ不可能であったと痛感しました。それ以来、私たちはDark Launchを行うという明るい道へと舵を切りました!
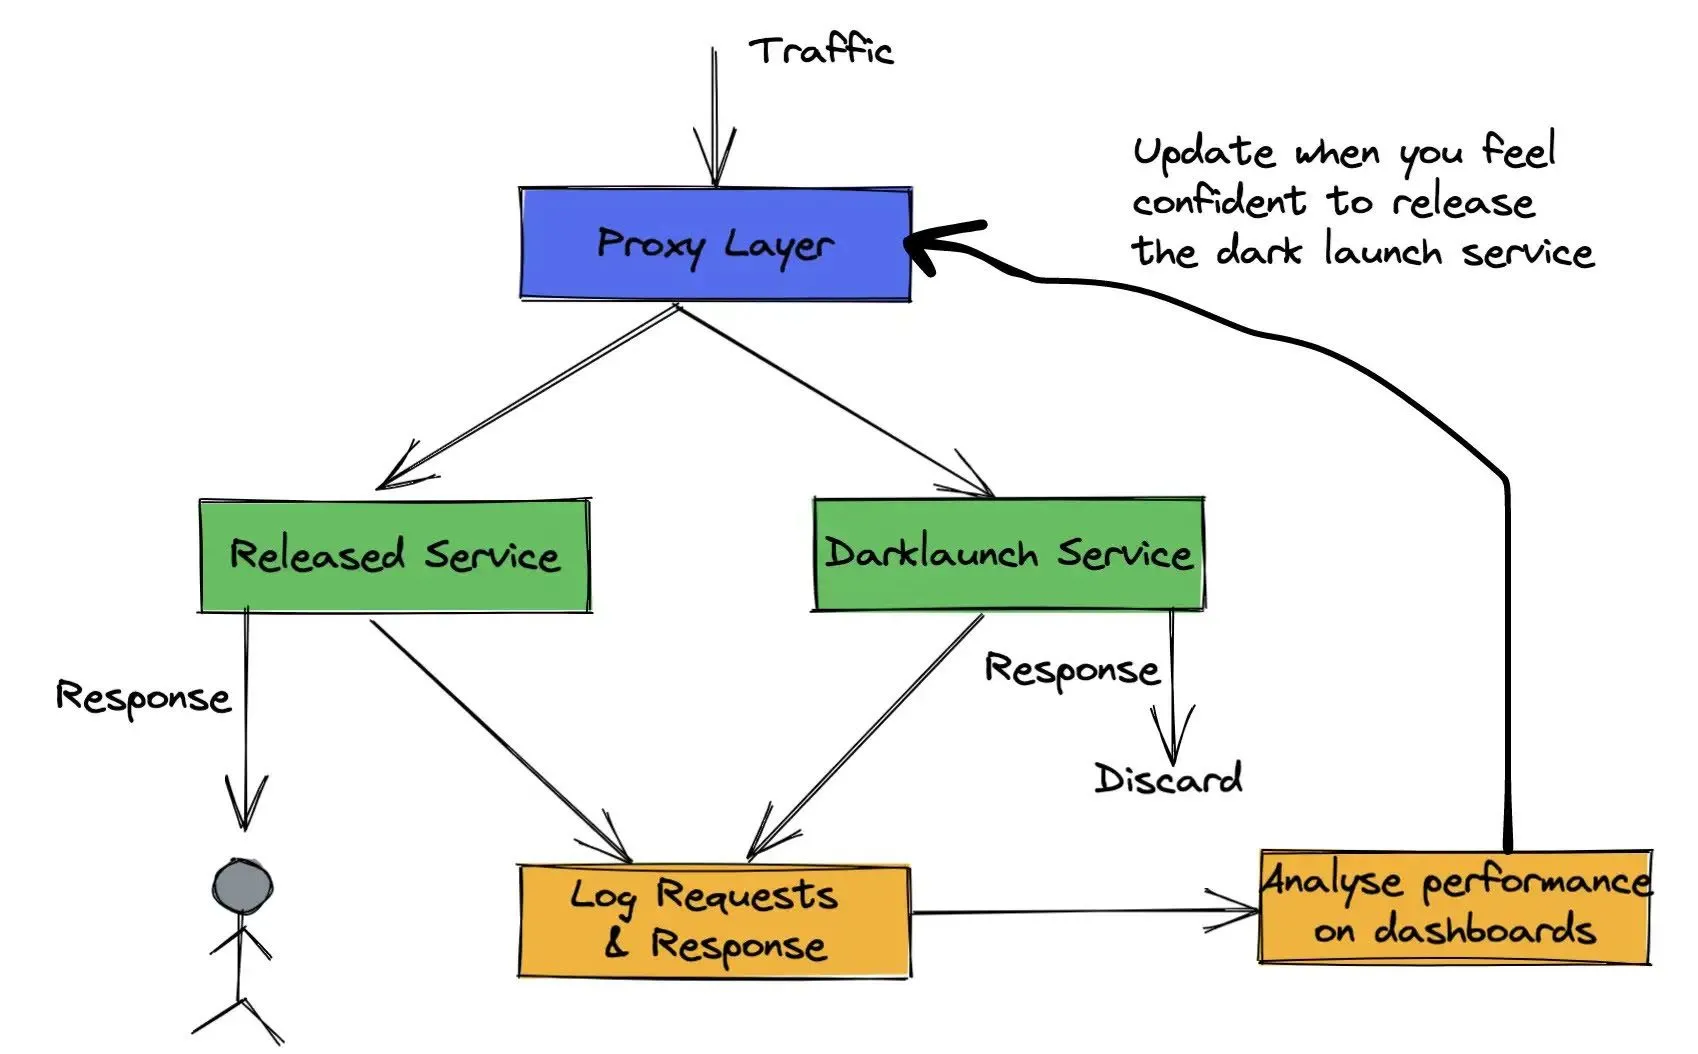
Dark Launchとは、新しくデプロイしたサービスに実際のプロダクションプラフィックをリプレイし、ユーザーに返答を返す前にそのレスポンスを破棄するデプロイメント戦略です。サービスが実際に本番稼働しているかのように振る舞いますが、ユーザーには全く影響を与えません。これにより、新しいサービスにエラーがないか、既存サービスと同等以上のパフォーマンスがあるか、そしてプロダクションの負荷に耐えられるかを確認できます。これらがすべて検証されれば、実際に新しいサービスへ段階的に切り替えることは極めて容易になります。ある意味で、
Dark Launchはサービスを立ち上げる(Launch)ための手軽(Light)な方法です。
デメリットは極めて小さく、得られる潜在的なメリットは絶大です。
サービスのDark Launchは、プロダクションと同等のシステム上でサービスやモデルをテストする現実的な方法の1つです。しかし、Dark Launchを実行するには、開発、モニタリング、インフラストラクチャの観点から、組織内に多くのセットアップと成熟度が求められます。
オフラインテストでは、通常は隔離された環境でシステムの挙動を検証できます。プロダクションのような現実的なトラフィックやネットワーク設定を含む周囲のシステムの状況を含めて、エンドツーエンドのシステムをテストできることは滅多にありません。周到なロギングと非常に複雑なオフラインテストによってこれら全体の70%を達成することは可能ですが、Dark Launch結果としてよりシンプルなシステムとなります。なぜなら、通常通りサービスを立ち上げて監視するためには、いずれにせよ上記の手順の大半を行うことになるからです。Dark Launchに成功した後は、新サービスの実際のリリースは極めて容易になるため、労力対効果の比率は十分に価値あるものになります。
実用上、これを正当化するのが難しいケースもいくつか存在します。たとえば、サービスがステートフルである場合や、実際にデータベースを変更する場合は、Dark Launchを行うことが格段に複雑になります。私個人の経験では、システムの正確性を保証することが非常に困難になるため、Dark Launchよりもオフラインテストで妥協する方がほぼ賢明です!
Dark Launchについてさらに興味がある方や、ご自身の経験を共有したい方は、ぜひ nikunj@truefoundry.com までご連絡ください!
TrueFoundry は、Kubernetes上のML Deployment PaaSであり、開発者のワークフローを高速化すると同時に、モデルのテストとデプロイにおける完全な柔軟性を提供し、インフラチームのための完全なセキュリティと管理性を確保します。当社のプラットフォームを通じて、Machine Learningチームは100%の信頼性、スケーラビリティ、数秒でのロールバック機能を備えたモデルを15分でデプロイおよび監視できるようになり、コスト削減と本番環境へのモデルリリースの高速化を実現し、真のビジネス価値の還元を可能にします。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.































