8月 31, 2026
|
5 min read


Updated: 11月 20, 2026
Published: 7月 2, 2026
Blazingly fast way to build, track and deploy your models!
VS Code と AI を使用してコーディングを行う場合、Cline は最適な選択肢です。TrueFoundry の AI Gateway 経由で Cline を実行することで、エディタ内でのコーディング体験を維持しながら、エンタープライズグレードのガードレール、オブザーバビリティ、コスト管理機能を追加できます。このガイドでは、Cline の概要、Gateway 経由でルーティングするメリット、および数分で完了する設定手順について解説します。
Cline はエディタ内で動作し、自然な対話を通じてファイルの書き込み、コードの修正、デバッグを支援します。リポジトリのコンテキストを理解し、VS Code から直接アクションを実行できるチームメイトのような存在であり、軽微な変更から大規模なリファクタリングまで幅広く活用できます。
Cline を TrueFoundry AI Gateway 経由でルーティングすることで、チームはアクセス権とキーを一元管理できるようになります。各個人の PC やスクリプトにプロバイダーの生キーを配布する代わりに、Cline に 1 つの TrueFoundry API キーとベース URL を指定するだけで、Gateway がバックグラウンドでモデルプロバイダーの資格情報を処理します。これにより、全開発者の設定を止めることなく、必要に応じてトークンのローテーションや失効を容易に行うことができます。
また、Gateway は意図した予算内での利用を徹底させるのに役立ちます。ユーザー、チーム、アプリ、モデルごとにハード予算を設定できるため、制限を超えると自動的に利用が停止し、無限ループや予期せぬ大量利用による高額請求を防ぎます。予算設定に加えて、レート制限を適用してトラフィックの健全性を維持し、チーム間での公平な利用を確保しながら、バックエンドの処理能力を保護することができます。
運用面での可視性も向上します。ダッシュボードを使用してレイテンシ、トークン使用量、コスト、エラー、トリガーされたルールを監視でき、これらのデータをモデル、ユーザー、チーム、カスタムラベルごとに分類できます。トレースが必要な場合は、ヘッダーを使用してオンデマンドでリクエストログを有効にし、不要な場合はログ収集をオフにしておくことができます。さらに、すべての呼び出しにプロジェクト、環境、テナント、機能などのメタデータをタグ付けし、それらのタグを使用してフィルタリングやグラフ化を行ったり、その次元で予算やレート制限のスコープを設定したりできます。
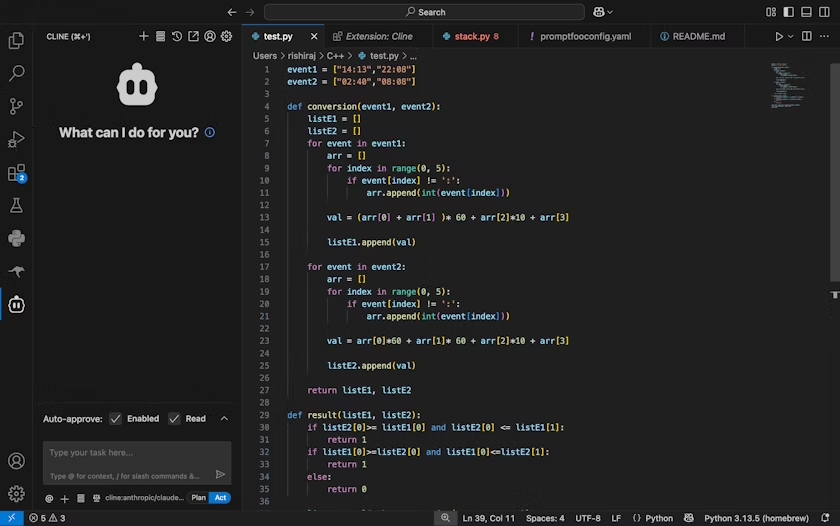
Cline がインストールされた VS Code を開いて開始します。Cmd/Ctrl + Shift + P を使用してコマンドパレットを開き、「Cline: Open in new tab」を実行します。Cline が開いたら、Cline タブ内のギア(設定)アイコンをクリックして設定を開きます。
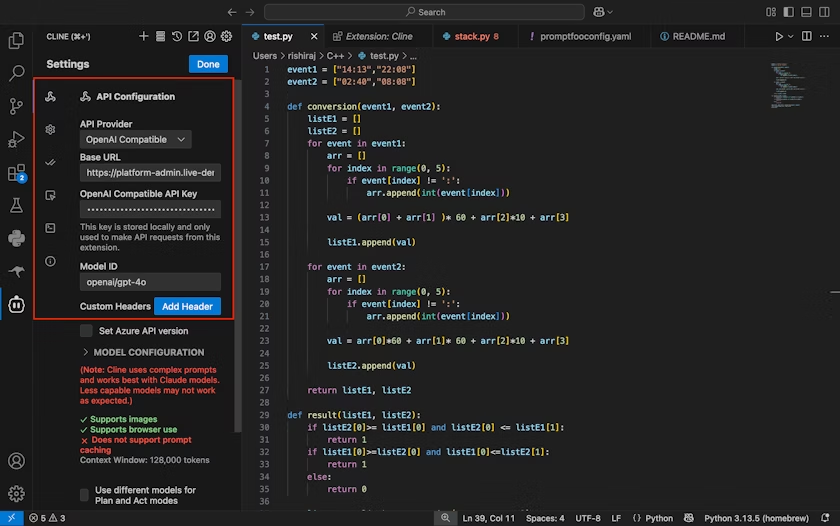
Cline の API 設定で、API provider を OpenAI Compatible に設定します。次に、TrueFoundry Gateway Base URL を入力し、TrueFoundry API キー を貼り付け、openai-main/gpt-4o などの Gateway 経由で公開されている Model ID または設定済みの他のルーティングモデルを選択します。設定を保存すると、これ以降 Cline は選択したモデルを使用して Gateway 経由でリクエストを送信するようになります。
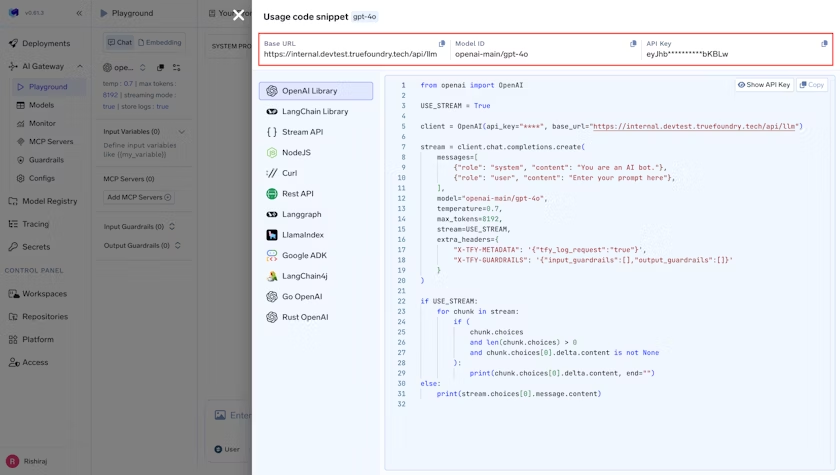
エディタの外で接続性を事前確認したい場合は、短いスクリプトでテストすることも可能です。OpenAI 互換クライアントは、ベース URL を設定し TrueFoundry キーを使用することで、他の OpenAI 互換エンドポイントと同様に Gateway と通信できます。
すべてが正常に動作しているか確認する簡単な方法は、「作成、修正、説明、デバッグ」のプロンプトを組み合わせて試すことです。たとえば、Cline に最初の N 個のフィボナッチ数を生成する Python 関数を作成させ、次に入力バリデーションとエラーハンドリングを追加させ、最後に関数の処理内容をわかりやすい言葉で説明させます。デバッグフローをテストしたい場合は、ファイルを渡して発生している ValueError を説明し、問題の修正を依頼します。
チーム全体に展開する場合は、まず適切な種類のキーを選択することから始めます。Personal Access Tokens は個人の開発者に適しており、Virtual Access Tokens は特定個人に紐づかず管理者によってスコープ設定や無効化ができるため、共有ツールやアプリケーションに適しています。キーの整理が完了したら、特定のユーザーやツールによる過剰な支出を防ぐために予算を設定します。制限は日次または月次で設定でき、ユーザー、チーム、仮想アカウント、モデル、またはその組み合わせに適用できます。条件に一致するルールが制限を超えると、呼び出しはブロックされます。
予算の次は、バックエンドを保護し公平な利用を徹底するためにレート制限を追加します。トークン数またはリクエスト数で制限でき、分、時間、日単位で制限を適用できます。ルールはユーザー、チーム、仮想アカウント、モデル、さらには環境やプロジェクトなどのメタデータによって照合できます。チームがビジネスコンテキストに基づいて利用状況を追跡している場合は、X-TFY-METADATA を使用して顧客、プロジェクト、環境、機能などの文字列値を送信するリクエストタグ付けを習慣化してください。これらのタグは、ダッシュボードのフィルタリングだけでなく、予算やレート制限のスコープ設定にも役立ちます。
ログ収集は目的に応じて設定する必要があります。X-TFY-LOGGING-CONFIG ヘッダーを使用してリクエストごとにログ収集を切り替えることができ、セルフホストの Gateway デプロイメントでは、常にログを記録するかまったく記録しないかのグローバルモードを設定することもできます。トレースを確認する必要がある場合は、Gateway UI の Monitor セクションからログを表示できます。
設定は以上です。これで Cline は指定されたモデルを使用して Gateway 経由でリクエストを送信します。
ヒント: 短いスクリプトでテストしたい場合、アクセス制御ガイドに示されているように、ベース URL と TrueFoundry キーを設定することで OpenAI クライアントから Gateway に通信できます。
Cline のトラフィックが Gateway を通過するようになると、Metrics Dashboard を使用してレイテンシ、Time to First Token、トークン間レイテンシ、トークン数、コスト、エラーコードを追跡できるようになります。モデルごとにグループ化することでプロバイダー間のパフォーマンスと安定性を比較でき、ユーザーやチームごとにグループ化することで利用パターンを把握しやすくなります。メタデータでグループ化すると、テナントや機能固有の動作を追跡でき、より詳細な分析が必要な場合はメトリクスを CSV にエクスポートできます。
Cline を使用することで、エディタ内で高速かつ自律的なコーディング支援が得られます。Gateway を導入することで、モデルアクセス、支出、セキュリティを制御できるほか、ログ、アナリティクス、一貫したメタデータによる透明性が確保されます。この組み合わせにより、ガバナンスを損なうことなく、チーム全体で AI 支援によるコーディングを安全にスケールさせることができます。
Cline はリポジトリ内で直接アクションを実行できるため、コーディングの負担を軽減します。TrueFoundry AI Gateway は、その強力な機能を組織全体に安全に展開することを可能にします。ベース URL を設定し、モデルを選択し、キーを追加すれば、すぐにコーディングを開始できます。導入が進むにつれて、予算、レート制限、ログ制御、メタデータを段階的に追加することで、管理体制を維持したまま開発速度を高く保つことができます。
| 評価基準 | 評価すべき項目 | 優先度 | TrueFoundry |
|---|---|---|---|
| レイテンシ | Time-to-First-Token のオーバーヘッドは p95 で 10ms 未満か? | 必須(Must Have) | ✅ 対応済み |
| データレジデンシー | ログを指定地域(EU/US など)内に保持できるか? | ユースケースによる | ✅ 対応済み |
| レイテンシベースのルーティング | リアルタイムのレイテンシや障害に基づいて自動的に迂回ルーティングされるか? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効が可能か? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効が可能か? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効が可能か? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効が可能か? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効が可能か? | 必須(Must Have) | ✅ 対応済み |
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.