August 26, 2026
|
5 min read

Blazingly fast way to build, track and deploy your models!
Claude Opus 5.5、GPT-6 Sol、GPT-6 LunaがTrueFoundry AI Gatewayで利用可能に
火曜日は、LLMトラフィックの運用に携わるすべての人にとって忙しい一日となりました。AnthropicがClaude Opus 5.5をリリースし、その数分後にOpenAIがGPT-6 Astraのより低価格な兄弟モデルであるGPT-6 SolとGPT-6 Lunaを公開しました。
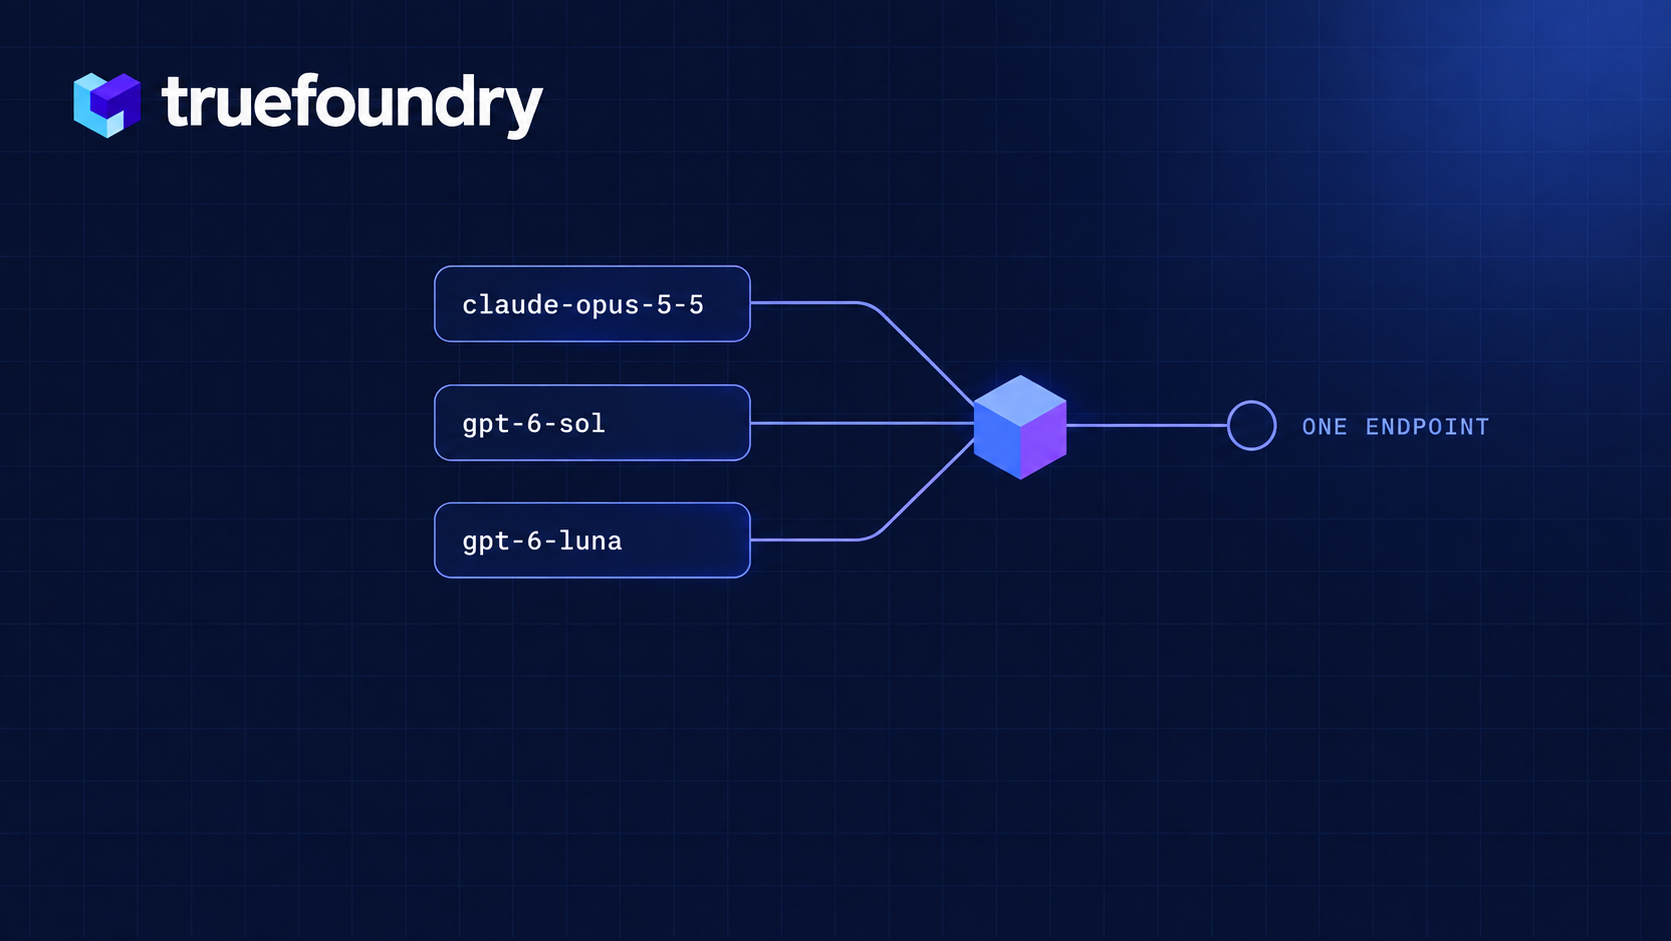
これら3つのモデルはすべてTrueFoundry AI Gatewayのモデルカタログに追加されており、価格設定、コンテキスト制限、機能がすでに反映されています。他のすべてのモデルで使用しているものと同じOpenAI互換のエンドポイントから呼び出すことができます。新しいSDKも、個別の統合も、Gatewayの更新リリースを待つ必要もありません。モデル文字列を変更するだけで、新しいモデルを利用できます。
TrueFoundry AI Gatewayでお試しください →
Anthropicの主張によると、Opus 5.5はほとんどのタスクにおいてClaude Fable 5.1と同等のパフォーマンスをOpus価格で発揮します。本番環境の予算に関わる重要なポイントは以下の通りです:
SolとLunaは、GPT-6 Astra(9月3日に10ドル / 50ドルで登場)と同じ手法でトレーニングされた後、コストの最適化が行われました。OpenAIは、Solを継続的なコーディングやエージェントタスク向け、Lunaを抽出や要約などの大ボリュームで定型的なジョブ向けとして提供しています。
9月に登場したモデルを並べて比較してみると、その価格差は無視できません。入力100万トークンあたりLunaが0.10ドル、Solが2ドル、Opus 5.5が4ドル、Astraが10ドルとなっています。2つのベンダー、2つの異なるネイティブAPIにまたがり、最も安い選択肢と最も高い選択肢の間に100倍の開きがあります。
この価格差こそが、1つのデフォルトモデルを選んですべてのトラフィックを送信すべきではない最大の理由です。本番環境のトラフィックの大半は、多くの容易なリクエストと少数の難解なリクエストで構成されています。容易なリクエストの大半をLunaに送り、難解なリクエストをOpus 5.5に送ることで、すべてのリクエストをOpusに送信する場合とは全く異なる総合コストを実現できます。これが機能するのは、モデルの切り替えがコードの変更ではなく設定の変更で済む場合に限られ、それこそがAI Gatewayの果たすべき役割です。
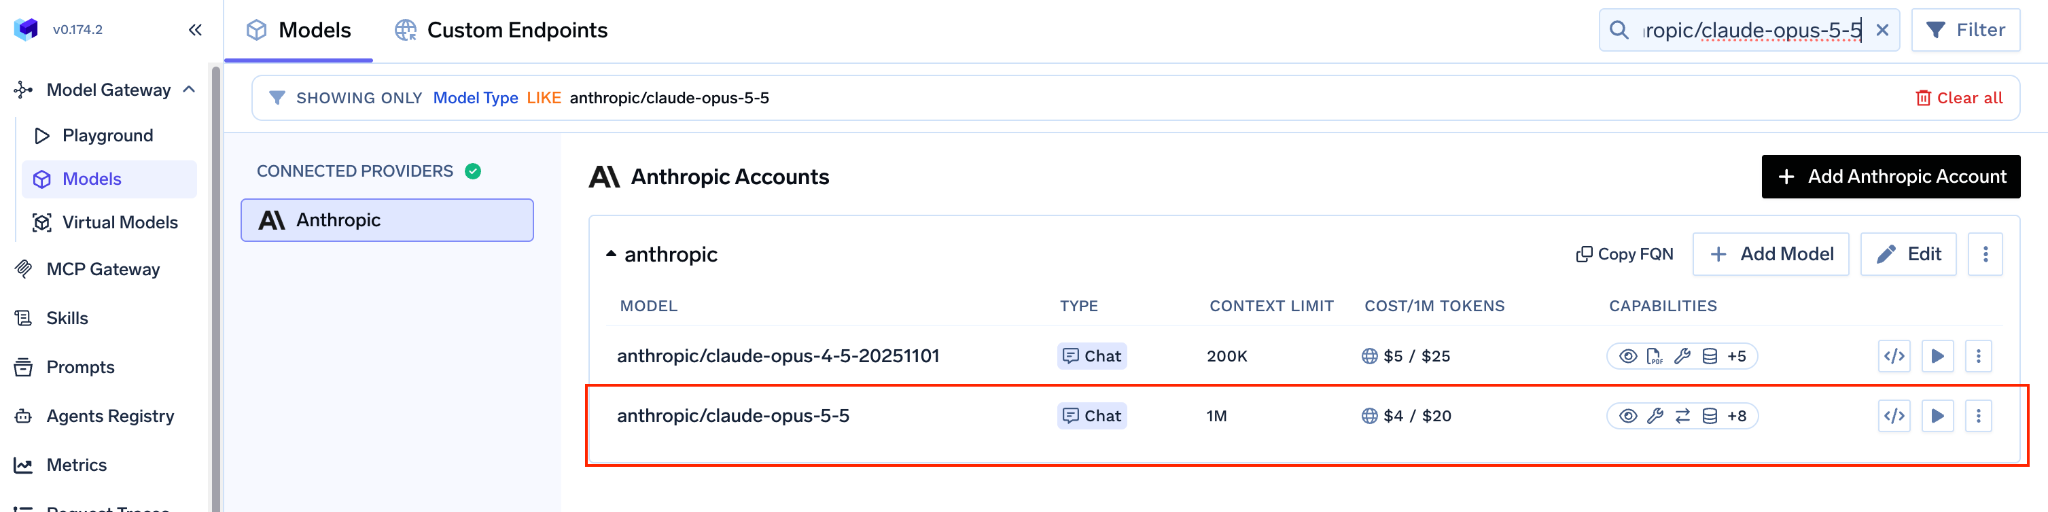
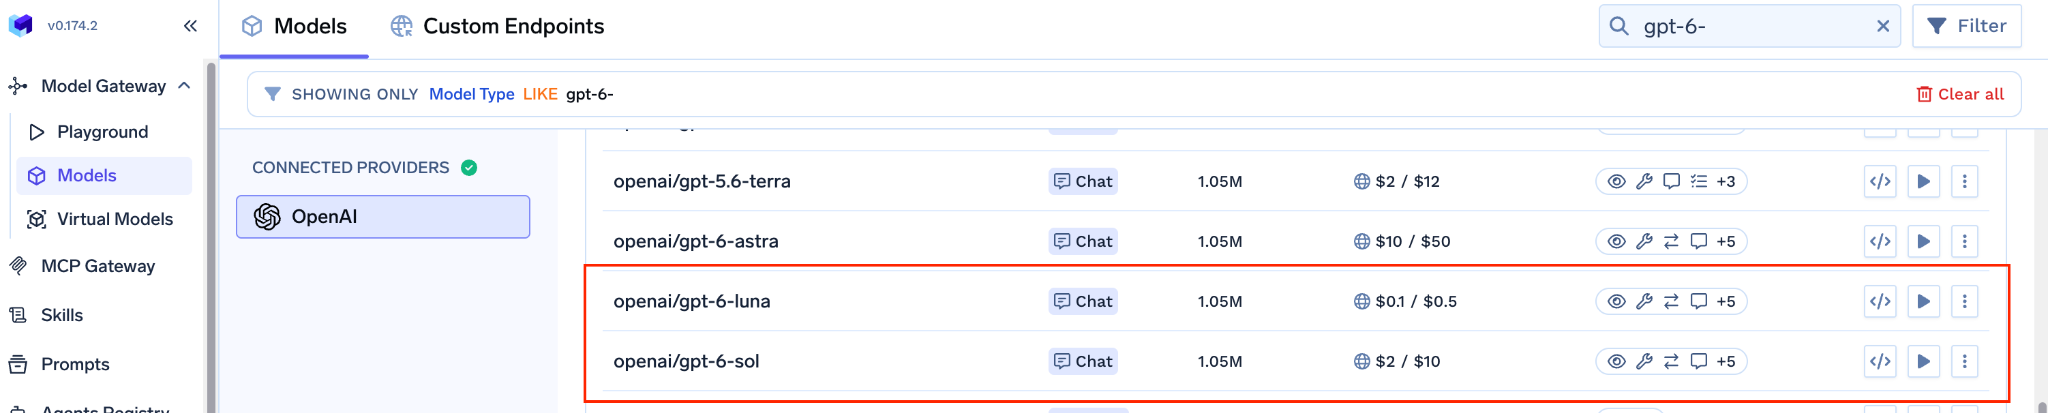
Gatewayで、Models → プロバイダーのアカウント(Anthropicアカウントなど) → Models Selectionを開き、claude-opus-5-5を検索してチェックを入れます。価格はカタログから直接取得されるため、画面上にインライン表示されます(100万トークンあたり入力4ドル / 出力20ドル)。次に、最先端モデル(Frontier Model)の利用範囲が初日から適切なチームやVirtual Keyに制限されるよう、Access Controlを設定します。
OpenAIアカウントでも同様の手順でgpt-6-solとgpt-6-lunaを設定します。
クラウド経由でこれらのモデルを実行する場合でも、カタログはそれらのルートをカバーしています:
リストにモデルがまだ表示されない場合は、リスト下部の + Add Model から手動で追加できます。GatewayはAnthropicおよびOpenAIが公開しているすべてのテキストモデルをサポートしています。
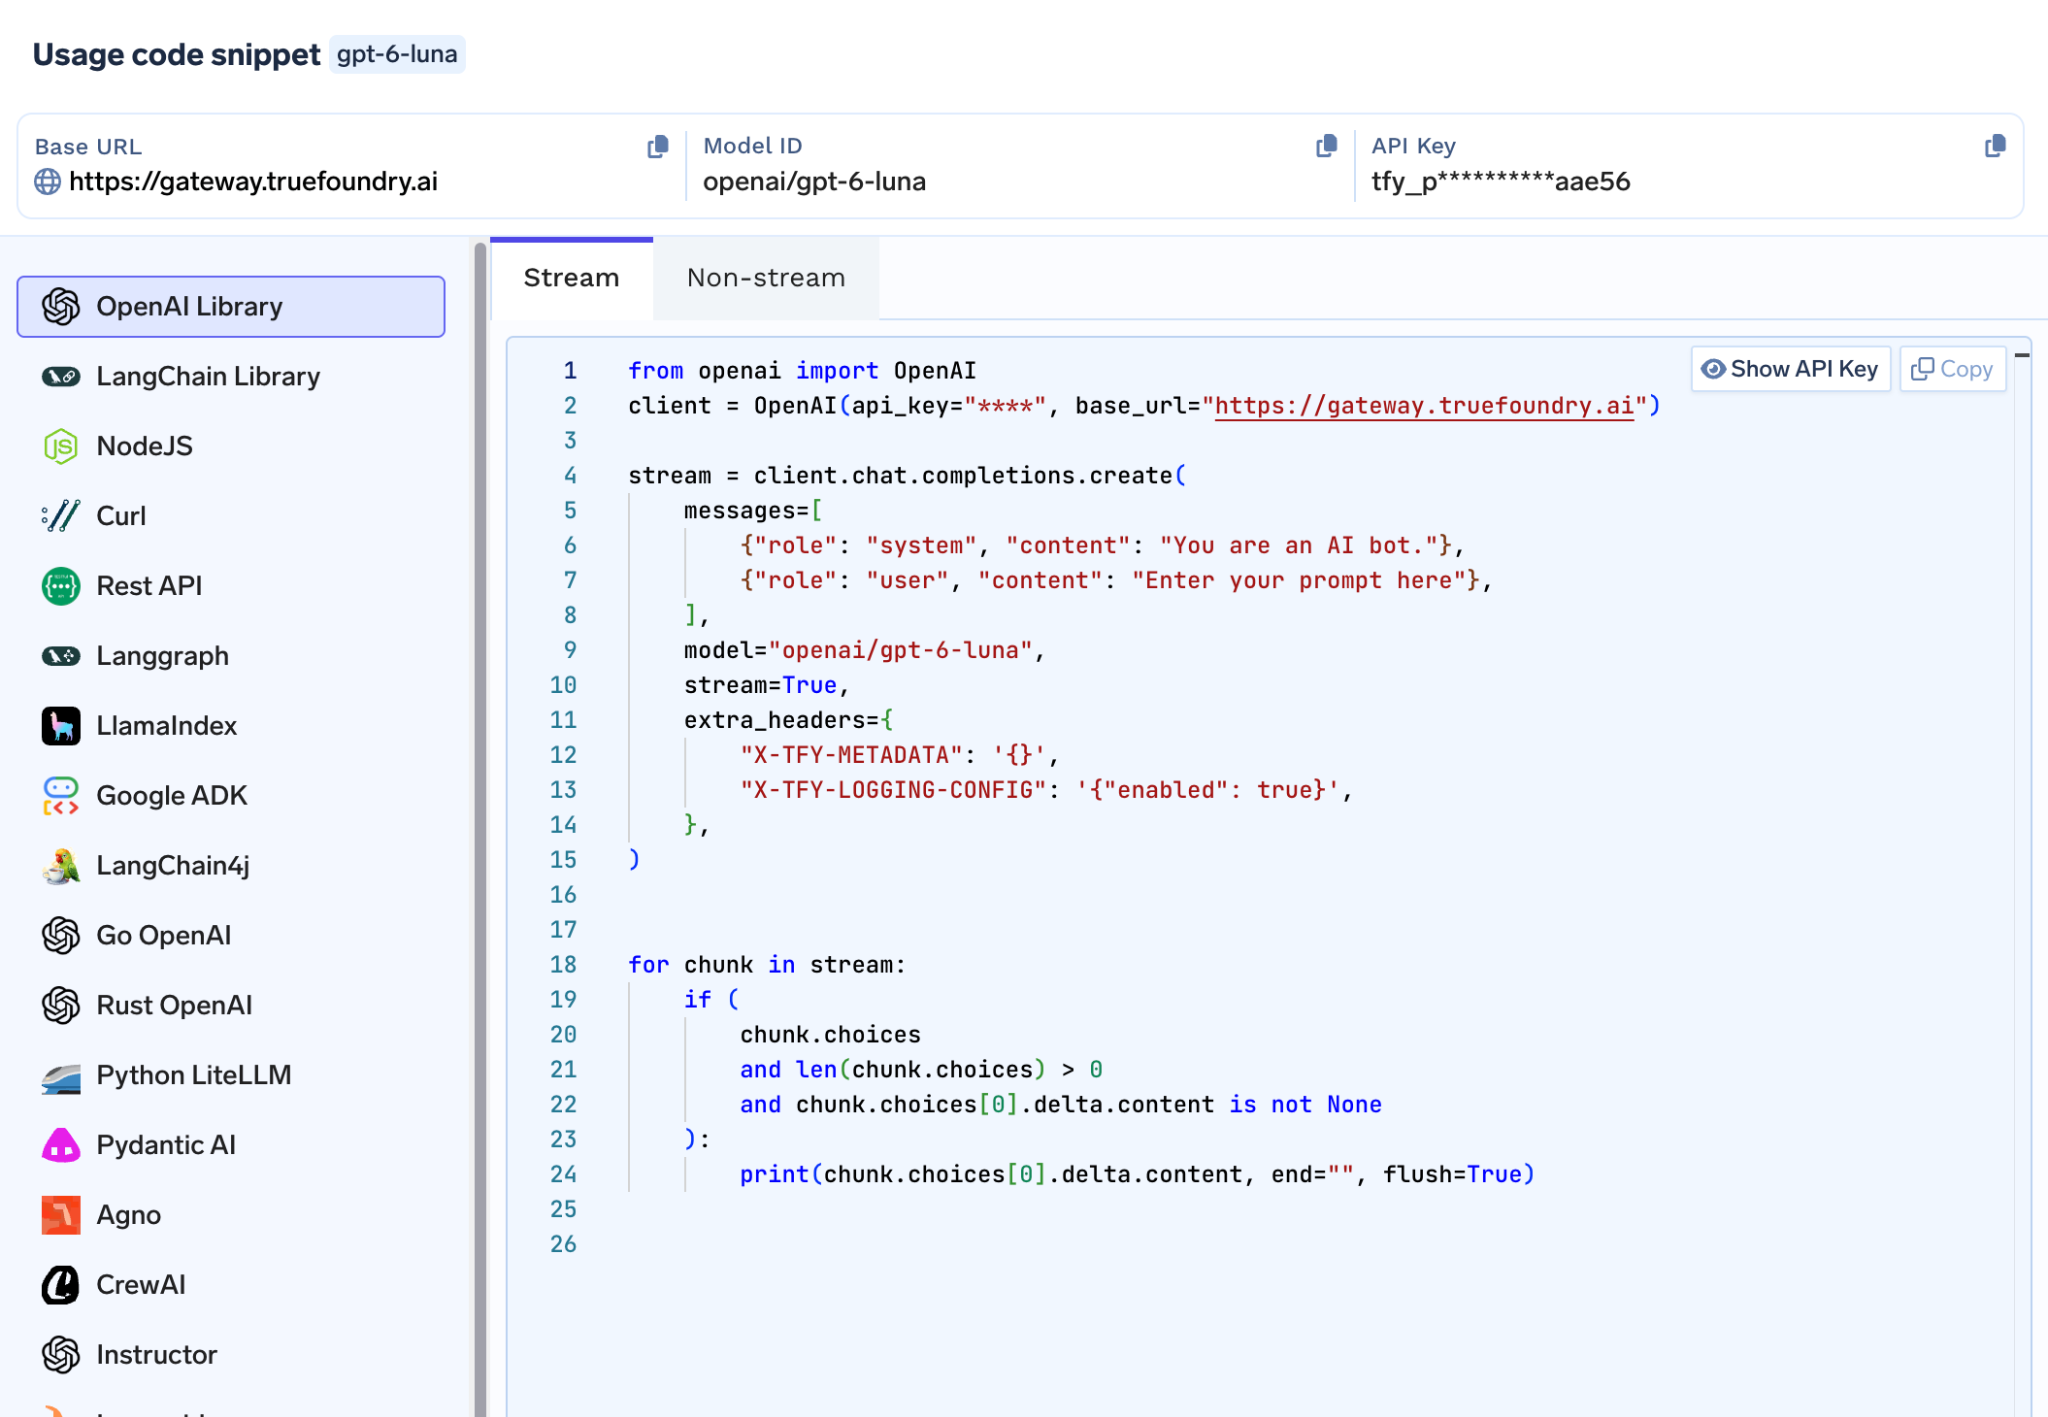
Playgroundを開き、モデルを選択して、お使いのSDK(OpenAI SDK、LangChain、Node.js、cURLなど)向けに生成されたコードスニペットをコピーします。以下はOpenAI Python版の例です:
モデルIDは<プロバイダーアカウント>/<モデル名>のように名前空間で区切られているため、anthropic-prod/claude-opus-5-5とopenai-prod/gpt-6-lunaは1行の変更で簡単に相互切り替えが可能です。X-TFY-METADATAヘッダーは各呼び出しをタグ付けするため、メトリクスビューでチーム別や機能別の支出を確認できます。
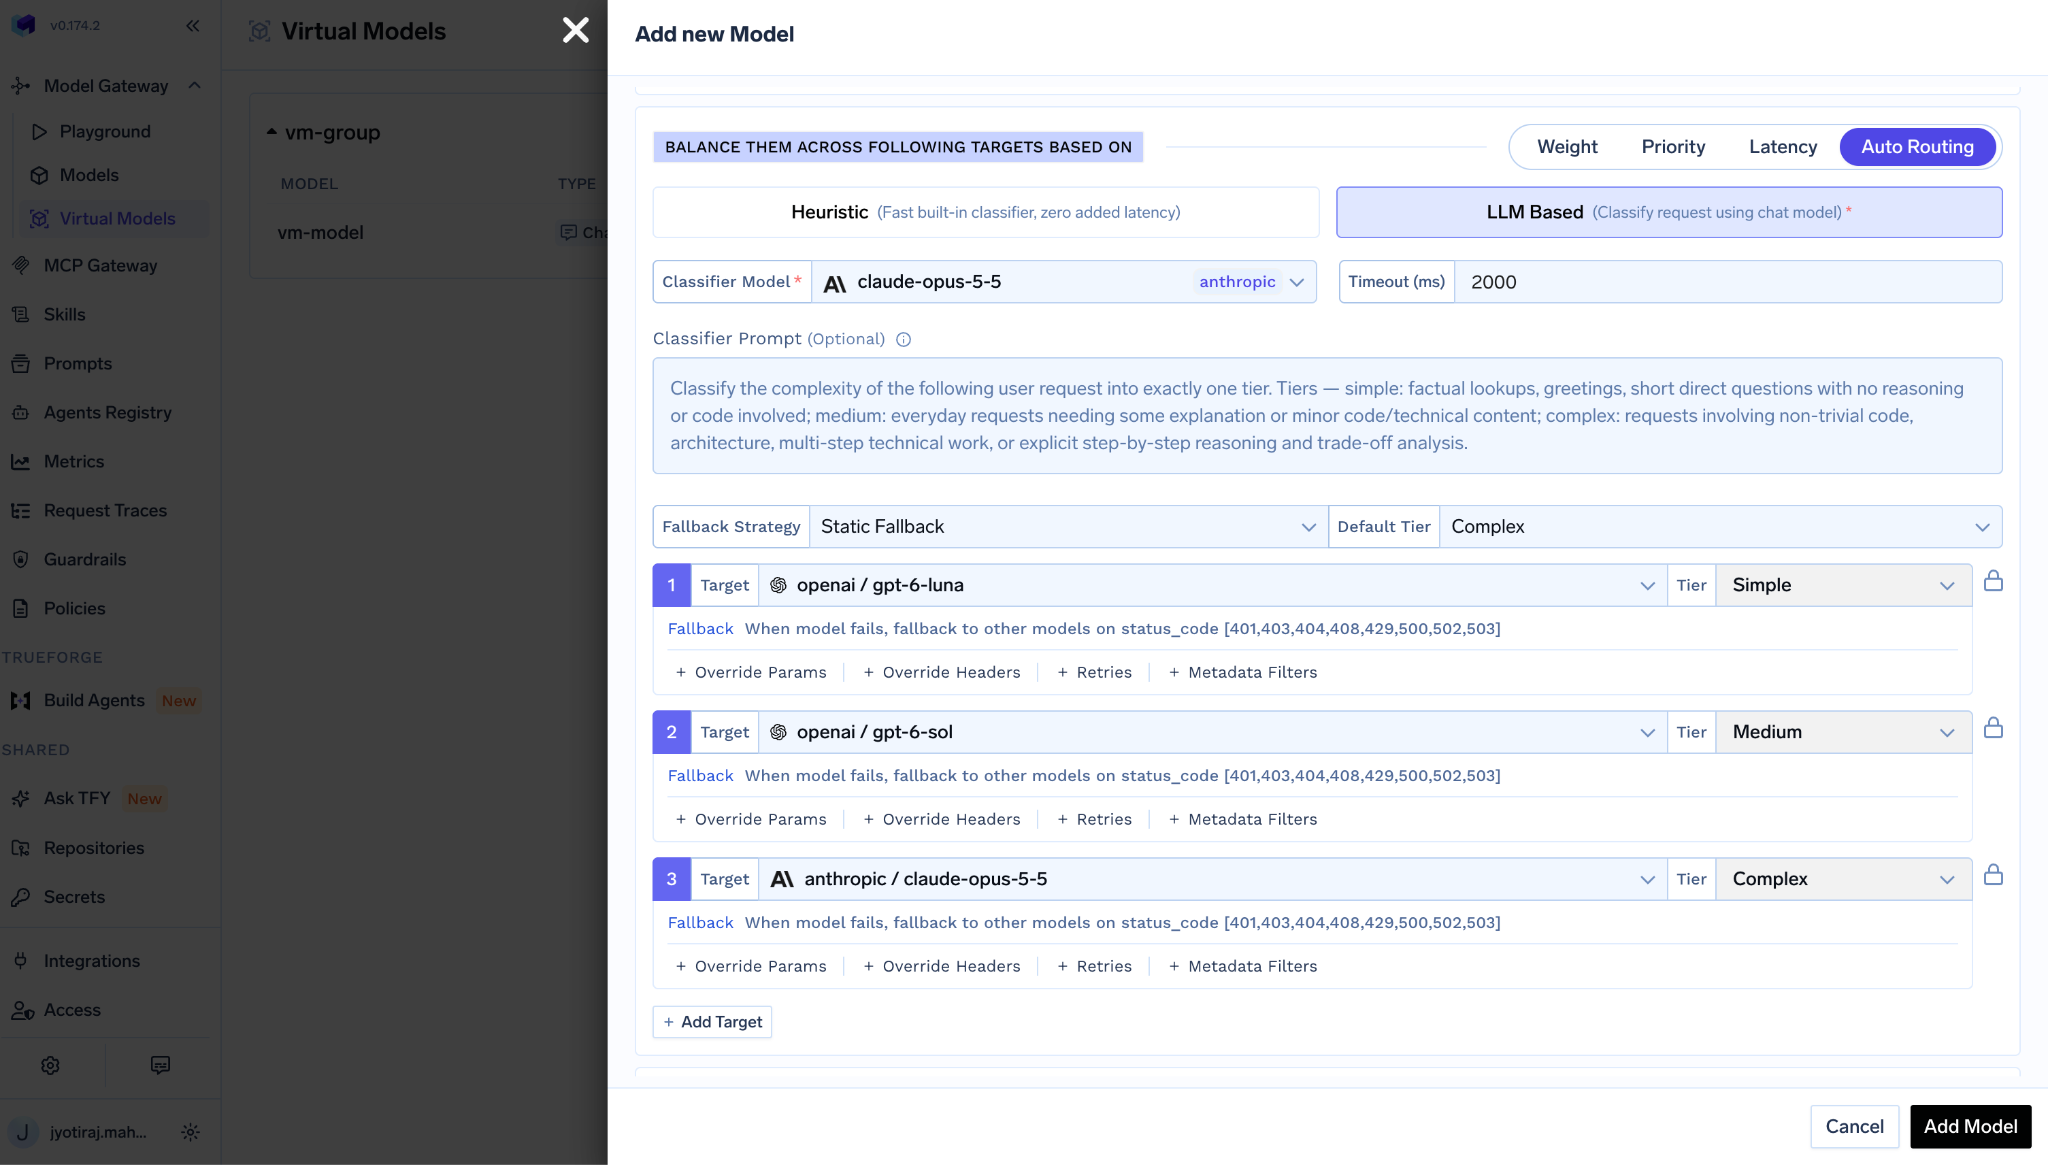
Virtual Modelを作成し、Auto Routingを選択します。Gatewayは各リクエストを「シンプル」「ミディアム」「コンプレックス」のいずれかに自動分類し、それぞれの階層に割り当てたターゲットに送信します。シンプルにはLuna、ミディアムにはSol、コンプレックスにはOpus 5.5を割り当てるのが適切な初期マップとなります。弊社のベンチマークでは、このようなルーティングにより、約98%の品質を維持しながらコストを50〜70%削減できました。フォールバック先としてOpus 5やAstraを追加することも可能です。アプリケーション側は、全体を通して1つのモデル名を呼び出すだけで済みます。
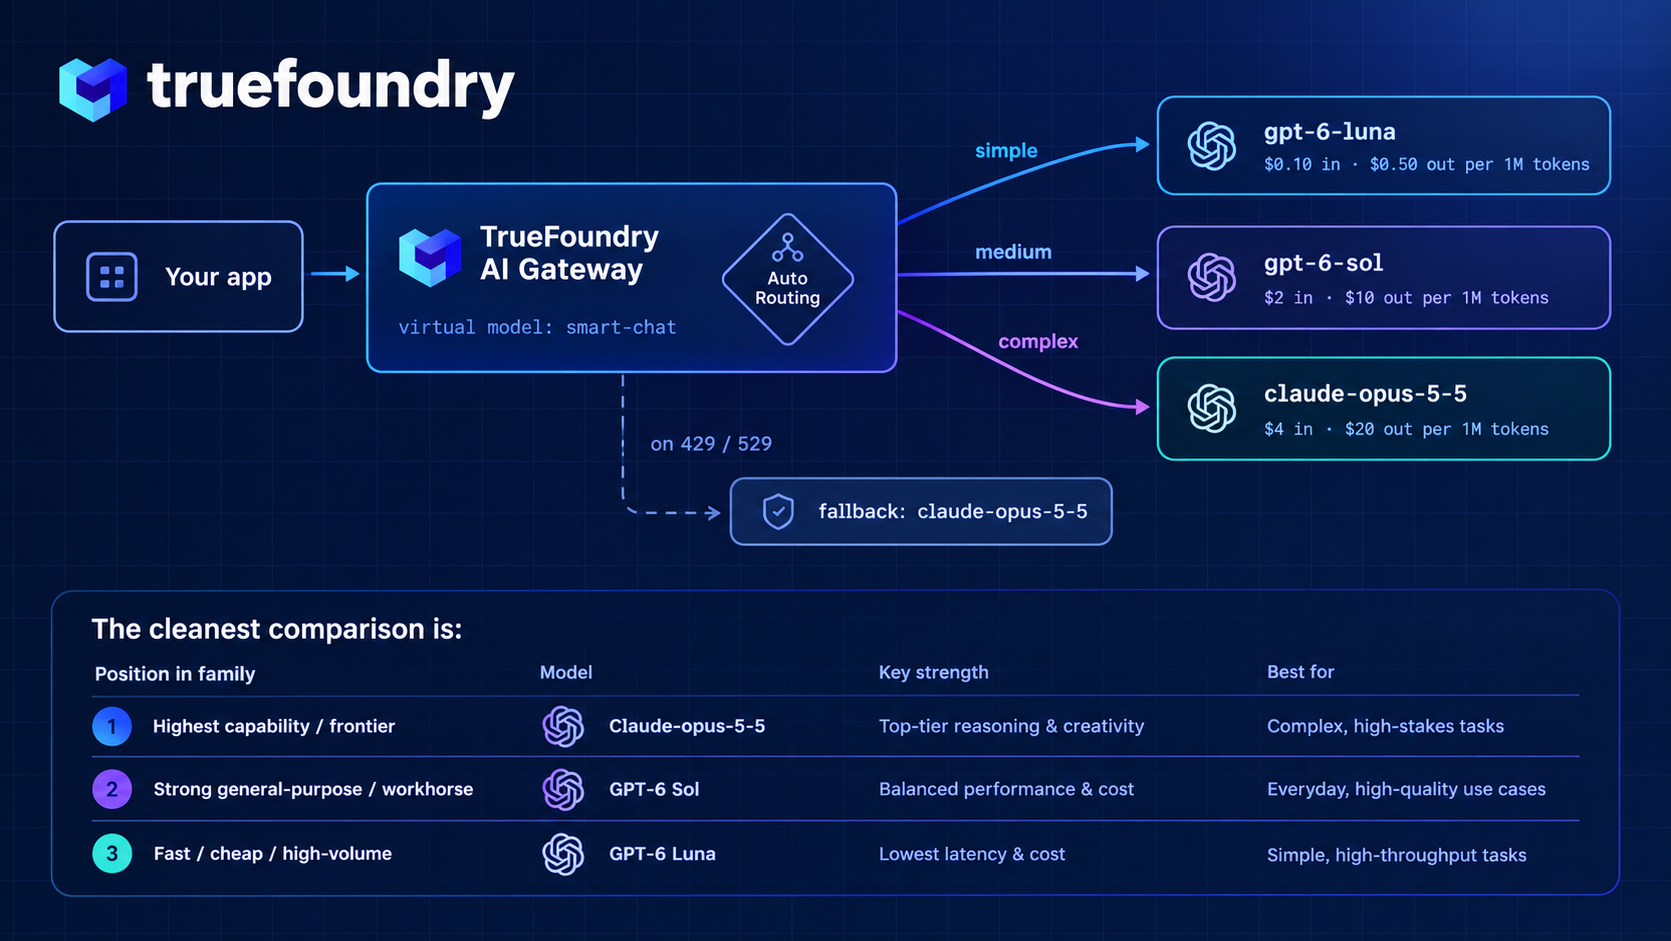
Opus 5.5は、タスクが高度でFableの価格設定では正当化できなかった場合に最適なモデルです。SolとLunaは、タスクが全く高度ではない場合に利用すべきモデルです。これらすべてをTrueFoundry経由で運用するということは、どのモデルを使用するかという決定がGatewayの構成内で行われることを意味し、デプロイを行わずに火曜日の午後に設定を変更できます。
TrueFoundry AI GatewayでClaude Opus 5.5、GPT-6 Sol、GPT-6 Lunaをお試しください →
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.