


11月 20, 2026
|
5 min read


Published: 11月 20, 2026

Blazingly fast way to build, track and deploy your models!
Bifrost は、2026 年におけるほぼすべての「AI gateway」選定リストに登場し、通常は最速およびオープンソースという言葉とともに紹介されます。しかし、ベンダー独自の数値を素直に読み解くだけでは、どちらの主張も十分には裏付けられません。そのため、当社は制限された 1 vCPU マシン上で自らベンチマーク測定を行うという確実な方法で検証しました。
本記事では、この比較におけるすべての Gateway に適用している同一の基準である、固定された 1 vCPU / 2 GB のテスト環境において、Bifrost のパフォーマンスに関する主張が実際の測定でどこまで維持されるかを解説します。
ここは、「最速の gateway」というあらゆる主張が真価を問われるセクションです。
ベンダーの数値:t3.xlarge(4 vCPU)上でモックのアップストリームに対して測定された、平均オーバーヘッド約 11 マイクロ秒における約 5,000 RPS。これを他のものと比較する前に、その数値が実際に何を測定しているかを理解する必要があります。Bifrost 自身のソースコードによると、マイクロ秒の数値は HTTP リクエスト処理および JSON マーシャリングを含めずに取得されています。つまり、これは gateway の内部パイプラインで費やされた時間であり、呼び出し元のリクエストに追加される純粋なレイテンシーではありません。同じソースでは t3.medium で 59 µs と記載されており、より小さなマシンではすでに約 5 倍劣化しています。また、これはパーセンタイルではなく平均値であり、ほとんどのチームが gateway コンテナに実際に割り当てるコンピューティングリソースの 4 倍の環境での数値です。
これらによって数値が不誠実になるわけではありません。単に「自分の p99 はどうなるか?」という問いとは異なる質問に答えているだけです。以下に示す内容はすべて、もう一方の数値です。つまり、マーシャリングと HTTP を含め、文書化された実際のペイロードサイズにおけるエンドツーエンドの追加レイテンシーであり、呼び出し元が gateway をパスに挟むことで支払う完全なコストです。測定対象が異なっているため、マイクロ秒とミリ秒の双方とも事実です。
当社は、固定環境(1 vCPU、2 GB RAM、オープンループ負荷。本比較で他のすべての gateway に適用している同一基準)を構築し、小規模(入力 200 / 出力 100 トークン)、中規模(2,000/500)、大規模(20,000/1,000)の 3 つのペイロードサイズにわたって Bifrost を直接測定しました。Bifrost の背後にあるモックアップストリームも固定されているため、減速は Bifrost に起因するものであり、不安定なテストダブルによるものではありません。非ストリーミング呼び出しでは 50 ms の「思考」時間 + ファーストトークンまで 50 ms、ストリーミング呼び出しでは固定 500 ms のストリーム時間という設定です。これが以下のチャートに見られる約 55 ms および約 530〜627 ms のベースラインであり、すべてのペイロードサイズで存在します。
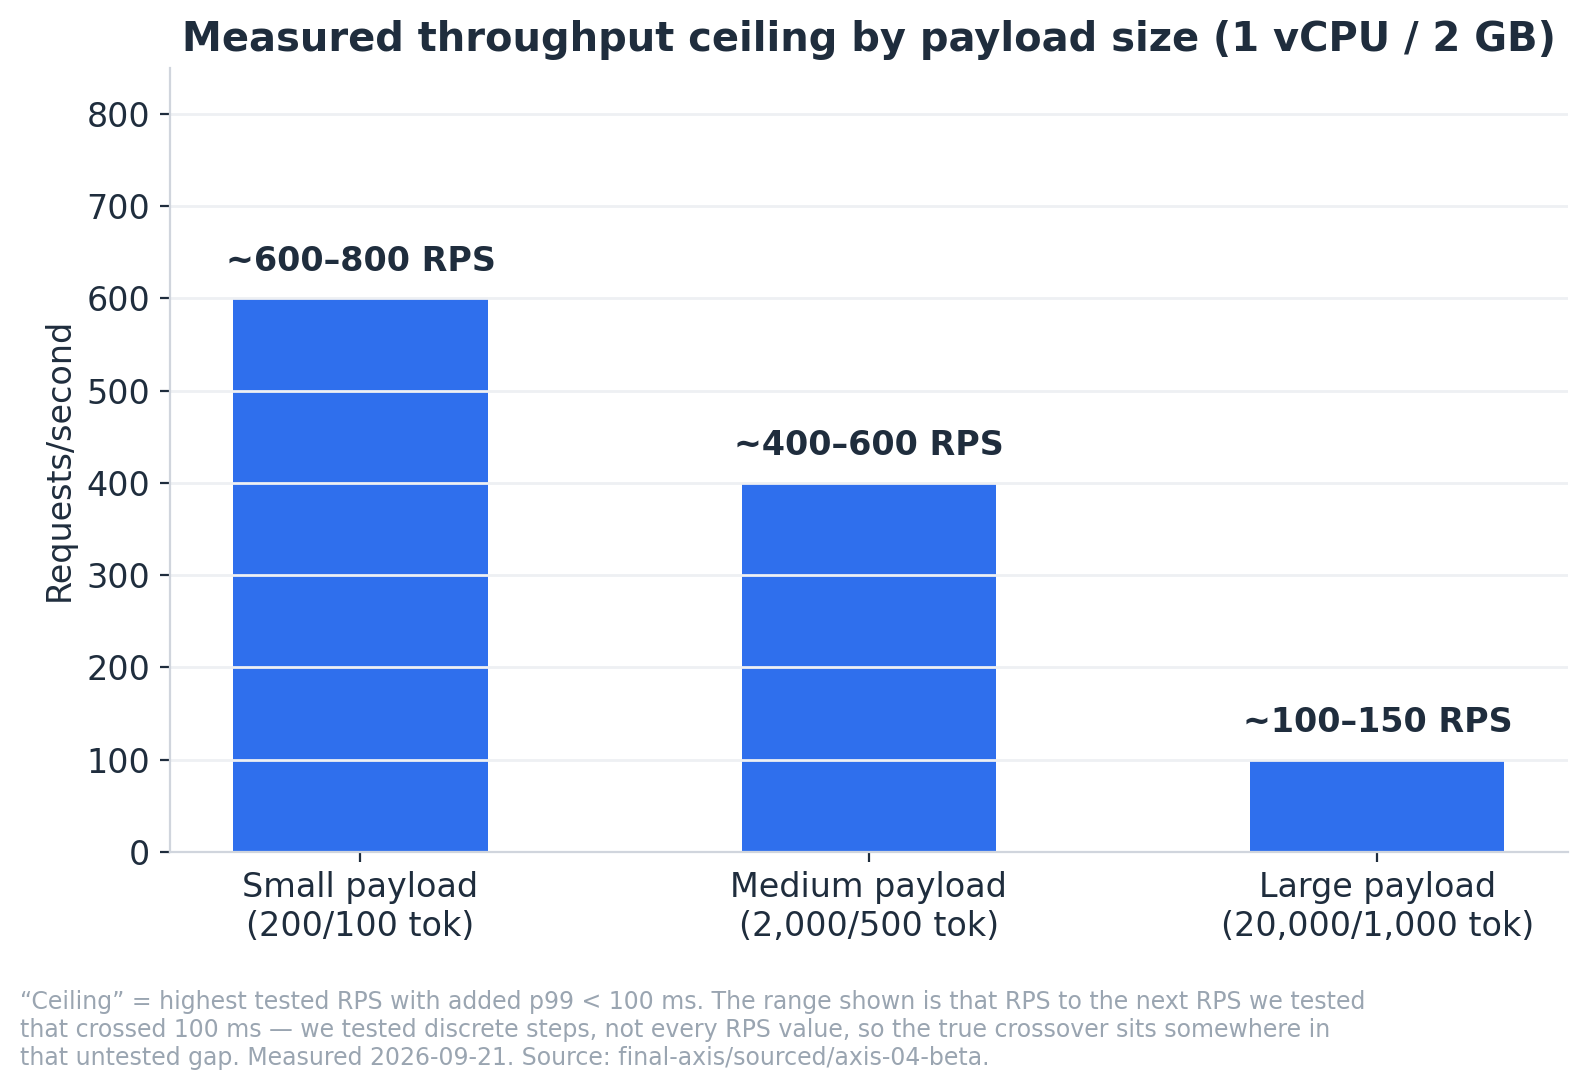
100 ms の追加レイテンシー予算における実際の特筆すべきスループット上限:小規模ペイロードで約 600〜800 RPS、中規模で約 400〜600 RPS、大規模で約 100〜150 RPS。これらは意図的にピンポイントの数値ではなく範囲で示しています。すべての値ではなく離散的な RPS ステップをテストしたため、各上限は実質的に「正常であることが確認できた最後の RPS から、正常でないことが確認できた次の RPS まで」を意味します。それらの範囲の下限以下では、中央値のリクエストが gateway に対して支払うコストは 2〜6 ms です。この中央値は本セクションで最も好ましい数値ですが、キャパシティ計画においては最も役に立たない数値でもあります。提供されるトラフィックの 60 倍の範囲にわたって小規模の場合で 2.1〜3.1 ms と、負荷によってほとんど変化しないため、gateway がダウンする直前まで安心感を与え続けてしまいます。実際に変動する数値は p99 です。追加 p99 は、10 RPS 時の +5.6 ms(小規模)、+7.5 ms(中規模)、+15.2 ms(大規模)から、600 RPS 時の小規模で +60 ms、400 RPS 時の中規模で +75 ms、わずか 100 RPS 時の大規模で +41 msへと上昇し、3 つのケースすべてにおいて、次にテストしたステップで 100 ms の予算を超えます。上限の範囲を超えると、3 つのペイロードサイズはいずれも緩やかに低下することはなく、それぞれ異なる形で問題が発生します。以下は、各ペイロードを並べ、gateway と実際のモックへの直接測定値を比較したものです(サイズ間で共有される単一の大まかなベースラインではなく、小規模、中規模、大規模それぞれが独自に異なる約 55〜62 ms の直接ベースラインを持ち、チャートにはそれぞれの実際の数値が表示されています)。
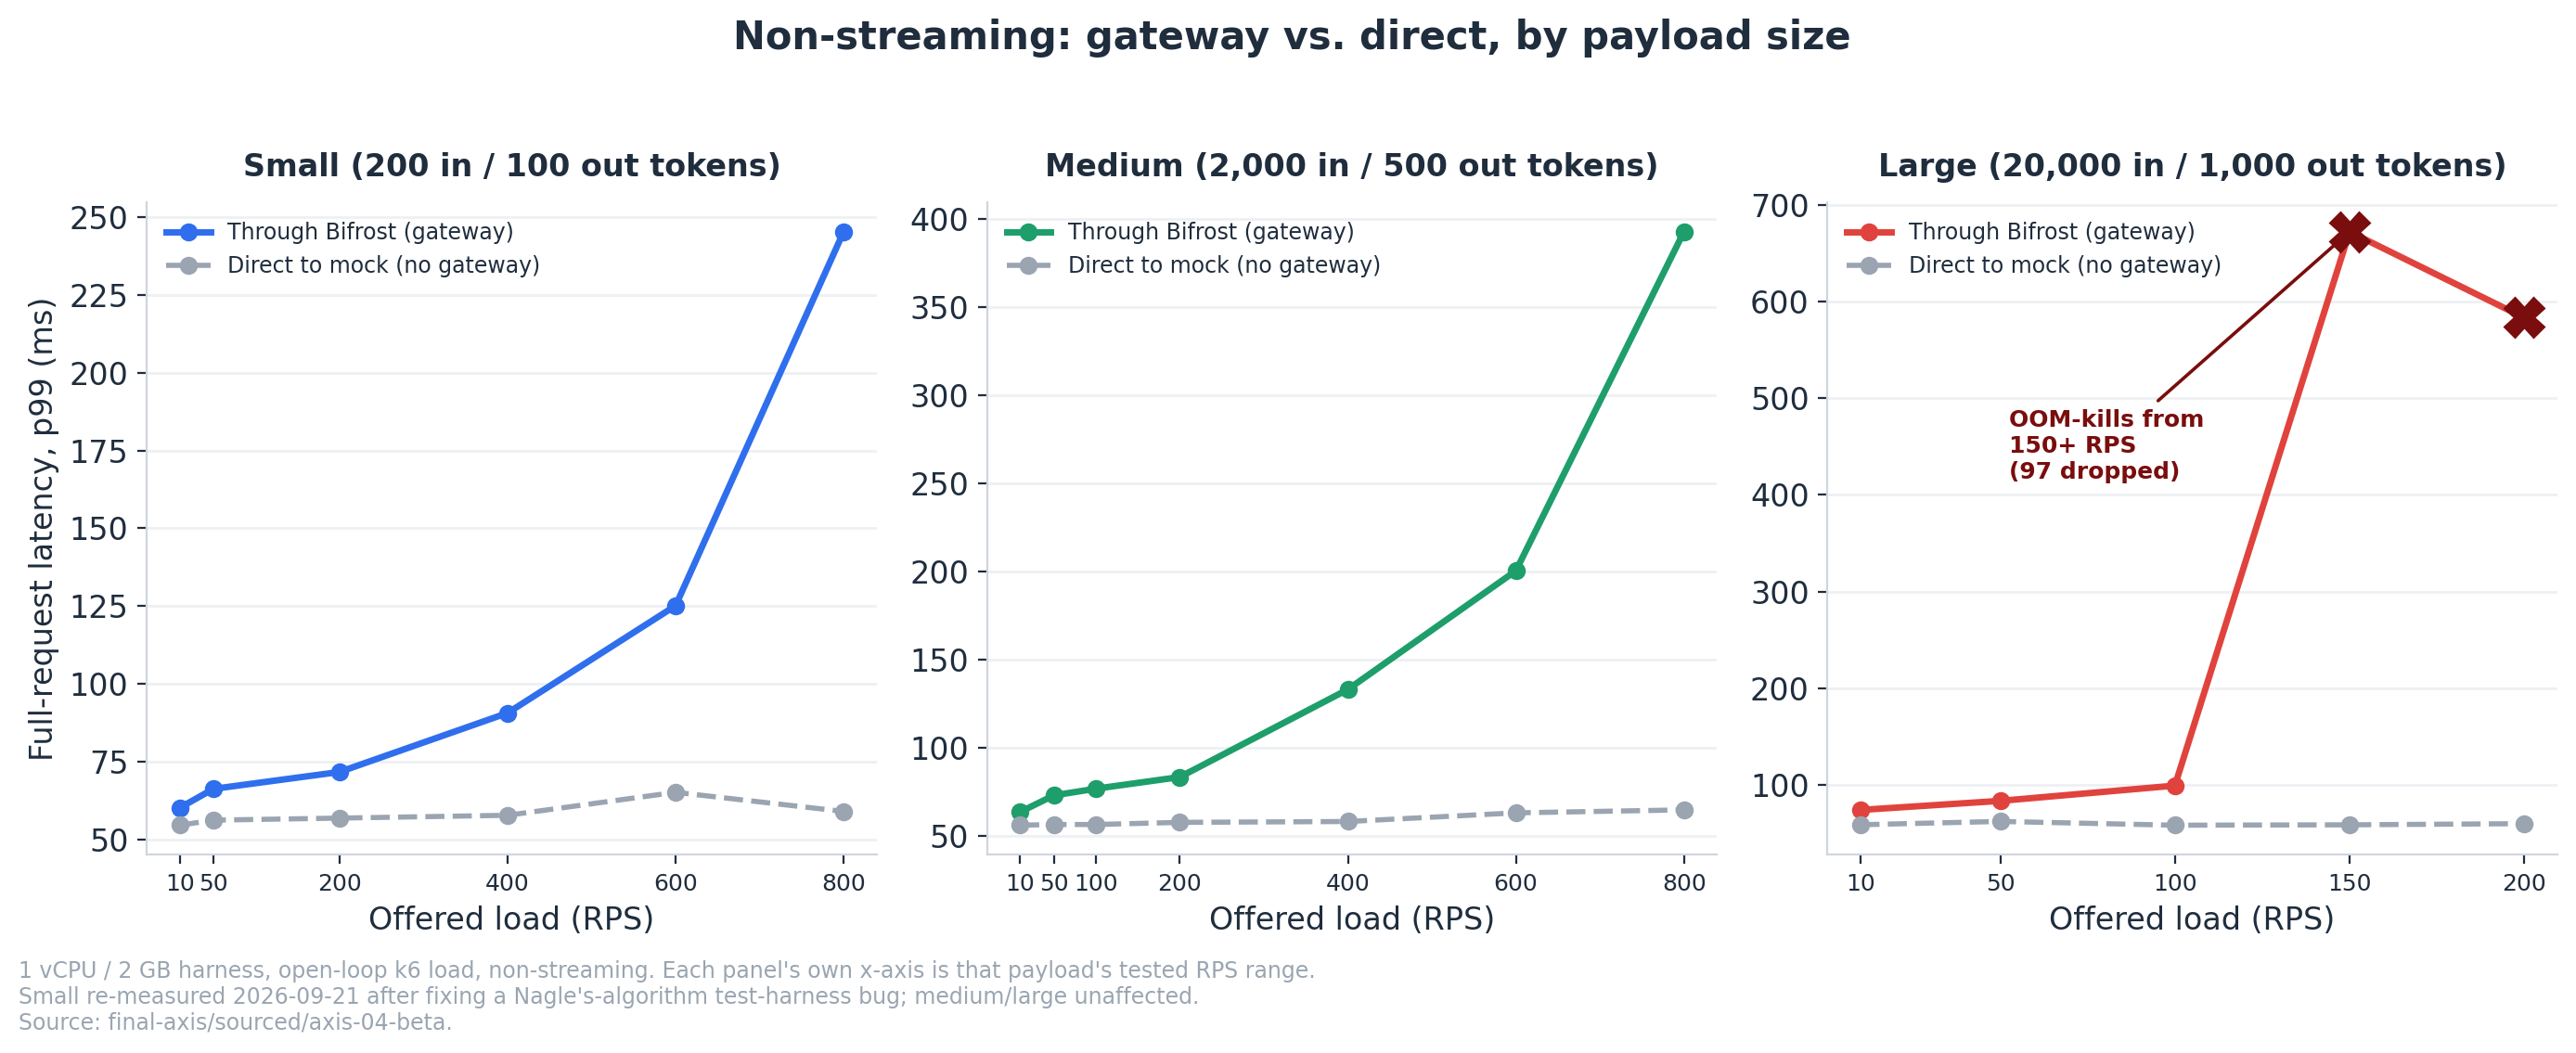
小規模と中規模は、RPS が異なるだけで同じ形状(平坦の後に p99 の裾が上昇する)を辿ります。小規模の上昇は約 400〜600 RPS あたりから始まります。中規模の上昇はリクエスト単位ではより早く始まりますが、2,000 トークンの入力によってリクエスト単位のコストが始終高く維持されるため、より急激な限界線はさらに先(400+ RPS)に存在します。大規模は段階的に上昇することはありません。10 から 100 RPS までは平坦ですが、150 RPS で急激に低下し、実行途中で Pod が OOM-kill され始めます(150 RPS で 61 件のドロップされたリクエスト、200 RPS でさらに 97 件)。これは小規模/中規模のようなキューイングの変調点ではなく、ハードなリソース制限であり、曲線ではなくほぼ垂直な跳ね上がりとして現れます。
ストリーミングも同じ制限に突き当たりますが、開いているすべてのストリームがメモリ内にバッファをより長く保持するため、より早く発生します。ペイロードごとの gateway と直接の比較は以下の通りです。
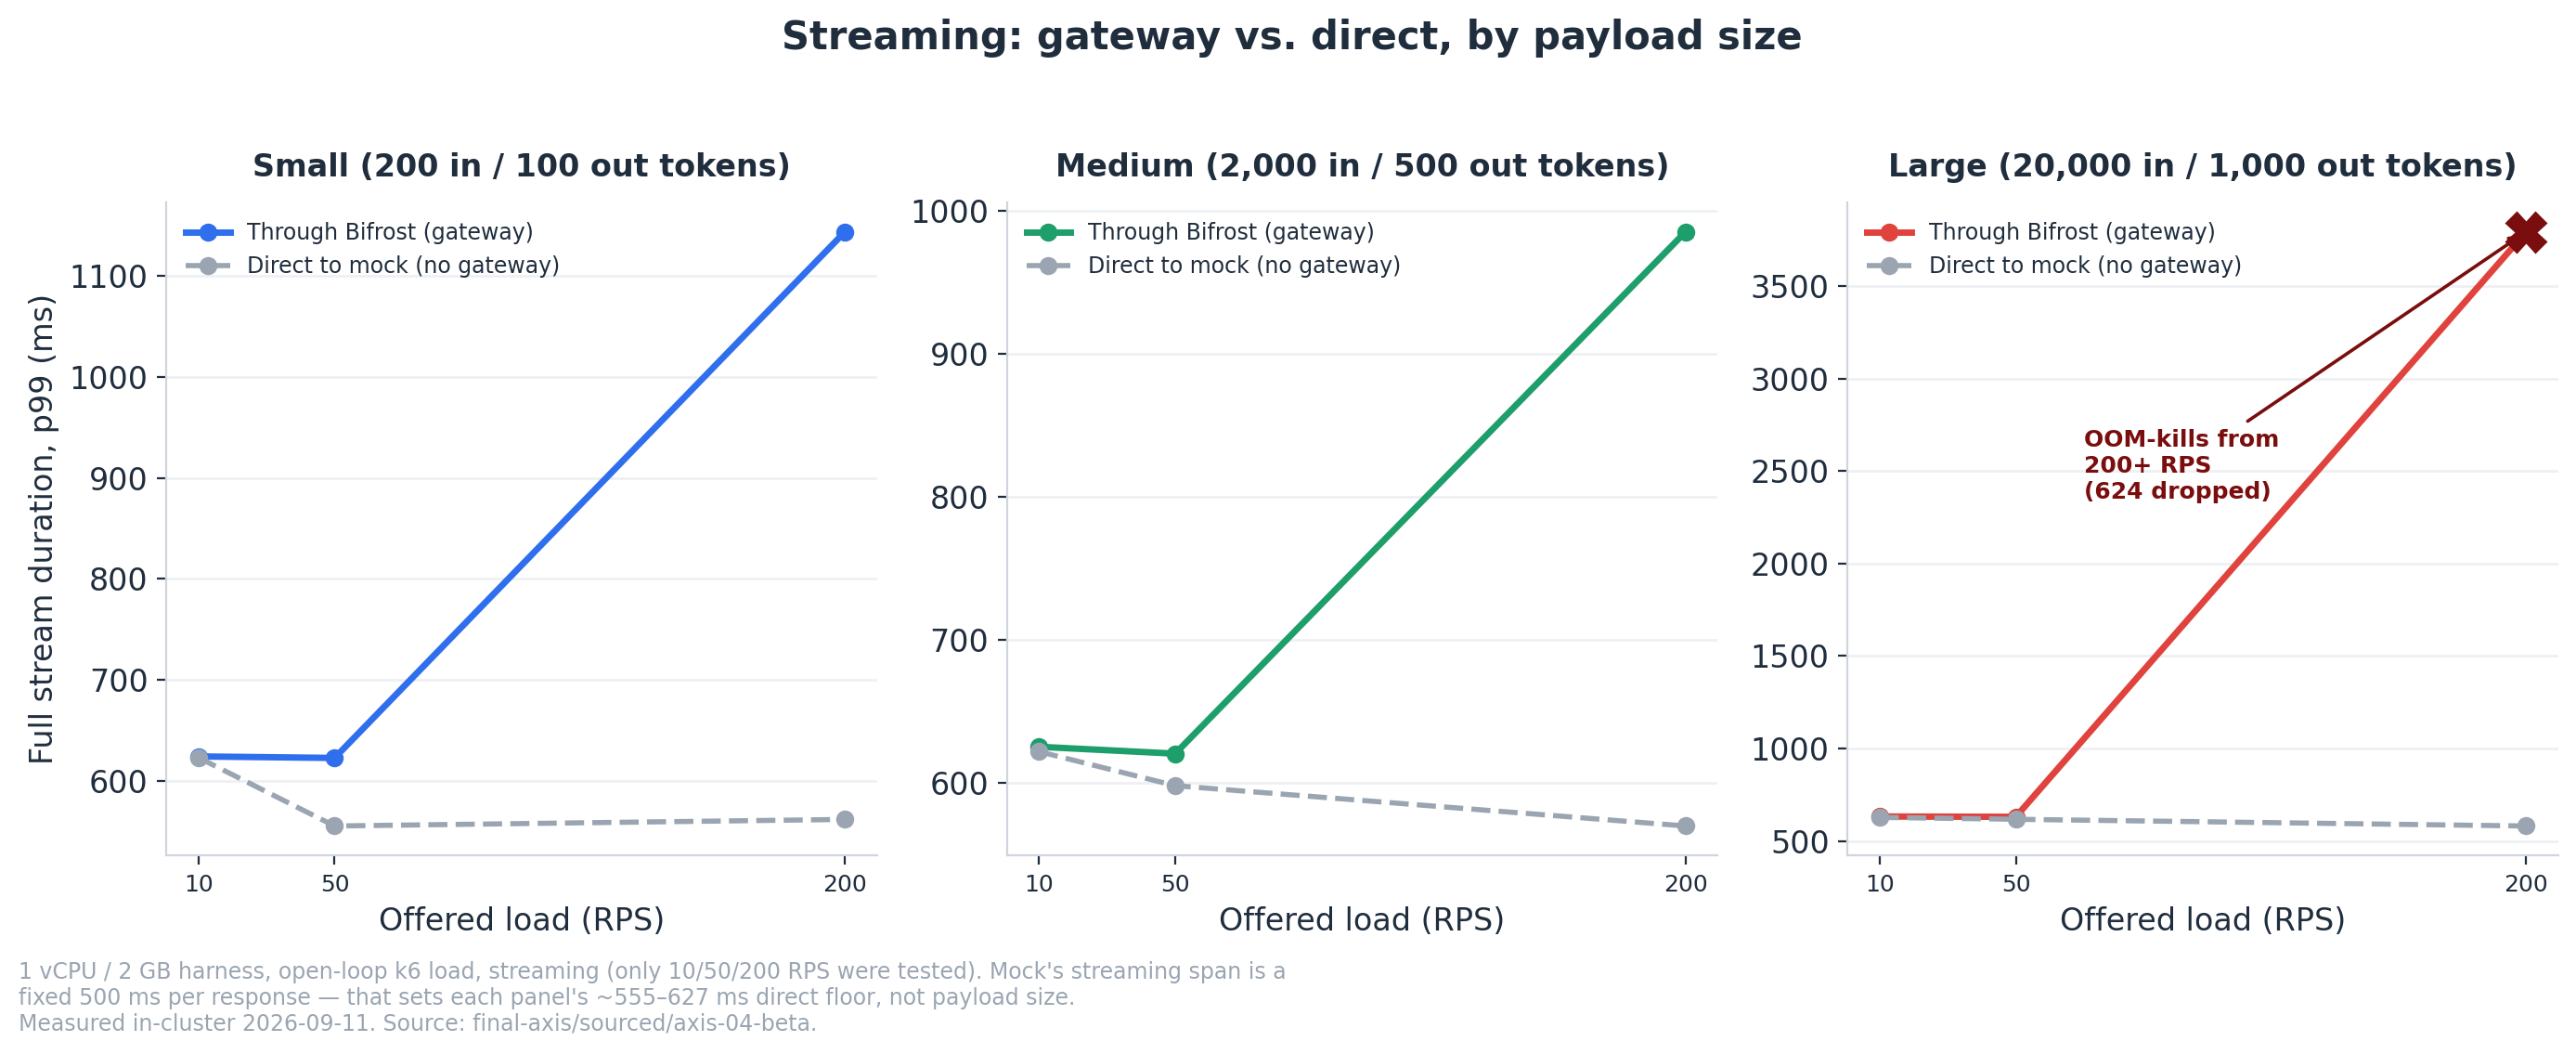
小規模と中規模のストリーミングは両方とも、50 RPS まではそれぞれの約 555〜627 ms の直接ベースラインに密接に追従し、200 RPS までに上昇し始めます(小規模の p99 は約 1.14 秒、中規模は約 985 ms に達します。両者とも OOM ではなくキューイングによるものです)。大規模のストリーミングにはそのような緩やかな上昇もありません。200 RPS までに実行途中で OOM 崩壊を起こし、12,001 個のストリームのうち 624 個をダウンさせ、p99 を約 3.8 秒まで膨らませます。ワークロードで大規模なドキュメントをストリーミングする場合、1 vCPU での 200 RPS は「低速」な層ではなく、「ダウンする」層となります。
ただし、UI でファーストトークンを表示するだけでよい場合、ストリーム全体の期間は重要な数値ではありません。そのため、ペアの非同期プローブを使用して、k6 の TTFB(モックがトークンが存在する前にヘッダーをフラッシュするため、ここでの SSE には無効)ではなく、実際のファーストコンテンツトークンの時間を測定しました。
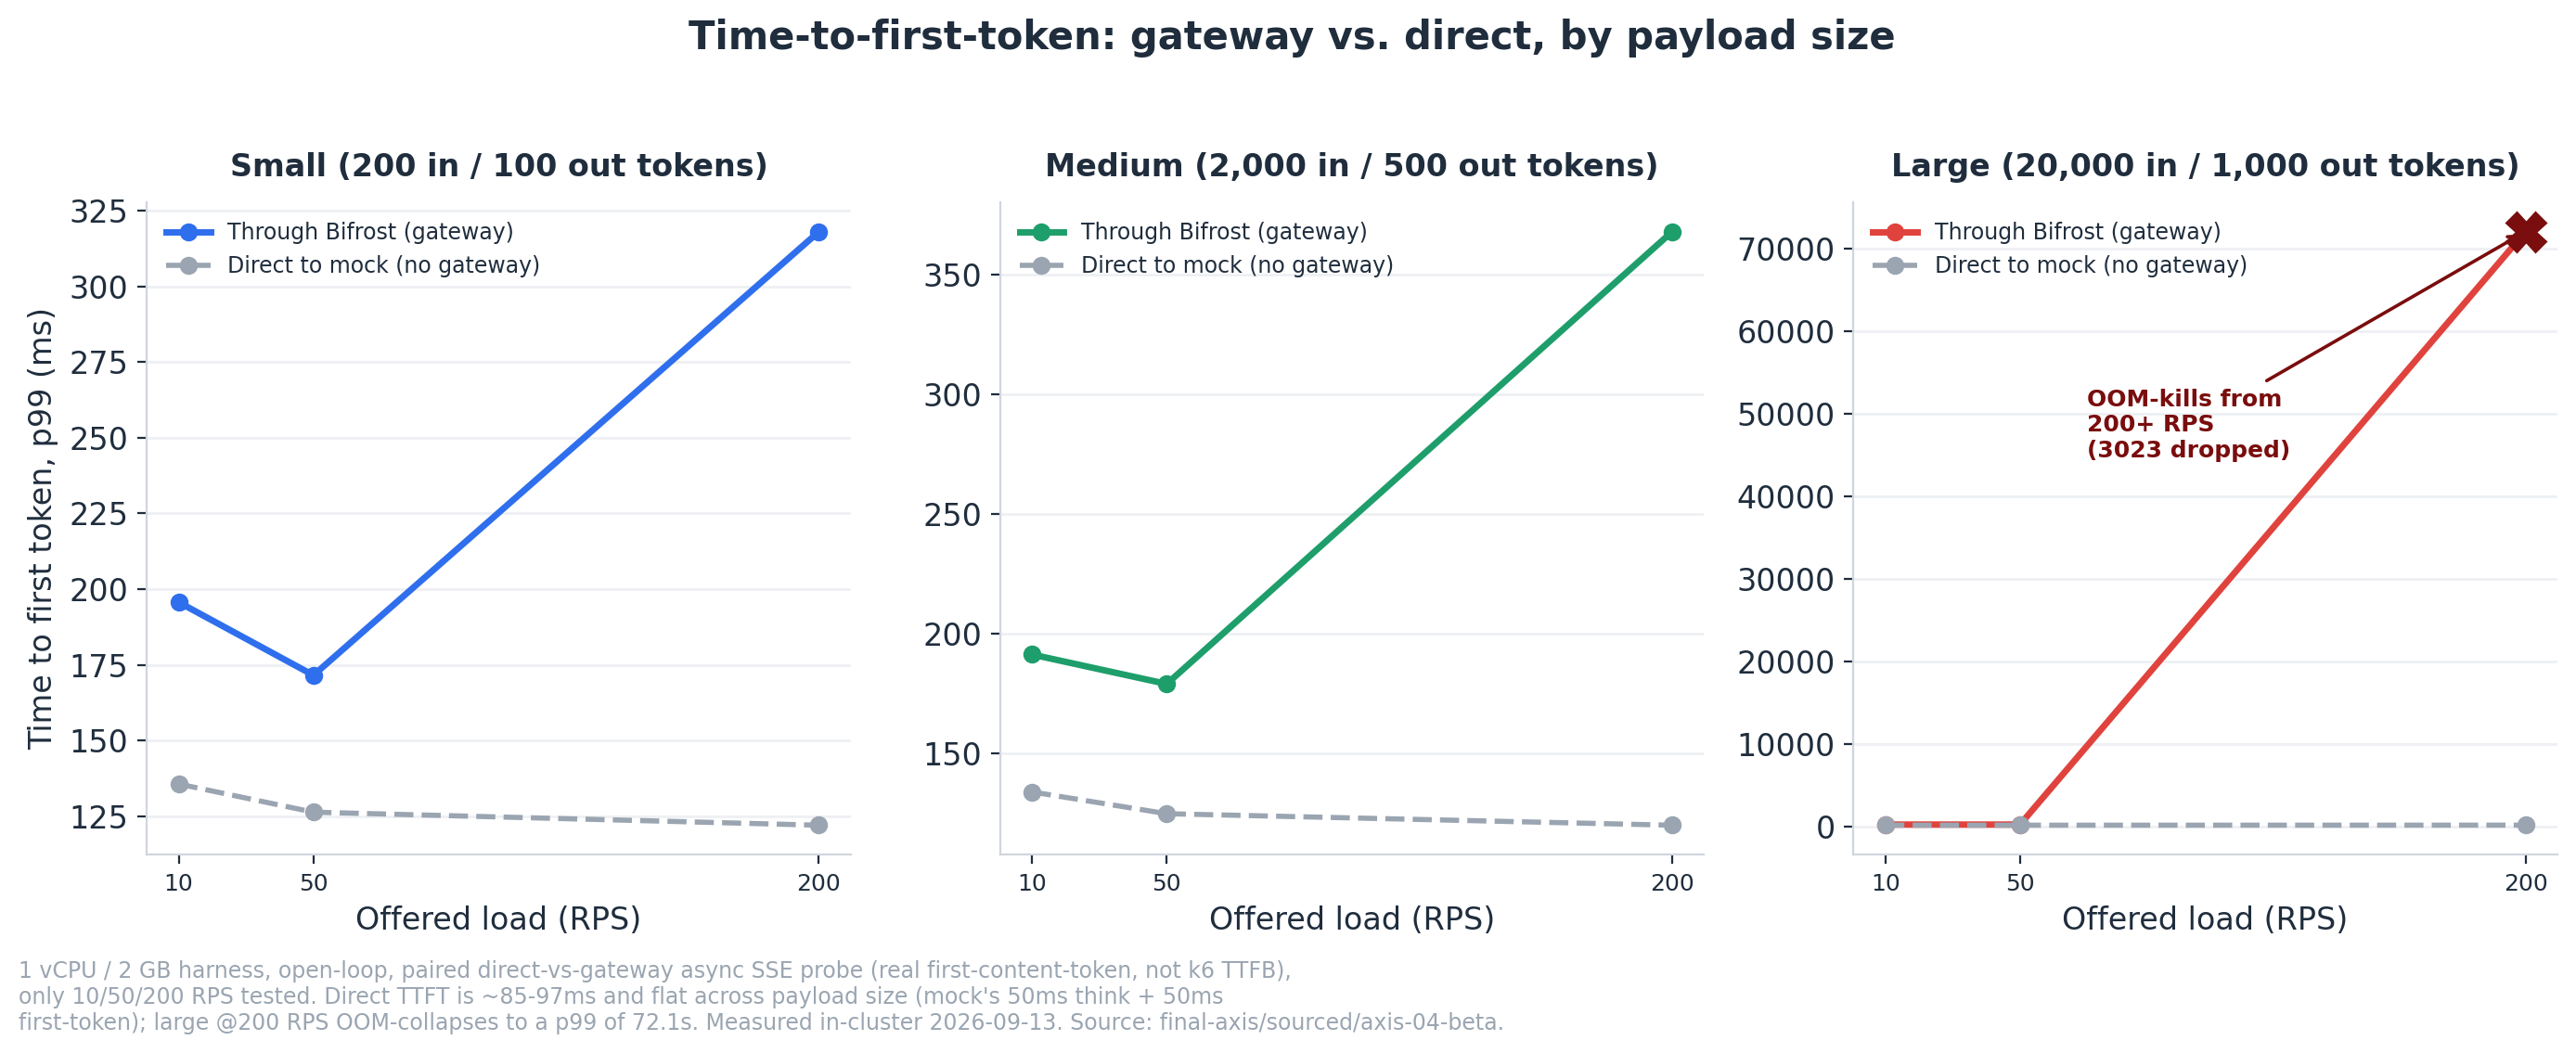
直接の TTFT は約 85〜97 ms で、3 つのペイロードサイズすべてで平坦です。これは入力の長さがファーストトークンの時間に影響しないことを示しており、そのベースラインを超えるすべての時間は Bifrost 自身の非同期リクエストごとのストリーミング設定コストです。この追加コストは 10〜50 RPS において約 27〜46 ms であり、サイズに依存しません(大規模 @10 RPS は +46 ms を追加、小規模 @10 RPS は +43 ms を追加。オーダーは同じでペイロードが異なります)。200 RPS では小規模と中規模の中央値はまだ維持されていますが(+57〜+71 ms)、末尾が急増し(追加 p99 は +196〜+248 ms に達する)、gateway ストリームの 10〜13% が完全に失敗します。これは上のストリーム全体のチャートで見られたものと同じキューイングの変調点です。大規模 @200 RPS には末尾の問題ではなく、崩壊が発生しています。提供された 200 RPS のうち 128.8 RPS しか処理されず、TTFT p99 は 72.1 秒まで膨れ上がり、12,001 個のストリームのうち 3,023 個が失敗します。これは、フルレスポンス側ではなくファーストトークン側から見た OOM の壁です。
また、意図的な過負荷バースト下において、Bifrost の 2 つのモードは両方ともメモリ安全性を維持しました。「blocking」モードは最終的に全員を処理し(最も遅いリクエストは約 5 秒待機)、「drop」モードはクリーンな 503 で迅速に失敗します。
大規模ペイロードの上限は、小規模/中規模とは全く異なる原因によるものです。原因は CPU ではありません。それを見るための最も明確な方法は、単一のピーク数値としてだけでなく、ペイロードサイズおよび提供された負荷ごとに分割して、メモリと CPU を個別に確認することです。
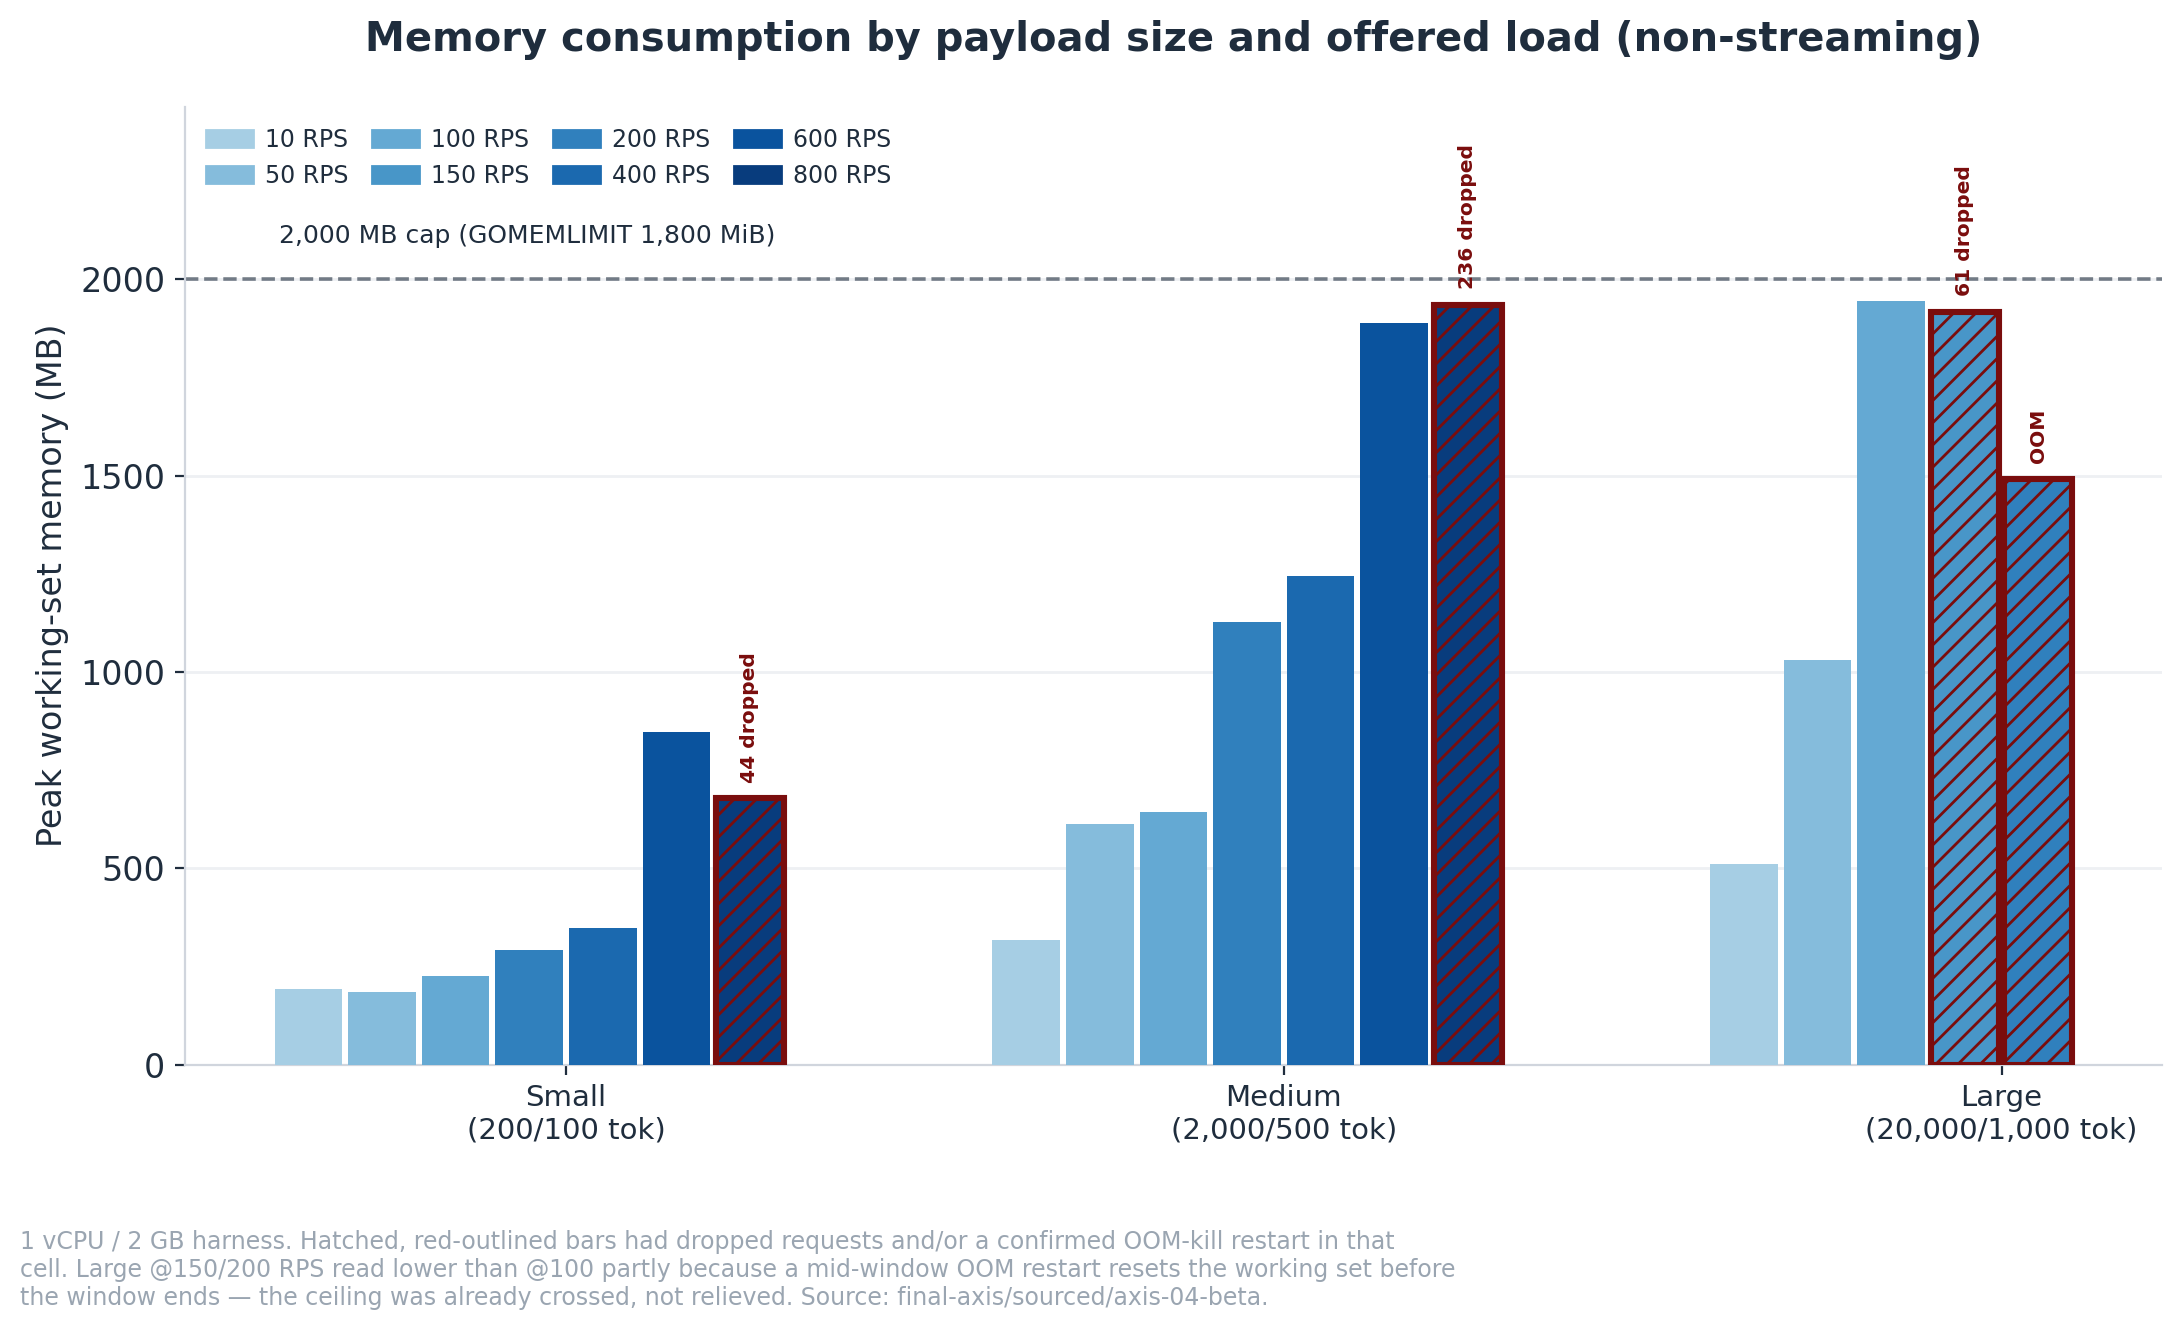
小規模と中規模は緩やかに上昇し、測定した最高の RPS(それぞれ 848 MB と 1,935 MB)でも 2,000 MB の上限に近づくことはありません。大規模は異なり、100 RPS の段階で測定された「上限」の 50〜700 RPS も手前の段階で、すでに 1,944 MB(上限の 97%)に達しています。赤枠と斜線で示されたバー(大規模 @150、@200)は、実際には 100 RPS のバーよりも低く読み取れます。これは回復のように見えますがそうではありません。ウィンドウ中間の OOM-kill によって Pod が再起動し、測定ウィンドウが終了する前にワーキングセットカウンターがリセットされるため、これらのバーは実際のピークを過小評価しており、過大評価ではありません。
CPU は正反対のストーリーを示しており、まさにこれがポイントです。
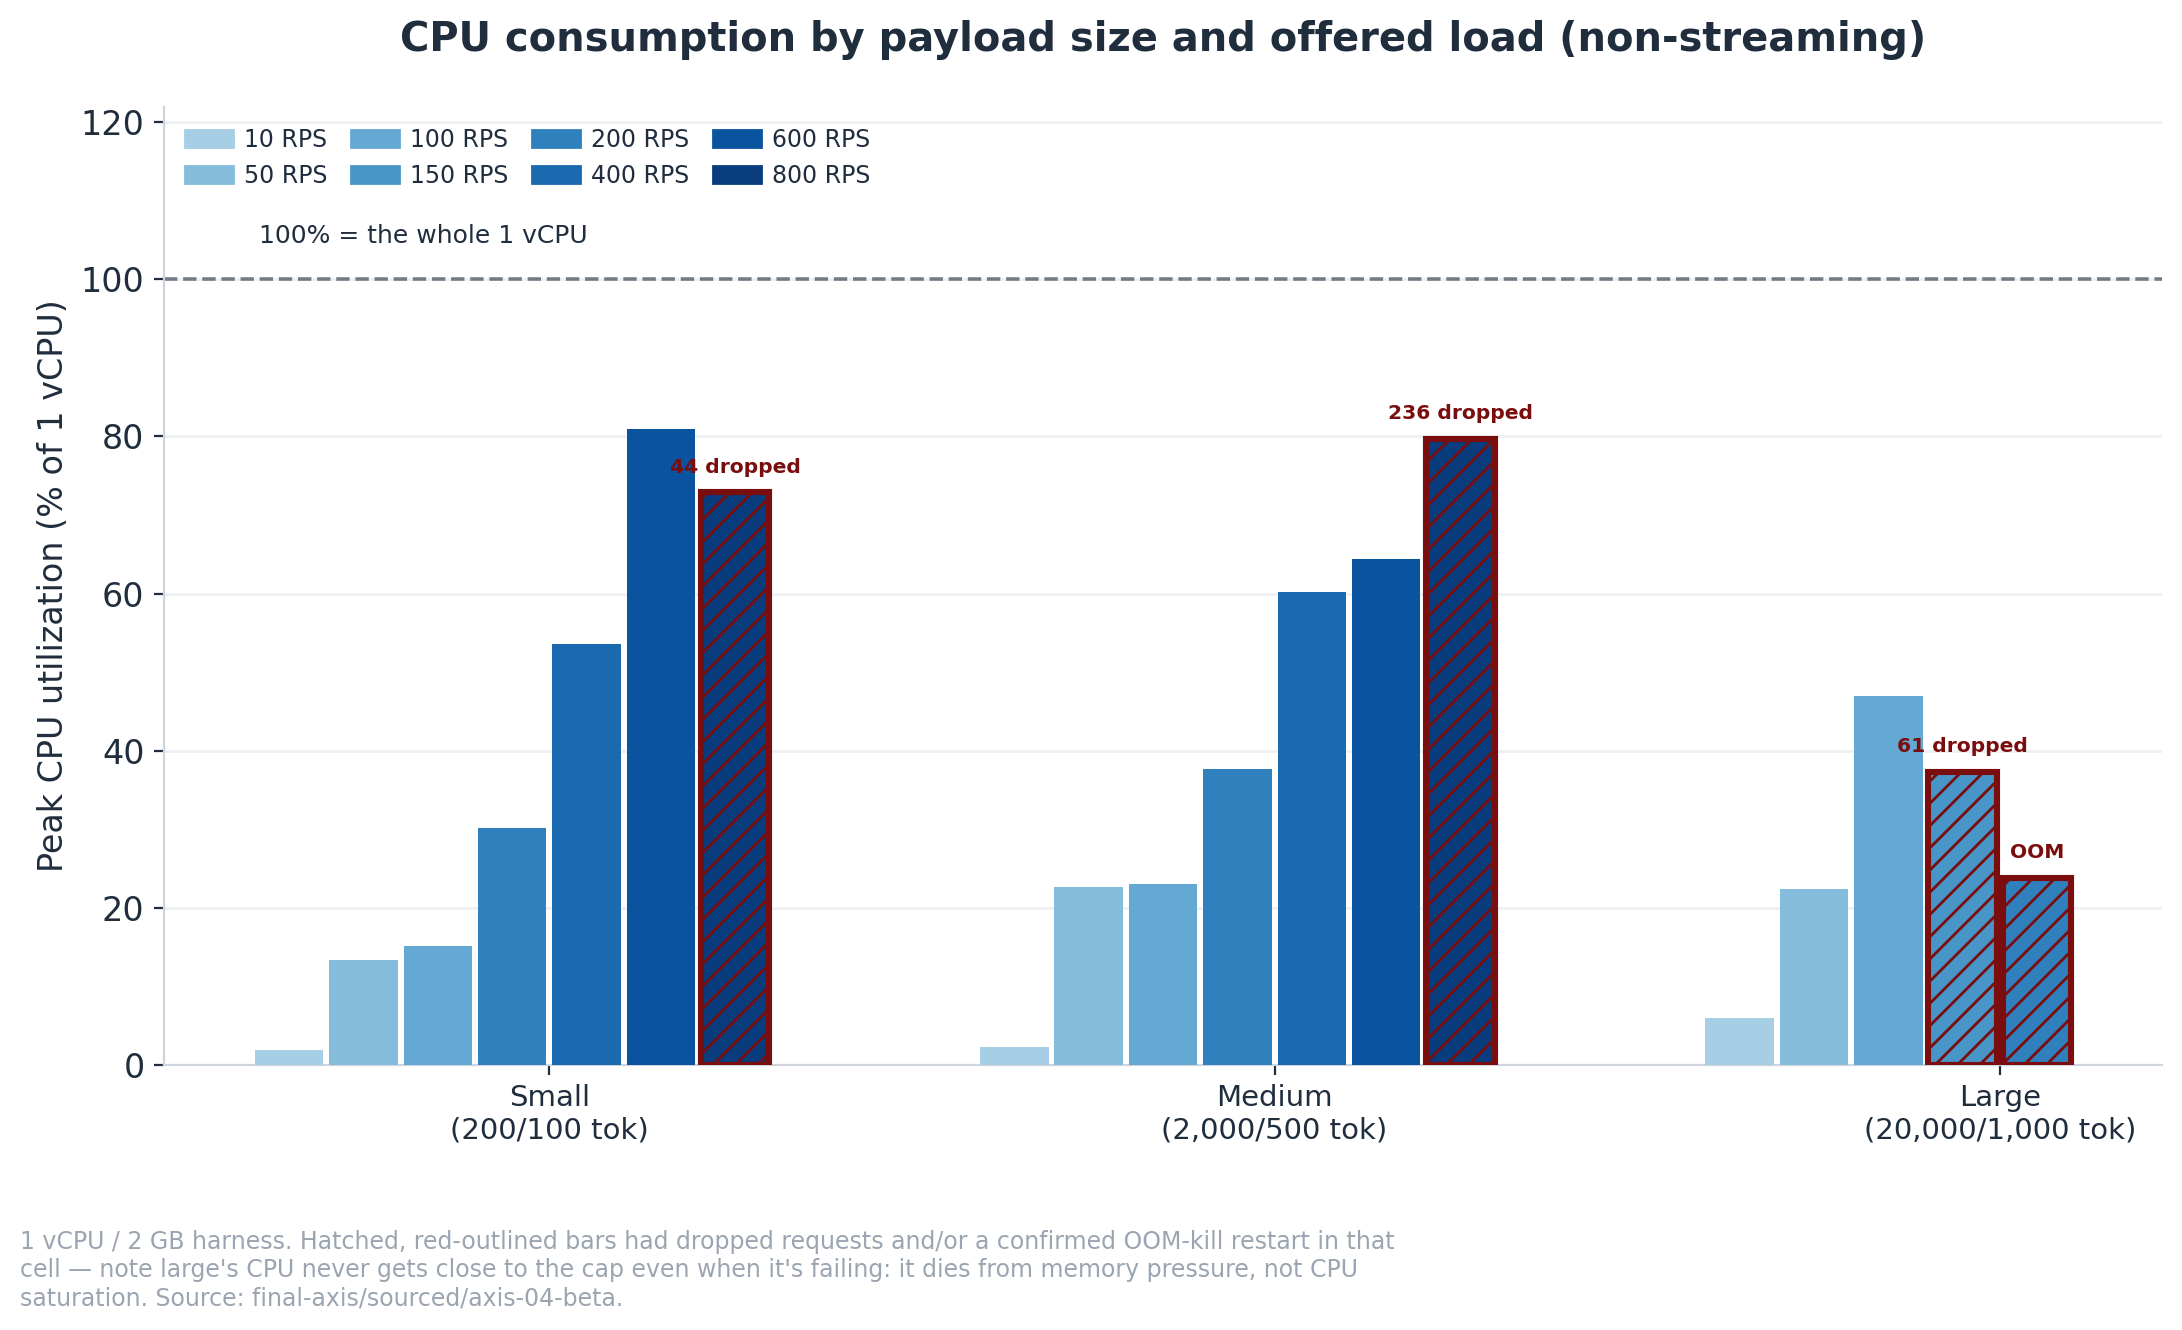
小規模と中規模は両方とも、最高の RPS で 73〜80% の範囲に上昇し、単一の vCPU に高い負荷をかける明確な CPU バウンドとなります。大規模はそうではありません。リクエストをアクティブにドロップし、OOM-kill されているセル(赤枠と斜線)でさえ、ピーク CPU は 37% と 24% で頭打ちになります。大規模は CPU の空き容量がなくなったために失敗しているのではなく、CPU に容量の余裕がある一方でメモリが枯渇したために失敗しています。ワークロードが長いドキュメントである場合、vCPU 数ではなく、この数値を基準に計画を立てる必要があります。
完全一致ヒットにより、約 59 ms の呼び出しが約 4 ms に短縮されます。セマンティックキャッシュ(異なる言い回しの同じ質問の繰り返しをキャッチする)は、埋め込み計算コストが発生しますが、新しい呼び出しと比較して半分に抑えることができます。
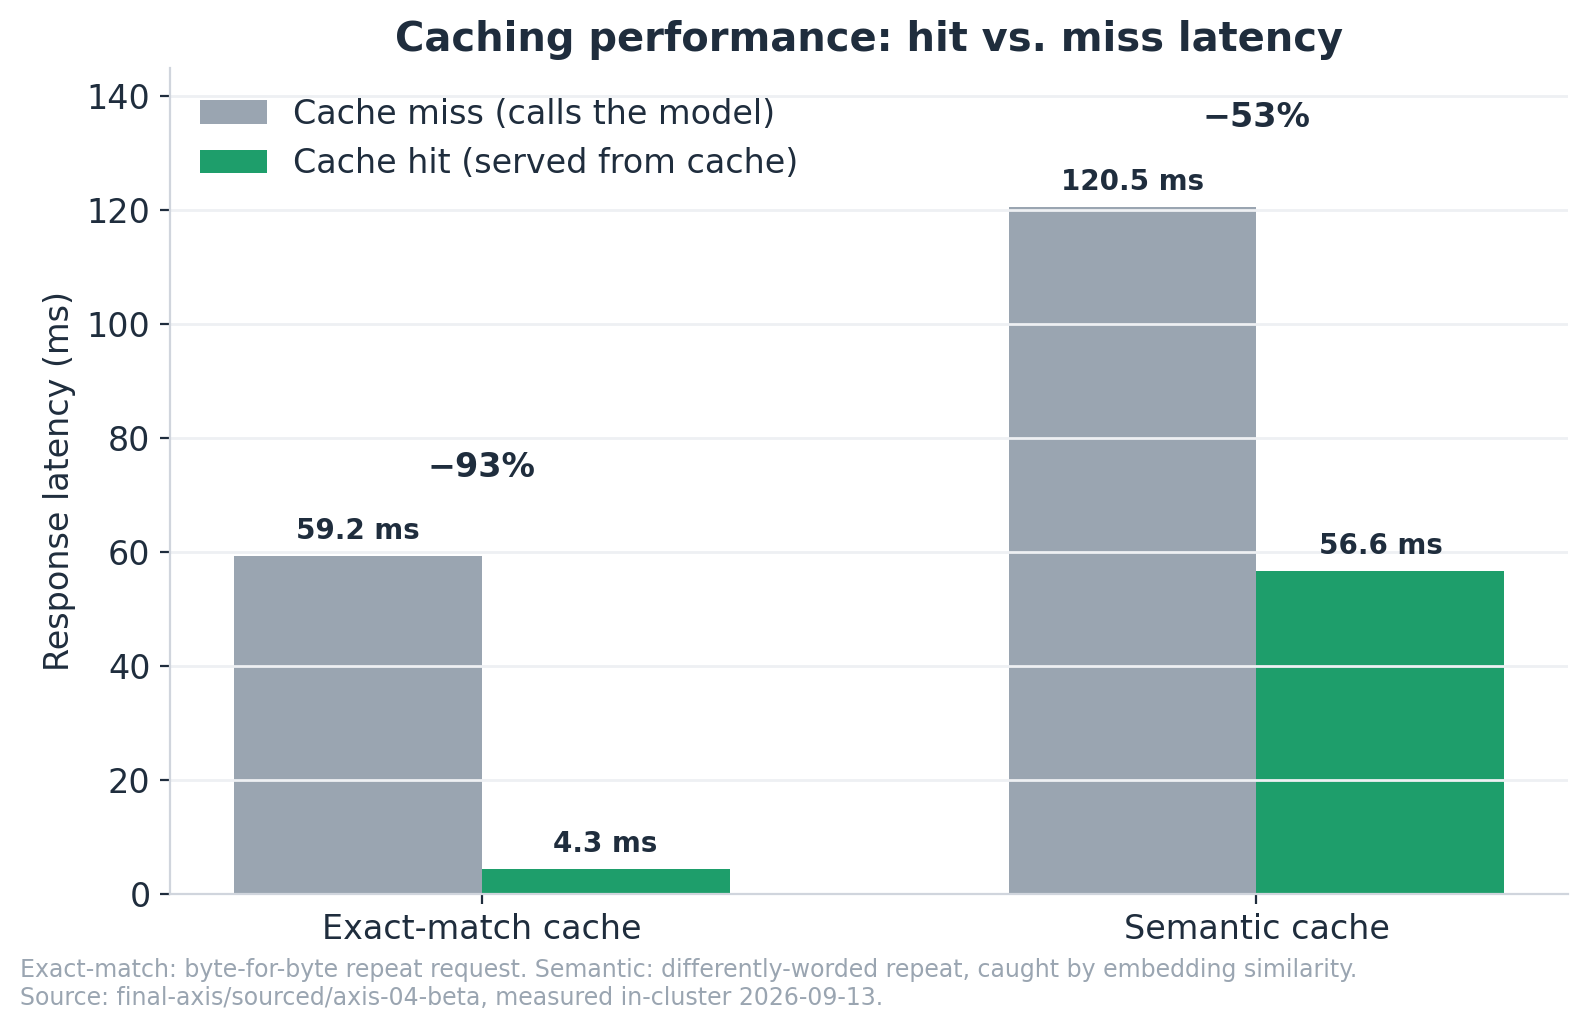
どちらの結果も単体としては驚くべきものではありません。キャッシュはモデルの呼び出しよりも高速であるはずであり、実際にその通りです。ここに示す数値は、正確にどれだけ高速化されるかを直接測定したものです。埋め込みコストが支払われた後、完全一致ヒットで 93%、セマンティックヒットで 53% の削減となります。
次へ進む前にもう 2 つの数値を示します。コールドスタートの中央値は 8.7 秒であり、そのうち 8.2 秒は一般的なコンテナ化セットアップにおける再起動ごとの必須のカタログ再ダウンロードです。永続ストレージを使用することで改善可能であり、ここでは個別に再テストしていません。
上記の数値に関する透明性のための補足:特に小規模ペイロードのセルにおいて、当社は自社のテストリグのバグ(ベースラインにノイズを発生させていた Nagle アルゴリズムのネットワーク干渉)を発見して修正しました。修正後、Bifrost の小規模ペイロードの上限は実際には約 400 から約 600〜800 RPS へと上昇しました。Bifrost を含むあらゆる gateway のベンチマーク測定において間違えやすい種類の問題であるため、修正を隠すのではなく作業工程を開示することを選択しました。
単一のマシン上において、Bifrost のオーバーヘッドは中央値において非常に低く抑えられています。約 55 ms のアップストリーム呼び出しに対して 2〜6 ms の追加であり、ペイロードサイズや負荷に関係なくほぼ平坦です。これは「最速の gateway」という主張の正当な根拠であり、価値のある特性です。実際の LLM 呼び出しに占める割合としては、無視できるレベルです。しかし、末尾( tail )は別のストーリーを示します。追加 p99 は負荷の影響を受けやすく、測定した上限で +41〜+75 ms に達します。また、大規模ペイロードは緩やかに低下するのではなく停止します(150 RPS で OOM-kill され、リクエストをドロップします)。キャッシュは宣伝通りに機能します(測定値で 93% および 53% のレイテンシー削減)。ベンダーの 5,000 RPS という数値は、ほとんどのチームが運用する環境よりも大規模なマシンおよび異なるワークロードを前提としています。したがって、単一ノードの場合、中央値の速度は問題ではありません。問題となるのは、負荷下の末尾レイテンシーと、ドキュメント主体のトラフィックにおけるメモリのヘッドルームです。
より難しい問題は、複数のノードを運用する場合に何が起きるかです。プロダクションの gateway は、スケールアウト、スケールイン、および誰にも気づかれることなく Pod の停止に耐えられる必要があります。オープンソース版では、ここが難点となります。構成変更はレプリカ間でライブ伝播されません。ドキュメント化されているパターンは、共有設定ファイルと再起動の組み合わせです。そのため、ルーティングの変更、キーのローテーション、予算の更新を行うたびに、切り替えの設定ひとつではなく、gateway Pod 全体での協調したロールアウトが必要になります。さらに、最初の管理者アカウントが作成されるまで誰でもアクセスできる管理ダッシュボードが存在することを考慮すると、オープンソース版はフリート環境よりも、注意深く監視する単一ノードに適しています。
Bifrost Enterprise はそのギャップの多くを解消します。gRPC メッシュにより、再起動なしで数秒以内にすべてのレプリカに構成変更がブロードキャストされます。しかし、Enterprise であっても、自身でデプロイ、スケール、パッチ適用、監視を行うインフラストラクチャであることに変わりはありません。ライセンスを購入しても、運用負荷が他者に移行するわけではありません。
したがって、真の決定は「Bifrost は高速か?」ではなく、「誰がそれを運用するのか?」ということです。専任のプラットフォーム/DevOps キャパシティを持つチーム、またはすべてを自社環境内に保持する厳格な要件を持つチームであれば、Bifrost を適切に運用できます(複数のレプリカが必要な場合は Enterprise が理想的です)。LLM 呼び出しの前段に信頼性の高い gateway を必要としているだけの小規模なチームにとっては、自前で gateway の運用を抱え込むよりも、マネージドサービスを利用する方が大きなメリットを得られるのが一般的です。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.












