



November 16, 2026
|
5 min read

Blazingly fast way to build, track and deploy your models!
今日のAI駆動型企業において、堅牢なAI安全性対策とLLMコンプライアンスは非常に重要です。企業が強力な大規模言語モデル(LLM)をビジネスワークフローに統合する際、これらのモデルを組織のルールに沿って「正しい軌道」に乗せ続けるメカニズムが必要となります。AI guardrailsは、道路のガードレールと同様に、すべてのAIインタラクションが会社の基準、ポリシー、バリューを反映するように機能します。Guardrailsは、LLMのプロンプトとレスポンスを自動的にチェックまたは変換し、セキュリティ、プライバシー、コンテンツポリシーを適用します。TrueFoundryのAI Gatewayは、AIパイプラインの中核にこのようなguardrailsを組み込み、リクエストとレスポンスを検証して安全性、品質、コンプライアンスを保証します。本記事では、AI Gatewayの文脈におけるAI guardrailsの技術的概要を提供します。Guardrailsの定義、機能の仕組み、重要なコンポーネント、および企業における導入方法について解説します。
AI guardrailsとは、エンタープライズポリシーを強制するために生成AIシステムの周囲に配置されるルールベースのコントロールとフィルターです。Guardrailsは、AIツールが「組織の基準、ポリシー、バリューに合致して動作する」ことを保証するのに役立ちます。実用上、これはguardrailsが機密データをマスキングまたは削除(データプライバシーのため)、許可されていないトピックをブロック(コンテンツコンプライアンスのため)、または出力フォーマットを検証(品質保証のため)することを意味します。
AI Gateway(TrueFoundryなど)では、guardrailsは2つのポイントで適用されます。リクエストがLLMに送信される前(入力guardrails)と、レスポンスが返された後(出力guardrails)です。LLMインタラクションの両端を補完することで、guardrailsはすべてのプロンプトと返答がエンタープライズルールに準拠していることを保証します。
AI Guardrailsの実際の活用例:
要約すると、AI guardrailsはAIガバナンスポリシーの技術的な強制手段であり、「すべてのリクエストとレスポンスが、セキュリティ、品質、コンプライアンスに関する組織の基準を満たす」ことを確実にします。
Gateway評価のための主要メトリクス
| 基準 | 何を評価すべきか? | 優先度 | TrueFoundry |
|---|---|---|---|
| レイテンシ | 最初のトークンまでの時間(Time-To-First-Token)において、p95オーバーヘッドが10ms未満に抑えられているか? | 必須 | ✅ サポート対象 |
| データレジデンシー | 自社領域内(EU/USなど)にログを保持できるか? | ユースケースによる | ✅ サポート対象 |
| レイテンシベースのルーティング | リアルタイムのレイテンシや障害に基づいて自動的に再ルーティングできるか? | 必須 | ✅ サポート対象 |
| キーのローテーションと無効化 | ダウンタイムなしでキーのローテーションや無効化ができるか? | 必須 | ✅ サポート対象 |
| キーのローテーションと無効化 | ダウンタイムなしでキーのローテーションや無効化ができるか? | 必須 | ✅ サポート対象 |
| キーのローテーションと無効化 | ダウンタイムなしでキーのローテーションや無効化ができるか? | 必須 | ✅ サポート対象 |
| キーのローテーションと無効化 | ダウンタイムなしでキーのローテーションや無効化ができるか? | 必須 | ✅ サポート対象 |
| キーのローテーションと無効化 | ダウンタイムなしでキーのローテーションや無効化ができるか? | 必須 | ✅ サポート対象 |

TrueFoundryのAI Gatewayは、すべてのLLM呼び出しの入力と出力の両方にguardrailsを適用します。入力guardrailsは、プロンプトがモデルに届く前に実行され、個人データのマスキングや禁止コンテンツのフィルタリングなどのタスクを実行します。出力guardrailsは、モデルが応答した後に実行され、不安全または許可されていないコンテンツがないかチェック(必要に応じて修正)します。
各guardrailルールは、validate(ブロック)またはmutate(変更)の2つのモードで動作できます。validateモードでは、検出された違反によってリクエストまたはレスポンスがエラーとともにブロックされ、コンプライアンスが厳格に強制されます。mutateモードでは、guardrailが自動的にコンテンツを変更して問題を削除または変換します(電話番号のリダクションや禁止用語の置換など)。この2段階(入力/出力)および2モード(validate/mutate)のアプローチにより、機密データや非準拠データがシステムをすり抜けるのを確実に防ぎます。
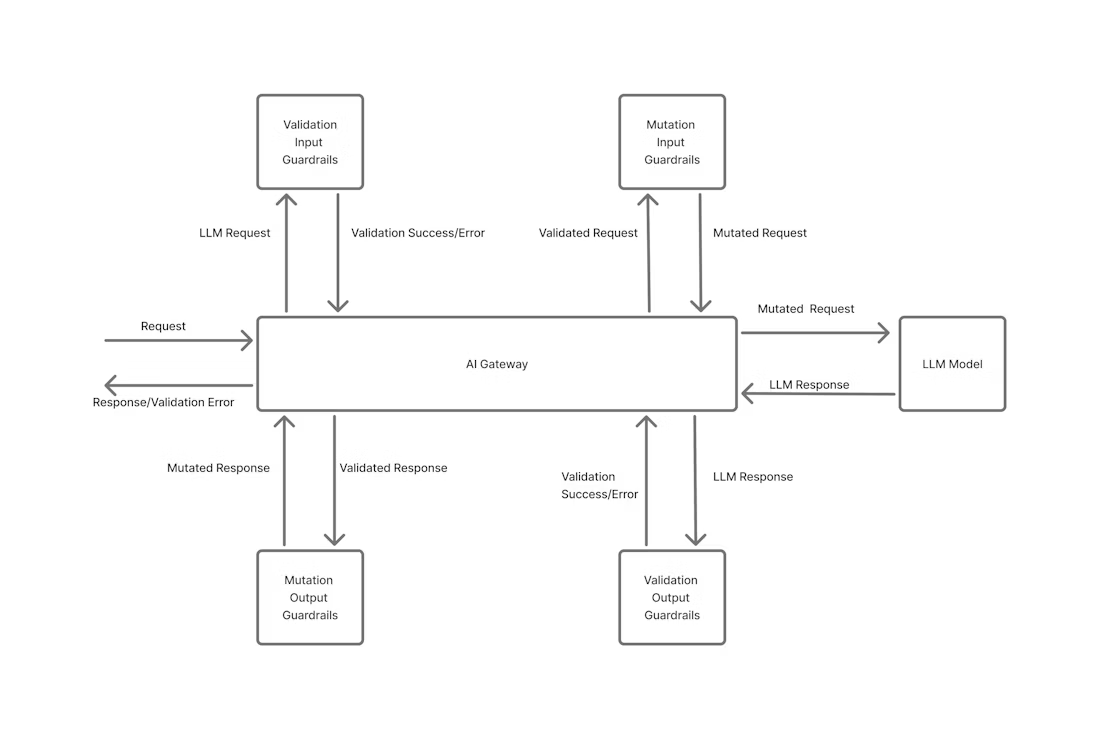
上の図は、各メッセージがモデルに到達する前に入力フィルターを通過し、応答後に出力フィルターを通過することで、AIインタラクションの両側でセーフティネットを提供している様子を示しています。
TrueFoundryのAI Gatewayは、アプリケーションロジックを変更することなく、企業がすべてのLLMインタラクションにわたってguardrailsを定義、統合、管理できる統合制御レイヤーを提供します。GuardrailsはYAML、API、またはTrueFoundry Consoleを介して宣言的に設定でき、複数のAIプロバイダー(OpenAI、Anthropic、Azure OpenAIなど)全体でチームが一貫したポリシーを適用できるようにします。
ハイレベルでは、guardrailsはGatewayレイヤーで統合され、アプリケーションと基盤となるLLMとの間のトラフィックをインターセプトします。
このアーキテクチャにより、並列実行とguardrail結果のキャッシングを通じて低レイテンシを維持しながら、AIの安全性とコンプライアンスを確保します。
開発者やプラットフォームチームは、さまざまなスコープでguardrailsを設定できます。
グローバルGuardrails:すべてのモデルおよびエンドポイントに適用される組織全体のポリシー(例:PIIリダクションや禁止トピック)。
モデルレベルGuardrails:LLMプロバイダーごとの固有の設定(例:GPT-4にはAzure PII検出を使用し、ClaudeにはOpenAI Moderationを使用するなど)。
ルートレベルGuardrails:APIルートでのきめ細かな制御。異なるエンドポイントに異なる検証ルールやコンプライアンスルールを強制できます。
簡単な設定例は以下のようになります。
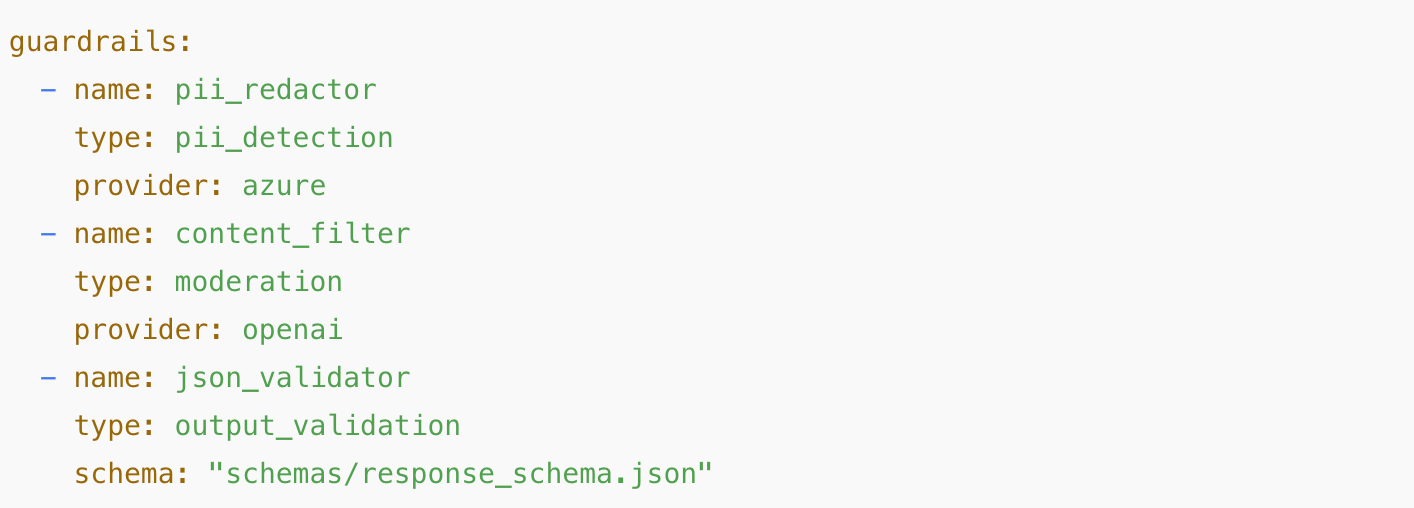
TrueFoundryのAI Gatewayを使用することで、組織はguardrailsをAIインフラのネイティブな要素として統合し、高いパフォーマンスと柔軟性を維持しながら、堅牢なAI安全性、データ保護、規制への準拠を確実なものにできます。
Guardrailsが存在しない場合、エンタープライズでのLLM導入は深刻なリスクに直面します。生成AIモデルは予測不可能で不安全な出力を生成する可能性があり、企業を法的、評判的、運用上の害にさらすことになります。例えば、フィルタリングされていないAIチャットボットがうっかりユーザーの個人情報を公開したり、不適切な言葉遣いや偏った表現を使用したりして、顧客の信頼を損ない、GDPRやHIPAAなどの規制に違反する可能性があります。機密性の高い領域(ヘルスケアや金融など)では、たった1つのハルシネーションによる回答でも破滅的な結果を招く恐れがあります。また、リアルタイムのチェックがないことは、問題がデプロイ後にしか検出されないことを意味します(不満を持ったユーザーや監査レビューによって判明するなど)。これは早期に検出するよりもはるかにコストがかかります。
実際、guardrailsの欠如は、セキュリティ侵害(データ漏洩)、コンプライアンス違反(違法なアドバイスや誤情報)、ブランド価値の棄損(攻撃的または一貫性のない応答)、および予測不能なアプリケーションの動作につながります。要するに、AIの安全性とコンプライアンスを強制するguardrailsがなければ、企業はコストの大きいエラーやAIシステムの制御喪失というリスクを負うことになります。
効果的なAI guardrailsは、さまざまなリスク領域をカバーするために複数の技術的要素を組み合わせます。堅牢なシステムには、通常以下が含まれます。
(1) ルールエンジン – ユーザー、モデル、またはコンテキストに基づいてマッチングを行う順序付けられたポリシー・ルールのセットであり、最初に適用可能なルールのみが実行されるようにします。
(2) PII & データフィルター – 入力と出力の両方において、個人情報や機密情報(メール、SSN、クレジットカードなど)を認識してリダクションする組み込みまたは外部の検出器。
(3) コンテンツ分類器 – リスク分類に基づいて、許可されていないトピック(医療アドバイス、ヘイトスピーチ、不適切な表現など)やハルシネーションをチェックするセマンティックフィルター。
(4) カスタムキーワードフィルター – 特定の用語をリアルタイムで変換またはブロックできる、企業固有の単語やフレーズのブロックリスト。
(5) 変換アクション – ポリシーに基づいて、コンテンツを拒否(validate)するか、自動的に無害化(mutate)する機能。
TrueFoundryのプラットフォームでは、これらのコンポーネントは「guardrail integrations」(OpenAIのモデレーションAPIへのリンクなど)として実装され、Gatewayが手動または自動で必要に応じて呼び出します。ルールが適用されるたびに、システムは監査と分析のためにイベント(何をチェックし、どのように処理したか)をログに記録します。これらが組み合わさることで包括的な安全フレームワークが構築されます。入力はLLMに届く前に事前にスクラブされ、出力はユーザーに届く前にチェックされます。McKinseyの表現を借りれば、効果的なguardrailシステムには、問題を指摘する「チェッカー」とそれらを修正する「コレクター」が含まれています。これはまさにTrueFoundryの入力/出力フィルターと変換ロジックが果たす役割です。
Guardrailsとガバナンスを区別することは重要です。AIガバナンスとは、何が許容され、なぜそうなのかを定義するハイレベルなフレームワーク、ポリシー、役割、および監視手順を指します(企業のデータプライバシーポリシーやAI倫理ガイドラインなど)。ガバナンスは、AIへの取り組みが明確な責任を持ち、法的および倫理的基準に沿っていることを確実にします。対照的に、guardrailsは、各AIリクエストに対してそれらのポリシーをリアルタイムで実装する技術的強制メカニズムです。言い換えれば、ガバナンスは道路の交通規則を設定し、guardrailsはAIという車両が脱輪するのを防ぐガードレールやセンサーの役割を果たします。Guardrailsのないガバナンスはポリシーが机上の空論に過ぎないことを意味し、ガバナンスのないguardrailsは何を強制すべきかの明確な指針がないことを意味します。実際には、効果的なAIリスク管理では両方を使用します。戦略的ガバナンスが目標(例:「PIIを絶対に公開しない」、「医療アドバイスを提供しない」)を定義し、guardrails(AI Gateway内)がすべてのLLMインタラクションでそれらのルールを自動的に強制します。あるアナリストが指摘するように、AIを安全にスケールさせるには、組織にはAIガバナンスと技術的guardrailsの両方が連携して機能することが必要です。
TrueFoundryのAI Gatewayを使用すると、組織全体にguardrailsを現実的にデプロイできます。通常、管理者はGateway UIで政策統合を保持するためのGuardrails Group(定義された管理者とユーザーを持つコンテナ)を作成することから始めます。そのグループ内で、プロバイダーの設定フォームに入力することにより、特定のguardrail integrations(コンテンツフィルタリング用のOpenAI Moderation APIなど)を追加します。
統合が定義されると、チームはTrueFoundryのPlaygroundを使用してすぐにテストできます。たとえば、入力guardrailを適用して不安全なプロンプトを送信すると、Playgroundはguardrailが期待通りにコンテンツをブロックまたは無害化することを実証します。
本番コードでは、開発者は選択したルールセットを指定したX-TFY-GUARDRAILSヘッダーを追加することで、リクエストごとにguardrailsを強制できます。これにより、アプリケーションは呼び出しごとに適用するフィルターを動的に指定できます。

全社的なポリシーに対して、TrueFoundryはGatewayレベルのguardrail設定をサポートしています。管理者はAI GatewayのConfigタブでYAML設定を作成し、when条件でルールを指定し、適用するinput_guardrailsとoutput_guardrailsをリストアップします。リクエストごとに最初にマッチしたルールのみが使用されます。
Gatewayレベルでguardrailsを定義することは、すべてのAIリクエストが会社のコンプライアンス基準に従って自動的にチェックされるため、組織全体のポリシー強制に最適です。このようにして、AI Gatewayはguardrailの管理と監査を集中化し、各アプリケーションを個別に実装する必要をなくします。
Guardrailsの領域は、AIの機能や規制とともに急速に進化しています。研究者はマルチレイヤーのguardrailアーキテクチャを推奨しています。たとえば、プライマリの入力/出力の「ゲートキーパー」レイヤーを、検索拡張チェックを使用して事実の正確性を検証する知識グラウンディングレイヤーで補完することができます。組織はインテリジェントなguardrailsの実験も行っており、AIエージェントを使用してモデル出力をリアルタイムで継続的に監視および修正しています。ツール面では、オープンソースフレームワークの成長エコシステムが登場しています。NVIDIAのNeMo Guardrailsツールキット、LangChainのGuardrailsライブラリなどは、LLM向けのプログラマブルなルールエンジンを提供します。クラウドプロバイダーも同様に、自社のAIサービス向けに組み込みのモデレーションフィルターやセーフティフィルターを提供しています。一方、より厳格な規制(EUのAI法案など)により、リアルタイムでLLMコンプライアンスを証明できるターンキーguardrailソリューションの需要が高まるでしょう。全体として、guardrailsはAI開発ライフサイクルにさらに深く統合され、高度なNLP検出器、コンテキストを考慮したポリシー、検証可能な監査ログを組み込んで、エンタープライズAIの導入を強力かつ安全に保つことが期待されます。
AI guardrailsは、高度なLLMを予測不能な実験から、信頼性とコンプライアンスを備えたエンタープライズツールへと変化させるために不可欠です。すべてのAIリクエストを入力チェックと出力チェックで挟み込むことにより、TrueFoundryのAI Gatewayは組織がデータプライバシー、コンテンツ基準、規制要件を自動的に強制できるようにします。鍵となるのは、柔軟でポリシー主導のフィルター(PIIマスキング、トピックモデレーションなど)と、リアルタイムの強制(validateまたはmutateアクション)および詳細なログ記録を組み合わせることです。CTOやAIアーキテクトにとって、guardrailsを組み込むことは、信頼性や安全性を犠牲にすることなく生成AIの可能性を解き放つことを意味します。エンタープライズの文脈において、Gatewayレベルの堅牢なguardrailsは責任あるAIの骨格であり、企業が自社のセキュリティ、品質、コンプライアンスのルールに対してすべての応答が審査されている安心感を持って、LLMによる革新を確信を持って進めることを可能にします。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























