


11月 20, 2026
|
5 min read


Published: 11月 20, 2026

Blazingly fast way to build, track and deploy your models!
Opus上のAgentを介してSlackを運用している場合、見逃せない数値があります。高Effort設定のSonnet 4.6に55行のSkillファイルを適用したところ、63個のタスク中56個をクリアしました。達成率は88.9%です。一方、Skillなしの高Effort設定のOpus 4.8も63個中56個をクリアしました。Sonnetの実行コストが$4.28であったのに対し、Opusのコストは$6.81でした。タスク処理時間の中央値においても、Sonnetの方が12%高速でした。
そのため、Opusに同じファイルを提供すれば、さらに大きな成果が得られると考えるのが自然です。実際に検証を行いました。Skillを適用したOpusは63個中55個のクリアにとどまりました。当初90%を超える成功率を示していたFable 5は、85.7%まで低下しました。あるプロンプトにおいて、OpusはSkillなしで3回中3回成功していたものが、Skillありでは3回中0回成功となりました。その失敗理由は明確です。チャンネルメンバーのリストを取得してユーザーIDを返したところで処理を停止してしまいました。ファイル内に「呼び出しを1回行ったら停止する」と記載されていたためです。同じ記述を読み込んだSonnetは、そのまま名前の検索を継続しました。
これが結果全体の傾向を示しています。Skillの価値は、それが補う不備の大きさに一致します。小規模なモデルでは補うべき不備が大きいため、簡潔なインデックスによってその大部分が解消され、何も適用しない大型モデルよりも低いコストで成果を上げることができます。性能上限に近いモデルでは補うべき不備が少ないため、混乱しやすいケース向けに書かれたルールが、最も必要性の低いモデルによって厳密に守られてしまう結果となります。
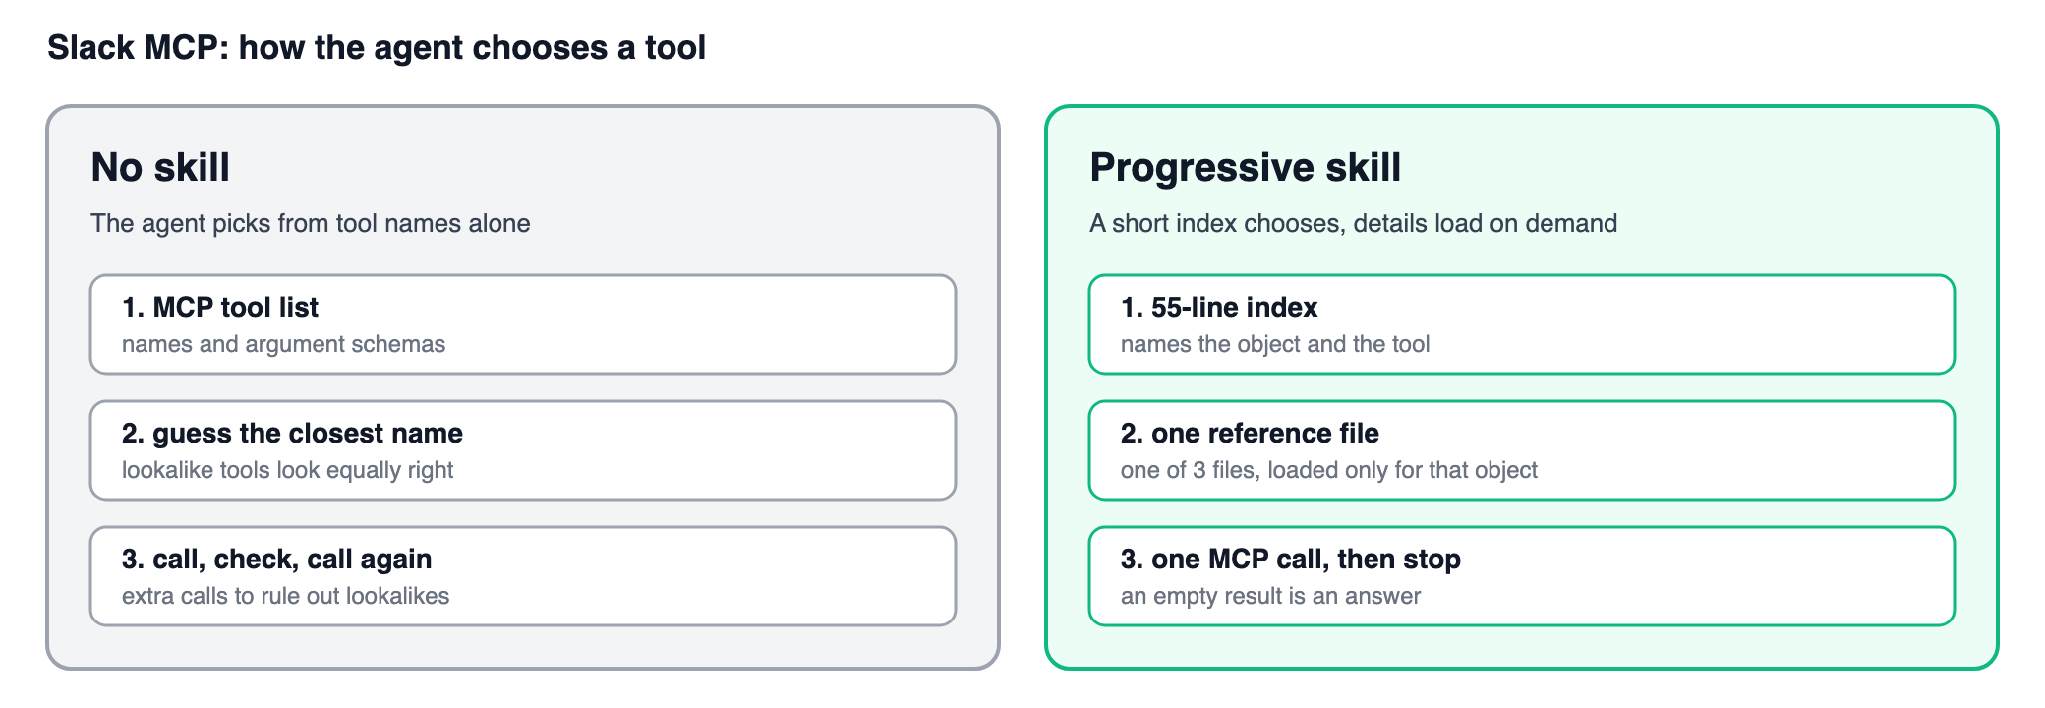
チームが1つのMCPサーバーでSkillによる精度の向上を確認すると、2つの思い込みが生じがちです。第1に、指示を追加することにデメリットはないため、ルールを広範に記述してすべてのモデルに読み込ませるべきだという考えです。第2に、指示に従う能力が最も高いため、最高のモデルが最も恩恵を受けるという考えです。Slackの検証結果は、この両方を否定しています。
第1の思い込みが誤りである理由は、Skillはモデルに識別能力が欠けていた場合にのみ有効であるためです。Slackのツールの大部分は容易に区別できます。送信、下書き作成、スケジュール設定はツール名で明確に分かれており、優れたモデルは指示がなくてもほぼ毎回正しく選択できました。ツールリスト自体がすでに機能を果たしている場合、Skillによって精度が向上することはありません。モデルにとって不要なルールが加わるだけであり、そのルールが厳格に適用されすぎてしまうリスクが生じます。
第2の思い込みも、逆の視点から同じ理由で否定されます。指示に最もよく従うモデルとは、本来役立つアクションを実行しようとしていたまさにその瞬間に、「1回呼び出したら停止する」という指示を最も忠実に守ってしまうモデルでもあります。Opusは指示がなくてもすでに自力でメンバー名を検索していました。Fableも指示なしでDMフィルターをクリアしていました。Skillはどちらのモデルにも新しい情報をもたらしませんでした。大まかなルールを与えられた結果、自力で判断させるよりも直訳的に指示に従ってしまいました。
コストに関する問題は、その内側にあります。問題は、Skillがそれに費やすトークンに見合う価値があるかどうかではありません。Skillを適用したAgentは、入力トークンをわずかに抑え、呼び出し回数を約3分の1削減したため、ファイル自体のコストは十分に回収できました。重要なのは、そもそもどのモデルが必要かという点です。55行のインデックスによってSonnetがOpusと同等の成果を出せるのであれば、Skillは実行時のトークンを節約しただけでなく、ワークロードに必要なモデルそのものを変化させたことになります。
具体例。 「mcp-gatewayのメンバーは誰ですか?」という問いに対し、メンバーリストはユーザーIDを返します。適切な回答をするには、それらのIDを検索して名前を提示する必要があります。Skillなしの高Effort設定のOpus 4.8は、3回中3回成功し、メンバーを一覧表示した後にプロフィールを読み込んで名前で回答しました。同じモデル、同じプロンプトにSkillを適用したところ、3回中0回の成功となりました。ある試行ではチャンネルを検索し、メンバーを2回一覧表示して停止しました。回答は名前のないユーザーIDのみでした。同じSkillを適用したSonnet 4.6は3回中3回成功し、名前の検索を完了させました。
数値データ。 21個のSlackタスク、6種類のClaude設定、各3回の実行を実施しました。すべてのモデル全体で、精度は83.3%から86.5%に向上しました。高Effort設定において、Skillを適用したSonnetは66.7%から88.9%に向上し、SkillなしのOpusと同じスコアを達成しました。コストはOpusの$6.81に対して$4.28でした。Skillを適用したOpusは87.3%でした。中Effort設定では、Sonnetが74.6%から84.1%に向上し、Opusは87.3%を維持しました。Fableは両方の設定で90%以上から85.7%に低下しました。これは63回中3〜4回の減少であり、数値としての確実性は低いものの、特定の失敗事例は明確に確認されています。タスクあたりのツール呼び出し回数は2.52回から1.71回に減少しました。ベンチマーク全体のコストは$46.10から$44.01に減少しました。
得られた学び。 Skillをモデルに合わせて最適化した後、不要なルールを削ぎ落とします。Skillはモデルに識別能力が欠けていた箇所(サーバーにない機能、検索範囲、ユーザーが明記した書き込みなど)で効果を発揮します。ツール名だけで選択肢が明確な場合、優れたモデルは自力で正解に達するため、大まかなルールを設定すると完了できたはずの作業を中断させてしまう可能性があります。発生し得る混同に合わせて各ルールを具体的に記述し、新しいルールは最も優れたモデルでテストしてから本格運用してください。
Linearのテストと同じ設計を採用し、変更した変数は1つのみです。
タスク。 検索範囲、スレッド、下書きとスケジュール、キャンバス、リスト、アップロード、未対応の機能、同意要求を中心として記述された21個のSlackプロンプト。「決定事項は何ですか?」という問いは、ワークスペース全体の検索、1つのチャンネル内の直近のメッセージ、または1つのメッセージに対する返信のいずれかを指す可能性があります。「これを送信して」という指示は、即時送信、承認待ちの下書き、または翌日送信予定のメッセージを意味する場合があります。「これを作成して」という指示は、キャンバス、リスト、またはファイルを指す可能性があります。これらは通常のSlack処理よりも複雑で、混乱が生じやすいため、検証用タスクとして選定されました。
データ。 Slackのレスポンスは固定された録画データから取得されました。両方の検証条件で同一のデータが使用され、実際のワークスペースに書き込みが行われることはありませんでした。
モデル。 Sonnet 4.6、Opus 4.8、Fable 5を使用し、それぞれ中Effortおよび高Effortで検証しました。6種類の設定でタスクごとに3回ずつ、毎回新規のワークスペースで実行しました。Skillありで378回、Skillなしで378回の実行を行いました。
2つの検証条件。
Skill。 Agentが常に読み込む55行のSKILL.mdインデックスです。オブジェクト、選択のための簡潔な基準、類似ツールの対比表、サーバーで実行できない操作が記載されています。3つの参照ファイル(検索、書き込み、アーティファクト用が各1つ)に引数の詳細が含まれています。一般的なタスクでは、Agentはコンテンツの所在を判断し(特定の場所がないテーマは検索、1つの会話内の最新メッセージはチャンネル履歴、1つのメッセージ配下の返信はスレッド)、チャンネル名をIDに変換し、必要に応じて該当カテゴリの参照ファイルを開き、1回呼び出して停止します。
スコアリング。 適切な順序で正しいツールを選択し、安全ルールを遵守し、正確な最終回答を提供した場合のみタスク合格と判定しました。Skillの有無を知らされていない別のOpus 4.8の評価モデルが回答を採点しました。タスクあたり3回の実行は比較的小規模なサンプルであり、合格チェックの2項目はモデルによる評価であり、プレイバック環境のため実際のAPIレイテンシーは反映されていません。
タスク、Skill、スコアリングルール、再現手順は公開されているmcp-skillbenchリポジトリに収録されています。
全体の精度は83.3%から86.5%へとわずかに変化しました。注目すべき動きはモデルごとの結果に現れています。
モデル別・Effort別の結果。
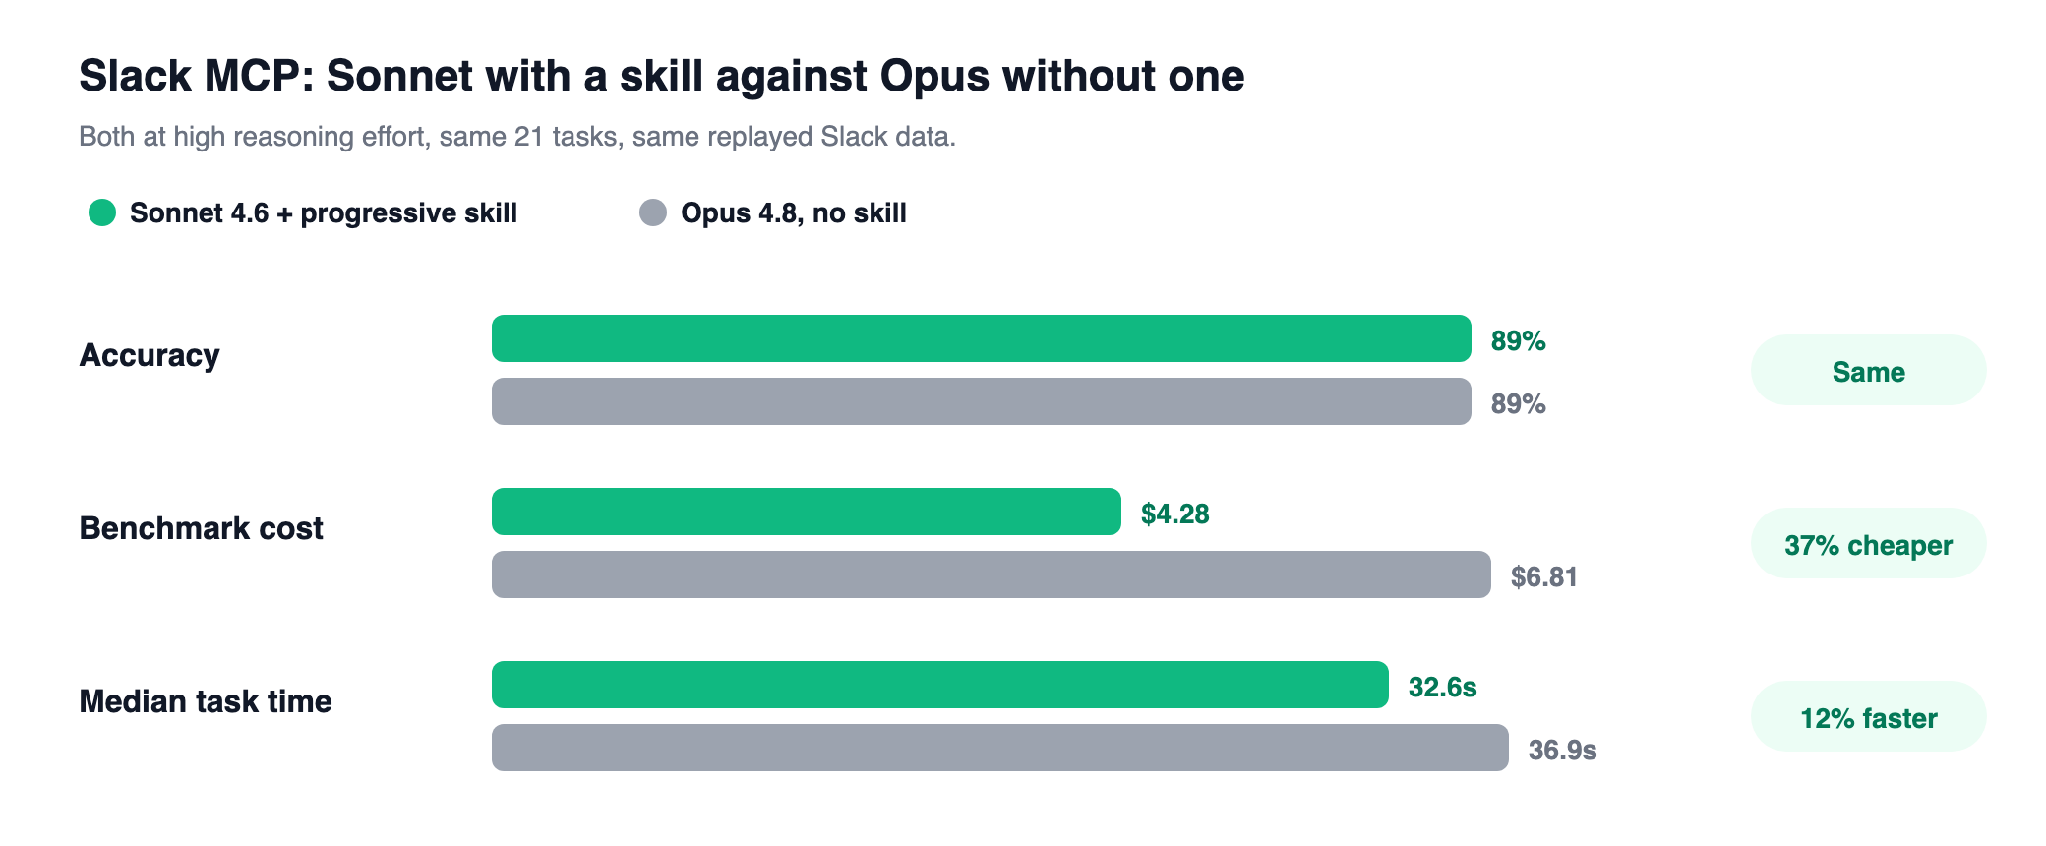
平均値は全体像を反映していません。高Effort設定のSonnetは42/63から56/63へと向上し、SkillなしのOpusと同じスコアを達成しました。コストは$6.81に対して$4.28となり、タスク時間の中央値は36.9秒に対して32.6秒でした。遅延が極端に大きいケースでは依然としてOpusが優位でした。Fableの低下は各設定で63回中3〜4回の範囲であり、性能の上限に近い領域ではノイズの影響も考えられます。以下の具体的な失敗事例は明確です。低下の正確な影響範囲については不確実性が残ります。
Skillがない状態でも、Agentは明確なツールの組み合わせに対して高い信頼性を示していました。送信・下書き・スケジュールの選択、リアクションの追加、自身のチャンネル一覧の取得などは、どちらの条件でもほぼ常に正しく動作しました。一部のタスクでは差が生じ、そこで小型モデルの改善が見られました。
これらの動作を支えるインデックスの記述は簡潔です。
1つのプロンプトに対して4回の実行を行いました。「mcp-gatewayのメンバーは誰ですか?」という問いに対し、メンバーリストはユーザーIDを返します。適切な回答をするには、それらのIDを検索して名前を提示する必要があります。全試行を高Effortで実施しました。各行の唯一の変更点はSkillの有無です。
小型モデルは名前の検索を最後まで実行しました。一方、大型モデルは「1回呼び出したら停止する」というルールに従い、必要な処理を途中で終了してしまいました。
他の2つのプロンプトでも同様の阻害が確認され、いずれも高EffortのFableにおいて成功率が3回中3回から1回に低下しました。「私の許可を得た上で、プライベートチャンネルとDMから__mcp_skill_eval_no_match__を検索してください。」というタスクにおいて、プライベートを含む検索がどちらの条件でも適切なツールでした。SkillなしのAgentは、プライベートチャンネル、グループDM、DMを指定するフィルターを適用して合格しました。インデックスには「プライベートチャンネルとDMを含む」と記載されており、Skillを適用した一部の実行ではその記述を文字通りに解釈し、フィルターを除外した上でDMの検索が完了したと出力しました。また、「[1つのメッセージへのリンク]の配下にあるディスカッション全体を読み込んでください。」というタスクにおいて、最初のページには返信の一部しか含まれておらず、Agentはそのページをディスカッション全体として提示することが多くありました。これはどちらの条件でも困難な処理でしたが、Skillの適用によってさらに悪化しました。
いずれの場合も、Agentは適切なツールを保持しているか、完了に必要な検索まであと1ステップの段階にありました。その状態でインデックス内の大まかなルールを適用した結果、自力で判断させる場合よりも厳格に指示に従ってしまいました。
インデックスは小型であり、参照ファイルは必要な場合のみ読み込まれるため、Skillを適用したAgentは非適用の場合よりも入力トークンをわずかに少なく抑えることができました。ツール呼び出し回数は、最短正解パスの1.24回に対し、タスクあたり2.52回から1.71回へと約3分の1減少しました。この削減の大部分はSonnetによるもので、Skillなしの実行では検索、読み込み、再検索を繰り返す傾向がありました。時間の中央値は37.6秒から35.1秒へとやや高速化し、上位5%の低速タスクは約75秒から約65秒に短縮されました。ベンチマーク全体のコストはSkillありで$44.01、Skillなしで$46.10でした。
高性能モデルで定型的な読み取りを行う場合、Skillは不要です。 AgentがOpusやFableで動作し、主に公開チャンネルの検索や履歴の読み取りを行う場合、ツールリストのみで十分機能します。Skillを導入しても呼び出し回数が多少削減される程度で、精度向上にはつながらず、上限に近いモデルでは試行成績を落とす可能性があります。
中小型モデルを採用する場合や、明確なルールが必要な場合は導入を検討してください。 検索範囲の制御、未対応機能への対処、ユーザーが指定した明らかな書き込み処理などが該当します。高Effort設定のSonnetが66.7%から88.9%に向上した結果が、このSkillを作成した理由です。この段階において、Skillは単なるプロンプト調整の手法ではなく、Opusを採用するかどうかを決定づける要因となります。
作成後は不要なルールを削ぎ落とします。 インデックスはツールの選択基準に絞り、詳細は必要に応じて読み込む構成にし、精度が低下したタスクを分析してください。メンバー一覧の取得後に名前を検索するなど、モデルがすでに正しく実行できていた処理を妨げるルールがある場合は、制限を緩めるか削除してください。短く整理されたSkillの方が忠実に実行されます。これには、適用すべきでなかったケースも含まれます。
新しいルールは、本格運用前に最も優れたモデルでテストしてください。 改善効果は中小型モデルで確認できます。一方、指示のオーバーライドによる問題は最も優れたモデルで顕在化します。
Skillは呼び出されるSlackツールを変更しますが、プライベートチャンネルの検索権限、呼び出しに使用するトークン、ログの記録内容を決定するものではありません。
TrueFoundry Skills Registryは、このようなSkillのバージョン管理と共有を実現します。Skillはプロンプトやモデルと共にリポジトリで管理されます。リポジトリ側で参照・編集・紐付けの権限を制御し、変更履歴と監査ログを保持します。各更新はバージョン番号で管理されるため、リグレッションの原因となったルールを修正した際、すべてのAgentに即座に反映でき、新しいバージョンで問題が生じた場合は前のバージョンに切り戻すことが可能です。同一のバージョンをTrueFoundry Agentに接続することも、Claude CodeやCursorに読み込むことも可能です。今回のSlack用Skillは1つのインデックスと3つの参照ファイルで構成されているため、CLIまたはtfy applyを用いたGitOps経由でまとめて配信されます。
TrueFoundry MCP GatewayはSlack MCPサーバーの前段に位置します。認証、ツールレベルのアクセス制御、すべての呼び出しのトレースログを処理します。オーバーヘッドは約3〜4msであり、1 vCPUで秒間350回以上のリクエストを処理できます。今回のベンチマークはローカルのプレイバック環境で実施されたため、ゲートウェイのパフォーマンス自体を示すものではありません。Skillが呼び出しを選択し、ゲートウェイがその呼び出しの実行可否を決定します。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




Yes. It includes an MCP Gateway, an Agent Gateway, and an MCP and Agents Registry with tool-level access control, so agents from LangGraph, CrewAI, AutoGen, or a custom framework can be governed centrally.








