



novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: novembre 20, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Demandez au responsable d'une plateforme pour combien de LLM distincts son entreprise paie actuellement, et vous obtiendrez généralement un temps d'arrêt, puis une estimation. La réponse honnête est souvent « plus que nous ne le pensons », car n'importe quel ingénieur muni d'une carte de crédit et d'une clé d'API peut intégrer un nouveau modèle dans un service en une après-midi. Chacune de ces intégrations représente une facture séparée, un jeu d'identifiants séparé et un chemin séparé par lequel les données sensibles peuvent quitter l'entreprise, sans qu'aucun d'entre eux ne soit visible depuis un endroit unique.
Un catalogue de modèles est le moyen de contrôle qui comble cette lacune. C'est la réponse unique et gouvernée à la question : « Quels modèles nos équipes sont-elles autorisées à appeler, et selon quelles règles ? » Il ne s'agit pas d'un tableau récapitulatif de fournisseurs approuvés, mais d'une liste appliquée où chaque entrée porte la politique qui lui incombe.
Cet article définit précisément ce qu'est un catalogue de modèles, établit une distinction claire entre un catalogue et un registre de modèles (ils sont constamment confondus), explique pourquoi la dispersion est dangereuse et coûteuse, et montre comment un catalogue implémenté dans une passerelle associe une véritable politique à un nom de modèle logique.
Vous souhaitez un catalogue gouverné de modèles approuvés avec des budgets et des politiques par modèle ? Réservez une démo.
Un catalogue de modèles est un ensemble sélectionné d'entrées de modèles logiques. Chaque entrée comprend deux volets.
Le premier volet est la liaison (binding) : un nom logique (par exemple, summarizer-prod) associé à une ou plusieurs cibles réelles (un fournisseur spécifique, une version de modèle et un point de terminaison). Il s'agit de la même indirection que celle offerte par un nom de modèle logique/virtuel : les applications appellent le nom, pas le fournisseur brut.
Le second volet est la politique rattachée à cette entrée :
Une entrée n'est « dans le catalogue » que lorsque ces deux volets existent. C'est toute la différence entre un catalogue et une simple liste de noms de modèles dans un wiki : le catalogue applique les règles, car la politique accompagne l'entrée et est exécutée à chaque appel.
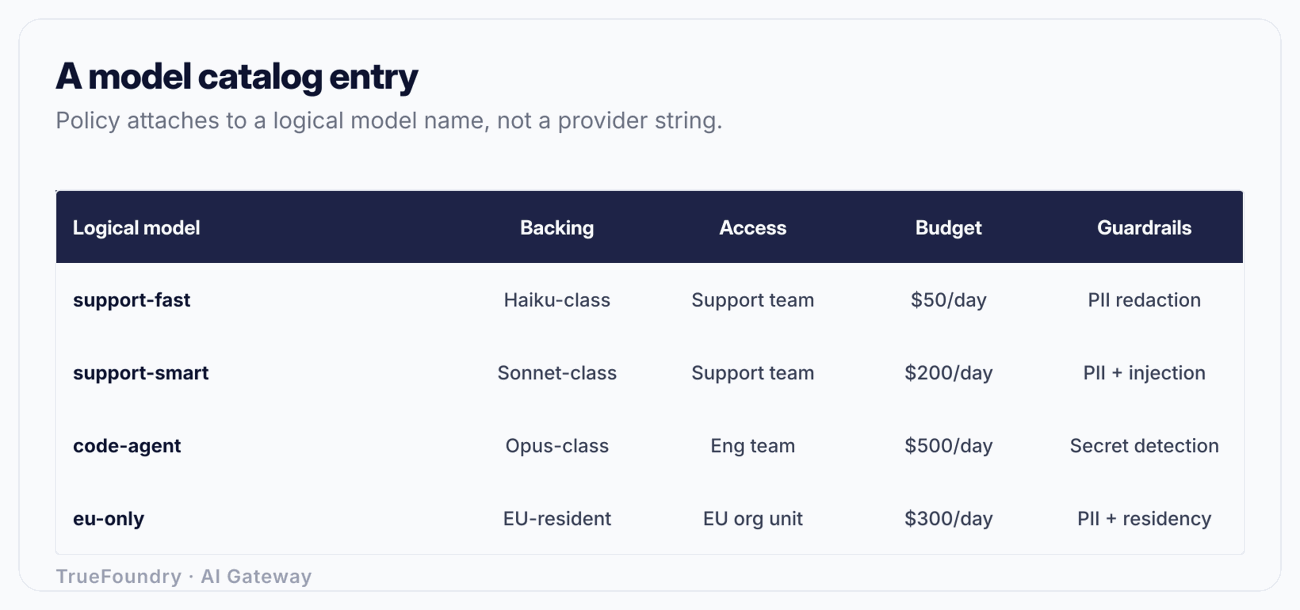
Puisque la politique est liée au nom logique plutôt qu'au code de l'application, sa modification s'effectue en un seul endroit. Réduisez le budget d'une équipe, remplacez la version du modèle sous-jacent, ajoutez un garde-fou PII, et chaque service appelant ce nom logique héritera du changement dès la requête suivante. Aucun redéploiement, aucune recherche de chaînes de caractères de modèles codées en dur dans les référentiels n'est nécessaire.
Il s'agit de la clarification la plus importante de cet article, car ces termes sont souvent utilisés de manière interchangeable alors qu'ils désignent des systèmes totalement différents.
Un registre de modèles (model registry) (à l'image des registres d'artefacts dans l'écosystème d'outils MLOps) gère les artefacts de modèles entraînés. Son unité de base est un modèle que vous avez produit : un ensemble de poids, avec des versions, un lignage remontant à la session d'entraînement et au jeu de données, des métriques et un cycle de vie (staging, production, archivé). Vous utilisez un registre lorsque vos data scientists entraînent des modèles et que vous devez suivre, promouvoir et déployer ces artefacts de manière reproductible.
Un catalogue de modèles gère l'accès aux modèles consommés par vos équipes, dont la plupart n'ont pas été entraînés par vos soins, comme les API LLM tierces et les modèles open-weight que vous hébergez. Son unité de base est une entrée approuvée et liée à une politique. Vous utilisez un catalogue pour contrôler qui peut appeler quel modèle, à quel coût, dans quelle région et sous quels garde-fous.
La confusion est compréhensible car tous deux traitent de « modèles », mais ils répondent à des questions différentes. L'un demande : « Quelle version du modèle de détection de fraude avons-nous déployée, et de quelle session d'entraînement provient-elle ? » L'autre demande : « L'équipe du support client est-elle autorisée à envoyer des données clients à ce LLM, et avons-nous dépassé notre budget ce mois-ci ? » Une plateforme mature intègre souvent les deux, positionnés à des niveaux différents.
S'il ne fallait retenir qu'une chose de cette section : un registre concerne l'offre de modèles que vous construisez ; un catalogue concerne la demande gouvernée pour les modèles qu'utilisent vos équipes. Choisir le mauvais outil pour un problème de gouvernance vous laissera avec un stockage d'artefacts parfaitement versionné, mais sans aucun contrôle sur la facture OpenAI.
Sans catalogue, l'usage des modèles croît de manière organique, ce qui semble bénéfique en apparence mais constitue en réalité le problème. Trois modes de défaillance en découlent et se cumulent.
Les modèles fantômes (shadow models). Un ingénieur ajoute un nouveau fournisseur pour déployer une fonctionnalité. Cela fonctionne, donc l'intégration reste. Personne ne l'a approuvée, la sécurité ne l'a jamais examinée et elle ne figure dans aucun inventaire. Multipliez cela par le nombre d'équipes sur une année, et vous obtenez un parc d'intégrations inconnues, chacune constituant une voie potentielle d'exfiltration de données, qu'aucune personne seule ne peut énumérer. On ne peut gouverner ce que l'on ne voit pas.
Les factures surprises. Lorsque chaque service détient sa propre clé d'API, les dépenses sont réparties sur les factures des fournisseurs sans balises (tags) communes. La facture mensuelle arrive sous la forme d'un montant global élevé, et personne ne peut répondre à la question « Quelle équipe est responsable de cette augmentation de 40 % ? » sans mener une enquête approfondie. Un coût qui ne peut être attribué ne peut être contrôlé, ce qui constitue le principe même du FinOps pour l'IA.
Les failles de conformité. C'est le problème qui met fin aux carrières. Une intégration non gouvernée envoie les données de clients européens vers un modèle s'exécutant dans une région US, violant ainsi un engagement de résidence des données. Ou encore, des prompts bruts contenant des PII atteignent un fournisseur sans aucun caviardage sur le parcours. Ou une application fuite un secret dans un prompt, enregistre ensuite côté fournisseur. Chaque faille existe parce qu'il n'y avait aucun point d'application entre l'application et le modèle.
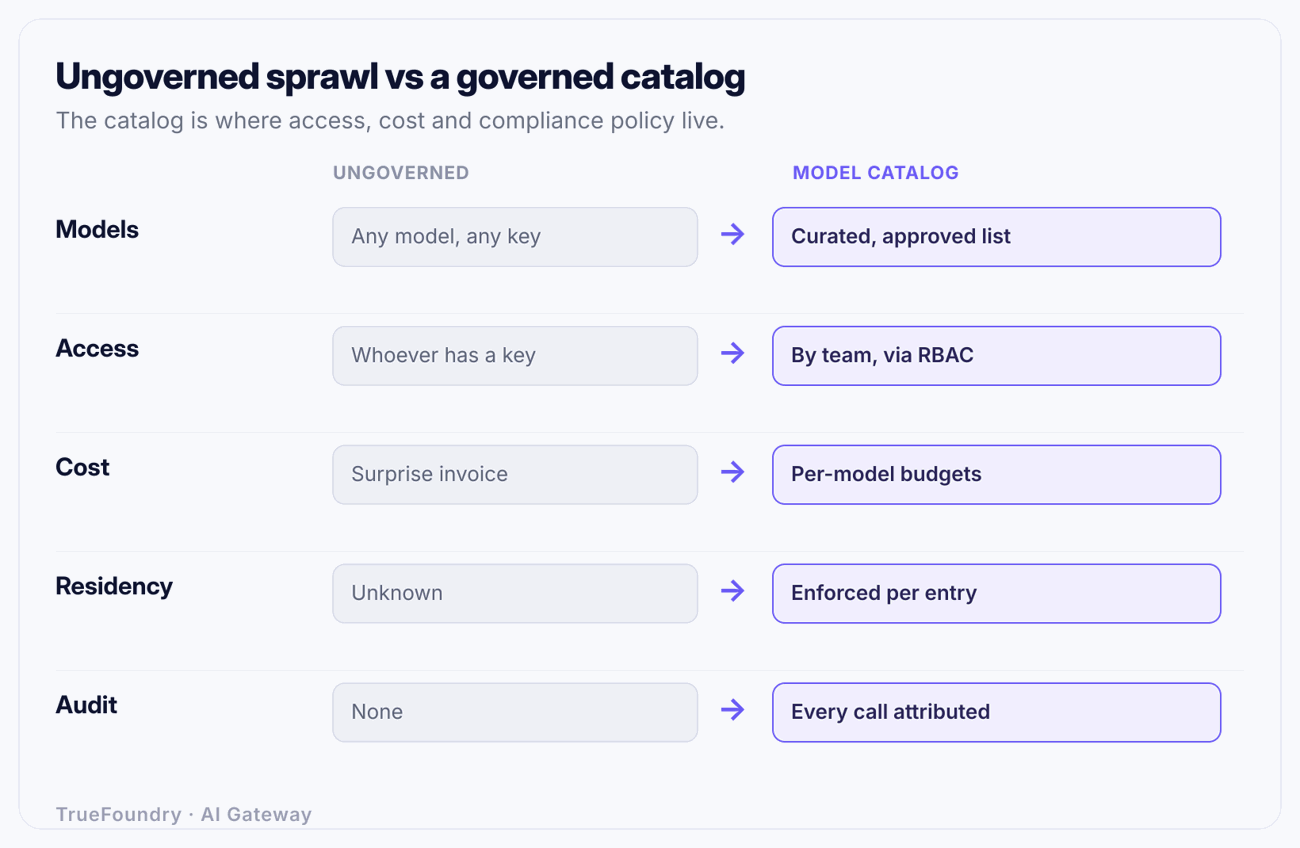
La cause racine commune est l'absence de point de passage obligé. Le câblage direct entre l'application et le fournisseur signifie qu'il n'y a aucun endroit unique pour observer l'utilisation, attribuer les coûts ou appliquer les politiques. Un catalogue, implémenté au niveau d'une passerelle, réintroduit ce point de contrôle sans retirer le choix des modèles aux équipes : elles conservent leur autonomie de choix, mais au sein d'un ensemble approuvé et gouverné.
Découvrez comment TrueFoundry associe des politiques d'accès, de coût et de résidence à chaque modèle. Réservez une démo.
Le catalogue n'est utile que dans la mesure où il est appliqué, et cette application est la raison pour laquelle sa place est dans la passerelle IA plutôt que dans un document. Structurellement, c'est le même point de passage obligé qu'offre un proxy LLM : chaque requête passe par un endroit unique, de sorte que la politique peut être appliquée à chaque appel.
Voici ce qui se produit lors d'une requête unique lorsque le catalogue réside dans la passerelle. Un service appelle le modèle logique support-assistant. La passerelle :
support-assistant. Si ce n'est pas autorisé, la requête est refusée.Chacune de ces étapes se réfère à la politique de l'entrée, et non au code du service appelant. C'est tout l'intérêt. L'application transmet un nom ; la passerelle applique tout ce qui est lié à ce nom. Modifiez la liaison (nouvelle version de modèle) ou la politique (budget réduit, garde-fou ajouté) dans le catalogue, et la requête suivante s'y conformera, sans qu'aucune modification d'application ne soit requise.
Cela fait également du catalogue l'emplacement naturel des contrôles documentés dans l'outillage de gouvernance. Les limites de débit et les budgets sont détaillés dans Limitation du débit de jetons LLM et budgets ; l'attribution qui donne du sens aux budgets est expliquée dans Attribution des coûts LLM et budgets d'équipe ; les contrôles de sécurité figurent dans Garde-fous pour l'IA (Guardrails) ; et l'application de la résidence est couverte dans Résidence des données. Le catalogue est l'endroit où ces politiques sont rattachées à des modèles spécifiques, et il s'intègre dans l'ensemble plus large des Outils de gouvernance de l'IA.
TrueFoundry met en œuvre exactement cela : un catalogue de modèles où chaque nom de modèle logique porte son contrôle d'accès, son budget, ses limites de débit, sa résidence et ses garde-fous, appliqués au niveau de la passerelle à chaque requête, avec une observabilité par requête étiquetée par utilisateur, équipe et modèle. Dans la mesure où le plan de données (data plane) peut s'exécuter dans votre propre VPC, sur site (on-premise) ou dans un environnement isolé (air-gapped), la résidence n'est pas une simple promesse sur un tableau de bord, mais une propriété physique du flux de trafic.
Concrètement, l'entrée pour support-assistant pourrait indiquer : nom logique support-assistant, adossé à une version spécifique du modèle d'un fournisseur ; accès restreint aux équipes Support et CX ; budget de 2 000 USD/mois ; limite de débit de 50 000 jetons/minute par équipe ; résidence ancrée dans l'UE ; garde-fous de caviardage des PII et de détection d'injection de prompts, activés en entrée comme en sortie. Un développeur de l'équipe Support appelle support-assistant et obtient un modèle gouverné sans rien connaître du fournisseur, de la région ou des limites. Un développeur d'une autre équipe appelant le même nom se voit refuser l'accès. C'est l'alliance du libre-service et de la gouvernance.
Voici à quoi ressemble un catalogue restreint mais réaliste. Chaque ligne représente une entrée logique ; les colonnes indiquent la politique qui lui est liée. Les chiffres sont donnés à titre d'illustration.
Consultez n'importe quelle ligne et vous pourrez répondre, pour ce modèle, à toutes les questions de gouvernance : qui, combien, à quelle vitesse, où et avec quel niveau de sécurité. Consultez une colonne et vous pourrez auditer une dimension unique sur l'ensemble des modèles, par exemple : « Quels sont les modèles ancrés dans l'UE ? » Cette lisibilité bidirectionnelle est ce que vous apporte un catalogue, et ce qu'un empilement de clés d'API dispersées ne pourra jamais fournir.
Confondre catalogue et registre. Les équipes mettent en place un registre de modèles, versionnent parfaitement l'ensemble, mais ne parviennent toujours pas à contrôler qui appelle l'API OpenAI ou ce que cela coûte, car un registre gouverne les artefacts que vous entraînez, pas l'accès aux modèles que vous consommez. Identifiez clairement votre problème avant de choisir un outil.
Traiter le catalogue comme une simple liste statique. Une page de modèles approuvés dans un wiki n'est pas un catalogue ; c'est une documentation que personne n'applique. La valeur réside dans l'application des règles à chaque requête. Si la liste ne bloque pas un appel non autorisé ou un prompt qui viole les règles de résidence, il s'agit d'une suggestion, pas d'un contrôle.
Rattacher la politique au code de l'application plutôt qu'au nom du modèle. Coder en dur un contrôle de budget ou une région dans chaque service crée une politique dispersée, incohérente, non auditable, qui dérive dès que quelqu'un oublie de l'ajouter. Liez la politique au modèle logique dans le catalogue afin que chaque appelant en hérite et que les modifications se propagent à partir d'un seul endroit.
Gouverner les coûts mais négliger les données. Les budgets et les limites de débit représentent la partie la plus simple. Les échecs les plus coûteux sont ceux liés à la conformité : des données qui traversent une région non autorisée, des PII qui atteignent un fournisseur sans caviardage. Un catalogue qui contrôle les dépenses mais néglige la résidence et les garde-fous laisse subsister des risques majeurs.
Absence d'attribution par requête. Si l'utilisation n'est pas étiquetée par utilisateur, équipe et modèle au moment de l'appel, les budgets deviennent inapplicables et la facture mensuelle reste un mystère. L'attribution doit se faire là où le trafic circule, au niveau de la passerelle, et non être reconstruite après coup à partir des factures des fournisseurs.
Un catalogue de modèles transforme la question « Quels modèles sommes-nous autorisés à utiliser, et selon quelles règles ? » — autrefois sans réponse claire — en une liste gouvernée et appliquée. Chaque entrée est un nom de modèle logique portant son propre contrôle d'accès, son budget, ses limites de débit, sa résidence et ses garde-fous. Comme la politique est liée au nom, vous la modifiez à un seul endroit et chaque appelant s'y conforme. Point fondamental, un catalogue n'est pas un registre de modèles : l'un gouverne l'accès aux modèles que vous consommez, l'autre versionne les artefacts que vous entraînez.
La raison de l'implémenter au sein d'une passerelle réside dans l'exécutoire des règles. Une liste dans un wiki exprime une intention ; un catalogue situé au point de passage obligé de chaque requête refuse concrètement les appels non autorisés, limite les équipes hors budget, maintient les données européennes au sein de l'UE et caviarde les PII avant qu'elles ne sortent. C'est ainsi que vous offrez aux équipes un accès en libre-service aux modèles tout en conservant le contrôle des coûts, des accès, de la résidence et de la sécurité, au lieu de découvrir les failles sur une facture ou lors d'un audit.
Gouvernez les modèles que vos équipes peuvent utiliser depuis un catalogue unique. Réservez une démo.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





