



novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: novembre 20, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Prenez presque n'importe quel produit LLM lancé au cours des trois dernières années et inspectez son API. Il y a de fortes chances qu'il accepte une requête avec un champ model, un tableau messages d'objets {role, content}, et temperature, et qu'il renvoie un tableau choices avec un bloc usage comptant les tokens. Cette structure ne provient pas d'un organisme de normalisation. Elle provient de l'API Chat Completions d'OpenAI, et elle s'est imposée.
Pour une équipe plateforme, « compatible OpenAI » est une expression fondamentale. C'est la raison pour laquelle vous pouvez évaluer un nouveau modèle open-weight le vendredi et le mettre en production le lundi sans réécrire votre application. C'est aussi une expression qui promet parfois un peu trop : deux points de terminaison peuvent être tous deux « compatibles OpenAI » et pourtant ne pas s'accorder sur la façon dont les appels d'outils (tool calls) sont retournés, dont les tokens sont comptés, ou sur le fait que le paramètre défini produise réellement un effet.
Cet article explique ce qu'est réellement ce standard, ce que la « compatibilité » garantit et ce qu'elle ne garantit pas, et comment une passerelle transforme plusieurs fournisseurs partiellement compatibles en un point de terminaison unique sur lequel vous pouvez vous appuyer en toute confiance.
Vous souhaitez un point de terminaison unique compatible OpenAI pour tous vos fournisseurs, avec failover et suivi des coûts ? Réservez une démo.
Les standards s'imposent généralement pour l'une des deux raisons suivantes : ils sont imposés, ou ils arrivent en premier et sont adoptés avant que quiconque ne conçoive une alternative. Le schéma Chat Completions appartient clairement à la seconde catégorie.
OpenAI a publié le point de terminaison /v1/chat/completions et, ce qui est crucial, a fourni des SDK officiels Python et JavaScript qui l'enveloppaient. Ces SDK ont été intégrés dans des tutoriels, des modèles de démarrage, des intégrations de frameworks et des bases de code en production à travers toute l'industrie. Au moment où les fournisseurs concurrents ont proposé des modèles valant la peine d'être exploités, la surface d'intégration était déjà standardisée en pratique : des millions de lignes de code savaient déjà comment appeler client.chat.completions.create(...).
Un nouveau fournisseur était alors confronté à un choix. Définir sa propre API élégante et demander à tout l'écosystème de l'apprendre, ou implémenter le schéma d'OpenAI et hériter gratuitement de chaque SDK, framework et outil. Presque tout le monde a choisi la deuxième voie. Les piles d'exécution open-weight l'ont adopté afin que tout ce qui s'y exécute soit instantanément accessible depuis le code existant. Le résultat est un standard de fait sans document de normalisation officiel : le schéma est « tout ce que le SDK OpenAI envoie et attend en retour ».
C'est pourquoi cette formule importe plus qu'il n'y paraît. La compatibilité n'est pas une fonctionnalité qu'un fournisseur ajoute pour peaufiner son offre. C'est le billet d'entrée dans un écosystème, et elle façonne la manière dont vous pouvez concevoir votre architecture autour du choix des modèles.
Si l'on résume, la compatibilité est un contrat portant sur quatre éléments : le point de terminaison, la structure de la requête, la structure de la réponse et le streaming.
Le point de terminaison. Un service compatible accepte POST /v1/chat/completions avec un en-tête Authorization: Bearer <key>. Beaucoup implémentent également /v1/models, /v1/embeddings et /v1/completions. L'URL de base change selon le fournisseur ; le chemin ne change pas.
La structure de la requête. Au minimum : une chaîne model et un tableau messages d'objets comportant un rôle role (system, user, assistant, tool) et un contenu content. Les paramètres optionnels que le client peut envoyer incluent temperature, top_p, max_tokens (les modèles OpenAI plus récents utilisent max_completion_tokens), stream, stop, tools, tool_choice et response_format.
La structure de la réponse. Un objet JSON avec un tableau choices ; chaque choix possède un index, un message avec role et content (et tool_calls lorsque le modèle appelle une fonction), ainsi qu'un finish_reason (stop, length, tool_calls, content_filter). Un objet usage indique prompt_tokens, completion_tokens et total_tokens.
Le streaming. Avec stream: true, la réponse est un text/event-stream d'événements envoyés par le serveur (SSE). Chaque ligne data: transporte un morceau (chunk) dont le choices[].delta contient le ou les tokens incrémentaux. Le flux se termine par une valeur littérale data: [DONE].
Voici le bénéfice concret. Ce corps de requête cible OpenAI :
POST https://api.openai.com/v1/chat/completions
Authorization: Bearer sk-...

{
  "model": "gpt-4.1",
  "messages": [
    {"role": "system", "content": "You are a terse assistant."},
    {"role": "user", "content": "Summarize MCP in one sentence."}
  ],
  "temperature": 0.2,
  "stream": false
}
Pour exécuter le même prompt auprès d'un autre fournisseur via un point de terminaison compatible, vous modifiez deux choses : l'URL de base et la valeur de model. Les champs messages, temperature et stream restent inchangés. Votre code de parsing, qui lit choices[0].message.content et usage.total_tokens, ne change pas du tout. C'est toute la proposition de valeur en un seul diff : le choix du modèle devient une simple chaîne de caractères, pas une réécriture.
La réponse, quel que soit le backend qui l'a servie, revient sous la forme :
{
  "id": "chatcmpl-...",
  "choices": [
    {"index": 0,
     "message": {"role": "assistant", "content": "MCP is an open protocol..."},
     "finish_reason": "stop"}
  ],
  "usage": {"prompt_tokens": 24, "completion_tokens": 18, "total_tokens": 42}
}
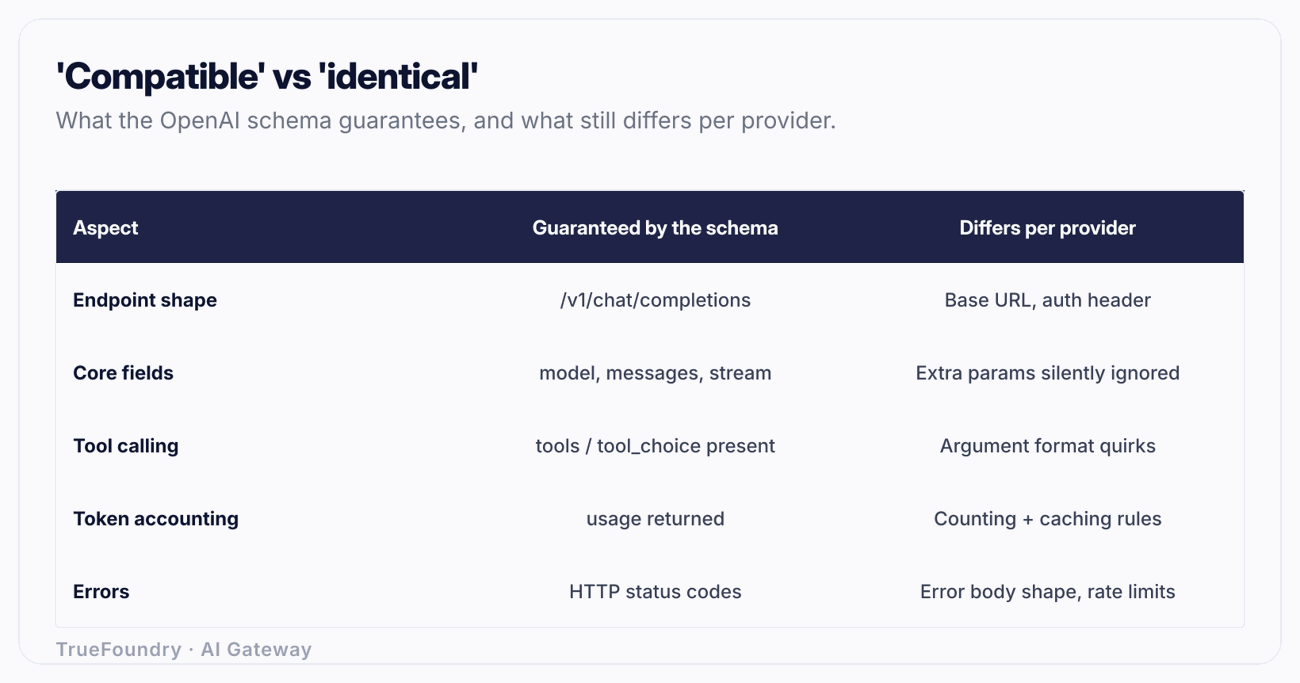
C'est ici que les équipes rencontrent des difficultés. « Compatible OpenAI » est une affirmation concernant le schéma, pas une garantie de comportement identique. La structure globale correspond ; le contenu peut différer de façons qui ne font surface que sous la charge ou dans des cas limites.
Les dialectes d'appels d'outils (tool-calling). C'est la plus grande divergence. OpenAI renvoie les appels de fonction dans message.tool_calls, chacun avec un id, un type et un objet function dont le arguments est un bloc JSON transformé en chaîne de caractères que vous devez parser. Certains backends compatibles renvoient les arguments sous la forme d'un objet déjà parsé, émettent l'ancien champ unique function_call, envoient les deltas d'appels d'outils différemment en mode streaming, ou gèrent les appels d'outils parallèles de manière incohérente. Le code qui applique aveuglément JSON.parse sur les arguments lèvera une erreur sur un backend qui les a déjà parsés.
Le décompte des tokens. Les décomptes de usage sont calculés par le propre tokenizer de chaque fournisseur. Le même prompt envoyé à deux modèles donne des valeurs de prompt_tokens différentes parce que les tokenizers diffèrent. Pire, certains backends omettent complètement usage dans les réponses en streaming à moins que vous ne définissiez un paramètre spécifique, de sorte que le suivi des coûts basé sur ce champ affiche silencieusement zéro.
Paramètres ignorés en silence. Vous pouvez envoyer seed, logit_bias, frequency_penalty, presence_penalty ou response_format: {type: "json_schema"} à un point de terminaison compatible et recevoir un 200 OK en retour, alors que le paramètre est complètement ignoré. Le point de terminaison a accepté le champ parce que le schéma l'autorise ; le backend ne l'implémente tout simplement pas. C'est la catégorie de bug la plus pernicieuse car aucune erreur n'est levée. Votre pipeline « déterministe » qui s'appuie sur seed devient silencieusement non déterministe.
Gestion des prompts système et des rôles. Certains backends intègrent le message system dans le premier tour de l'utilisateur, ou ne prennent en charge qu'un seul message système, ou traitent un content vide différemment. Le comportement multi-tours peut ainsi dériver.
Sémantique de la raison de fin (finish-reason). Lorsqu'un modèle s'arrête parce qu'il souhaite appeler un outil, OpenAI indique finish_reason: "tool_calls". Les backends n'utilisent pas tous la même chaîne de caractères, ce qui casse les boucles d'agents qui effectuent des branchements conditionnels sur cette valeur.
Le tableau ci-dessous sépare ce que le standard vous garantit de manière fiable de ce que vous devez vérifier pour chaque fournisseur.
Ce qu'il faut en retenir, ce n'est pas que « la compatibilité est illusoire ». C'est plutôt que « la compatibilité vous offre 90 % du travail gratuitement et vous devez tester les 10 % restants pour chaque fournisseur ». Ces derniers 10 % représentent précisément le travail qu'une passerelle peut absorber afin que votre application n'ait jamais à s'en soucier.
Découvrez comment TrueFoundry vous permet de changer de modèle par son nom sans toucher au code applicatif. Réservez une démo.
Si chaque fournisseur est principalement compatible mais subtilement différent, la bonne architecture consiste à ne plus faire interagir votre application directement avec chaque fournisseur. Placez un point de terminaison unique compatible OpenAI devant eux et laissez cette couche gérer la traduction et la normalisation.
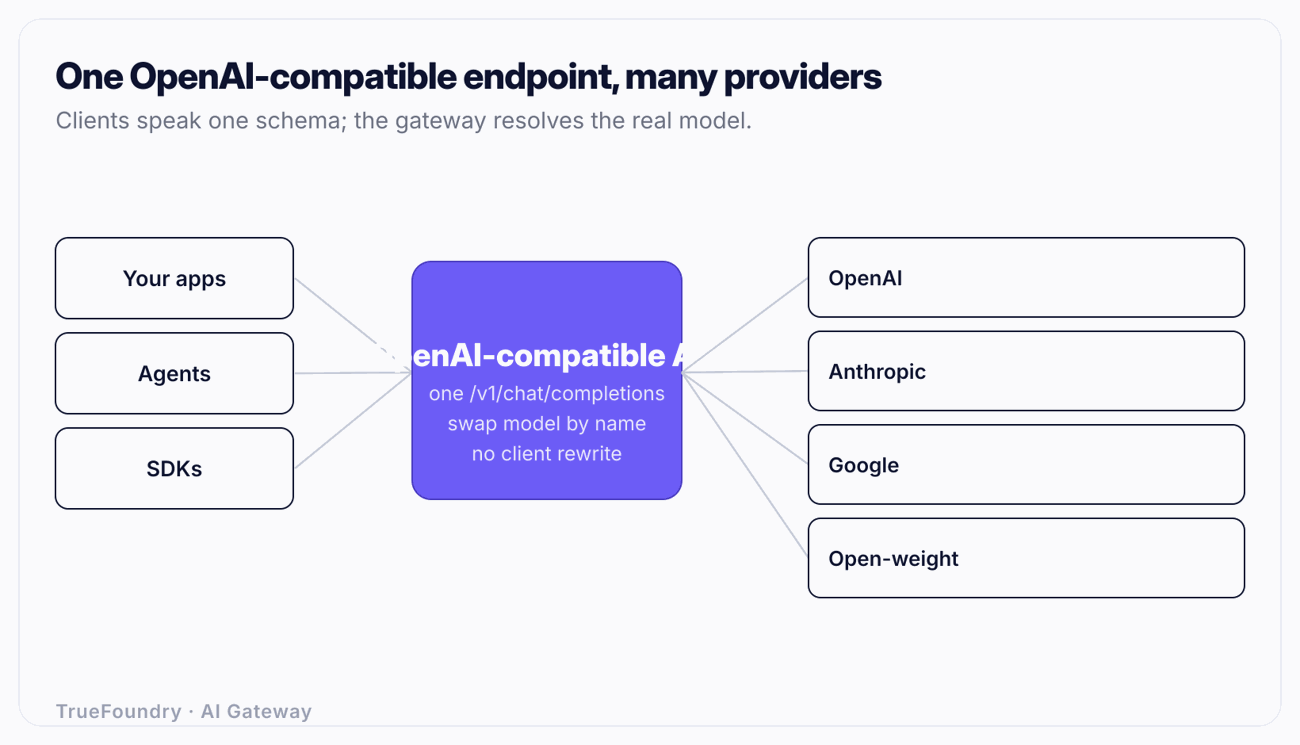
C'est ce que fait une passerelle IA (AI gateway), et c'est structurellement la même idée qu'un proxy LLM : un guichet d'entrée logique unique, de nombreux backends derrière lui. TrueFoundry expose une API unifiée compatible OpenAI devant chaque fournisseur. Votre application continue d'envoyer la structure Chat Completions qu'elle connaît déjà. Pour changer de modèle, vous modifiez la valeur de model pour la remplacer par un nom logique résolu par la passerelle ; tout le reste (corps de la requête, SDK, parsing) reste constant.
Comme la passerelle normalise les différences décrites ci-dessus, votre code n'a plus à se soucier de savoir si un backend donné transforme les arguments d'appels d'outils en chaînes de caractères ou indique usage sur les flux. La passerelle présente un dialecte homogène. Les bibliothèques open source comme LiteLLM ont popularisé cette couche de traduction dans le code ; notre article expliquant ce qu'est LiteLLM couvre cette approche et montre jusqu'où va une passerelle gérée.
Mais l'intérêt d'adopter ce modèle ne réside pas seulement dans une interface propre. Dès lors que chaque requête passe par un point de terminaison unique, vous débloquez des fonctionnalités qu'il est impossible d'ajouter à des intégrations dispersées par fournisseur :
Routage. Un nom de modèle logique peut être adossé à plusieurs cibles réelles, et la passerelle choisit entre elles en fonction de la latence, du poids ou de la priorité. Consultez notre article sur ce qu'est un routeur LLM pour une sélection de modèles basée sur le coût et la qualité.
Fallback (basculement). Si un fournisseur renvoie une erreur 500 ou expire, la passerelle réessaie au cours de la même requête vers une cible de secours, de sorte qu'une panne chez un seul fournisseur ne se transforme pas en erreur pour votre utilisateur. C'est le sujet abordé dans notre article sur le fallback LLM.
Mise en cache. La mise en cache exacte et la mise en cache sémantique au niveau de la passerelle réduisent à la fois la latence et les dépenses pour les prompts répétés ou quasi-identiques, de manière transparente, derrière le même point de terminaison.
Observabilité et imputation des coûts. Comme chaque requête passe par un seul endroit, vous obtenez des métriques de coût, de tokens et de latence par requête, étiquetées par utilisateur, équipe et modèle, alimentant l'observabilité des LLM et l'imputation des coûts aux budgets d'équipe. Une intégration directe par fournisseur ne vous apporte rien de tout cela sans une instrumentation sur mesure pour chacun d'eux.
Rien de tout cela ne vous a obligé à adopter une nouvelle API. Ces avantages découlent de la standardisation sur l'interface unique que vous utilisez déjà. Si vous évaluez vos options, notre guide sur comment choisir une passerelle IA en détaille les critères.
Ce choix n'est pas une question de dogme ; il dépend du nombre de fournisseurs avec lesquels vous interagissez et de l'importance que vous accordez à la résilience et à la visibilité des coûts.
L'intégration directe se justifie lorsque vous faites appel à un seul fournisseur et que vous n'en utiliserez jamais d'autre. Dès que vous souhaitez un second modèle, une résilience face aux pannes ou une source unique de vérité pour les coûts, la passerelle devient rentable.
Supposer que compatible signifie identique. Le schéma correspond ; le comportement ne correspond pas toujours. Les équipes réorientent un prompt vers un backend moins cher, constatent que cela « fonctionne » et déploient en production, pour découvrir des semaines plus tard que seed a été ignoré et que les sorties n'ont jamais été reproductibles. Testez les paramètres dont vous dépendez réellement sur chaque backend.
Faire confiance àusagepour les coûts sans vérifier le streaming. Plusieurs backends omettent le bloc usage sur les réponses en streaming à moins que cela ne soit explicitement demandé. Les tableaux de bord de coûts basés sur ce champ indiquent zéro et semblent parfaits jusqu'à ce que la facture réelle arrive. Vérifiez que les données d'utilisation sont présentes sur le type exact de requête que vous exécutez en production.
Encoder en dur l'URL de base et le SDK par fournisseur. Cela recrée la dispersion que le standard était censé éliminer. Chaque nouveau modèle devient un projet d'intégration et chaque panne de fournisseur devient votre propre panne. Standardisez sur un point de terminaison unique et faites du choix de modèle un élément de configuration, pas du code.
Parser les arguments d'appels d'outils sans vérifier le format. Certains backends renvoient arguments sous forme de chaîne de caractères, d'autres sous forme d'objet. Une utilisation aveugle de JSON.parse lèvera une erreur dans ce dernier cas. Normalisez la structure avant le parsing, ou laissez une passerelle le faire pour vous.
Traiter la passerelle comme un simple composant technique. Le point de terminaison est la partie facile. La vraie valeur réside dans ce qu'un point de passage unique permet : routage, failover, mise en cache, budgets et attribution des coûts, qu'il est impossible d'ajouter à moindre coût sur N intégrations directes.
Le schéma Chat Completions d'OpenAI est devenu la norme non pas par décret, mais parce qu'il est arrivé le premier et a été adopté partout. Être « compatible OpenAI » est le passeport pour entrer dans cet écosystème : envoyez la structure de requête habituelle, parsez la réponse habituelle. Cela vous offre un levier formidable — le choix du modèle devient une simple chaîne de configuration — à condition de garder en tête que compatible ne veut pas dire identique et de tester les comportements dont vous dépendez réellement.
La manière la plus propre d'obtenir cet avantage sans les inconvénients consiste à vous standardiser sur un point de terminaison unique compatible OpenAI devant chaque fournisseur. Votre application conserve l'interface qu'elle connaît déjà, et la passerelle absorbe les particularités de chaque fournisseur tout en ajoutant le routage, le failover, la mise en cache, les budgets et l'imputation des coûts qu'il serait impossible de greffer sur des intégrations dispersées. Une seule interface en entrée ; tous les modèles derrière.
Unifiez chaque fournisseur de LLM derrière une API unique compatible OpenAI. Réservez une démo.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





