



novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: novembre 20, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
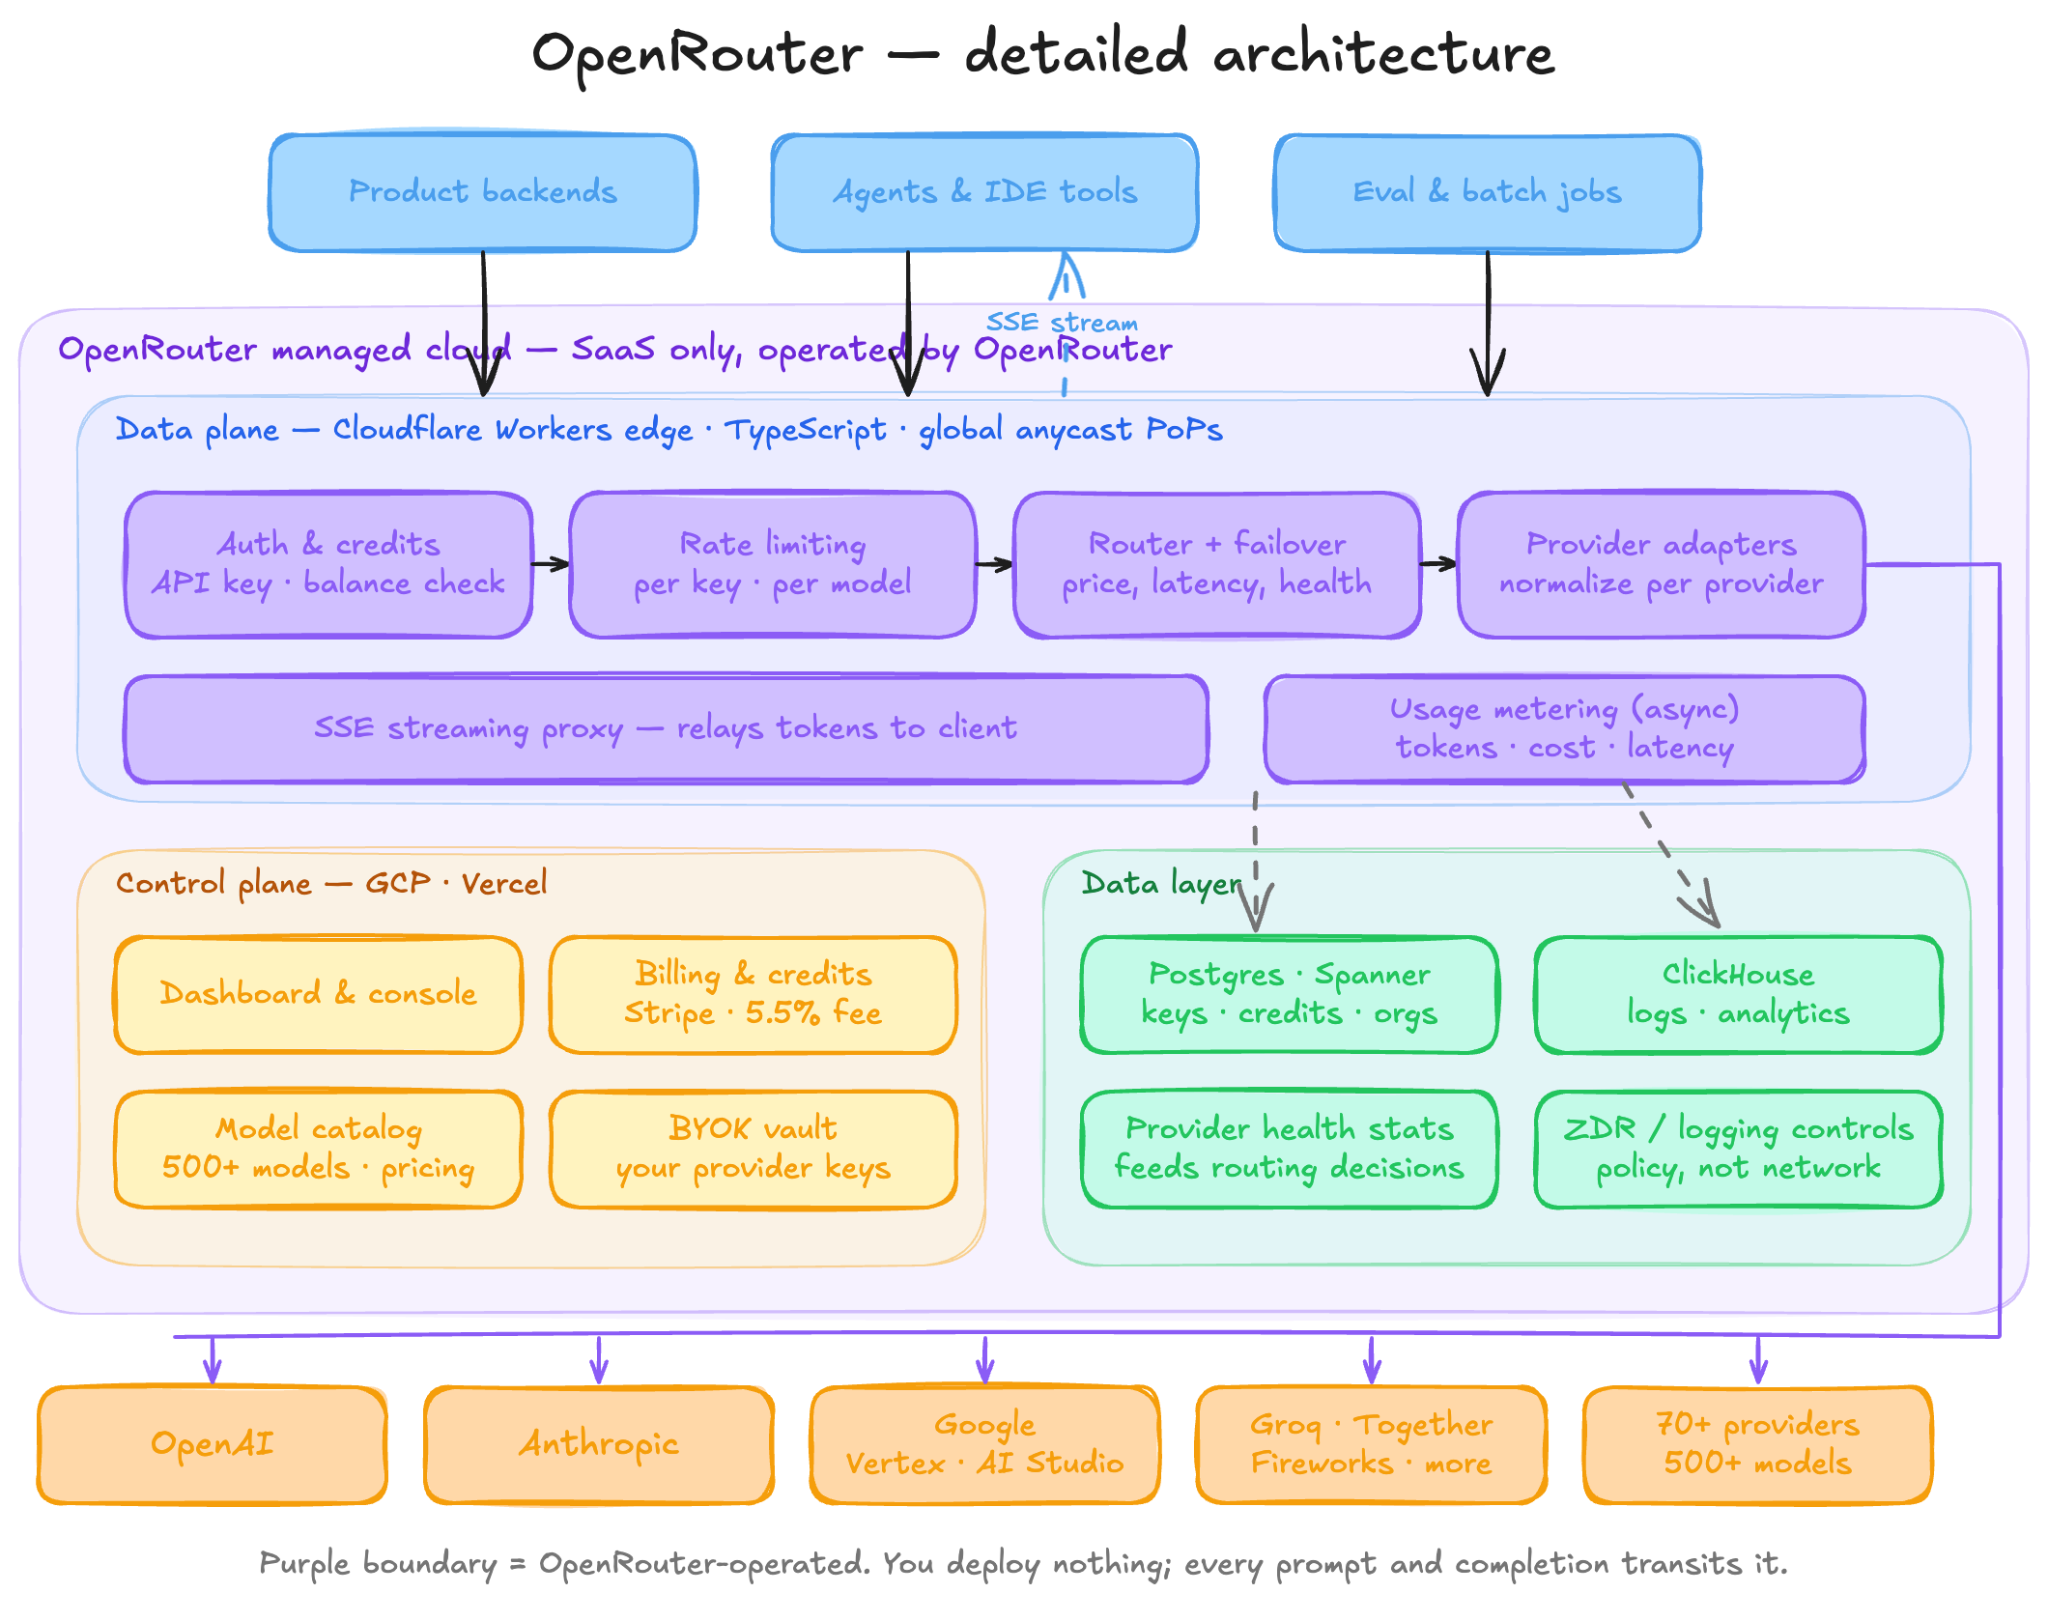
OpenRouter est un routeur SaaS géré ne disposant d'aucune édition auto-hébergée, VPC ou sur site (on-premise) à aucun niveau, et chaque prompt que vous lui envoyez quitte votre réseau. Ce n'est pas une critique du produit ; c'est son architecture. Mais c'est le fait unique qui met fin à la plupart des évaluations d'OpenRouter en entreprise avant même que la comparaison des fonctionnalités ne commence, et c'est la raison pour laquelle les équipes plateforme et sécurité finissent par le comparer à une AI gateway qu'elles peuvent exécuter elles-mêmes.
Cet article s'adresse aux personnes qui doivent répondre à la question « où s'exécute-t-il, et où vont les prompts » : les ingénieurs plateforme qui dimensionnent un déploiement en production, les responsables de la sécurité ayant une exigence de frontière des données, et les architectes qui souhaitent savoir ce que font réellement un plan de contrôle et un plan gateway. Nous comparons le modèle hébergé d'OpenRouter avec les quatre modes de déploiement de TrueFoundry AI Gateway (SaaS géré, SaaS avec votre propre stockage, hybride et entièrement auto-hébergé ou air-gapped), nous détaillons l'architecture qui rend ces modes possibles, et nous expliquons clairement ce que vous devriez exploiter dans chaque cas. Chaque affirmation est tirée de la documentation publique des deux fournisseurs.
Si vous savez déjà que vous avez besoin d'une gateway à l'intérieur de votre propre périmètre, vous pouvez réserver une démo TrueFoundry et passer directement au tableau comparatif ci-dessous.
OpenRouter exécute à la fois son plan de contrôle et son plan de données sur sa propre infrastructure. Vous n'en exploitez aucun, il n'y a donc rien à déployer, aucune gestion Kubernetes, aucune dépendance avec état de votre côté et aucune mise à jour à effectuer. L'architecture côté client est simplement un point de terminaison et une clé API. Plutôt que des modes de déploiement, ce qui varie est le point de terminaison : openrouter.ai/api/v1 mondial par défaut, et pour les clients Enterprise, des URL de base spécifiques à la région sur eu.openrouter.ai et us.openrouter.ai, où les requêtes sont déchiffrées et traitées uniquement dans cette région et acheminées uniquement vers les fournisseurs qui y opèrent. Private Models, également disponible en version Enterprise, permet à OpenRouter d'appeler un point de terminaison de modèle que vous hébergez, intégré manuellement par leur équipe (Models).
Rien de tout cela n'est de l'auto-hébergement. Les prompts, les réponses et les métadonnées transitent tous par OpenRouter, puis par le fournisseur qui sert la requête. OpenRouter documente trois contrôles adjacents, et il convient d'être précis sur ce que chacun fait : le routage régional restreint la juridiction dans laquelle les données sont déchiffrées ; le routage sans rétention de données limite les requêtes aux fournisseurs qui ne stockent pas les prompts ni les réponses ; et provider.data_collection: "deny" achemine uniquement vers les fournisseurs qui ne collectent pas les données utilisateur. Tous trois régissent la destination des données et ce qui est conservé. Aucun d'entre eux ne change le fait qu'elles quittent votre réseau. Le basculement entre les deux points de terminaison régionaux n'est pas documenté.
Le revers de la médaille mérite une attention égale. Zéro infrastructure à n'importe quelle échelle est un véritable avantage, et le travail opérationnel ne disparaît pas vraiment : il se déplace dans votre application (gestion des tentatives et des délais d'attente dans le client, solde de crédits surveillé, et décision de conserver ou non un chemin direct vers le fournisseur comme seconde route, car une gateway hébergée constitue un point d'échec unique dans le chemin de la requête).
Une AI gateway auto-hébergée est généralement un fork du produit d'un fournisseur : un binaire différent, un ensemble de fonctionnalités différent, un contrat de support différent. TrueFoundry propose quatre modes au sein d'un seul produit sur un seul plan de contrôle, ce qui constitue la différence structurelle sur ce sujet (modes de déploiement) :
Ces modes résolvent des problèmes différents, et les confondre est l'erreur la plus fréquente que nous voyons lors des évaluations. Le mode 2 résout la résidence des données sans résoudre l'extrusion du chemin des données : les prompts transitent toujours par notre gateway. Le mode 3 résout l'extrusion du chemin des données, car les prompts ne quittent jamais votre VPC, tout en maintenant les opérations proches de zéro, car le plan gateway ne conserve aucun état. Le mode 4 résout tout, à l'exception d'un rappel divulgué : la connexion et les licences transitent par notre serveur d'authentification mondial, qui reçoit les adresses e-mail des utilisateurs et le nombre de requêtes, mais rien du chemin de la requête. Si vous exécutez déjà des modèles dans votre propre environnement, notre guide sur le déploiement de LLM sur site (on-premise) explique comment la gateway s'intègre à leurs côtés.
Deux remarques honnêtes. Il n'y a pas d'édition auto-hébergée open source ; l'offre gratuite Developer à 0 $ est une offre SaaS, pas un binaire auto-hébergeable, et l'auto-hébergement est une capacité de l'offre Enterprise. De plus, le passage d'un mode à l'autre (commencer sur SaaS, évoluer vers l'hybride) est sous-entendu par le plan de contrôle partagé, mais n'est pas encore documenté comme une procédure de migration officielle.
La raison pour laquelle les quatre modes peuvent constituer un seul et même produit réside dans la séparation entre le plan de contrôle et le plan gateway, et la raison pour laquelle le mode hybride est peu coûteux à exécuter est liée à ce que le plan gateway ne fait pas.
Le plan gateway est totalement sans état. La configuration (modèles, clés, politiques, RBAC) se synchronise depuis le plan de contrôle via une file d'attente NATS et est conservée en mémoire. Chaque vérification sur le chemin de la requête (authentification, RBAC, limites de débit, budgets) s'exécute en mémoire, sans aucun appel à une base de données sur le chemin critique. Les journaux et les métriques remontent de manière asynchrone après la réponse, de sorte qu'une écriture de journal ne bloque jamais une requête. Le plan de contrôle conserve tout l'état : Postgres pour la configuration et les utilisateurs, NATS pour la synchronisation, ClickHouse adossé à un stockage d'objets pour les journaux et les analyses (architecture du plan gateway, architecture du plan de contrôle). C'est ce qui donne à la gateway environ 3 à 4 ms de latence ajoutée et plus de 350 requêtes par seconde sur un seul vCPU tout en gérant plus de 2 500 LLM via un point de terminaison compatible OpenAI, et c'est pourquoi plusieurs plans gateway peuvent être rattachés à un seul plan de contrôle pour des déploiements multi-VPC et multi-régions.
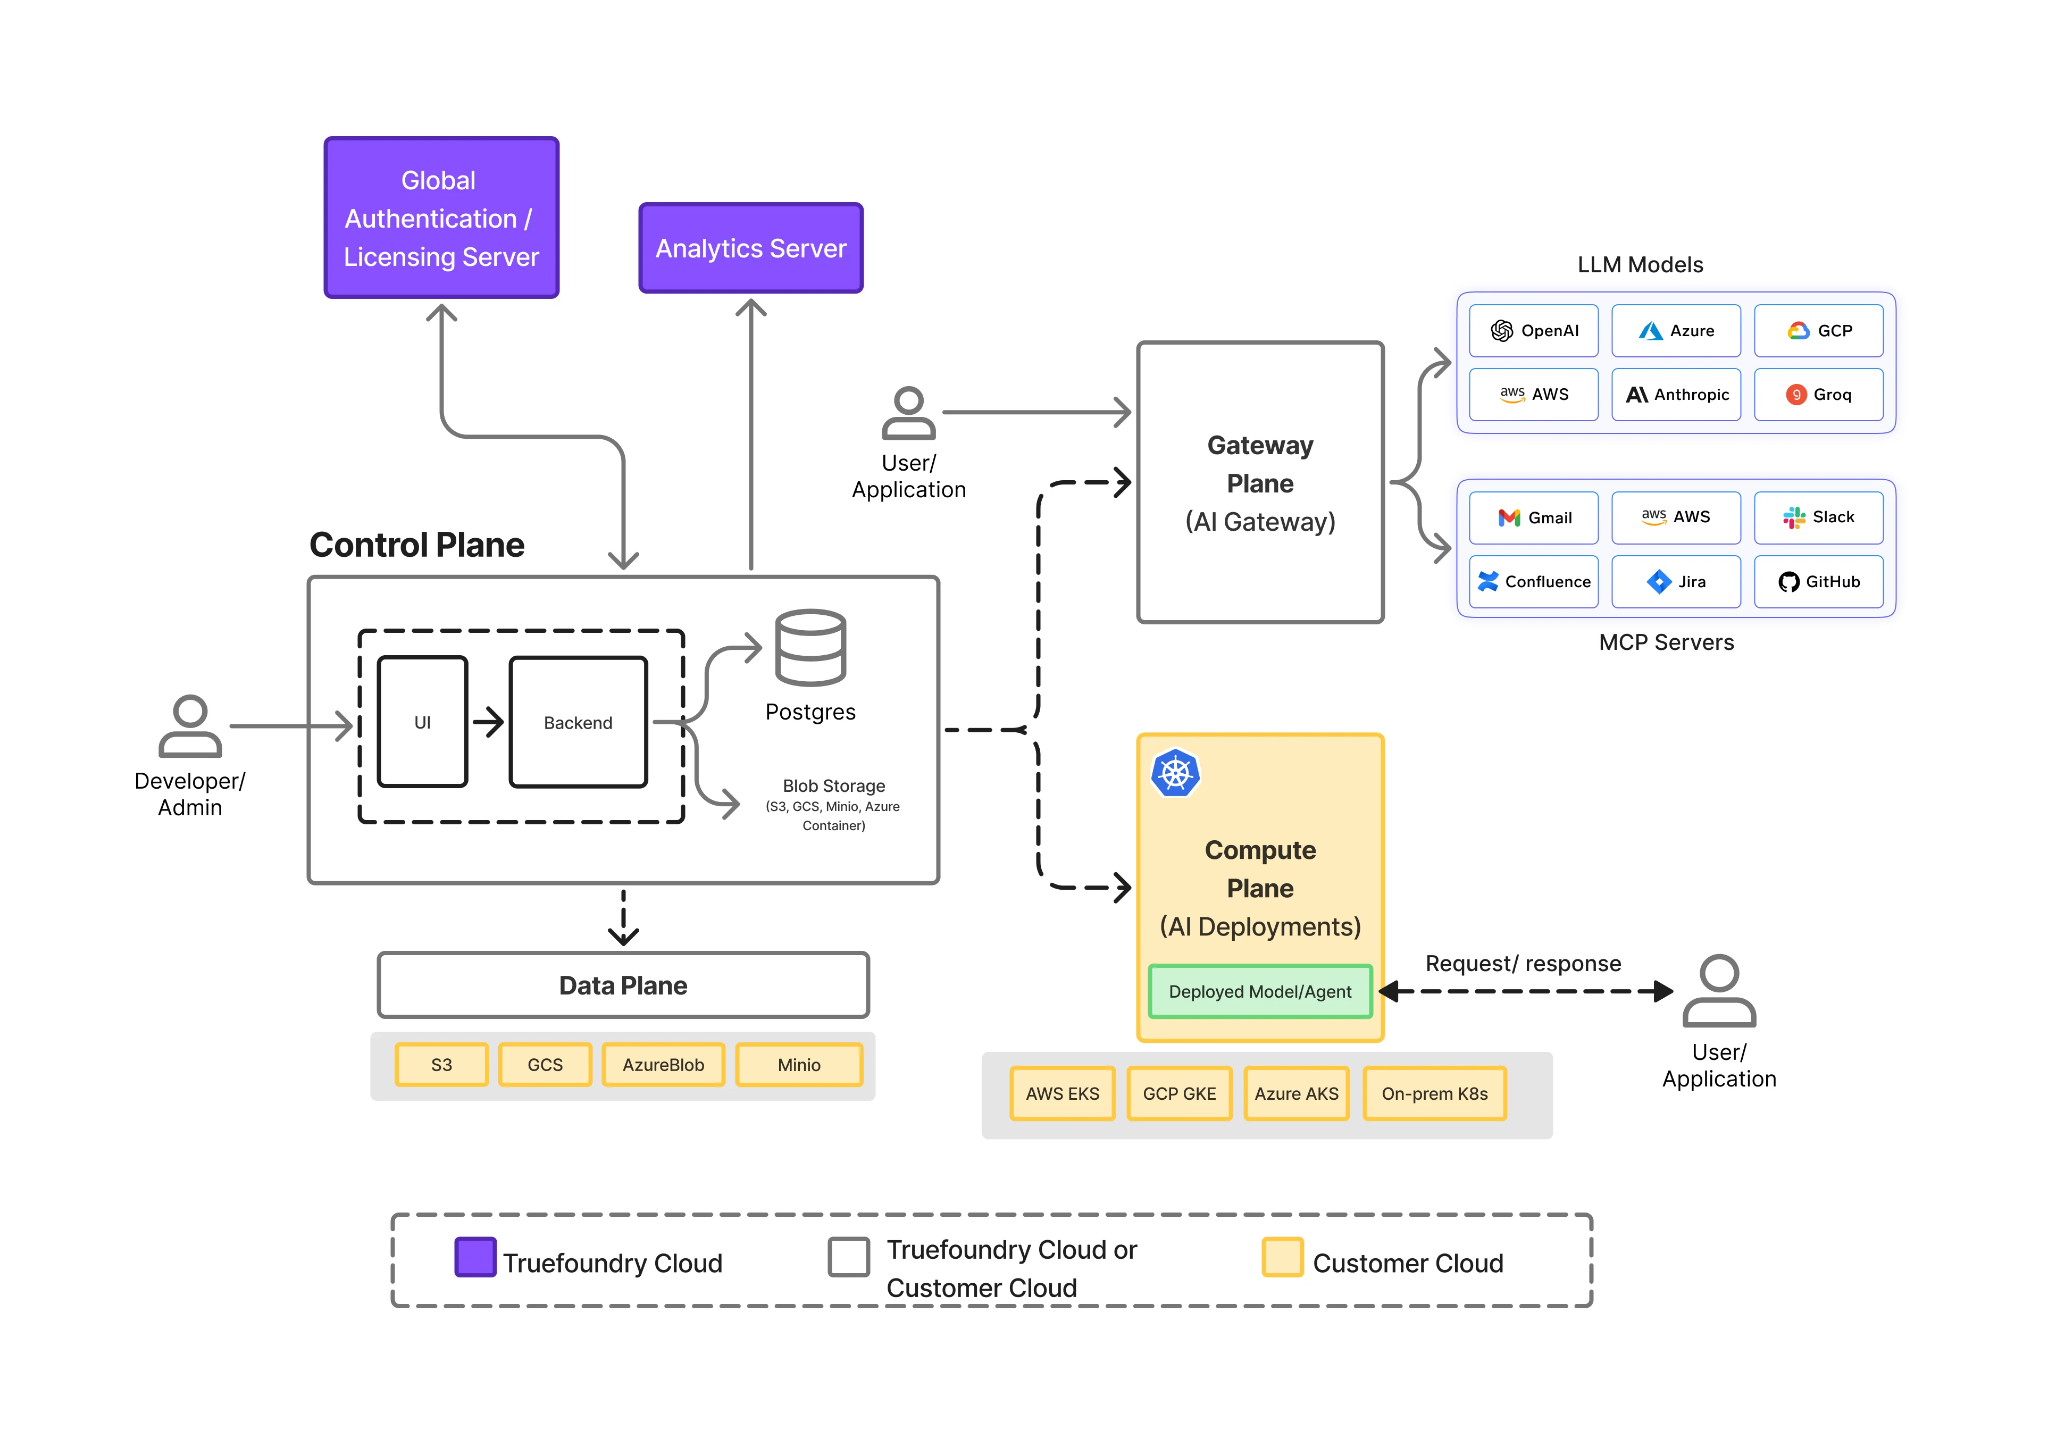
Deux points de précision maintiennent cette affirmation sur l'architecture de la gateway IA rigoureuse. « Aucun appel externe sur le chemin de la requête » comporte des exceptions documentées : Redis sur les routes où le cache est activé, et tout garde-fou géré par TrueFoundry attaché à une route ajoute un saut réseau. De plus, cette séparation n'est pas une fonctionnalité réservée au mode hybride ; le SaaS complet utilise la même architecture, de sorte que l'hybride est le même produit avec un plan relocalisé plutôt qu'un fork.
Cette séparation répond également à la question que se posent toutes les équipes plateforme : que se passe-t-il lorsque le plan de contrôle est inaccessible ? La gateway continue de servir les requêtes en se basant sur la dernière configuration synchronisée. Ce qui se dégrade, c'est la fraîcheur de la configuration, la précision du budget agrégé et la capacité à démarrer de nouveaux pods. Le pire des cas est l'arrêt simultané de NATS et du backend du plan de contrôle : la synchronisation en temps réel s'arrête, le pipeline de journaux s'interrompt, les compteurs agrégés se bloquent et les redémarrages de pods échouent. Si NATS est actif et que seul le backend est en panne, la synchronisation, l'agrégation et les journaux continuent, et seules l'interface utilisateur et l'API sont affectées (FAQ de déploiement). L'équivalent chez OpenRouter est plus simple et plus strict : le plan de contrôle et le plan de données forment un système hébergé unique sans secours géré par le client, de sorte qu'une panne à ce niveau supprime tous les fournisseurs d'un coup, ce qui est précisément la défaillance qu'un routeur multi-fournisseurs cherche à éviter.
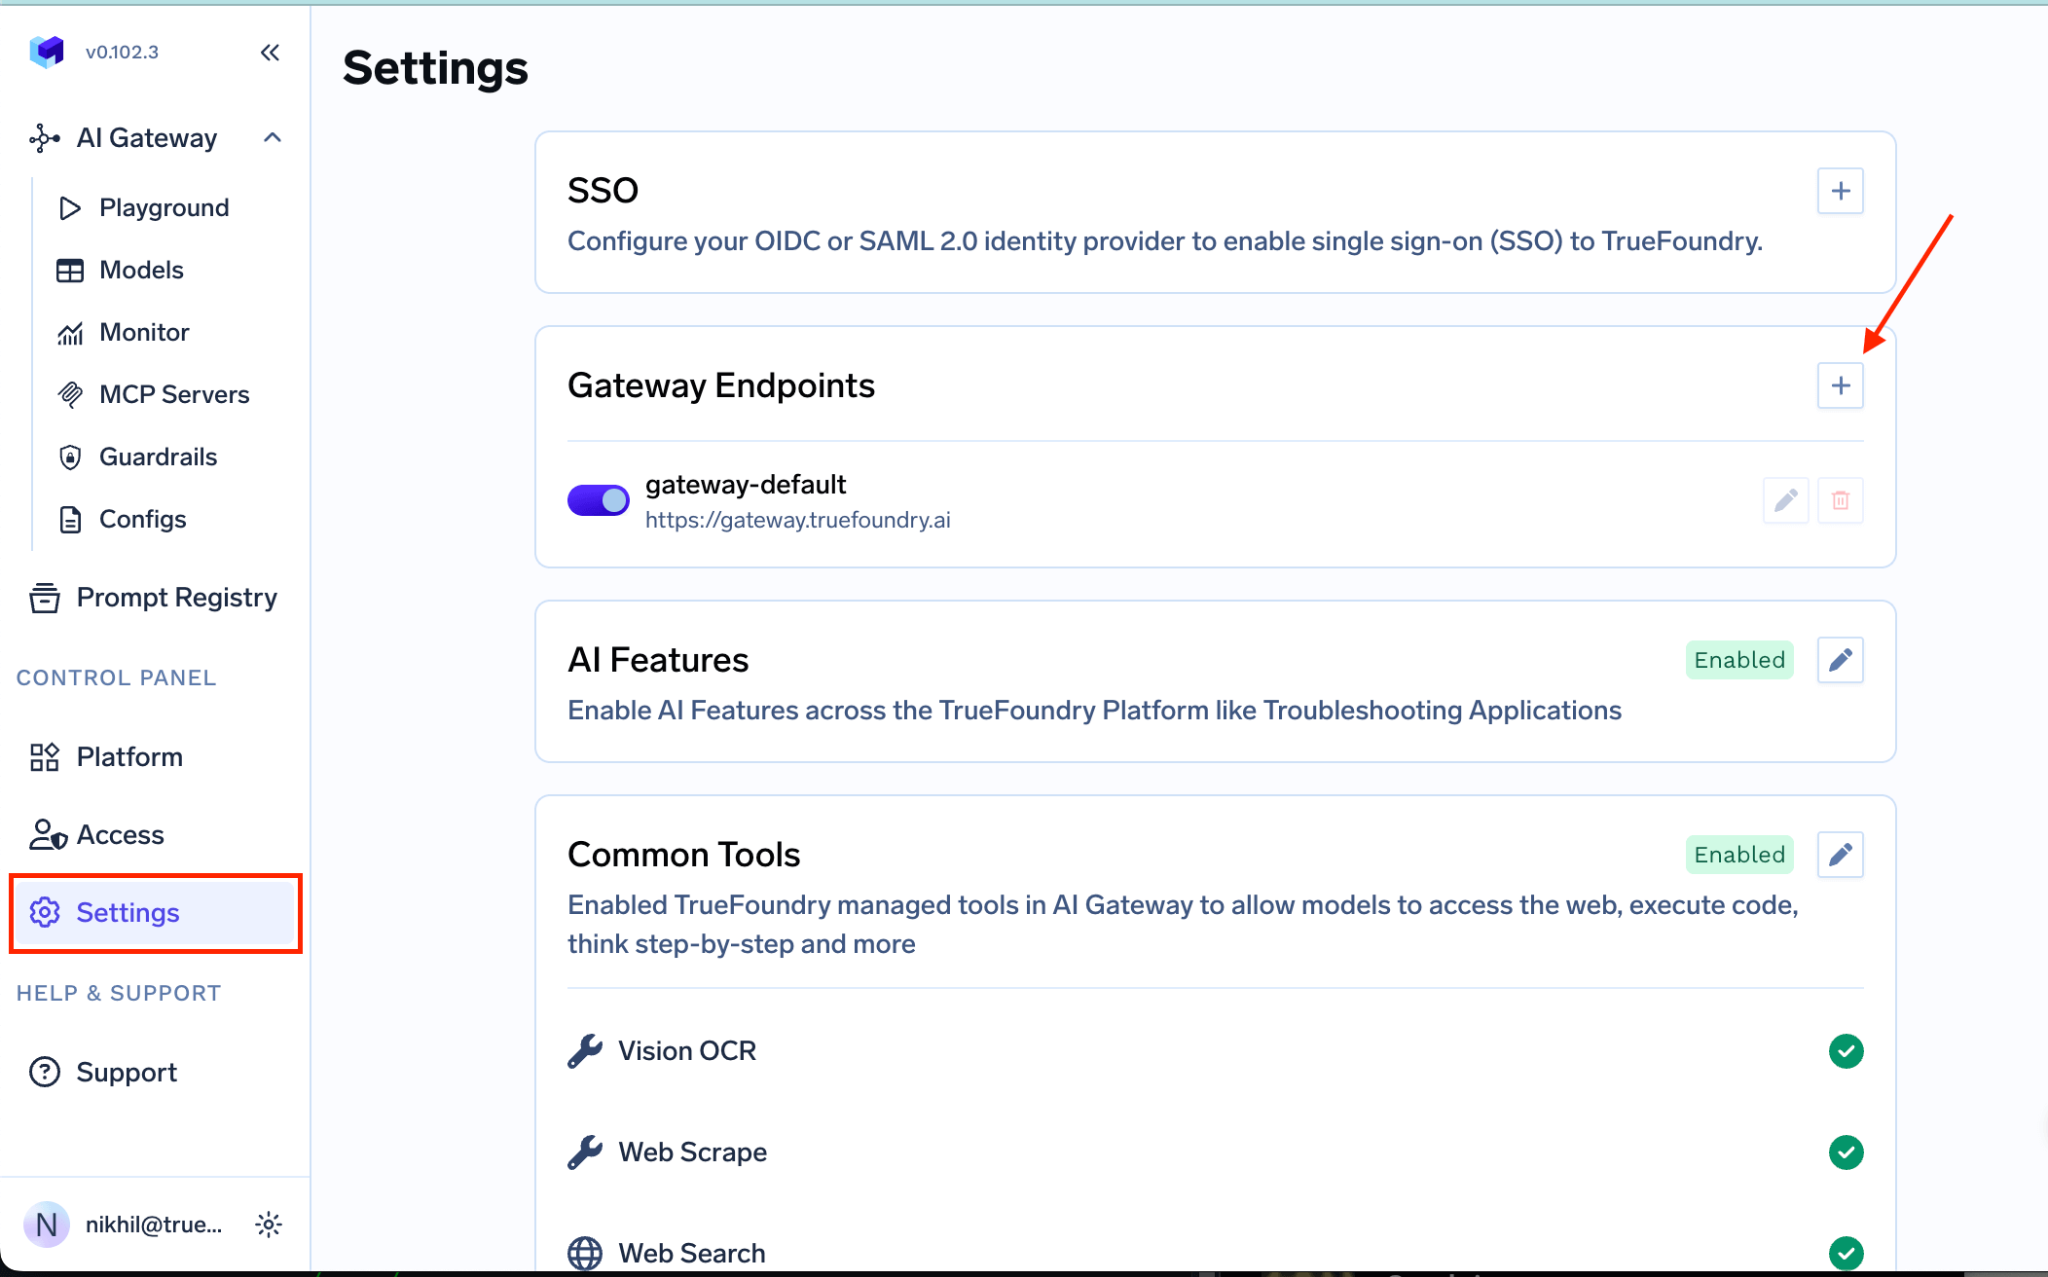
Le plan gateway est écrit en Hono sur Node.js et est fourni sous forme de chart Helm tfy-llm-gateway pour Kubernetes 1.27+ (EKS, GKE, AKS, OpenShift et sur site documentés). Il n'y a pas de CRD ni d'opérateur : les objets gateway résident dans le plan de contrôle et se synchronisent via NATS, de sorte que kubectl ne touche jamais à la configuration de la gateway. Un seul cerveau, aucune dérive par cluster, avec un coût honnête : la politique de la gateway ne peut pas être gérée en GitOps via des manifestes Kubernetes, et le GitOps/IaC est une capacité réservée à l'offre Enterprise (déployer le plan gateway).
Les affirmations relatives au caractère « air-gapped » sur ce marché se déclinent en trois niveaux, et un acheteur doit savoir lequel lui est vendu. Le niveau « marketing » correspond à du SaaS avec un réseau privé. Le niveau « air-gapped sur le chemin des données » signifie qu'aucune donnée de requête ne sort jamais, avec une exception divulguée concernant le canal de contrôle. Le niveau « totalement déconnecté » implique l'absence totale d'extrusion, avec des licences hors ligne.
TrueFoundry se situe fermement dans le deuxième niveau. Les installations entièrement auto-hébergées dans des environnements restreints sont documentées, avec miroir d'images et de charts dans des registres privés et aucune dépendance à l'Internet public pour le service du trafic. La licence est une clé stockée sous forme de Secret Kubernetes, validée au démarrage et lors de la synchronisation plutôt qu'à chaque requête ; les pods en cours d'exécution continuent de servir indéfiniment sans connectivité au serveur de licences, et seuls les nouveaux démarrages de pods nécessitent le plan de contrôle et NATS. Il n'y a pas de licence hors ligne sous forme de fichier, ce qui constitue la distance mesurée par rapport au troisième niveau. Une limite avec réouverture automatique doit toujours accompagner l'affirmation d'un LLM air-gapped : notre garde-fou PII intégré est propulsé par Azure AI Language et s'exécute sur une infrastructure gérée par TrueFoundry. Par conséquent, l'activer dans un déploiement auto-hébergé envoie le contenu de la requête au-delà de la frontière. Les configurations air-gapped doivent plutôt utiliser des garde-fous auto-hébergés ou personnalisés (garde-fou PII).
OpenRouter ne se situe pas sur cette échelle. Concernant la résidence des données sur OpenRouter spécifiquement, le constat le plus net dans sa documentation est que le suivi des entrées et sorties (Input & Output Logging) ne s'applique pas aux requêtes acheminées via les points de terminaison UE ou US ; ces requêtes sont traitées normalement mais la consignation est ignorée. Le traitement régional et le contenu des prompts stockés s meurent donc mutuellement, de sorte qu'un acheteur entreprise qui souhaite la résidence des données dans l'UE ne peut pas bénéficier en même temps du débogage ou de l'audit au niveau des prompts via la plateforme. L'emplacement où sont stockées les métadonnées de requête conservées par OpenRouter, et dans quelle région, n'est pas documenté.
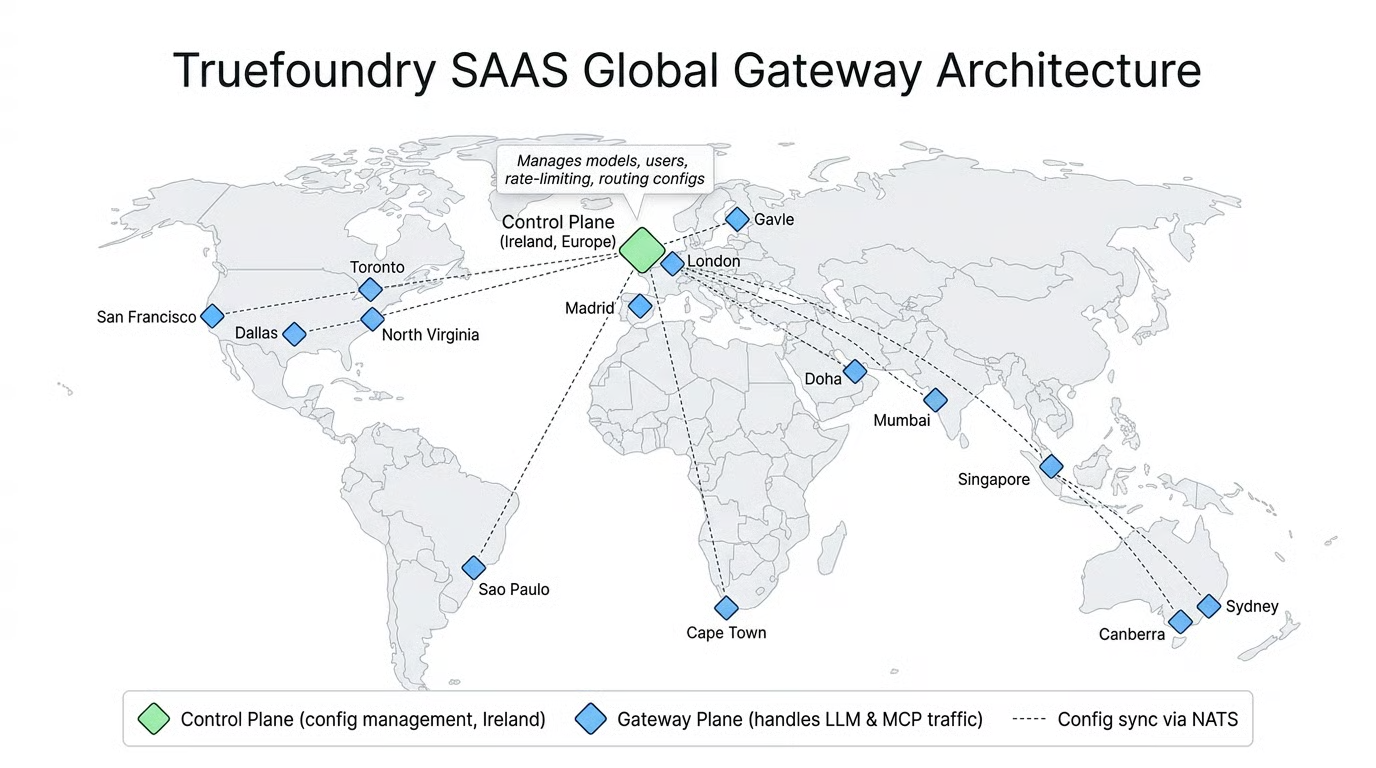
Concernant le multi-région : TrueFoundry SaaS bascule automatiquement vers la gateway saine la plus proche (SaaS distribué mondialement) ; le multi-région auto-hébergé consiste en plusieurs plans gateway sous un seul plan de contrôle (Enterprise), la gestion du trafic et la reprise après sinistre du plan de contrôle étant à votre charge.
Les fonctionnalités de TrueFoundry sont issues de notre documentation ; les fonctionnalités d'OpenRouter reflètent ses fonctionnalités publiques documentées au moment de la rédaction.
L'exigence minimale de production de TrueFoundry dépend du mode plutôt que de l'échelle. En mode hybride, il s'agit d'un cluster Kubernetes réparti sur deux zones de disponibilité (AZ), de deux répliques de gateway sans état ou plus avec autoscaling et anti-affinité, d'un ingress avec TLS, d'une sortie vers le plan de contrôle et les fournisseurs, et de Redis uniquement si vous utilisez le cache ou avez besoin de budgets exacts entre les répliques. La haute disponibilité se résume réellement à des répliques. Passer au mode entièrement auto-hébergé multiplie vos composants avec état de un (optionnel) à quatre (requis) : un Postgres géré multi-AZ, un cluster NATS à trois nœuds, ClickHouse répliqué et un stockage d'objets durable, chacun étant soit un service géré, soit sous la responsabilité de votre équipe d'astreinte. C'est pourquoi les coûts de base sont d'environ 600 $/mois pour l'hybride et de 800 à 1 000 $/mois pour l'auto-hébergé complet avant passage à l'échelle, et pourquoi nous estimons la charge de travail à environ 0,1–0,15 ETP pour l'hybride et 0,3–0,5 ETP pour un plan de contrôle auto-hébergé (nos estimations, pas des chiffres publiés).
Le coût d'OpenRouter est de 0 $ et environ 0,02 ETP pour une petite équipe, ce qui constitue un avantage réel. La comparaison qu'un acheteur devrait réellement faire n'est pas « gratuit contre 800 $ » : c'est de savoir si l'exigence qui l'a amené à chercher une gateway LLM d'entreprise peut être satisfaite par un produit hébergé. Si les prompts doivent rester à l'intérieur de votre périmètre, la ligne d'infrastructure est simplement le prix pour répondre à cette exigence. Le domaine plus large des options auto-hébergées est couvert dans notre guide sur les alternatives à OpenRouter.
OpenRouter en version auto-hébergée n'est pas un produit qui existe, et aucun niveau de routage régional ou de configuration sans rétention ne transformera une marketplace hébergée en une solution auto-hébergée. OpenRouter l'emporte sur la simplicité de déploiement et perd sur le choix : rien à exécuter, rien que vous ne puissiez garder dans votre réseau. TrueFoundry l'emporte sur le choix et le paie au niveau de l'empreinte infrastructurelle : quatre modes sur un seul plan de contrôle, un plan gateway sans état qui continue de fonctionner lors des pannes du plan de contrôle, et une option auto-hébergée dont le coût réside dans une pile avec état et du temps ingénieur. Pour toute organisation ayant une exigence de frontière des données, la décision se prend sur ce seul critère.
Si vous évaluez une gateway IA pour un déploiement VPC, hybride ou air-gapped, réservez une démo pour voir le plan gateway s'exécuter dans votre propre cluster, ou découvrez TrueFoundry AI Gateway pour commencer sur le SaaS géré et déplacer le plan ultérieurement.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





