


noviembre 21, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Nueve de los diecinueve modelos gratuitos de OpenRouter se ejecutan en proveedores cuya política publicada indica que pueden entrenar con tus prompts. La etiqueta es de OpenRouter, obtenida de la política de datos estructurados que publica para cada proveedor al que enruta.
Alguien está pagando las GPU. El trato suele ser razonable: inferencia gratuita a cambio de datos de uso, comentarios y adopción. «0 $ por token» es el importe de la factura. La política de datos, la existencia de un solo host y el tiempo que el modelo permanece publicado constituyen el resto de lo que te cuesta, a fecha de 5 de octubre de 2026.
Los modelos gratuitos en OpenRouter suelen llevar el sufijo :free en el ID del modelo, como nvidia/nemotron-3.5-lightning:free. El 5 de octubre, la API de modelos enumeraba 17 de ellos, además de otros dos con precio cero pero sin el sufijo: inclusionai/ling-3.1-flash, añadido dos días antes, y stealth/space-bunny-alpha, un modelo anónimo ofrecido por el proveedor stealth de OpenRouter. Eso suma 19 modelos de texto gratuitos. También está openrouter/free, un enrutador que elige uno de ellos al azar para cada solicitud, filtrando según las funciones que requiera tu petición.
La página de precios de OpenRouter describe el plan Free como «más de 25 modelos gratuitos» de «4 proveedores gratuitos». La API muestra 19 modelos de 10 proveedores. La diferencia se debe probablemente a la rotación del catálogo y a distintas formas de contabilizar, más que a algo oculto, pero sirve como recordatorio para consultar la API en lugar del material de marketing.
Agrupados según lo que indica la política de datos del host:
OpenRouter publica una política de datos para cada uno de los 92 proveedores que enumera: si el proveedor puede entrenar con los prompts, si los conserva y durante cuánto tiempo. Solo cinco de esos 92 están marcados como posibles usuarios de prompts para entrenamiento. Cuatro de los cinco ofrecen modelos gratuitos: NVIDIA, Thinking Machines, Liquid y el proveedor stealth. El quinto, DeepSeek, es de pago.
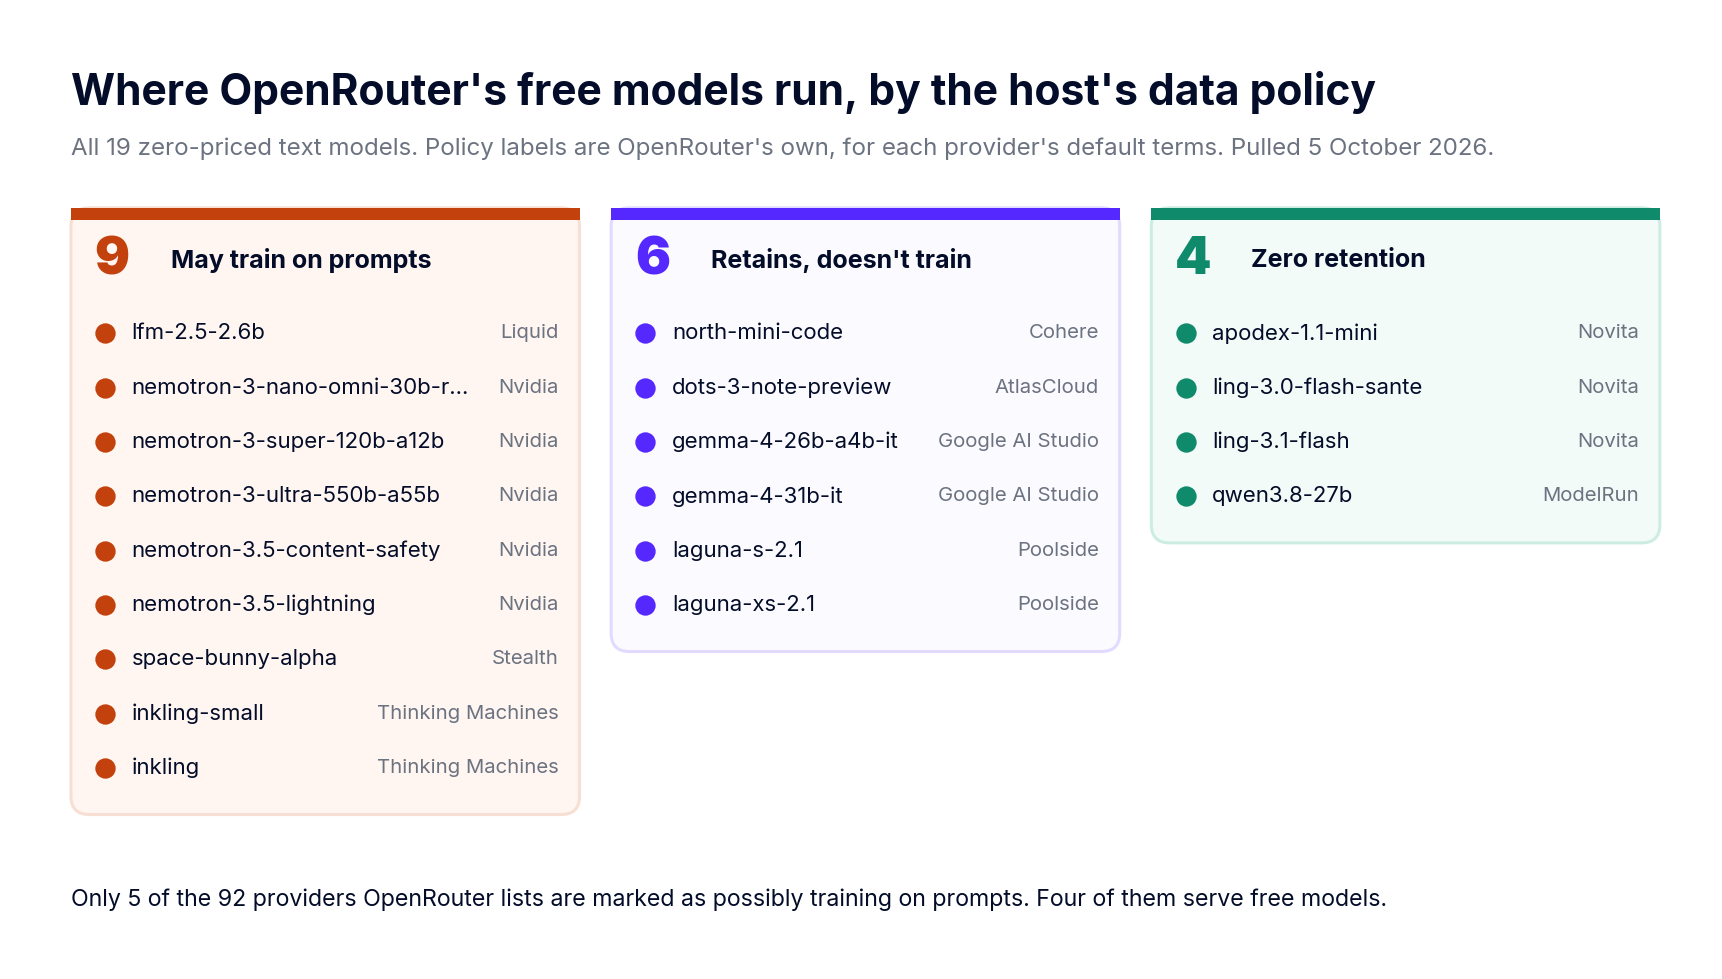
Por lo tanto, para los modelos gratuitos en concreto, la distribución es: nueve en hosts que pueden entrenar, seis en hosts que guardan tus prompts sin entrenar con ellos (Google AI Studio durante 55 días, Cohere durante 30, Poolside y AtlasCloud durante un periodo que no especifican) y cuatro con cero retención, tres de ellos en Novita.
Tres aclaraciones permiten ser justos. En primer lugar, estas son las condiciones predeterminadas de cada proveedor. OpenRouter señala que un endpoint individual puede tener una política distinta a la predeterminada de su proveedor, y a veces negocia condiciones más estrictas, por lo que algunas rutas gratuitas pueden ser mejores de lo que se muestra. En segundo lugar, cuando OpenRouter no puede determinar una política, marca el endpoint tanto para entrenamiento como para retención, lo que peca de cauteloso. En tercer lugar, «puede entrenar» describe lo que permiten los términos, no lo que ocurre con cada prompt en particular.
Las condiciones explican esta división. Los términos que OpenRouter enlaza para NVIDIA son sus condiciones de prueba de la API, y para Thinking Machines son sus términos del nivel de investigación gratuita. Que los creadores de modelos ofrezcan inferencia gratuita para aprender del uso es un acuerdo habitual y perfectamente adecuado para datos públicos y proyectos personales. Sin embargo, no es idóneo para datos de clientes, código interno o cualquier información bajo un contrato de confidencialidad (NDA).
OpenRouter ofrece controles. Tu configuración de privacidad tiene interruptores independientes para endpoints de pago y gratuitos que pueden entrenar con las entradas, además de un modo de cero retención de datos, y las solicitudes pueden definir data_collection: "deny". Hay dos detalles importantes sobre esto. La tabla de precios de OpenRouter incluye el enrutamiento basado en políticas de datos como una función del plan Standard, no como parte del plan Free. Además, ninguno de los 92 proveedores está marcado actualmente como capaz de publicar prompts, por lo que el interruptor «endpoints gratuitos que pueden publicar prompts» no bloquea nada a día de hoy.
Cada uno de los 19 modelos gratuitos tiene exactamente un endpoint. Un modelo de pago en OpenRouter puede tener una docena de hosts y realizar un fallback entre ellos. Un modelo gratuito tiene un solo host, por lo que si está ocupado o caído, no hay otro sitio al que redirigir.
Esto interactúa de forma desfavorable con los controles de privacidad mencionados antes. Si desactivas «endpoints gratuitos que pueden entrenar», OpenRouter deja de enrutar a esos hosts, tal como está documentado. Al haber solo un host por modelo, esto no te redirige a un lugar más seguro: simplemente hace que nueve de los diecinueve modelos dejen de estar disponibles.
El tiempo de actividad (uptime) de un día osciló entre el 97 % y el 100 % para la mayoría de los endpoints gratuitos el día que extrajimos los datos, con una excepción, Nemotron 3 Nano Omni, que se situó en el 86 %. A esto hay que añadir los límites: 20 solicitudes por minuto en cualquier modelo gratuito, y 50 al día hasta que hayas comprado al menos 10 créditos, momento en el que pasa a 1000 al día. Las solicitudes fallidas también pueden contar para el límite diario. Nuestra publicación sobre los límites de frecuencia de OpenRouter explica cómo funcionan estas restricciones y por qué dependen de tu historial de pagos.
Una variante gratuita no siempre es el mismo despliegue que el modelo de pago con el mismo nombre. Gemma 4 31B es el ejemplo más claro: el endpoint gratuito limita la salida a 32 768 tokens, mientras que los hosts de pago para el mismo modelo llegan hasta los 262 141, y hay 13 de ellos para elegir.
Esto funciona en ambas direcciones. El endpoint gratuito de Nemotron 3 Ultra ofrece un contexto de un millón de tokens frente a los 262 144 de sus hosts de pago, y el endpoint gratuito de Inkling duplica su contexto de pago. La opción gratuita puede ser más grande o más pequeña que la ruta de pago. La cadena de texto del modelo por sí sola no indica cuál es el caso, algo habitual en OpenRouter en general, tal como explicamos en qué es OpenRouter y cómo enruta las solicitudes.
Los modelos gratuitos en OpenRouter son recientes. A 5 de octubre, la mediana de permanencia de los modelos gratuitos era de 75 días; 8 de los 19 habían aparecido en los 60 días anteriores, y el más antiguo, Nemotron 3 Super, llevaba 207 días. Dos nombres son versiones preliminares por etiqueta: uno incluye «preview» en su ID y el otro es una versión alpha de tipo stealth.
Además, desaparecen. Dos ID gratuitos que recomendaba una guía de julio ampliamente compartida, qwen/qwen3-coder:free y deepseek/deepseek-r1:free, ya no figuran en la lista, mientras que las versiones de pago de ambos modelos siguen estando disponibles. Lo que se retiró fue la variante gratuita, no el modelo. Trata cualquier modelo gratuito como una promoción con una fecha de caducidad que no se te avisará con antelación, y fija un fallback de pago si depende de ello algún proceso importante.
El enrutador openrouter/free devuelve un endpoint operativo en cada solicitud eligiendo un modelo gratuito al azar, de modo que dos pases en la misma conversación pueden ser respondidos por modelos distintos, de empresas diferentes y con políticas de datos distintas.
Esta es la parte que la mayoría de las guías de niveles gratuitos omiten. Para seis de los nueve modelos gratuitos cuyo host puede entrenar, DeepInfra ofrece exactamente el mismo modelo, y los datos de OpenRouter señalan que DeepInfra ni entrena ni conserva los prompts.
Tomemos como ejemplo Nemotron 3.5 Lightning. Es gratuito en NVIDIA, o cuesta 0,06 $ por millón de tokens de entrada y 0,16 $ por millón de tokens de salida en DeepInfra. Alcanzando el propio límite máximo del nivel gratuito de 1000 solicitudes al día, con 2000 tokens de entrada y 500 de salida por solicitud, el coste es de 20 centavos al día: 6,00 $ por 30 días, o 6,33 $ tras la tarifa de crédito del 5,5 % de OpenRouter. Para obtener 1000 solicitudes gratuitas al día, de todos modos debes comprar 10 $ en créditos, lo que por sí solo cubriría más de un mes y medio de la ruta de pago.
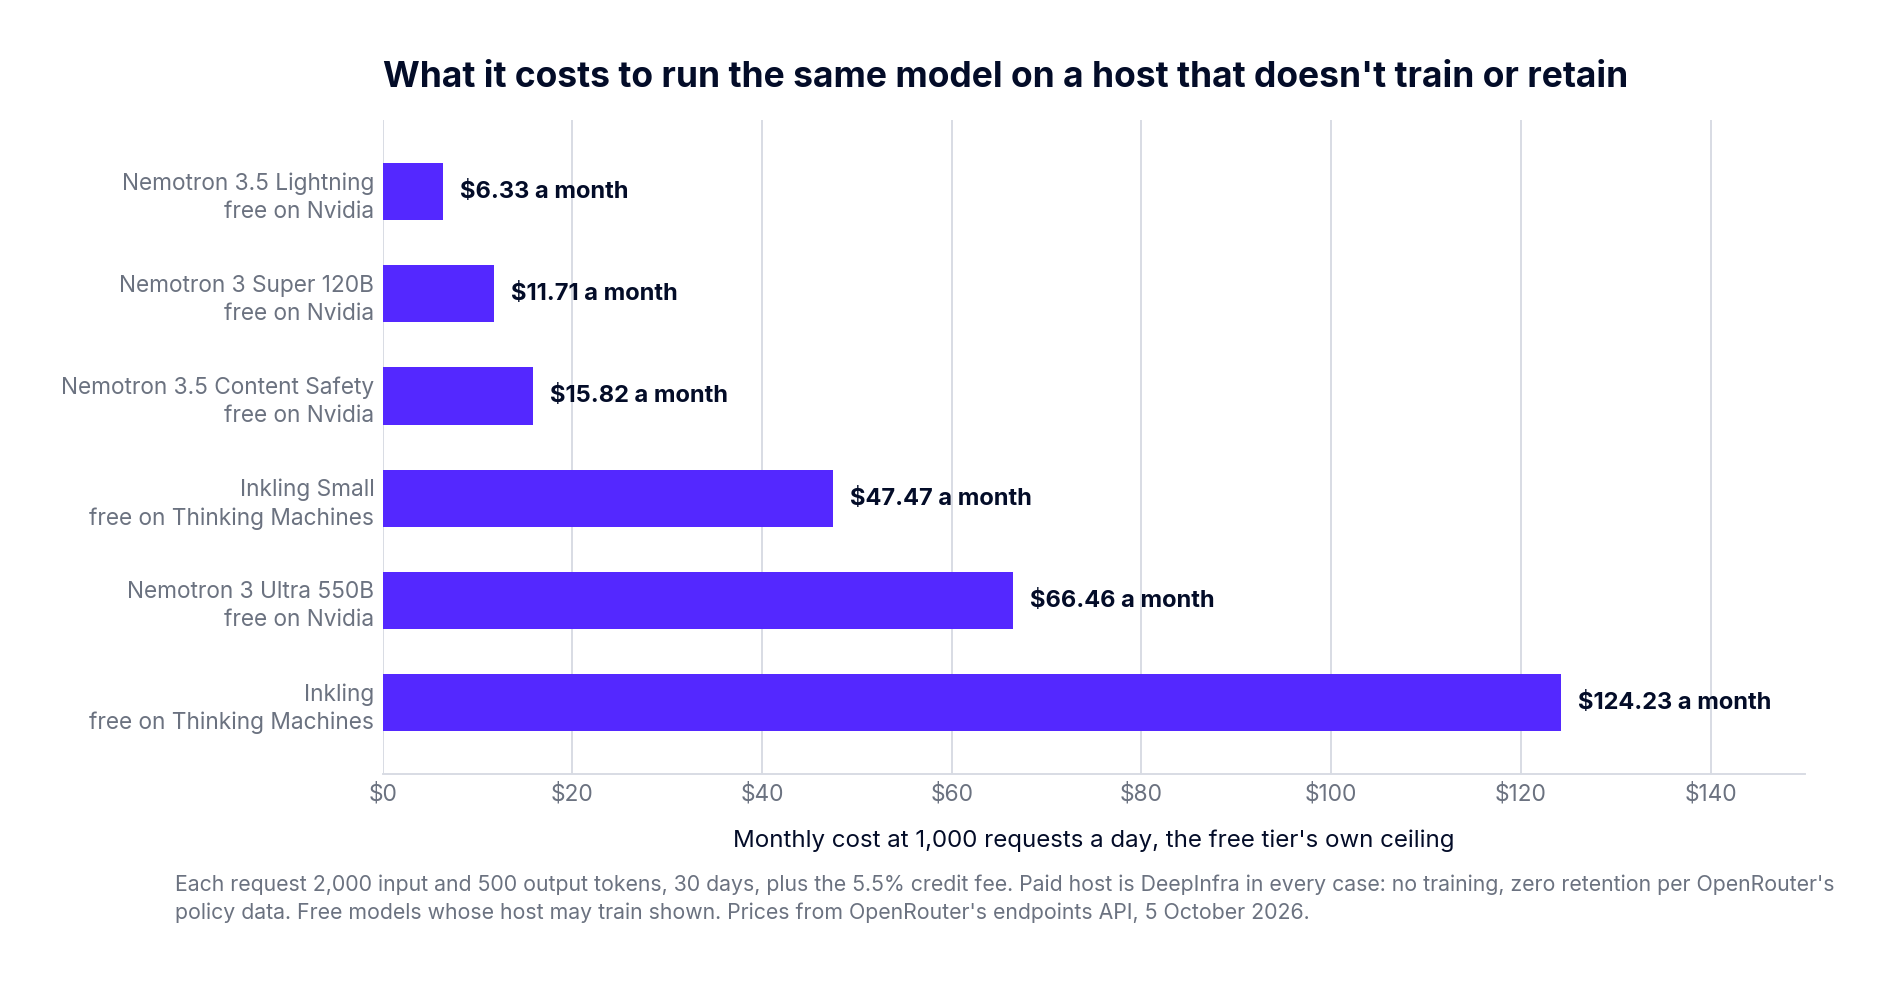
El abanico es amplio, desde 6 $ al mes para Lightning hasta 124 $ para Inkling, por lo que «pagar directamente» no es automáticamente irrelevante para los modelos más grandes. Pero para los tres modelos Nemotron más pequeños, mantener tus prompts fuera de una canalización de entrenamiento cuesta menos de 16 $ al mes.
Los modelos gratuitos de OpenRouter son una buena opción para crear prototipos y comparar modelos antes de comprometerse, así como para evaluaciones con datos públicos o sintéticos. Los proyectos personales, las demostraciones y el aprendizaje también encajan bien. Cualquier información con cierto grado de sensibilidad se puede procesar en los cuatro modelos con cero retención, y debe mantenerse alejada del resto.
Resultan una mala opción para datos de clientes, código interno o cualquier elemento cubierto por un NDA o un acuerdo de procesamiento de datos (DPA). Lo mismo se aplica a cualquier servicio que deba permanecer activo sin interrupciones, ya que solo hay un host y no existe fallback, y a cualquier desarrollo que vayas a lanzar a producción, puesto que el modelo puede ser retirado sin previo aviso. Para cualquier volumen real, la ruta de pago suele representar apenas unos pocos dólares al mes.
Varios de estos modelos gratuitos pertenecen a familias que publican pesos abiertos, entre ellas Gemma y Qwen. Ejecutar esos pesos en tus propias GPU es la forma de utilizar el modelo sin ningún tercero en la ruta de la solicitud. TrueFoundry los despliega con vLLM, TGI y Triton, detrás del mismo AI Gateway que gestiona tus proveedores alojados.
Si decides seguir usando OpenRouter, la pasarela puede situarse delante para restringir a qué modelos tiene acceso cada equipo. De este modo, los endpoints gratuitos se reservan para los equipos de desarrollo, mientras que el tráfico de producción se dirige a hosts que hayas verificado previamente. Permite exponer más de 1000 LLM a través de una única API compatible con OpenAI, añade solo unos 3 o 4 ms de latencia y gestiona más de 350 RPS en un solo vCPU.
Los modelos gratuitos de OpenRouter cuestan 0 $ por token y resultan muy útiles para probar un modelo antes de tomar una decisión. Casi la mitad se ejecutan en hosts que pueden entrenar con tus prompts, todos se sirven desde un único host y muy pocos llevan publicados más de unos meses. Utilízalos para explorar, mantén los datos sensibles en rutas pagadas o con cero retención y verifica el endpoint antes de confiar únicamente en el nombre.
Para ejecutar pesos abiertos sin terceros en la ruta, consulta cómo TrueFoundry AI Gateway sirve modelos alojados e infraestructuras propias de forma integrada.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.






They cost nothing per token. You pay in other ways: nine of the nineteen free models run on hosts whose policy says they may train on your prompts, each free model has only one host and no fallback, and usage is capped at 20 requests a minute and 50 a day, or 1,000 a day once you've bought 10 credits.
It depends on the host. As of 5 October 2026, nine of the nineteen free models ran on providers that OpenRouter marks as possibly training on prompts, six on providers that retain prompts without training, and four on zero-retention hosts. OpenRouter itself says it doesn't train on API data; the policy that matters is the provider's.
On 5 October 2026 OpenRouter's API listed 19 free text models: 17 with a :free suffix and two priced at zero without one, served by 10 providers. Its pricing page says "25+". The list changes often, so query /api/v1/models for the current set.
Sí. TrueFoundry se ejecuta en su VPC, on-prem, en entornos air-gapped o híbridos, de modo que los prompts y las respuestas nunca salen de su dominio, incluso cuando enruta entre muchos proveedores.
Cualquier LLM mediante backends de alto rendimiento como vLLM, TGI y Triton, además de servidores compatibles con OpenAI como Ollama, todos conectados al mismo AI Gateway y gobernados de la misma forma.



Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada














