


noviembre 21, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Los chats de atención al cliente filtran números de la seguridad social en los prompts. Los desarrolladores internos pegan claves de acceso de AWS en un asistente de código. Una respuesta tóxica se le escapa a un usuario final. Cada uno de estos casos es un fallo real de las operaciones con LLM, y cada uno de ellos se puede detectar mediante un pequeño clasificador local en unos pocos milisegundos, sin necesidad de realizar una llamada de ida y vuelta al LLM. La cuestión más difícil es cómo conectar esas comprobaciones a través de cientos de aplicaciones y decenas de proveedores de modelos, de forma alineada con cada solicitud, sin tener que inventar una pila de validación diferente para cada aplicación. La integración entre Guardrails AI y TrueFoundry AI Gateway ofrece la respuesta en un solo lugar.
Toda aplicación impulsada por LLM dentro de una organización acaba topándose con la misma pregunta: ¿dónde deben residir las comprobaciones de seguridad? Si se acoplan internamente en cada aplicación, se fragmentan con cada despliegue y varían entre equipos. Si se colocan por delante de cada proveedor de modelos, se multiplican entre los distintos proveedores y pasan por alto las aplicaciones que los esquivan. TrueFoundry AI Gateway resuelve la cuestión al convertirse en la capa de ejecución única por la que pasa todo el tráfico de LLM: ofrece una API compatible con OpenAI en el extremo frontal, se distribuye hacia todos los proveedores de modelos en el extremo posterior y gestiona todas las funciones transversales (autenticación, límites de frecuencia, observabilidad, políticas) en el medio. Un solo pod gestiona más de 250 RPS en 1 vCPU con unos 3 ms de latencia añadida, sin estado y limitado por la CPU, con la configuración sincronizada a través de NATS para que la ruta de la solicitud no realice ninguna llamada externa.
La centralización de la ruta de la solicitud es lo que hace que los guardrails encajen de forma natural. El gateway expone cuatro ganchos — llm_input, llm_output, mcp_pre_tool, mcp_post_tool — y se le puede adjuntar cualquier número de guardrails a cada uno. El gateway los distribuye en paralelo en la misma solicitud, de modo que un detector de PII, un escáner de secretos y un clasificador de toxicidad evalúan el mismo prompt al mismo tiempo sin acumular latencia en serie. Los rails de entrada se ejecutan de forma concurrente con la llamada al modelo, y si alguno de ellos se bloquea, la llamada al modelo en curso se cancela antes de que se facturen los tokens, lo que supone un ahorro de costes real cuando los validadores detectan violaciones de políticas genuinas en el tráfico de los clientes. Un complemento HTTP personalizado permite que cualquier proveedor o servicio interno participe siempre que cumpla con el contrato de veredicto del gateway, que es exactamente la interfaz a la que se conecta Guardrails AI.
Guardrails AI es un marco de trabajo de código abierto en Python para validar entradas y salidas de LLM. Su abstracción principal es el Guard, un contenedor que envuelve uno o varios validadores extraídos del Guardrails Hub, un registro de implementaciones de comprobación preconstruidas. El catálogo del Hub abarca detección de PII, detección de secretos, clasificación de toxicidad, filtros de lenguaje soez, restricción de temas, fundamentación de alucinaciones y mucho más. La mayoría de los validadores son heurísticas locales o pequeños clasificadores; un subconjunto realiza llamadas a un LLM externo en el momento de la validación.
El paquete v1 para esta integración utiliza cuatro validadores locales: DetectPII (un contenedor de Microsoft Presidio para correos electrónicos, números de teléfono, SSN de EE. UU., tarjetas de crédito, IBAN, pasaportes / licencias de conducir / ITIN de EE. UU.), SecretsPresent (detect-secrets de Yelp para claves de AWS, tokens de OpenAI, tokens de GitHub, JWT, claves privadas), ToxicLanguage (el clasificador Detoxify de Unitary procedente de Hugging Face) y ProfanityFree (un filtro basado en listas de palabras para las respuestas del asistente). Ninguno de ellos requiere una llamada a un LLM. La latencia de validación mediana en un pod activo es inferior a 100 ms por validador.
La integración trata a Guardrails AI como una biblioteca, la envuelve en un servicio FastAPI y registra el servicio como un guardrail HTTP personalizado en TrueFoundry. Para evitar un comportamiento peculiar conocido de la versión v0.9.3 en el que las llamadas Guard.use() encadenadas se sobrescriben entre sí, el contenedor expone un punto de enlace POST por validador y por dirección — /detect-pii-input, /secrets-present-output, /toxic-language-input, y así sucesivamente — y ejecuta cada Guard de forma aislada. Los operadores eligen qué validadores adjuntar a qué modelo dentro del panel de control.

Los validadores del Hub se instalan en el momento de la compilación de Docker a través de un argumento de compilación que contiene el token del Hub. El token se consume en la capa de compilación y no está presente en el entorno de ejecución. Las versiones de los validadores se fijan según lo proporcionado por el Hub en el momento de la compilación; actualizar el paquete requiere editar el Dockerfile y realizar un nuevo despliegue.
La estructura de respuesta del contenedor es la siguiente:
Respuesta del contenedorInterpretación del gatewayHTTP 200 + {"verdict": true}Permitir: el validador no se ha activadoHTTP 200 + {"verdict": false, "message": "<validator>: ..."}Bloquear: el gateway propaga el mensajeHTTP 5xxFallo real: se enruta a través de la política Fail on error del panel de control
El estado HTTP indica "completado vs. con error"; el veredicto reside en el JSON. Los bloqueos de los rails y las interrupciones temporales se pueden distinguir, por lo que Fail on error: false es la opción predeterminada segura.
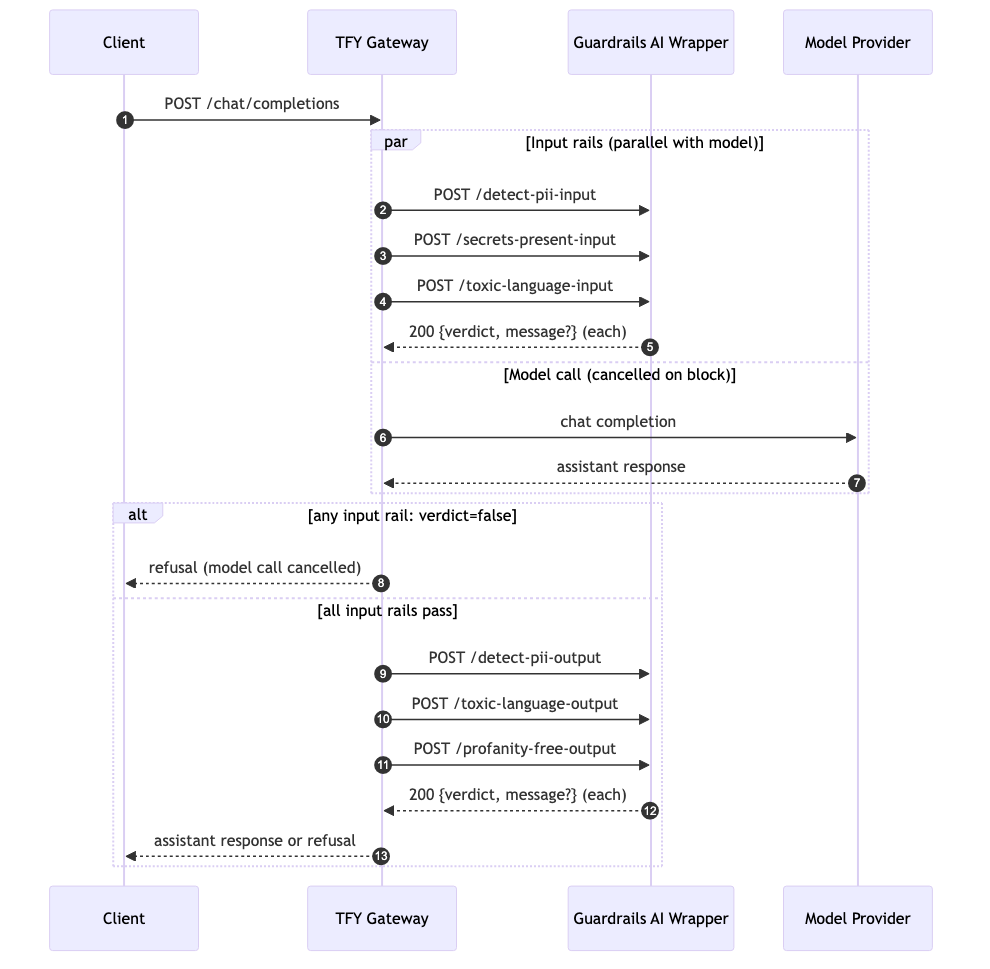
X-TFY-GUARDRAILS).{"verdict": false, "message": "<validator>: <reason>"}; cualquier validador que supere la comprobación devuelve {"verdict": true}.Dado que ningún validador realiza llamadas externas a un LLM, la latencia añadida por rail se ve determinada principalmente por la ejecución de Python y la inferencia del clasificador, siendo habitualmente muy inferior a 100 ms en un pod activo, sin dependencias externas que puedan fallar.
El contenedor se distribuye como un único servicio FastAPI desplegable mediante el SDK estándar de Python de TrueFoundry. Configure la URL del contenedor y la clave bearer como un Custom Guardrail por validador en el panel de control, adjunte los rails a un modelo o selecciónelos por solicitud, y los validadores se ejecutarán de forma alineada en cada llamada. La implementación de referencia se encuentra en integrations/guardrails-ai/ dentro del repositorio integrations-custom-guardrails; consulte la documentación de guardrails personalizados de TrueFoundry para conocer el flujo del panel de control y el catálogo de Guardrails Hub para obtener validadores adicionales.
El principio arquitectónico es la separación limpia de la complejidad del validador respecto a la ejecución del gateway. El gateway se mantiene sin estado, limitado por la CPU y libre de dependencias externas en la ruta de la solicitud. Los analizadores de Presidio, los complementos de detect-secrets y la inferencia de Hugging Face residen detrás de un único límite HTTP. Sustituir el motor del validador por uno diferente en el futuro solo requerirá un cambio en el contenedor: la configuración del panel de control, el contrato y las aplicaciones demandantes se mantendrán exactamente como están.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.








Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada














