


noviembre 20, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Published: noviembre 20, 2026

¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
La pregunta «¿cuál es el mejor modelo?» es errónea y cuesta dinero a las empresas sin que se den cuenta. La respuesta honesta es que un modelo de frontera es una herramienta con un precio, y la elección idónea depende de lo que le esté pidiendo. Enviar una tarea de clasificación de reseñas de productos a un modelo de razonamiento de primer nivel es como alquilar una grúa para colgar un cuadro. Funciona, sí, pero cuesta 40 veces más de lo necesario y es más lento.
A finales de 2026, la frontera de la IA se ha estructurado en niveles (*tiers*). Cada proveedor principal ofrece al menos tres modelos: un *flagship* optimizado para razonamiento complejo, un modelo intermedio (*workhorse*) ajustado en precio y rendimiento (*throughput*), y un modelo pequeño diseñado para ser veloz y prácticamente gratuito. Las decisiones clave ya no son «OpenAI o Anthropic», sino «qué nivel utilizar para cada petición, a qué coste y con qué alternativa». Se trata de un problema de enrutamiento, y los problemas de enrutamiento se resuelven mediante políticas, no mediante la fidelidad a una marca.
Este artículo persigue dos objetivos. Primero, ofrecer un recorrido por proveedores centrado en las fortalezas reales de cada modelo. Segundo, presentar un marco de decisión que asocia sus tipos de tareas a un nivel de modelo y a una postura de costes, mostrando cómo una pasarela de IA (*AI gateway*) permite aplicar dicho marco sin reescribir la aplicación cada vez que un proveedor lanza una nueva versión.
¿Desea enrutar cada petición al modelo adecuado según la tarea y el coste? Reserve una demostración.
Los *benchmarks* evalúan un modelo mediante una prueba fija. Sin embargo, su tráfico en producción no es una prueba fija; es una mezcla: un alud de llamadas económicas y repetitivas (extraer el número de una factura, clasificar una incidencia, decidir qué *prompt* secundario ejecutar) y un flujo reducido de peticiones verdaderamente complejas (depurar una condición de carrera entre cinco archivos, razonar sobre un contrato de 200 páginas). Un único modelo «superior» debe tener un precio y un tamaño dimensionados para el flujo complejo, por lo que acaba pagando un sobrecoste en el volumen masivo.
Tres factores hacen que limitar el análisis a un solo modelo resulte costoso:
La solución consiste en tratar la selección del modelo como un elemento de configuración. Defina la política una sola vez («la extracción va al nivel económico, la programación al nivel intermedio, el razonamiento complejo se escala a un *flagship* y todo cuenta con un segundo proveedor como alternativa en caso de error»), exprésela en una pasarela y modifíquela sin necesidad de desplegar código. Para conocer los detalles de este mecanismo, consulte qué es un enrutador de LLM y selección de modelos basada en coste y calidad.
Las únicas cifras confirmadas directamente por el fabricante que se muestran a continuación son las de Claude. Todo lo demás se ha recopilado a partir de informes de terceros a fecha de noviembre de 2026 y debe verificarse en las páginas oficiales de precios y modelos de cada proveedor antes de basar decisiones en ellas. Las especificaciones de los modelos cambian con frecuencia.
La oferta de Claude a finales de 2026 cuenta con una ventana de contexto de 1M de tokens, 128K de salida y un límite de conocimiento (*training cutoff*) de junio de 2026. Sus niveles están claramente definidos:
El patrón más útil aquí es la división en tres partes: un modelo pequeño casi gratuito, un modelo intermedio equilibrado y un modelo *premium* para agentes. Es posible construir casi cualquier política de enrutamiento basándose en estos tres roles.
Se informa de que la generación GPT-6 de OpenAI sigue una estructura de niveles similar. Se señala que GPT-6 Astra tiene un coste de 10 $ / 50 $ y se posiciona para razonamiento de alto nivel. GPT-6.1 Sol figura a 2 $ / 10 $ y se describe como el modelo más potente de la familia para investigación y programación, con un *Coding Index* reportado cercano a 54. GPT-6.1 Terra, con un precio reportado de 1 $ / 5 $ y lanzado hacia el 26 de octubre de 2026, se presenta con un contexto de aproximadamente 1,05M y un *Coding Index* cercano a 48, lo que lo sitúa a la mitad del precio de Sol conservando gran parte de su capacidad de programación. GPT-6 Luna, reportado a 0,10 $ / 0,50 $, es el modelo destinado a tareas de clasificación y enrutamiento de gran volumen, con un *Coding Index* cercano a 31.
Considere estas cifras del *Coding Index* como orientativas y no como datos exactos, ya que proceden de fuentes de terceros y pueden variar.
La gama de Google es la más difícil de precisar debido a contradicciones en los informes. Gemini 3.1 Pro figura a 2 $ / 12 $ y se orienta al razonamiento de mayor complejidad. Gemini 3.6 Flash se sitúa en 1,50 $ / 7,50 $, lanzado hacia julio de 2026, con una ventana de contexto de 1M, un *Intelligence Index* cercano a 50, una puntuación en SWE-Bench Pro del 58,7 % y un rendimiento (*throughput*) reportado de unos 280 tokens por segundo, lo que lo posiciona como un modelo intermedio muy capacitado y económico para programación. Gemini 3.1 Flash-Lite se reporta cerca de los 0,25 $ / 1,50 $ para el nivel más bajo. Si no puede confirmar la disponibilidad de 3.6 Flash en su cuenta, la alternativa segura es la versión de disponibilidad general Gemini 3.5 Flash.
La nomenclatura y versiones de Grok no están del todo consolidadas. Grok 4.3, a un precio aproximado de 1,25 $ / 2,50 $, es la configuración más citada, destacando por su bajo coste de salida. Se mencionan versiones más recientes como Grok 4.6 y Grok 5, pero aún no se han estabilizado. Considere esta versión como no definitiva y verifíquela directamente con xAI antes de enrutar tráfico de producción hacia ella.
Para los equipos que prefieren el autoalojamiento (*self-hosting*) o minimizar al máximo los costes: Meta Llama 4 Maverick se reporta en torno a 0,20 $ / 0,60 $ y Scout a 0,11 $ / 0,34 $, ambos de código abierto y autoalojables. DeepSeek V4 se sitúa en un rango aproximado de 0,22 $ a 0,66 $, diseñado para tareas de programación y razonamiento con costes optimizados. Mistral Large 3 se reporta a 0,50 $ / 1,50 $. Estas alternativas resultan especialmente relevantes cuando la residencia de datos o los costes unitarios puros son el factor determinante.
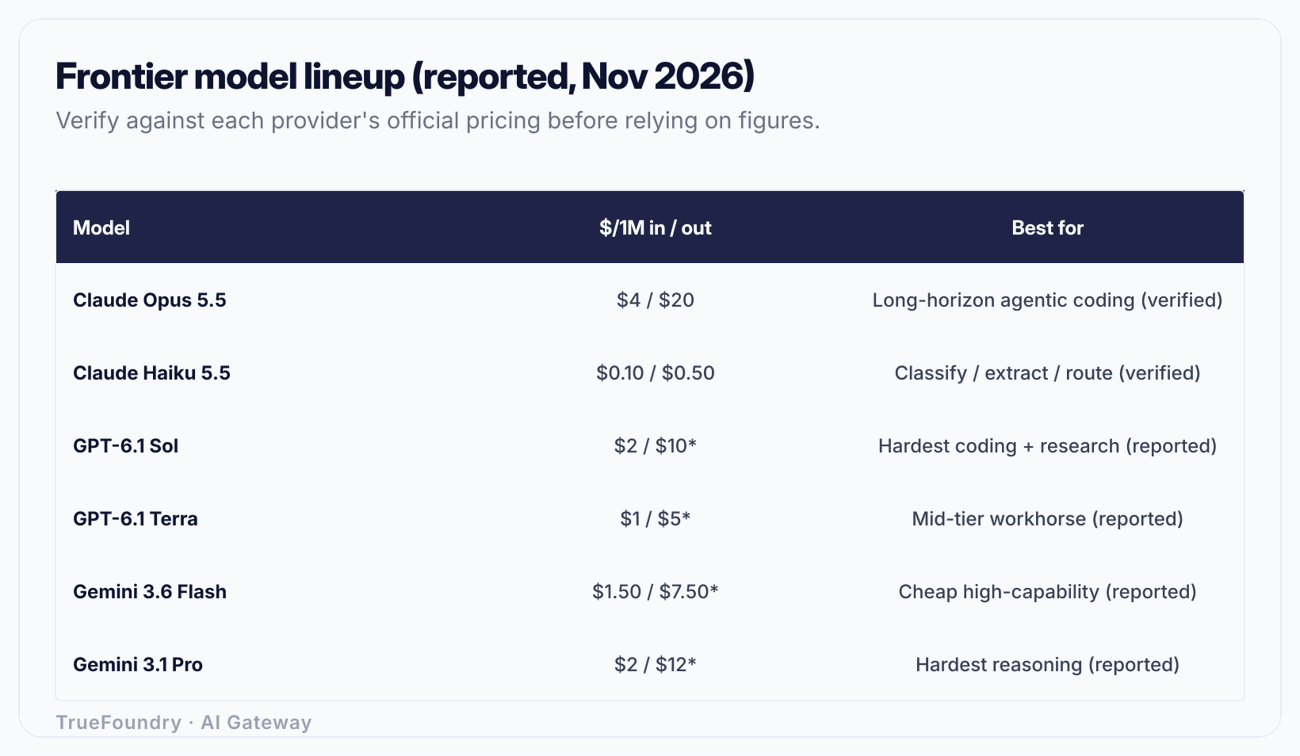
Precios y benchmarks según datos reportados a fecha de noviembre de 2026; verifique las tarifas en la página oficial de cada proveedor antes de tomar decisiones, ya que las especificaciones cambian con frecuencia.
Deje de elegir un modelo único. Comience por clasificar su tráfico y asocie cada clase a un nivel y a una postura de costes. Cuatro categorías cubren prácticamente cualquier necesidad.
Son tareas de gran volumen y baja ambigüedad: etiquetar un ticket, extraer una fecha de un documento o decidir qué rama de *prompts* ejecutar. No requieren un *flagship*. Un modelo pequeño (Haiku 5.5, GPT-6 Luna, Gemini 3.1 Flash-Lite) con un coste aproximado de 0,10 $ a 0,25 $ por millón de tokens de entrada las gestiona a la perfección; al ser la salida breve, el coste por petición es insignificante. Postura de costes: minimizar. Aquí es donde el enrutamiento hacia el nivel económico amortiza la inversión.
El chat de cara al usuario exige buena calidad y baja latencia, pero rara vez necesita un razonamiento profundo. Los modelos de nivel intermedio (Sonnet 5.5, GPT-6.1 Terra, Gemini 3.6 Flash) representan el punto óptimo. Postura de costes: equilibrar. Preste especial atención al precio de salida, ya que las aplicaciones de chat generan una gran cantidad de tokens.
La programación en varios pasos, en la que el modelo debe planificar, invocar herramientas, leer archivos y mantener un objetivo a lo largo de diferentes turnos, es donde se aprecian las diferencias de capacidad. Para las tareas más complejas con agentes, Opus 5.5 es la opción sólida confirmada; GPT-6.1 Sol se sitúa como un equivalente reportado. Para la programación diaria sin necesidades a largo plazo, un modelo de nivel intermedio (Terra, Gemini 3.6 Flash, Sonnet 5.5) suele ofrecer un 90 % del rendimiento por una fracción del coste. Postura de costes: segmentar por dificultad. Enrute las ediciones rutinarias al nivel intermedio y escale las ejecuciones complejas con agentes a modelos superiores.
Análisis jurídico, síntesis de investigaciones o razonamiento sobre documentos extensos. Este es el único caso donde está justificado pagar por un *flagship* (Astra, Gemini 3.1 Pro, Opus 5.5 o Fable 5.1 para los casos más extremos). Postura de costes: pagar por calidad, pero filtrando el acceso. Solo una pequeña fracción del tráfico debe llegar a este nivel; el filtro se establece mediante la regla de enrutamiento.
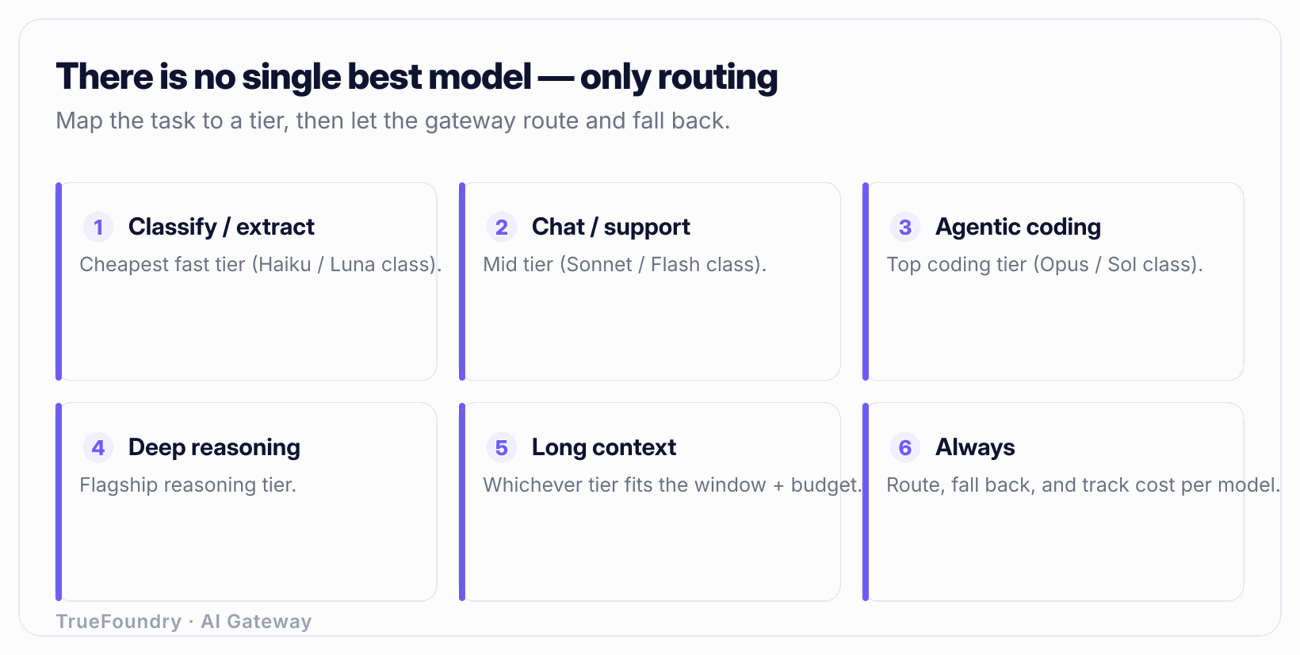
Precios y benchmarks según datos reportados a fecha de noviembre de 2026; verifique las tarifas en la página oficial de cada proveedor antes de tomar decisiones, ya que las especificaciones cambian con frecuencia.
Descubra cómo TrueFoundry enruta, gestiona alternativas y supervisa costes en cualquier modelo. Book a demo.
Supongamos un producto que procesa 10 millones de peticiones de modelos al mes, con una distribución 80/15/5: 80 % sencillas (clasificación, extracción, enrutamiento), 15 % chat y programación cotidiana, y 5 % razonamiento complejo y programación mediante agentes. Asumamos un promedio de 500 tokens de entrada y 200 de salida por petición para los niveles sencillo e intermedio, y una cantidad superior para el nivel complejo.
Si enruta todo hacia un único modelo *flagship* a 4 $ / 20 $, pagará la tarifa máxima por las 10M de peticiones, incluidas las 8M que un modelo de 0,10 $ habría resuelto con idéntico resultado. Si enruta por tarea:
El nivel sencillo, que concentra el grueso del volumen, pasa a costar aproximadamente 1/40 parte por token de entrada en comparación con el *flagship*. En la mayoría de los entornos reales, esto reduce la factura total a más de la mitad, manteniendo las peticiones complejas en el modelo preciso que necesitan. La cifra exacta dependerá de su combinación de tokens; de ahí la importancia de medir el coste por nivel mediante visibilidad detallada. Consulte atribución de costes de LLM y presupuestos de equipos para saber cómo aplicar este control en sus equipos.
El marco anterior solo resulta útil si se puede aplicar de forma ágil sin realizar un despliegue en cada cambio. Para esto sirve una pasarela de IA (*AI gateway*). La pasarela expone una única API unificada y compatible con OpenAI hacia su aplicación. Detrás de ese único punto de acceso (*endpoint*), se configura a qué modelo real se deriva cada petición. La aplicación envía siempre la misma estructura de petición; la pasarela decide el destino.
Esta desacoplación ofrece cuatro ventajas clave alineadas con el marco propuesto:
El concepto de API única tiene un impacto mayor del que parece. Cuando se lanza un nuevo modelo (Terra apareció a finales de octubre; surgirá otro en diciembre), basta con añadirlo como destino y desviar el tráfico cambiando un archivo de configuración. La aplicación no requiere cambios. Para comprender la arquitectura subyacente, consulte qué es un proxy de LLM y cómo elegir una pasarela de IA.
La frontera de la IA a finales de 2026 no es una cima solitaria con un ganador claro. Es un conjunto de niveles, y los equipos que gestionan bien sus recursos son aquellos que asignan cada segmento de su tráfico al nivel adecuado en vez de pagar tarifas *flagship* para tareas de clasificación. Los nombres de los proveedores cambiarán, los precios seguirán evolucionando y las clasificaciones se reestructurarán. El marco de trabajo se mantiene invariable: clasifique su tráfico, asocie cada categoría a un nivel y a una postura de costes, y restrinja el nivel más caro para que solo reciba peticiones complejas.
Incorpore este marco como una política de enrutamiento en una pasarela, y la elección de modelos dejará de ser un debate continuo para convertirse en una línea de configuración modificable en minutos. Podrá enrutar por tarea y coste, activar alternativas si un proveedor falla, almacenar respuestas repetidas en caché y conocer al detalle el coste de cada modelo por petición. Esa es la manera de mantenerse en la vanguardia sin quedar atado a un punto fijo de ella.
Deje de acoplarse a un solo modelo: enrute entre ellos. Reserve una demostración.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada




