



October 10, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: October 10, 2026
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Prompt-Engineering-Techniken helfen Teams dabei, präzisere Anweisungen für Sprachmodelle zu formulieren, die Ausgabequalität zu verbessern und vermeidbare Fehler zu reduzieren. OpenAI beschreibt Prompt Engineering als das Verfassen effektiver Anweisungen, damit Modelle Inhalte liefern, die den Anforderungen entsprechen. Anthropic merkt an, dass Prompt Engineering am besten funktioniert, wenn Erfolgskriterien durch das Prompting steuerbar sind.
Für Unternehmen ist Prompt Engineering längst keine bloße Fähigkeit zur persönlichen Produktivitätssteigerung mehr. Es beeinflusst heute Modellkosten, Latenz, Zuverlässigkeit, Compliance und die Benutzererfahrung. Ein Prompt, der drei Sätze zur Begründung hinzufügt, kann die Token-Kosten bei einer Million Anfragen pro Monat verdoppeln. Ein Prompt, der einem Agenten unsicheren Zugriff auf Tools gewährt, kann einen Sicherheitsvorfall bei der Zugriffskontrolle darstellen.
Dieser Leitfaden erläutert die nützlichsten Methoden des Prompt Engineerings, wann sie jeweils anzuwenden sind und wo die Disziplin auf Prompt-Ebene mit der Governance des AI-Gateways verknüpft werden muss. Zudem wird erklärt, wie TrueFoundry Teams dabei unterstützt, Prompts, Modelle, MCP-Tools, Budgets und Agenten in der Produktion zu steuern.
Prompt Engineering ist die Praxis, LLM-Prompts so zu gestalten, dass sie zuverlässige, präzise und korrekt formatierte KI-Ausgaben erzeugen. Es ist die wichtigste Schnittstelle zwischen menschlicher Absicht und dem Verhalten von KI-Modellen. Die Qualität dieser Schnittstelle wirkt sich direkt auf die Zuverlässigkeit, die Kosten, die Sicherheit und den Nutzen der Anwendung bei verschiedenen Aufgaben aus.
Die Disziplin hat sich von der Formulierung prägnanter Anweisungen für einfache Fragen hin zur Architektur von Prompts für agentische Workflows entwickelt. Ein moderner Prompt kann Eingabevariablen, Regeln für strukturierte Ausgaben, zusätzlichen Kontext, Modelleinstellungen, Leitplanken (Guardrails) und Richtlinienanforderungen für den produktiven Einsatz enthalten.
Die praktische Konsequenz ist eindeutig: Teams, die Prompts als Wegwerf-Text betrachten, liefern oft KI-Anwendungen von geringerer Qualität. Teams, die systematische Prompt-Engineering-Techniken mit Versionierung, Evaluierung und Governance anwenden, haben bessere Chancen auf präzise Antworten und überzeugendere Ergebnisse.
TrueFoundrys Prompt-Management spiegelt diesen Wandel wider. Ein gespeicherter Prompt bündelt Systemnachricht, Benutzernachricht, Eingabevariablen, Guardrails und die Konfiguration für strukturierte Ausgaben in einem versionierten Objekt. Anwendungen können über einen eindeutigen Namen darauf verweisen, anstatt den Prompt-Text direkt einzubetten.
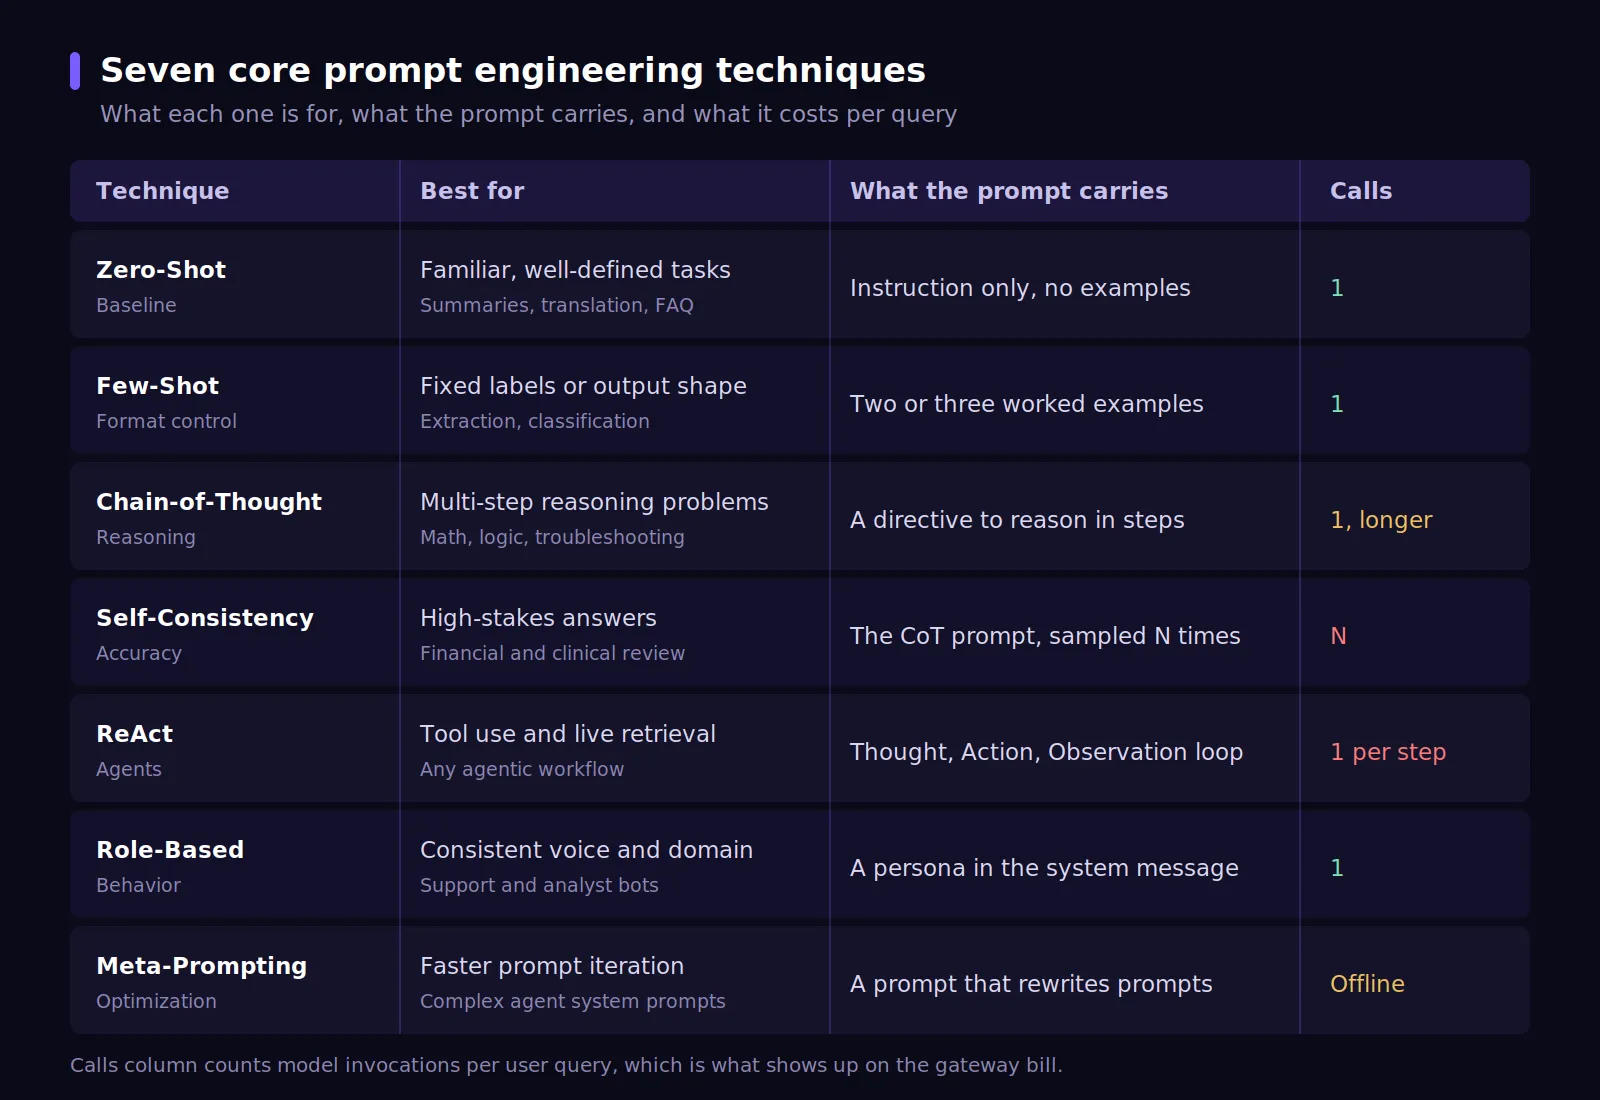
Sieben grundlegende Prompt-Engineering-Techniken decken den Großteil der produktiven Arbeit ab. Betrachten Sie diese als eine Entwicklung. Jede einzelne bringt mehr Genauigkeit, Struktur oder Kontrolle. Gleichzeitig erfordern sie jedoch einen höheren Aufwand in Bezug auf Token-Verbrauch, Latenz, Wartung oder Governance-Komplexität.
Beim Zero-Shot-Prompting wird das Large Language Model aufgefordert, eine spezifische Aufgabe ohne vorherige Beispiele zu erledigen. Das Modell stützt sich dabei allein auf seine Trainingsdaten und seinen gesunden Menschenverstand, um das korrekte Antwortformat, den Inhalt und den Tonfall aus der Anweisung abzuleiten.
Am besten geeignet für: Klar definierte Aufgaben, bei denen das Modell das Muster bereits versteht. Beispiele hierfür sind Zusammenfassungen, Übersetzungen, einfache Klassifizierungen, die Beantwortung von FAQs und das Extrahieren relevanter Fakten aus kurzen Eingaben.
Einschränkung: Die Zuverlässigkeit von Zero-Shot-Ansätzen sinkt, wenn die gewünschte Aufgabe ein striktes Format oder domänenspezifisches Verhalten erfordert. Das Scheitern bleibt oft unbemerkt. Ein Zero-Shot-Klassifikator liefert ein plausibles Label statt einer Fehlermeldung, sodass sich der Fehler erst später durch schlechte Analysedaten oder eine geringere Nutzerzufriedenheit bemerkbar macht.
Beim Few-Shot-Prompting werden vor der eigentlichen Anfrage ein oder mehrere Beispiele für Eingabe und Ausgabe bereitgestellt. Diese detaillierten Beispiele geben dem Modell ein konkretes Muster vor, dem es folgen kann – besonders dann, wenn die gewünschte Ausgabe einen bestimmten Tonfall, ein festes Schema, einen vorgegebenen Labelsatz oder eine bestimmte Schreibstruktur erfordert.
Ideal für: Aufgaben, bei denen die Form der Ausgabe entscheidend ist. Nutzen Sie es für Klassifizierungen mit festen Labels, die Extraktion strukturierter Daten, die Anpassung an einen bestimmten Stil, domänenspezifische Tonalität und Anforderungen an ein wiederholbares Format.
Anzahl der Beispiele: Zwei bis drei Beispiele reichen für viele produktive Aufgaben oft aus. Mehr Beispiele können die Qualität des Prompts verbessern, allerdings kostet jede Anfrage entsprechend mehr Token. Teams sollten das Kosten-Nutzen-Verhältnis abwägen, bevor sie längere Prompts für Endpunkte mit hohem Volumen verwenden.
Beim Chain-of-Thought-Prompting wird das Modell dazu angehalten, Zwischenschritte zu durchdenken, bevor es die endgültige Antwort generiert. Dies kann die Leistung bei mathematischen Problemen, logischen Aufgaben, Fehlerbehebungsprozessen oder Programmieraufgaben verbessern, bei denen die logische Herleitung das Ergebnis beeinflusst.
Ideal für: Komplexe logische Schlussfolgerungen, Entscheidungsbäume, technische Diagnosen, Finanzanalysen und anspruchsvolle Denkaufgaben. Es funktioniert am besten, wenn der Prompt eine durchdachte Problemlösung anstelle einer kurzen Antwort verlangt.
Zero-Shot-CoT: Das Hinzufügen einer Anweisung zur schrittweisen Herleitung kann das Chain-of-Thought-Verhalten aktivieren, ohne dass explizite Beispiele für logische Ketten erforderlich sind. Dies ist eine einfache Methode, um die logische Leistung bei komplexen Aufgaben zu steigern.
Kombination mit Few-Shot: Few-Shot-Beispiele, die logische Herleitungen enthalten, können die Leistung bei domänenspezifischen Arbeitsabläufen verbessern. Teams sollten die angezeigte Antwort kurz halten, wenn Nutzer nur das Endergebnis benötigen.
Ein operativer Aspekt ist hierbei wichtig: Die Ausgabe bei Chain-of-Thought ist lang, und genau diese langen Ausgaben streamen Teams, um die wahrgenommene Latenz gering zu halten. Die Dokumentation zu den Guardrails von TrueFoundry guardrails documentation besagt, dass Output-Guardrails übersprungen werden, wenn eine Anfrage `stream: true` enthält, da keine vollständige Antwort zur Überprüfung vorliegt. Eine gestreamte Herleitung wird von keiner Output-Richtlinie kontrolliert.
Selbstkonsistenz erweitert das Chain-of-Thought-Prompting, indem für dieselbe Frage mehrere unabhängige logische Ketten generiert werden. Das System wählt anschließend die Antwort aus, die über alle Stichproben hinweg am konsistentesten ist.
Ideal für: Anspruchsvolle Aufgaben, bei denen die Genauigkeit der Antwort wichtiger ist als die Inferenzkosten. Beispiele hierfür sind Risikoprüfungen, juristische Analysen, Finanzanalysen, Fallstudien und sicherheitskritische Empfehlungen.
Kostenabwägung: Selbstkonsistenz erfordert mehrere Modellaufrufe pro Abfrage. Fünf Stichprobenketten machen aus einer abrechenbaren Anfrage fünf. Die Durchsetzung von Budgets pro Team über ein AI Gateway ist unerlässlich, wenn Teams diese Methode in großem Maßstab anwenden.
ReAct-Prompting kombiniert Denken und Handeln. Das Modell wechselt zwischen einem Gedankenschritt, einem Handlungsschritt und einem Beobachtungsschritt. Dieses Muster ermöglicht es dem Modell, nachzudenken, externe Tools aufzurufen, das Ergebnis zu lesen und fortzufahren, bis die Aufgabe abgeschlossen ist.
Ideal für: Agentenbasierte Workflows, die Informationsabruf, Tool-Ausführung, Echtzeit-Kontext oder die Erledigung mehrstufiger Aufgaben erfordern. ReAct ist nützlich, wenn ein KI-Assistent mit Datenbanken, APIs, SaaS-Tools oder internen Systemen interagieren muss.
ReAct verändert die Sicherheitsfrage. Der Prompt formt nicht mehr nur den Text. Er beeinflusst auch die Tool-Auswahl und die Abfolge der Aktionen. Wenn Tools mit Geschäftssystemen interagieren, fungiert das MCP Gateway als Durchsetzungsebene für Berechtigungen, Validierung und Audit-Logging.
Beim rollenbasierten Prompting wird dem Modell auf System-Prompt-Ebene eine spezifische Persona, ein Fachbereich oder ein Verhaltenskontext zugewiesen. „Du bist ein leitender Finanzanalyst, der ein Kundenportfolio überprüft“ erzeugt andere Denkmuster und Ausgabestile als dieselbe Frage ohne Rollenzuweisung.
Ideal für: Domänenspezifische Anwendungen, Kundendienst-Agenten mit definierten Personas, technische Support-Bots und jede Anwendung, bei der ein konsistenter Tonfall und Verhaltenskontext über alle Interaktionen hinweg wichtig sind.
Unternehmenseinsatz: Rollenbasierte System-Prompts sind ein primärer Mechanismus zur Durchsetzung von Verhaltensleitplanken auf Anwendungsebene, bevor eine Ausgabefilterung auf Infrastrukturebene erfolgt.
Beachten Sie eine Grenze, die die meisten Teams überrascht. Die Guardrail-Dokumentation von TrueFoundry bestätigt, dass System-Prompts standardmäßig von der Guardrail-Bewertung ausgeschlossen sind, sodass die Rollendefinition selbst niemals überprüft, blockiert oder redigiert wird. Persona-Anweisungen formen das Verhalten, fungieren jedoch nicht als Richtlinie, die von der Infrastruktur verifiziert wird.
Beim Meta-Prompting wird das LLM dazu genutzt, Prompts zu analysieren, zu kritisieren und zu verbessern, anstatt direkt Aufgaben für Endnutzer auszuführen. Prompt-Engineers können damit schneller Entwürfe generieren, gängige Muster vergleichen und Anweisungen verfeinern.
Ideal für: Teams, die häufig am Prompt-Design arbeiten und die Optimierung beschleunigen möchten. Es eignet sich besonders für komplexe Aktivitäten, strategische Planung und System-Prompts für Agenten mit vielen Schlüsselelementen.
Hinweis für die Produktion: Meta-Prompting generiert Prompt-Kandidaten, die vor der Implementierung in der Produktion dennoch anhand eines Testdatensatzes evaluiert werden müssen. Es beschleunigt die Erstellung von Entwürfen, nicht den Validierungsprozess.
Ein systematischer Workflow zur Prompt-Optimierung stellt sicher, dass diese Unterscheidung gewahrt bleibt, indem Kandidaten anhand eines festen Evaluationsdatensatzes bewertet werden, anstatt sich auf den subjektiven Eindruck eines Prüfers zu verlassen.
Die folgenden fortgeschrittenen Techniken erfordern mehr Rechenleistung oder Designaufwand, bieten jedoch Vorteile bei Problemen, die mit einfacheren Methoden nur schwer zu lösen sind. Setzen Sie diese ein, wenn ein Evaluationsdatensatz zeigt, dass einfachere Ansätze an ihre Grenzen stoßen.
Tree-of-Thought erweitert das lineare Chain-of-Thought-Prompting um eine verzweigte Struktur. Das Modell erkundet mehrere Argumentationspfade, bewertet potenzielle Lösungen und wählt den vielversprechendsten Zweig für die weitere Bearbeitung aus.
Ideal für: Probleme, bei denen der Lösungsweg nicht unmittelbar aus der Aufgabenstellung hervorgeht. Beispiele hierfür sind die Synthese von Forschungsergebnissen, kreative Arbeiten wie das Schreiben von Kurzgeschichten, Strategieentwicklung, komplexe Fehlersuche und ergebnisoffene Planung.
Tree-of-Thought kann die Ergebnisse bei schwierigen logischen Aufgaben verbessern. Da die Kosten jedoch mit dem Verzweigungsfaktor und der Tiefe skalieren, sind Budgetobergrenzen wichtig, bevor die Technik in kundenorientierten Endpunkten eingesetzt wird.
Beim Constitutional Prompting wird ein Regelwerk in den System-Prompt eingebettet. Das Modell nutzt diese Prinzipien, um seine eigene Antwort zu bewerten und zu überarbeiten, bevor es das Ergebnis ausgibt.
Ideal für: KI-Anwendungen, bei denen die konsequente Einhaltung von Unternehmenswerten, Sicherheitsrichtlinien oder Compliance-Standards entscheidend ist. Es hilft dabei, das Verhalten des Modells bereits vor der nachgelagerten Filterung zu steuern.
Betrachten Sie die Konstitution als Qualitätskontrolle, nicht als Audit-Kontrolle. Die Prinzipien sind im System-Prompt verankert. Compliance-Nachweise sollten aus Leitplanken, Traces, Richtlinienergebnissen und Protokollen stammen, die das Modell nicht beeinflussen kann.
Directional Stimulus Prompting fügt einen kurzen Hinweis, ein Schlüsselwort oder ein Steuersignal hinzu, um das Modell auf die relevantesten Informationen zu lenken. Dies ist hilfreich, wenn der Basis-Prompt zwar klar ist, das Modell aber einen stärkeren Impuls benötigt, worauf es ankommt.
Am besten geeignet für: Klassifizierungs-, Zusammenfassungs- und Extraktionsaufgaben, bei denen ein kleiner Richtungsweiser den Fokus schärft. So kann beispielsweise bei einer Zusammenfassung zum Klimawandel ein Stimulus wie „politische Auswirkungen“ die Aufmerksamkeit gezielt lenken.
Dies ist eine fortgeschrittene Technik, da kleine Hinweise die Antwort unerwartet verändern können. Teams sollten die Leistung mit einer Baseline vergleichen und sicherstellen, dass der Stimulus das gewünschte Ergebnis verbessert, ohne andere Fälle zu beeinträchtigen.
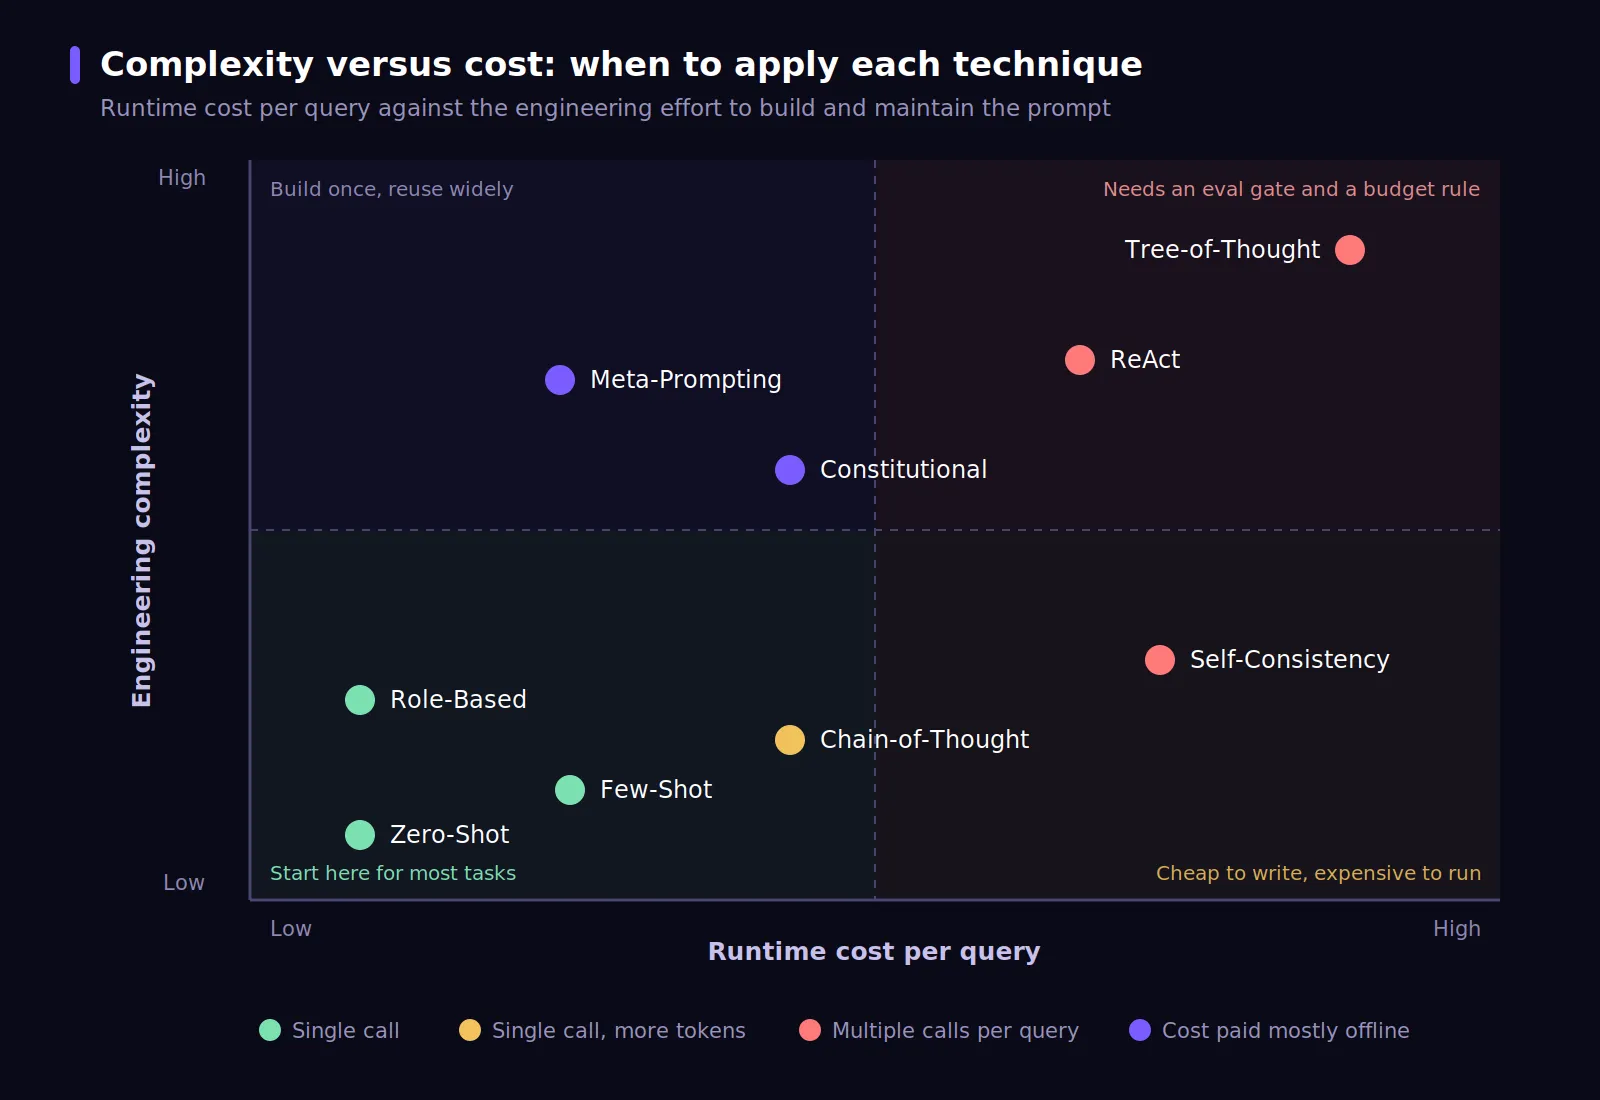
Individuelle Prompt-Engineering-Methoden funktionieren in kontrollierten Tests anders als in Produktionsumgebungen mit echten Nutzern. Mehrere betriebliche Realitäten beeinflussen, welche Techniken praktikabel bleiben, sobald Verkehrsaufkommen, Kosten, Risiken und Governance zunehmen.
Die integrierte Prompt-Injection-Leitplanke von TrueFoundry läuft nur im Validierungsmodus und analysiert den Benutzer-Prompt sowie alle Dokument- oder Kontextinhalte als zwei separate Oberflächen. Die Trennung der Analyse ist wichtig, da indirekte Injections innerhalb abgerufener Dokumente auftreten und nicht in der Nachricht des Benutzers selbst.
Prompt-Engineering-Techniken bestimmen, wie gut ein LLM eine Aufgabe versteht und ausführt. Die Governance-Ebene bestimmt, ob diese Ausführung sicher, innerhalb von Kostenrahmen sowie mit den für den Unternehmenseinsatz erforderlichen Zugriffskontrollen und Audit-Nachweisen erfolgt.
Das AI Gateway von TrueFoundry wendet eine Eingabefilterung an, bevor Prompts ein Modell erreichen, und fängt Prompt-Injection-Versuche ab, unabhängig davon, wie ausgefeilt die Prompt-Engineering-Methoden des Systems sind. Output-Guardrails wenden Inhaltsrichtlinien an, bevor Antworten an Anwendungen zurückgegeben werden, und ergänzen so das konstitutionelle Prompting auf Modellebene, anstatt es zu ersetzen.
Das Ausführungsmodell belohnt genaues Hinsehen. Guardrails zur Eingabevalidierung laufen parallel zur Modellanfrage. Wenn die Validierung während des Vorgangs fehlschlägt, bricht das Gateway die Modellanfrage ab, sodass der blockierte Prompt keine Kosten verursacht. Guardrails zur Eingabemodifikation, wie etwa die Schwärzung von PII, laufen hingegen vor der Anfrage, da sie die Payload umschreiben, die das Modell erhält.
Jeder Guardrail erscheint im Request-Trace als eigener Span mit Latenz, Ergebnis, Umfang und der Entität, auf die er angewendet wurde. Das Rollout folgt den Erkenntnissen: Regeln zunächst im Audit-Modus starten, dann auf „Enforce, But Ignore On Error“ hochstufen und schließlich auf „Enforce“ setzen, sobald die Ergebnisse korrekt aussehen.
Guardrails können pro Anfrage über den Header `X-TFY-GUARDRAILS` oder zentral als Richtlinien unter AI Gateway → Controls → Guardrails für die unternehmensweite Durchsetzung angehängt werden.
{
  "llm_input_guardrails": ["my-group/prompt-injection"],
  "llm_output_guardrails": ["my-group/secrets-detection"],
  "mcp_tool_pre_invoke_guardrails": ["my-group/sql-sanitizer"],
  "mcp_tool_post_invoke_guardrails": ["my-group/code-safety"]
}
Team-spezifische Token-Budgets, die durch das LLM-Gateway durchgesetzt werden, verhindern Kostenüberschreitungen, die bei Self-Consistency- und Tree-of-Thought-Techniken ohne entsprechende Kostengovernance im großen Maßstab entstehen können. Ratenbegrenzungsregeln akzeptieren sowohl Token-Einheiten als auch Anfrage-Einheiten, und `rate_limit_applies_per` erstellt einen unabhängigen Zähler pro Benutzer, pro Modell oder pro Metadaten-Schlüssel.
name: ratelimiting-config
type: gateway-rate-limiting-config
rules:
  # Cap the reasoning-heavy service that runs self-consistency
  - id: "reasoning-service-hourly"
    when:
      metadata:
        service: "risk-analysis"
    limit_to: 200000
    unit: tokens_per_hour

  # Give every user an independent daily token ceiling
  - id: "user-daily-limit"
    when: {}
    limit_to: 1000000
    unit: tokens_per_day
    rate_limit_applies_per: ['user']
Budgetregeln fügen Dollar-Obergrenzen pro Benutzer, Team, Modell, virtuellem Konto oder Metadaten-Schlüssel hinzu. Meilenstein-Benachrichtigungen und der Audit-Modus helfen Teams dabei, Schwellenwerte zu kalibrieren, bevor die Durchsetzung den Datenverkehr blockiert.
Anwendungen können einen gesteuerten Prompt über den FQN der Version aufrufen, anstatt Text mit der Anwendung auszuliefern. Dies hält Prompt-Änderungen aus dem Release-Zyklus heraus. Das Gateway rendert die Vorlage und führt den Aufruf aus.
from openai import OpenAI

client = OpenAI(
    api_key="your-tfy-api-key",
    base_url="{GATEWAY_BASE_URL}"
)

response = client.chat.completions.create(
    messages=[],
    model="",
    extra_headers={
        "X-TFY-METADATA": '{"service":"risk-analysis","env":"production"}',
    },
    extra_body={
        "prompt_version_fqn": "chat_prompt:truefoundry/default/cot-risk-review:3",
        "prompt_variables": {
            "portfolio_id": "PF-4471",
            "review_window": "Q3"
        }
    },
)

print(response.choices[0].message.content)
Zwei Details bei diesem Aufruf sind entscheidend. Die Versionsfixierung bedeutet, dass für ein Rollback eines Prompts kein erneutes Deployment erforderlich ist, und der Header `X-TFY-METADATA` sorgt dafür, dass dienstspezifische Budgets, Ratenbegrenzungen und Kostenzuordnung einem tatsächlichen Eigentümer zugeordnet werden können.
Das Agent Gateway steuert jeden Tool-Aufruf, den ReAct-basierte Agenten tätigen, sodass die Argumentations- und Ausführungsschritte unabhängig voneinander kontrolliert bleiben und jeder Tool-Aufruf den Kontext der Benutzeridentität in seinem Protokoll mitführt.
Das MCP Gateway stellt die Pre-Invocation- und Post-Invocation-Hooks bereit, die dies durchsetzen. Dabei bewerten Guardrails jeden Tool-Aufruf einzeln und nicht nur einmal pro Konversation. Ein Agent, der nacheinander fünf Tools aufruft, durchläuft also fünf Prüfzyklen.
Pre-Invocation-Hooks stoppen die Aktion, bevor sie ausgeführt wird, und decken dabei Parametervalidierung, SQL-Sanitierung sowie Berechtigungsprüfungen ab, die als Cedar- oder OPA-Richtlinien definiert sind. Post-Invocation-Hooks untersuchen die Ausgabe des Tools und erkennen indirekte Injektionen sowie durchgesickerte Geheimnisse, bevor diese im Beobachtungsschritt wieder in den Kontext des Modells zurückgeführt werden.
Erstellen Sie Prompt-Workflows, die auch in der Produktion sicher und kontrolliert bleiben. Demo buchen um zu sehen, wie TrueFoundry Prompt-Registry, Guardrails, Budgetkontrollen und Audit-Logs in Ihrem AI Gateway miteinander verbindet.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet




















