



November 6, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Die OWASP Top 10 für Large Language Model-Anwendungen sind eine konsensbasierte Liste der kritischsten Sicherheitsrisiken in LLM-gestützter Software, die vom OWASP GenAI Security Project gepflegt wird. Die aktuelle Version ist die Liste von 2025 unter genai.owasp.org/llm-top-10. Die Version 1.1 von 2023/24 ist dort weiterhin archiviert und wird noch häufig zitiert – wenn also ein Beitrag von Modell-Diebstahl oder übermäßigem Vertrauenspricht, bezieht er sich auf die veraltete Version.
Die Liste von 2025 in der Veröffentlichung von OWASP:
Die Änderungen zeigen, wohin sich der Fokus verlagert hat. System-Prompt-Leakage und Schwachstellen bei Vektoren und Embeddings sind neu hinzugekommen. Modell-Denial-of-Service wurde zum umfassenderen Unbegrenzter Verbrauch. Unsicheres Plugin-Design in die Lieferkette integriert und mit übermäßiger Handlungsfähigkeit ausgestattet, während sich die Tools um Protokolle wie MCP herum etablierten. Modell-Diebstahl ist komplett weggefallen.
Das ist der Teil, den die meisten Berichte auslassen. Die Top-10-Listen Risiken, und ein Risiko ist kein Produktmerkmal. Vier davon betreffen den Inferenzpfad, an dem ein Gateway ansetzt. Drei gehören zum Anwendungscode. Drei betreffen Pipelines, die ein Gateway niemals sieht.
Vier liegen direkt im Zuständigkeitsbereich, drei teilweise, und drei erfordern einen Verantwortlichen an anderer Stelle. Wenn Ihr KI-Sicherheits-Framework eine Gateway-Zeile für LLM04 und LLM08 enthält, ist diese Zeile reine Dekoration.
Ein Gateway deckt LLM01, LLM02, LLM06 und LLM10 gut ab, da alle vier Anfragepfad- Probleme sind: Sie treten in dem Moment auf, in dem ein Prompt gesendet oder ein Tool ausgelöst wird – also genau in dem Moment, den ein Gateway erfassen kann. Die anderen wurden bereits Wochen zuvor entschieden, während eines Trainingslaufs oder eines Indexierungsvorgangs.
Die Liste als Compliance-Checkliste zu behandeln. OWASP veröffentlicht eine Risikotaxonomie mit Leitfäden zur Risikominderung, keine Zertifizierung. Es gibt kein OWASP LLM Top 10-Audit und keine Stelle, die ein Zertifikat ausstellt. Eine Matrix, die behauptet, alle zehn Punkte würden durch ein einziges Tool „abgedeckt“, ist dazu geschrieben, ein Meeting zu überstehen, nicht einen Angriff.
Ausgabeprüfung an der falschen Stelle. LLM05 befasst sich damit, was Ihre Anwendung mit der Modellausgabe macht. Ein Gateway kann zwar kennzeichnen, dass eine Antwort os.system oder ein nicht maskiertes Skript-Tag enthält, es kann jedoch nicht verhindern, dass Ihr Dienst diese Zeichenfolge an eine Shell weitergibt. Die Kontrolle muss dort liegen, wo die Ausgabe verarbeitet wird; die Gateway-Prüfung dient lediglich als zusätzliche Verteidigungsebene.
Die Annahme, dass Erkennung gleich Prävention ist. Erkennung ist ein Klassifikator, und Klassifikatoren haben falsch-negative Ergebnisse, gegen die Angreifer vorgehen. Die dauerhafte Schadensbegrenzung für LLM01 besteht darin, davon auszugehen, dass eine Injektion gelegentlich erfolgreich ist, und das System so zu gestalten, dass es dies übersteht – was eigentlich ein LLM06-Problem ist. Schränken Sie die Werkzeugoberfläche ein, damit eine erfolgreiche Injektion das Modell erreicht, ohne dass gefährliche Funktionen aufgerufen werden können.
LLM10 als reines Abrechnungsproblem ignorieren. Ein Agent, der in einer Endlosschleife feststeckt, ist ein Denial-of-Service-Angriff auf Ihr eigenes Budget, und Abfragen mit hohem Volumen sind die Grundlage für Modellextraktion. Dies ist die am einfachsten zu schließende Sicherheitslücke, die jedoch am häufigsten offen gelassen wird.
Das AI Gateway von TrueFoundry implementiert diese Kontrollen als Guardrails an Hooks im Anforderungspfad. Es gibt vier davon, und welche Risiken Sie angehen können, hängt davon ab, an welchem Hook Sie sich befinden.
Für LLM-Anfragen: input, bevor der Prompt das Modell erreicht, und output, nachdem es geantwortet hat.

Für MCP-Tool-Aufrufe: mcp_pre_tool, bevor das Tool ausgeführt wird, und mcp_post_tool, nachdem es ein Ergebnis zurückgibt.
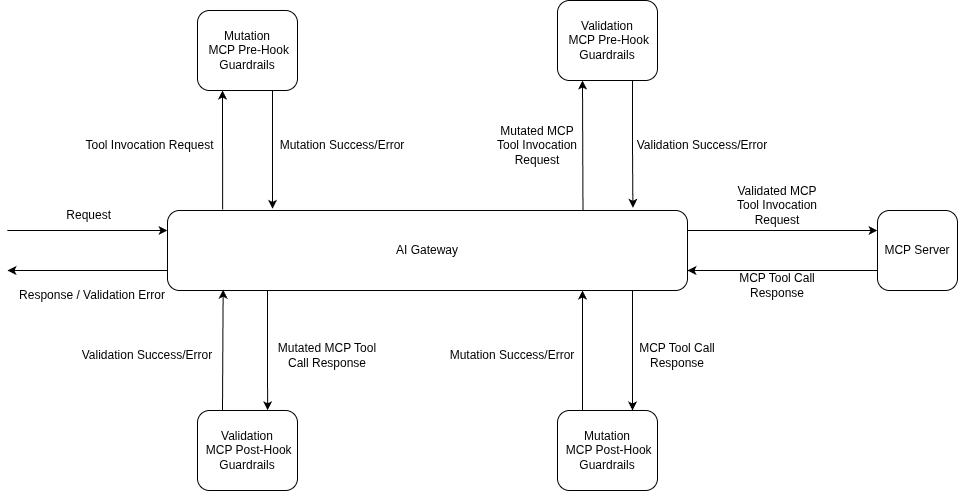
Diese MCP-Hooks machen das OWASP MCP Frage handhabbar. Guardrails laufen bei jedem Tool-Aufruf separat – fünf Tools hintereinander bedeuten fünf Prüfdurchläufe. Ein Fehler vor dem Tool-Aufruf verhindert dessen Ausführung; ein Fehler nach dem Tool-Aufruf hält das Ergebnis zurück.
Jedes Guardrail verfügt über einen Betriebsmodus – „validate“ prüft und kann blockieren, „mutate“ schreibt zusätzlich um – sowie eine Durchsetzungsstrategie für Verstöße und Guardrail-Fehler:
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




Eine Konsensliste der zehn kritischsten Sicherheitsrisiken in LLM-Anwendungen, herausgegeben vom OWASP GenAI Security Project. Die aktuelle Version ist die Liste von 2025: Prompt Injection, Offenlegung sensibler Informationen, Lieferkette, Daten- und Modell-Poisoning, unsachgemäße Ausgabeverarbeitung, übermäßige Handlungsbefugnis, Leck des System-Prompts, Schwächen bei Vektoren und Embeddings, Fehlinformationen und unbegrenzter Verbrauch. Es handelt sich um eine Orientierungshilfe, nicht um eine Zertifizierung – es gibt kein Audit, das zu bestehen wäre.
Nein. Ein Gateway sitzt im Anfragepfad und adressiert daher Risiken dieses Pfads gut: Prompt Injection, Offenlegung sensibler Informationen, übermäßige Handlungsbefugnis und unbegrenzten Verbrauch. Bei unsachgemäßer Ausgabeverarbeitung, Fehlinformationen und der Lieferkette hilft es teilweise. Poisoning und Vektorschwächen entstehen in Trainings- und Retrieval-Pipelines, die ein Gateway nie berührt.
Vor allem über LLM06 Excessive Agency und LLM01 Prompt Injection. Ein MCP-Tool-Aufruf ist die Stelle, an der aus einem kompromittierten Prompt eine reale Aktion wird; die entscheidenden Kontrollen liegen daher auf dem Tool-Pfad: ein mcp_pre_tool-Hook, der Argumente vor der Ausführung validiert, ein mcp_post_tool-Hook, der Ergebnisse bereinigt, bevor das Modell sie sieht, Allowlisting auf Tool-Ebene und Freigaben für destruktive Aufrufe. TrueFoundry führt Guardrails für jeden Tool-Aufruf einzeln aus, nicht einmal pro Konversation.
Ja. TrueFoundry läuft in Ihrer VPC, On-Prem, Air-Gapped oder hybrid, sodass Prompts und Antworten Ihre Domäne nie verlassen, auch wenn Sie über viele Anbieter hinweg routen.
Ja. Es umfasst ein MCP Gateway, ein Agent Gateway und eine MCP & Agents Registry mit Zugriffskontrolle auf Tool-Ebene. Agenten auf Basis von LangGraph, CrewAI, AutoGen oder einem eigenen Framework lassen sich alle zentral steuern.
Ja. Das Gateway ist OpenTelemetry-kompatibel und lässt sich in Grafana, Datadog, Prometheus oder Ihren bevorzugten Stack integrieren. Es verfolgt jede Anfrage vom Prompt bis zur Ausführung von Tools und Modellen, sodass Sie eine einheitliche Protokollierung erhalten, ohne Ihre bestehenden Systeme entfernen zu müssen.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet



















