



November 6, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Muse Spark ist die erste Modellfamilie von Meta Superintelligence Labs, die am 8. April 2026 als Ersatz für die Llama-Reihe (Meta AI) vorgestellt wurde. Version 1.3 ist die dritte Iteration und laut Metas Dokumentation der empfohlene Standard für neue Arbeiten.
Die Spezifikationen von der Modell- und Preisseite der Meta Model API (Stand September 2026):
Drei Details sind besonders hervorzuheben.
Es ist kein Open-Weight-Modell. Das ist der erste Punkt, den die meisten falsch verstehen, teils weil Meta jahrelang das Open-Weights-Unternehmen war. Muse Spark 1.3 wird ausschließlich über eine API bereitgestellt. Metas eigene Release-Note schließt mit einem Roadmap-Hinweis ab, der „das Muse Spark Open-Weights-Release“ als zukünftigen Punkt nennt — ein klares Signal, dass dies noch nicht geschehen ist. Wenn Sie Meta-Gewichte benötigen, die Sie heute herunterladen können, heißt das Modell Muse Glimmer: 30B Parameter, dichte Multimodalität, 128K Standard-Kontext, Apache 2.0, destilliert aus Muse Spark (Muse Glimmer Dokumentation). Echte freie Lizenz, viel kleineres Modell. Verwechseln Sie die beiden nicht.
Audio ist speziell in 1.3 beeinträchtigt. In den Fußnoten von Metas Modellseite wird angemerkt, dass Audio-Verständnis in 1.3 „derzeit nicht vollständig unterstützt wird“ und die Antwortqualität leiden kann; es wird empfohlen, stattdessen 1.2 oder das dedizierte Muse Voice Transcribe Modell zu verwenden. Das ist eine ungewöhnliche Regression für ein Minor-Release, und es ist relevant, wenn Ihre Pipeline Audio verarbeitet.
Das Kontextfenster hat einen Festpreis. 1.048.576 Tokens ohne Aufpreis für langen Kontext (in Metas Worten: „no long-context premium“) — derselbe Token-Preis, egal ob das Fenster fast leer oder fast voll ist. Die meisten Provider verlangen ab einem bestimmten Schwellenwert höhere Preise. Dieser hier nicht.
[SCREENSHOT: Meta Model API — das dev.meta.ai Dashboard zeigt den muse-spark-1.3 Modelleintrag und die Tarifauswahl]
Meta stellt 1.3 eher als Usability-Release denn als Leistungssprung dar, und die veröffentlichten Abweichungen stützen diese Sichtweise.
Quelle: Introducing Muse Spark 1.3, Meta AI Research, 2. September 2026.
Die Effizienzzahlen haben eine direkte kommerzielle Auswirkung: Eine Token-Reduzierung um 25 % bei identischer Arbeit entspricht einer Reduzierung der Kostenzeile um 25 %, noch bevor irgendeine Routing-Entscheidung getroffen wird. Aber beachten Sie die Herkunft — es handelt sich um Metas internen Vergleich der Ingenieure, nicht um eine Überprüfung durch Dritte. Die Richtung stimmt höchstwahrscheinlich; das Ausmaß bei Ihren eigenen Workloads müssen Sie selbst messen.
Die Verhaltensänderungen sind leise der interessantere Teil. Ein Modell, das nachfragt, bevor es etwas Unumkehrbares tut, und zugibt, wenn es feststeckt, bietet betrieblich einen ganz anderen Mehrwert als eines, das selbstbewusst fehlerhaft weitermacht. Für langlaufende Agenten-Workflows, bei denen ein schlechter Tool-Aufruf reales Geld kostet, ist das mehr wert als ein Benchmark-Punkt.
Meta veröffentlicht eine Benchmark-Scorecard, die Muse Spark 1.3 mit Muse Spark 1.2, GPT-5.6 Sol und Claude Opus 5 über Agenten-, Coding-, Befolgsamkeits- (Instruction-Following) und Langkontext-Evaluierungen hinweg vergleicht. Die Suite umfasst laut Metas Bericht zur Evaluierungsmethodik:
Die einzelnen Ergebnisse sind [VERIFY]. Meta veröffentlicht sie nur innerhalb einer gerenderten Grafik im Release-Post, nicht als maschinenlesbaren Text. Daher werden in diesem Beitrag keine Zahlen zitiert, die nicht präzise belegt werden können. Entnehmen Sie diese der Scorecard auf Metas Seite, bevor Sie eine Zahl zitieren.
Was der Methodikbericht in Textform aussagt, ist ohnehin nützlicher als die reinen Scores, und drei Vorbehalte sollten jede zitierte Zahl begleiten.
Vergleiche wurden auf unterschiedlichen Effort-Leveln durchgeführt. Muse Spark 1.3, Opus 5 und GPT-5.6 Sol wurden bei maximalem Reasoning-Effort evaluiert; Muse Spark 1.2 bei xhigh. Ein Teil der Differenz zwischen 1.2 und 1.3 resultiert daher aus unterschiedlichen Einstellungen, nicht rein aus Modellunterschieden.
Der OSWorld-Vergleich verwendet nicht dieselbe Version. Jedes Modell wurde auf OSWorld 2.0 Version 08.08 evaluiert, außer Muse Spark 1.2, das auf Version 06.24 lief. Meta legt dies offen, was anzurechnen ist, bedeutet aber, dass diese Zeile kein direkter Vergleich ist.
Ergebnisse sind Best-of-Source. Meta berichtet „den höchsten vergleichbaren Primärmetrik-Wert, der aus unserer Evaluierung, dem offiziellen Leaderboard oder den selbst gemeldeten Ergebnissen des Modellanbieters verfügbar war“. Den besten verfügbaren Wert für jedes Modell in jeder Zeile zu nehmen, ist eine vertretbare Methode, aber es ist kein einzelner kontrollierter Testlauf.
Meta äußert sich auch ungewöhnlich offen zu den Grenzen der eigenen Konkurrenztests und merkt an, dass die Testläufe „möglicherweise nicht für proprietäre Modelle optimiert sind und deren beste anbieteroptimierte Leistung möglicherweise nicht widerspiegeln“. Das ist ein ehrlicher Disclaimer und ein guter Grund, jede Anbieter-Scorecard — einschließlich dieser — als Start-Hypothese und nicht als finales Ergebnis zu betrachten. Der einzige Benchmark, der eine Routing-Entscheidung sichert, ist Ihr eigener Traffic mit Ihren Prompts. Das ist das Hauptargument dafür, eine eigene Evaluierung durchzuführen, bevor Sie sich festlegen.
Meta bietet zwei Tarife an, und der Unterschied zwischen ihnen ist die folgenschwerste Tatsache in diesem gesamten Beitrag.
Quelle: Meta Model API Preiskonditionen und Rate Limits, September 2026.
Der Contributor-Tarif ist beim Input um 92 % und beim Output um 95 % günstiger. Meta kommuniziert den Gegenwert völlig transparent: stark rabattierte Tokens „im Austausch für die Erlaubnis, Ihre Prompts und Vervollständigungen zum Trainieren zukünftiger Meta-Modelle zu verwenden“. Die Modell-IDs sind unterschiedlich — muse-spark-1.3-contributor anstelle von muse-spark-1.3 —, sodass die Entscheidung beim Aufruf explizit getroffen wird und nicht in einer Kontoeinstellung versteckt ist.
Diese Transparenz ist eine gute Praxis. Sie erzeugt aber auch ein spezifisches betriebliches Risiko, auf das wir noch zurückkommen werden.
Zwei weitere Preishinweise: Web-Search-Grounding kostet $2,50 pro 1.000 Suchanfragen zusätzlich zu den Token-Kosten; alles, was das web_search Tool nutzt, verursacht also zusätzliche Kosten. Und maximales Reasoning ist nur im Standard-Tarif verfügbar — der günstige Tarif kann den Modus nicht erreichen, der die Schlagzeilen-Benchmarks erzeugt.
Vier Fehlermodi sind spezifisch für dieses Release und nicht nur allgemeine Begleiterscheinungen der Modellnutzung.
Der Contributor-Tarif ist nur eine Konfigurationszeile von einem Datenvorfall entfernt. Ein Rabatt von 92 % ist genau die Art von Ersparnis, die ein Ingenieur bei einer Kostenüberprüfung anwendet, ohne den zweiten Teil des Satzes zu lesen, und die beiden Modell-IDs unterscheiden sich nur durch ein Suffix. Wenn ein Entwickler einen Produktionsdienst auf muse-spark-1.3-contributor umstellt, um ein Budgetziel zu erreichen, werden Kundenprompts zu Meta-Trainingsdaten, während sich in der Anwendung äußerlich nichts ändert. Das muss an zentraler Stelle durchgesetzt werden, da es nicht zuverlässig in jedem einzelnen Repository kontrolliert werden kann.
Rate Limits gelten pro Team, nicht pro Key. Meta drückt sich klar aus: Alle API Keys innerhalb eines Teams teilen sich das Budget von 3.000 RPM und 4M TPM. Das Ausstellen eines Keys pro Dienst partitioniert die Kapazität nicht, sodass ein einzelner fehlerhafter Batch-Job ein interaktives Produkt blockieren kann. Metas Rat lautet, den Header x-ratelimit-remaining-tokens auszulesen und Drosselungen vorzunehmen, bevor das Limit erreicht wird — was bedeutet, dass eine Komponente in Ihrem Stack dies auch tatsächlich verarbeiten muss.
Geschlossene Gewichte (Closed Weights) beenden die Diskussion über Datenresidenz frühzeitig. Bei einem Open-Weight-Modell können Sie darüber diskutieren, wo es ausgeführt werden soll. Hier gibt es nur eine Antwort: Prompts gehen an Metas API. Ihre Rechtsabteilung entscheidet, was akzeptabel ist; der Punkt ist, dass die Ausweichmöglichkeit des Self-Hostings, die für Muse Glimmer existiert, für Muse Spark nicht vorhanden ist.
Die Modelliteration ist schnell. Drei Versionen zwischen April und September 2026, etwa vier Wochen zwischen 1.2 und 1.3, und eine dokumentierte Audio-Regression in einem Minor-Release. Jede Integration, die einen Modell-String fest im Code hinterlegt, muss früher überarbeitet werden, als es der Planungszyklus vorsieht — wofür virtuelle Modellnamen und gestaffelte Umstellungen gedacht sind.
Ein geschlossenes Modell verändert den Zweck eines Gateways. Bei einem Open-Weight-Release besteht die Aufgabe des Gateways in der Portabilität. Hier geht es um Kontrolle, Zuordnung (Attribution) und die Möglichkeit, Entscheidungen anzupassen.
Machen Sie den Tarif zu einer Policy, nicht zu einer Präferenz. Die Contributor-Entscheidung sollte einmalig von den verantwortlichen Personen getroffen und dann durchgesetzt werden. Policy Enforcement auf Gateway-Ebene ermöglicht es Ihnen, muse-spark-1.3 für Produktionsdienste freizugeben und die Contributor-Variante auf eine Sandbox zu beschränken — oder sie komplett zu blockieren. Anwendungen fordern einen Modellnamen an; das Gateway entscheidet, worauf dieser verweist.
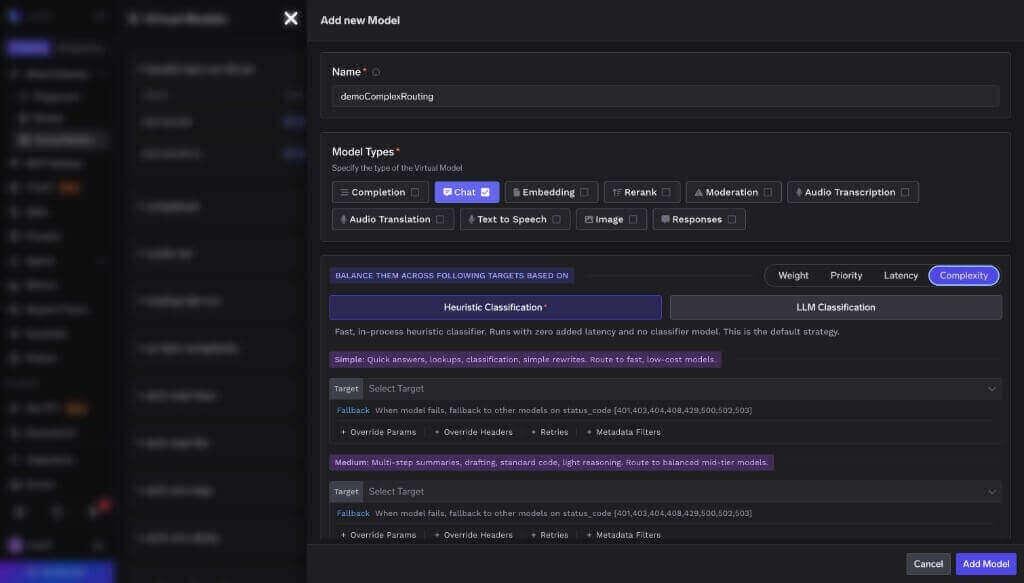
Routen Sie nach Aufgabe, nicht nach Anbieterloyalität. Metas eigene Scorecard positioniert 1.3 gegen Opus 5 und GPT-5.6 Sol, anstatt zu behaupten, sie überall zu schlagen — was für eine gemischte Modell-Flotte spricht. Langlaufende Agenten-Workflows und Aufgaben mit Kontexten im Bereich von einer Million Tokens gehen an Muse Spark; andere Aufgaben gehen dorthin, wo sie besser aufgehoben sind. Im Auto-Routing-Benchmark von TrueFoundry über 550 Prompts hinweg senkte eine solche Priorisierung der Anfragen die Kosten um 69 % bei Erhalt von 98 % der Basisqualität, wobei die durchschnittliche Latenz von 7,6 s auf 4,0 s sank; bei produktionsnahem Traffic erreichte die Reduzierung 80 %.
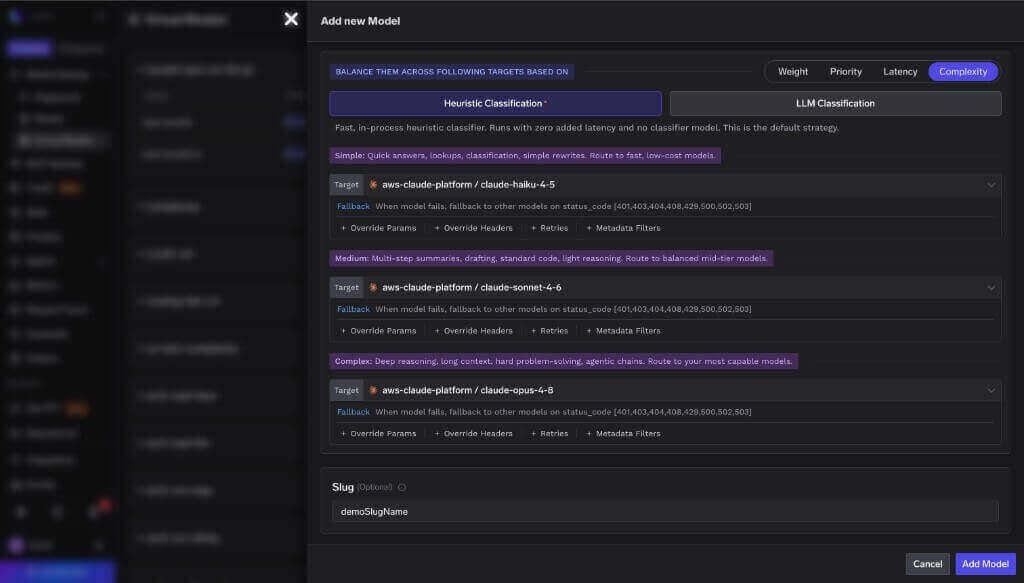
Fangen Sie das gemeinsame Rate Limit ab. Da Metas Kontingent pro Team gilt, ist das Gateway der natürliche Ort zur Verwaltung: Rate Limiting pro nutzendem Team, Warteschlangen (Queueing) und Failover zu einem anderen Provider, wenn Meta einen 429-Fehler zurückgibt. Ein gemeinsames Budget erfordert eine zentrale Stelle, die es steuert.
Behalten Sie Ihre eigenen Guardrails. Meta berichtet von einer verbesserten Resistenz gegen Prompt Injection in 1.3, was begrüßenswert ist, aber keine Kontrolle darstellt, die Sie selbst besitzen. Gateway-Guardrails werden unabhängig davon ausgeführt, welcher Provider antwortet, sodass sich Ihre Richtlinien nicht ändern, wenn Sie das Modell wechseln.

Überprüfen Sie das Effizienzversprechen. Meta gibt an, dass 1.3 ~25 % weniger Tokens verbraucht als 1.2. Die Ermittlung der Kosten pro Anfrage und die Token-Zuordnung nach Teams ist der Weg, dies für Ihren eigenen Traffic zu bestätigen, anstatt es ungeprüft zu übernehmen.

Die Kurzfassung (Stand September 2026):

[SCREENSHOT: Muse Code — Terminal-Sitzung, die einen Agenten-Workflow auf Muse Spark 1.3 zeigt]
Muse Spark 1.3 ist ein solides, unspektakuläres Release — und genau das Unschnörkelige ist der entscheidende Punkt. Meta hat keinen neuen Durchbruch für sich beansprucht. Das Unternehmen verspricht weniger Tool-Aufrufe, weniger Tokens, besseres Verhalten in langen Threads und eine bessere Einschätzung bei unumkehrbaren Aktionen — also genau die Faktoren, die darüber entscheiden, ob ein Agenten-Workflow sauber abgeschlossen wird oder einen Nachmittag an Ressourcen verbrennt. Für ein Team, das bereits über mehrere Provider hinweg routet, ist es damit eine ernstzunehmende vierte Option für langlaufende Agenten-Workflows, mit dem fest gepreisten Kontextfenster von einer Million Tokens als Alleinstellungsmerkmal.
Seien Sie sich jedoch der Schwachstellen bewusst. Die Gewichte sind geschlossen, sodass die Argumente für Portabilität und Datenresidenz, die ein Open-Weight-Modell interessant machen, hier nicht greifen — und wenn Sie nach Metas offenem Modell gesucht haben, ist das Muse Glimmer, ein deutlich kleineres Modell. Die Audioverarbeitung hat sich in diesem Release verschlechtert. Die Spitzen-Ergebnisse wurden als Bild veröffentlicht, teilweise unter ungleichen Einstellungen gemessen und basieren auf Best-of-Source-Werten. Und die günstigste Option zur Nutzung kostet Sie Ihre Prompts.
Das führt zum ehrlichen Fazit: Es kommt darauf an, was Sie selbst kontrollieren möchten. Wenn Sie Metas bestes Modell nutzen wollen, mieten Sie es zu Metas Bedingungen. Die wesentliche Entscheidung ist dann nicht, ob Sie es einsetzen, sondern wo die Tarif-Policy verwaltet wird und wer sie ändern kann. Verankern Sie diese Entscheidung hinter einem Gateway, bevor das erste Team die Anbindung direkt vornimmt — so kostet Sie das Hinzufügen von Muse Spark 1.3 zur Modell-Rotation lediglich eine Konfigurationsänderung statt einer Migration.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




Muse Spark ist die Modellfamilie von Meta Superintelligence Labs, vorgestellt am 8. April 2026 und inzwischen Nachfolger von Metas Llama-Reihe. Muse Spark 1.3, veröffentlicht am 2. September 2026, ist die aktuelle Version, mit einem Kontextfenster von 1.048.576 Tokens und Text-, Bild-, Video- und PDF-Eingabe.
Nein. Muse Spark 1.3 ist geschlossen und nur per API verfügbar. Metas Release-Beitrag nennt eine Veröffentlichung offener Gewichte als künftigen Roadmap-Punkt. Das heute verfügbare Open-Weight-Modell von Meta ist Muse Glimmer – 30 Mrd. Parameter, Apache 2.0, aus Muse Spark destilliert, mit einem Standard-Kontextfenster von 128K.
Im Standard-Tarif 1,25 $ pro Million Input-Tokens, 0,15 $ für gecachten Input und 4,25 $ pro Million Output-Tokens, ohne Aufschlag für langen Kontext. Der Contributor-Tarif kostet 0,10 $ Input und 0,20 $ Output, im Gegenzug für die Erlaubnis, mit Ihren Prompts und Antworten zu trainieren.
Meta bewertet 1.3 gegenüber Muse Spark 1.2, Claude Opus 5 und GPT-5.6 Sol auf GDPVal-AA v2, JobBench, OSWorld 2.0, DeepSearchQA, AutomationBench, DeepSWE v1.1, SWE-Atlas Codebase QnA, Terminal-Bench 2.1, MRCR v2 und einem internen Index zur Befolgung von Anweisungen. Die einzelnen Ergebnisse sind nur in einem Bild in Metas Release-Beitrag veröffentlicht – lesen Sie sie dort nach und nicht in der Sekundärberichterstattung.
Das AI Gateway von TrueFoundry fügt etwa 3–4 ms hinzu und bewältigt mehr als 350 RPS auf 1 vCPU – unerheblich im Vergleich zu Generierungszeiten von mehreren Sekunden.
Nein, und die oben gezeigte Streuung der Benchmarks ist das Argument dagegen. Nach Aufgabentyp über offene und geschlossene Modelle hinweg zu routen, ist meist günstiger und besser, als sich auf eines festzulegen.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet



















