September 11, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Kubernetes RBAC ist der Autorisierungsmodus, der entscheidet, ob eine authentifizierte Anfrage an den API-Server zugelassen wird. Der Modus ist in der API-Gruppe rbac.authorization.k8s.io/v1 enthalten und auf praktisch jedem verwalteten Cluster aktiviert.
Authentifizierung und Autorisierung sind getrennte Schritte. Der API-Server ermittelt zuerst, wer Sie sind – anhand eines Client-Zertifikats, OIDC-Tokens, ServiceAccount-Tokens oder einer Cloud-IAM-Identität. Anschließend prüft RBAC, ob diese Identität das geforderte Verb auf der jeweiligen Ressource ausführen darf. RBAC bestimmt niemals die Identität, sondern nur die Berechtigung.
Eine RBAC-Regel gleicht eine kleine Gruppe von Anfragefeldern ab:
Zwei Eigenschaften sind wichtiger als jedes Syntax-Detail.
RBAC ist additiv. Es gibt kein Deny. Wenn ein beliebiges Binding eine Berechtigung erteilt, besitzen Sie diese. Der einzige Weg, sie zu entziehen, besteht darin, jedes Binding zu entfernen, das sie gewährt. Daher der klassische Ticket-Satz: „Ich habe deren Admin-Rolle entfernt, aber sie können immer noch Pods löschen.“
RBAC ist Default-Deny. Ein Verb, das niemand gewährt hat, wird abgelehnt. Das praktische Risiko ist daher fast nie eine fehlende Regel – sondern eine Regel, die weit über das beabsichtigte Maß hinausgeht.
Eine Role ist ein an einen Namespace gebundenes Objekt (namespaced). Sie gewährt Berechtigungen für namespaced Ressourcen und das ausschließlich innerhalb des Namespace, in dem sie existiert.
Eine ClusterRole ist nicht an einen Namespace gebunden. Sie existiert einmal für den gesamten Cluster und deckt drei Anwendungsfälle ab, die eine Role nicht bedienen kann:
Die Frage k8s Role vs. ClusterRole wird oft so gestellt, als ginge es um Macht. In Wirklichkeit geht es um Scope und Wiederverwendbarkeit:
Vier Standard-ClusterRoles sollte man kennen, bevor man eigene schreibt: view (liest die meisten namespaced Ressourcen, schließt Secrets jedoch bewusst aus), edit (liest/schreibt die meisten, inklusive Secrets), admin (edit plus Erstellen von Roles und RoleBindings im Namespace) und cluster-admin (* auf *, überall).
view, edit und admin sind aggregierte ClusterRoles: Der Controller füllt ihre Regeln aus allen ClusterRoles, die per Label zu ihrer aggregationRule passen. Das ist der vorgesehene Weg, um sie für eigene CRDs zu erweitern.
Eine Role oder ClusterRole für sich gewährt noch gar nichts. Erst ein Binding verknüpft sie mit Subjects.
Ein RoleBinding ist an einen Namespace gebunden und gewährt die im roleRef genannte Rolle ihren Subjects innerhalb des eigenen Namespace.
Das Wichtigste, was man über ein RoleBinding in Kubernetes wissen muss: Sein roleRef kann auf eine ClusterRole verweisen, wobei die Berechtigungen strikt auf den Namespace des RoleBindings beschränkt bleiben. Definieren Sie die Funktion einmal und gewähren Sie sie Namespace für Namespace:
Ein ClusterRoleBinding hebt diese Grenze auf und gewährt eine ClusterRole überall – in jedem Namespace sowie für alle clusterweiten Ressourcen in der Rolle.
Drei Regeln, die immer wieder zu Fehlern führen:
RBAC kennt exakt drei Arten von Subjects. Der Unterschied liegt darin, woher sie stammen.
Es gibt keine User-Ressource – Sie können kein kubectl create user ausführen. Kubernetes vergleicht die vom Authentifikator übermittelten Benutzernamen und Gruppenlisten als einfache Strings mit den Bindings. Daher gilt: Ein Tippfehler im Subject-Namen gewährt stillschweigend keinerlei Rechte, ohne dass beim Anwenden ein Fehler ausgegeben wird.
ServiceAccounts sind die Identitäten, die Ihre Workloads nutzen. Ein Pod, der keinen konkreten ServiceAccount angibt, läuft unter dem default-Account seines Namespace. Dieser besitzt zwar keine Berechtigungen, sein Token wird jedoch weiterhin gemountet und authentifiziert – setzen Sie daher automountServiceAccountToken: false überall dort, wo ein Pod niemals den API-Server aufruft.
Kubernetes generiert außerdem automatisch Gruppen, die Sie niemals leichtfertig binden sollten: system:authenticated (jede authentifizierte Identität), system:serviceaccounts (alle ServiceAccounts clusterweit) und system:masters, das durch ein Standard-Binding direkt auf cluster-admin gemappt wird.
Die offiziellen Empfehlungen sind kurz und drehen sich fast ausschließlich um den Scope.
Bevorzugen Sie namespaced Roles. Greifen Sie zuerst zu Role und RoleBinding. Nutzen Sie eine ClusterRole nur dann, wenn die Ressource tatsächlich clusterweit ist oder Sie eine einzige wiederverwendbare Definition wünschen – und binden Sie diese selbst dann mit einem RoleBinding, es sei denn, das Subject benötigt wirklich jeden Namespace.
Vergeben Sie cluster-admin nicht vorschnell. Es bedeutet * auf *, einschließlich der RBAC-Objekte selbst. Ein Inhaber kann sich somit dauerhaft jede beliebige Berechtigung erteilen. Reservieren Sie es ausschließlich für Notfälle (Break-Glass).
Vermeiden Sie Wildcards. resources: ["*"] deckt stillschweigend auch CRDs ab, die erst Monate später installiert werden, und verbs: ["*"] schließt deletecollection ein. Zählen Sie die Verben und Ressourcen einzeln auf.
Binden Sie Gruppen, keine einzelnen User. Ein Binding pro Person wird bei Personalwechseln schnell zum Problem. Mappen Sie Ihre IdP-Gruppen in den Cluster und binden Sie diese, sodass Teamänderungen keine YAML-Anpassungen erfordern.
Betrachten Sie list auf Secrets wie einen Lesezugriff. list gibt vollständige Objektinhalte zurück und ist daher genauso mächtig wie get. Das Lesen von Secrets legt zudem die ServiceAccount-Credentials des jeweiligen Namespace offen.
Kennen Sie die Escalation-Verben. create auf pods ermöglicht es dem Inhaber, einen Pod als beliebiger ServiceAccount im Namespace auszuführen und dessen Berechtigungen zu erben. escalate und bind hebeln den Schutzmechanismus aus, der Sie daran hindert, Berechtigungen zu vergeben, die Sie selbst nicht besitzen. impersonate erlaubt es, im Namen einer anderen Identität zu handeln.
Auditieren Sie mit dem CLI-Tool, nicht mit der YAML-Datei. Da Berechtigungen additiv sind und aus verschiedenen Bindings stammen können, kennt nur der API-Server den tatsächlichen Zustand:
kubectl auth can-i delete pods --namespace team-alpha
kubectl auth can-i --list --namespace team-alpha
kubectl auth can-i list secrets \
--as=system:serviceaccount:team-alpha:reporting -n team-alpha
--as erfordert die Impersonation-Berechtigung, die Admins in der Regel besitzen. Wenden Sie RBAC-Manifeste mit kubectl auth reconcile an – dadurch werden Regeln und Subjects zusammengeführt, anstatt sie zu überschreiben.
Verwendung von ClusterRoleBinding, wenn ein RoleBinding ausreichen würde. Der häufigste Fehler in der Praxis. Jemand benötigt view im eigenen Namespace, die ClusterRole existiert bereits und ein ClusterRoleBinding ist eine Zeile kürzer – gewährt dadurch aber auch Lesezugriff über jeden Namespace hinweg, einschließlich aller Secrets.
Die Annahme, Namespaces böten mehr Isolation als sie tatsächlich tun. Ein Namespace ist lediglich die Abgrenzungseinheit für RBAC und sonst nichts – keine Netzwerk-, Node- oder Ressourcengrenze. „Sie haben nur Zugriff auf ihren Namespace“ ist eine Aussage über den API-Server, nicht über den Cluster.
Bindung an system:authenticated aus Bequemlichkeit. Es wirkt wie „alle im Team“. In Wahrheit bedeutet es jede Identität, die sich authentifizieren kann – einschließlich aller ServiceAccounts in jedem Namespace.
Der Glaube, Cluster-RBAC decke die auf dem Cluster laufende Plattform ab. Ein Data Scientist ohne jegliche Kubernetes-Berechtigungen kann unter Umständen trotzdem einen Dienst bereitstellen, ein Modell aufrufen oder ein Secret lesen, da diese Aktionen über eine Plattform-API laufen, die Cluster-RBAC nie zu Gesicht bekommt.
Kubernetes RBAC beantwortet präzise eine Frage: Wer darf dieses Verb auf diesem Kubernetes-Objekt ausführen? Es hat keine Antwort auf eine zweite Frage, die auf einer KI-Plattform genauso wichtig ist: Wer darf dieses Modell bereitstellen, dieses Provider-Konto nutzen, dieses MCP-Tool aufrufen oder diese Secret-Gruppe lesen? Das sind keine Kubernetes-Objekte. Sie befinden sich in einer Control Plane, die über eine Plattform-API erreicht wird – keine Role und kein RoleBinding steuert sie.
TrueFoundry ist Kubernetes-native: Die Compute-Plane besteht aus einem oder mehreren Ihrer eigenen EKS-, GKE-, AKS-, OpenShift- oder On-Premises-Cluster, die über einen leichtgewichtigen tfy-agent ausgehend mit der Control Plane verbunden sind. Beide Ebenen sind gleichzeitig vorhanden, weshalb es sich lohnt, genau zwischen ihnen zu unterscheiden.
Die beiden Modelle teilen sich nicht zufällig ein gemeinsames Vokabular. In den Kernkonzepten von TrueFoundry ist ein Cluster ein tatsächlicher Kubernetes-Cluster und ein Workspace ein Kubernetes-Namespace. Wenn Sie jemandem die Rolle Workspace Member zuweisen, begrenzen Sie dessen Zugriff auf dasselbe Objekt, das auch ein RoleBinding adressieren würde.
Was Sie dabei nicht tun, ist das Schreiben eines RoleBindings. Plattformrollen und Cluster-RBAC-Objekte werden unabhängig voneinander an verschiedenen Orten konfiguriert. Die Dokumentation beschreibt keinen Mechanismus, der das eine in das andere übersetzt, synchronisiert oder generiert. Zwei Ebenen, eine gemeinsame Grenze. Auch beim Audit zieht die Dokumentation dieselbe Trennlinie: Plattform-Audit-Logs decken Plattform-Aktivitäten ab und ersetzen explizit keine Audit-Logs auf Infrastrukturebene von Kubernetes oder Ihrem Cloud-Anbieter.
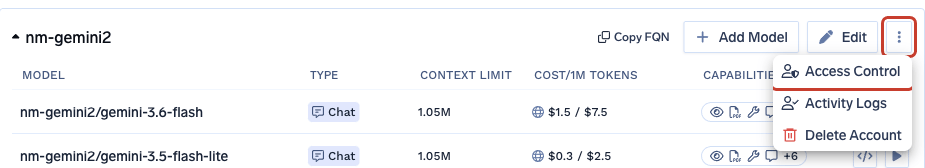
Das Modell lautet Subject + Ressource + Rolle = Role Binding – was vertraut vorkommen dürfte. Ein Subject ist ein User, ein Team, ein virtuelles Konto oder ein Agent; eine Ressource ist ein Cluster, ein Workspace, ein Repository, eine Secret-Gruppe, ein Provider-Konto oder ein MCP-Server. Berechtigungen werden direkt an der Ressource vergeben – öffnen Sie deren Drei-Punkte-Menü und wählen Sie Access Control:
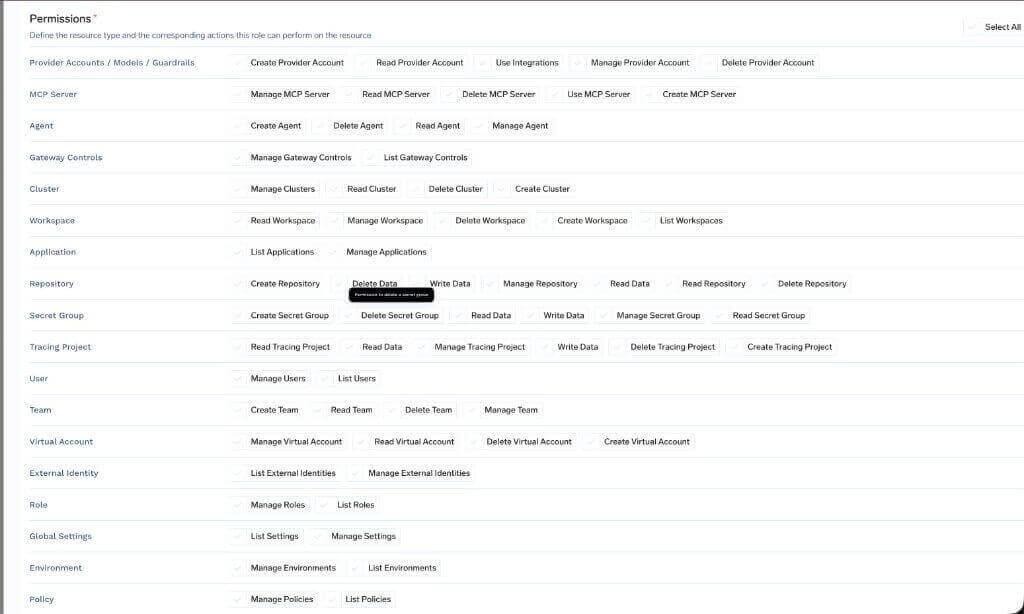
Wählen Sie anschließend Subjects und eine Rolle aus. Das Menü zeigt die Aktionen an, die in jeder Rolle enthalten sind:

Die angebotenen Rollen hängen vom Ressourcentyp ab: Cluster Admin / Member / Viewer auf einem Cluster, Workspace Admin / Member / Viewer auf einem Workspace, Manager / User / Approver auf einem MCP-Server. Im Hintergrund sind Berechtigungen Schlüssel in der Form ressource:Aktion – cluster:ReadCluster, workspace:ManageWorkspace, secret-group:ReadData. Dieselbe Regelstruktur wie bei Kubernetes, aber andere Objekte:
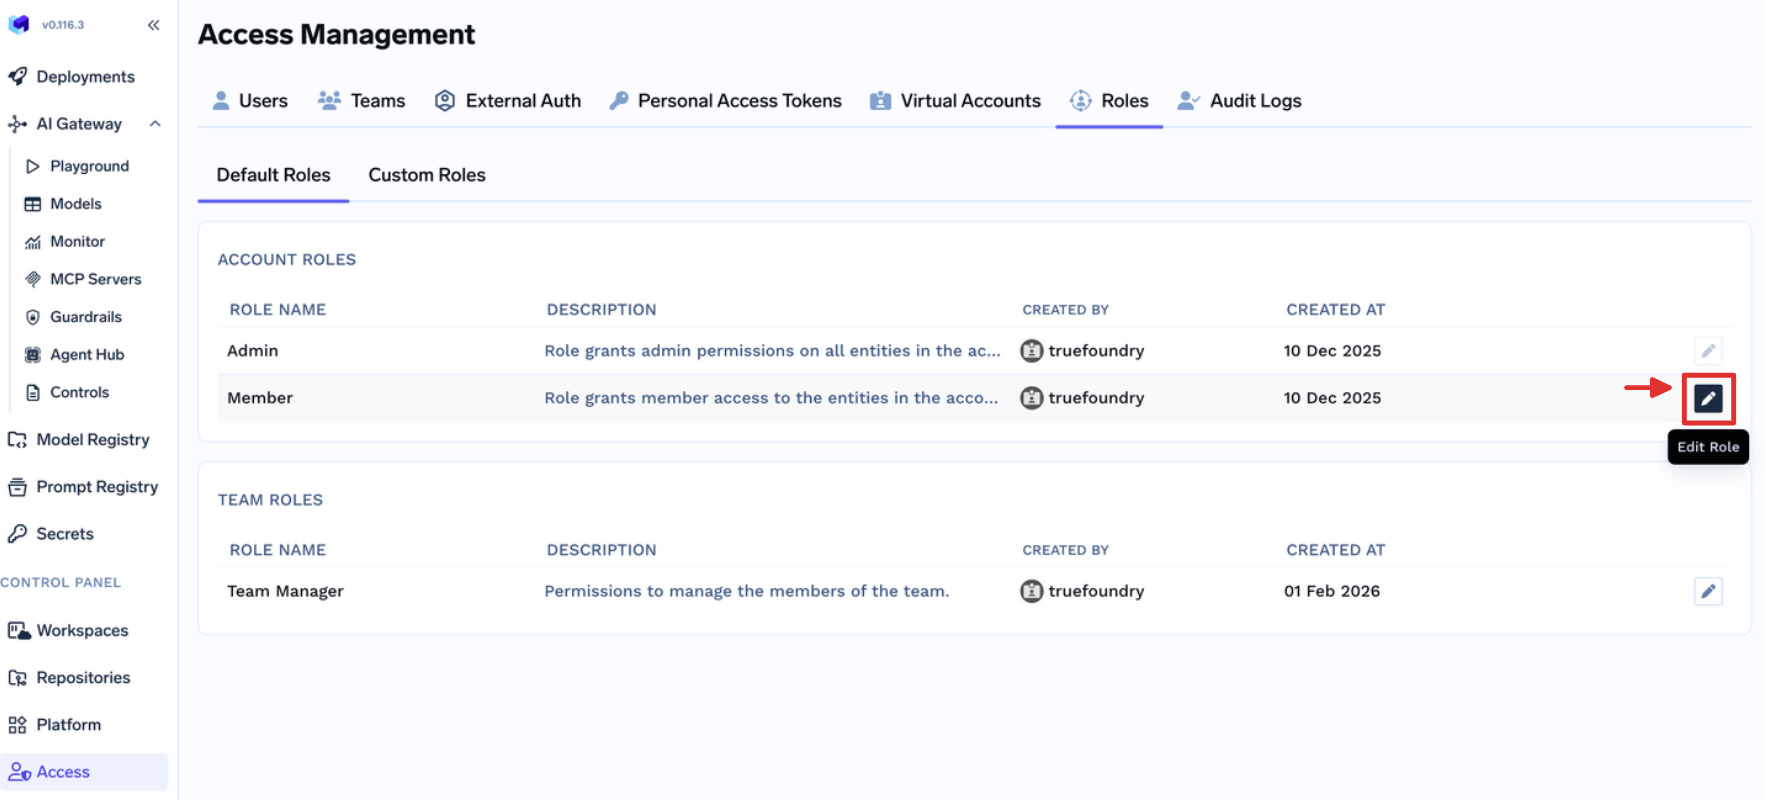
Tenant-weite Rollen sind das Plattform-Pendant zu einem ClusterRoleBinding und tragen dieselbe Warnung. Admin und Read-Only Member können nicht bearbeitet werden. Member, die bearbeitbare Basisrolle, die jeder Benutzer erhält, ist bewusst minimal gehalten – cluster:ReadCluster, user:ListUsers, agent:CreateAgent und einige weitere – und reicht an keinen einzelnen Workspace, kein Modell und keinen MCP-Server heran.
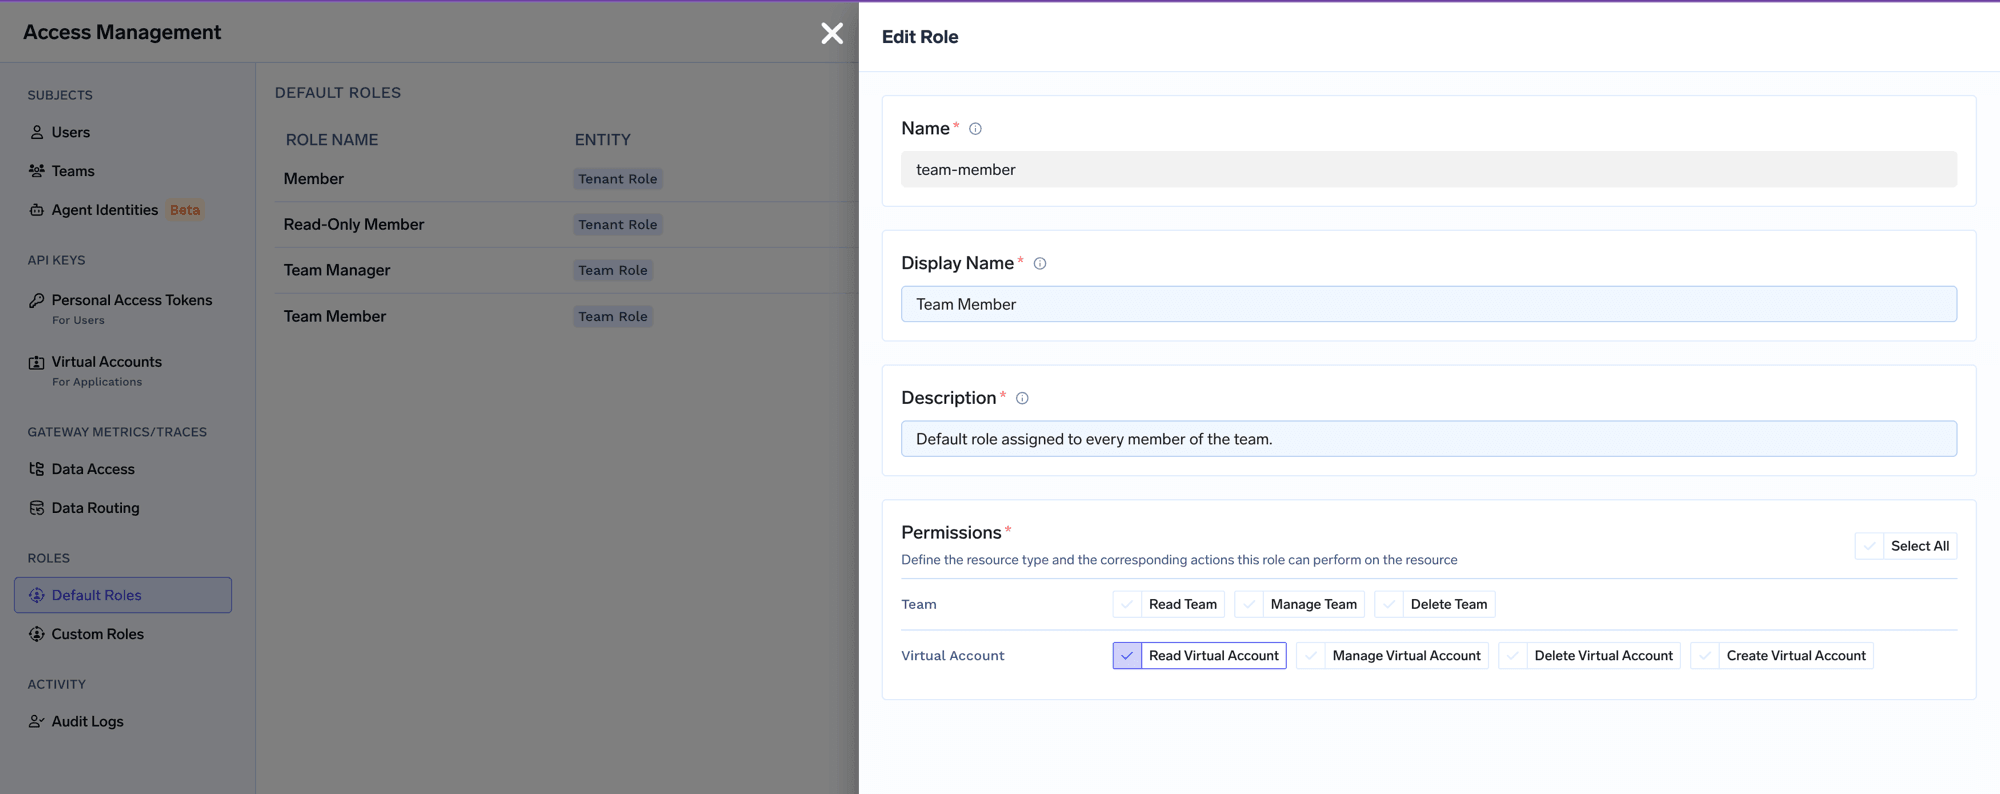
Teamrollen entsprechen einem RoleBinding mit rechtebasierter Begrenzung durch Besitz (Ownership): Team Member enthält virtual-account:ReadVirtualAccount, beschränkt auf Virtual Accounts im Besitz von Teams, denen der Benutzer angehört.
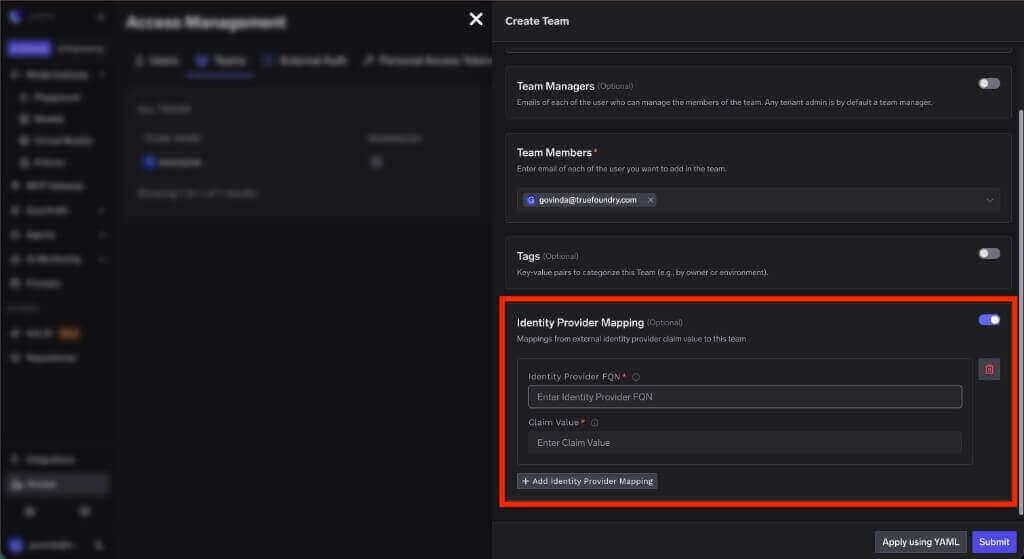
Auch die Best Practice, bevorzugt Gruppen statt einzelner Benutzer zu binden, gilt hier unverändert. Ein IdP-Claim-Wert wird einem TrueFoundry-Team zugewiesen, sodass dieselbe Verzeichnisgruppe, die Ihre Cluster-Bindings steuert, auch die Plattform-Mitgliedschaft regelt:
Eine realistische Anforderung: Das ML-Team soll in seinen eigenen Namespace deployen und einen MCP-Server bereitstellen können, ohne dass jemand Cluster-Admin oder Tenant-Admin werden muss.
In Kubernetes. Der Namespace heißt ml-prod. Binden Sie edit in diesen einen Namespace mit einem RoleBinding, dessen Subject die IdP-basierte Gruppe ist:
Überprüfen Sie es und testen Sie den Zugriff auch in der negativen Richtung:
Beachten Sie, dass edit auch das Lesen von Secrets in diesem Namespace erlaubt. Falls das Team diese nicht lesen soll, binden Sie eine spezifischere benutzerdefinierte ClusterRole.
In der Plattform. Nichts davon erlaubt es jemandem, einen MCP-Server zu erstellen, da MCP-Server keine Kubernetes-Objekte sind. Der erste Impuls ist oft, die Rolle Admin zu vergeben. Erstellen Sie stattdessen unter Access > Custom Roles eine benutzerdefinierte Rolle, die exakt mcp-server:CreateMcpServer enthält:
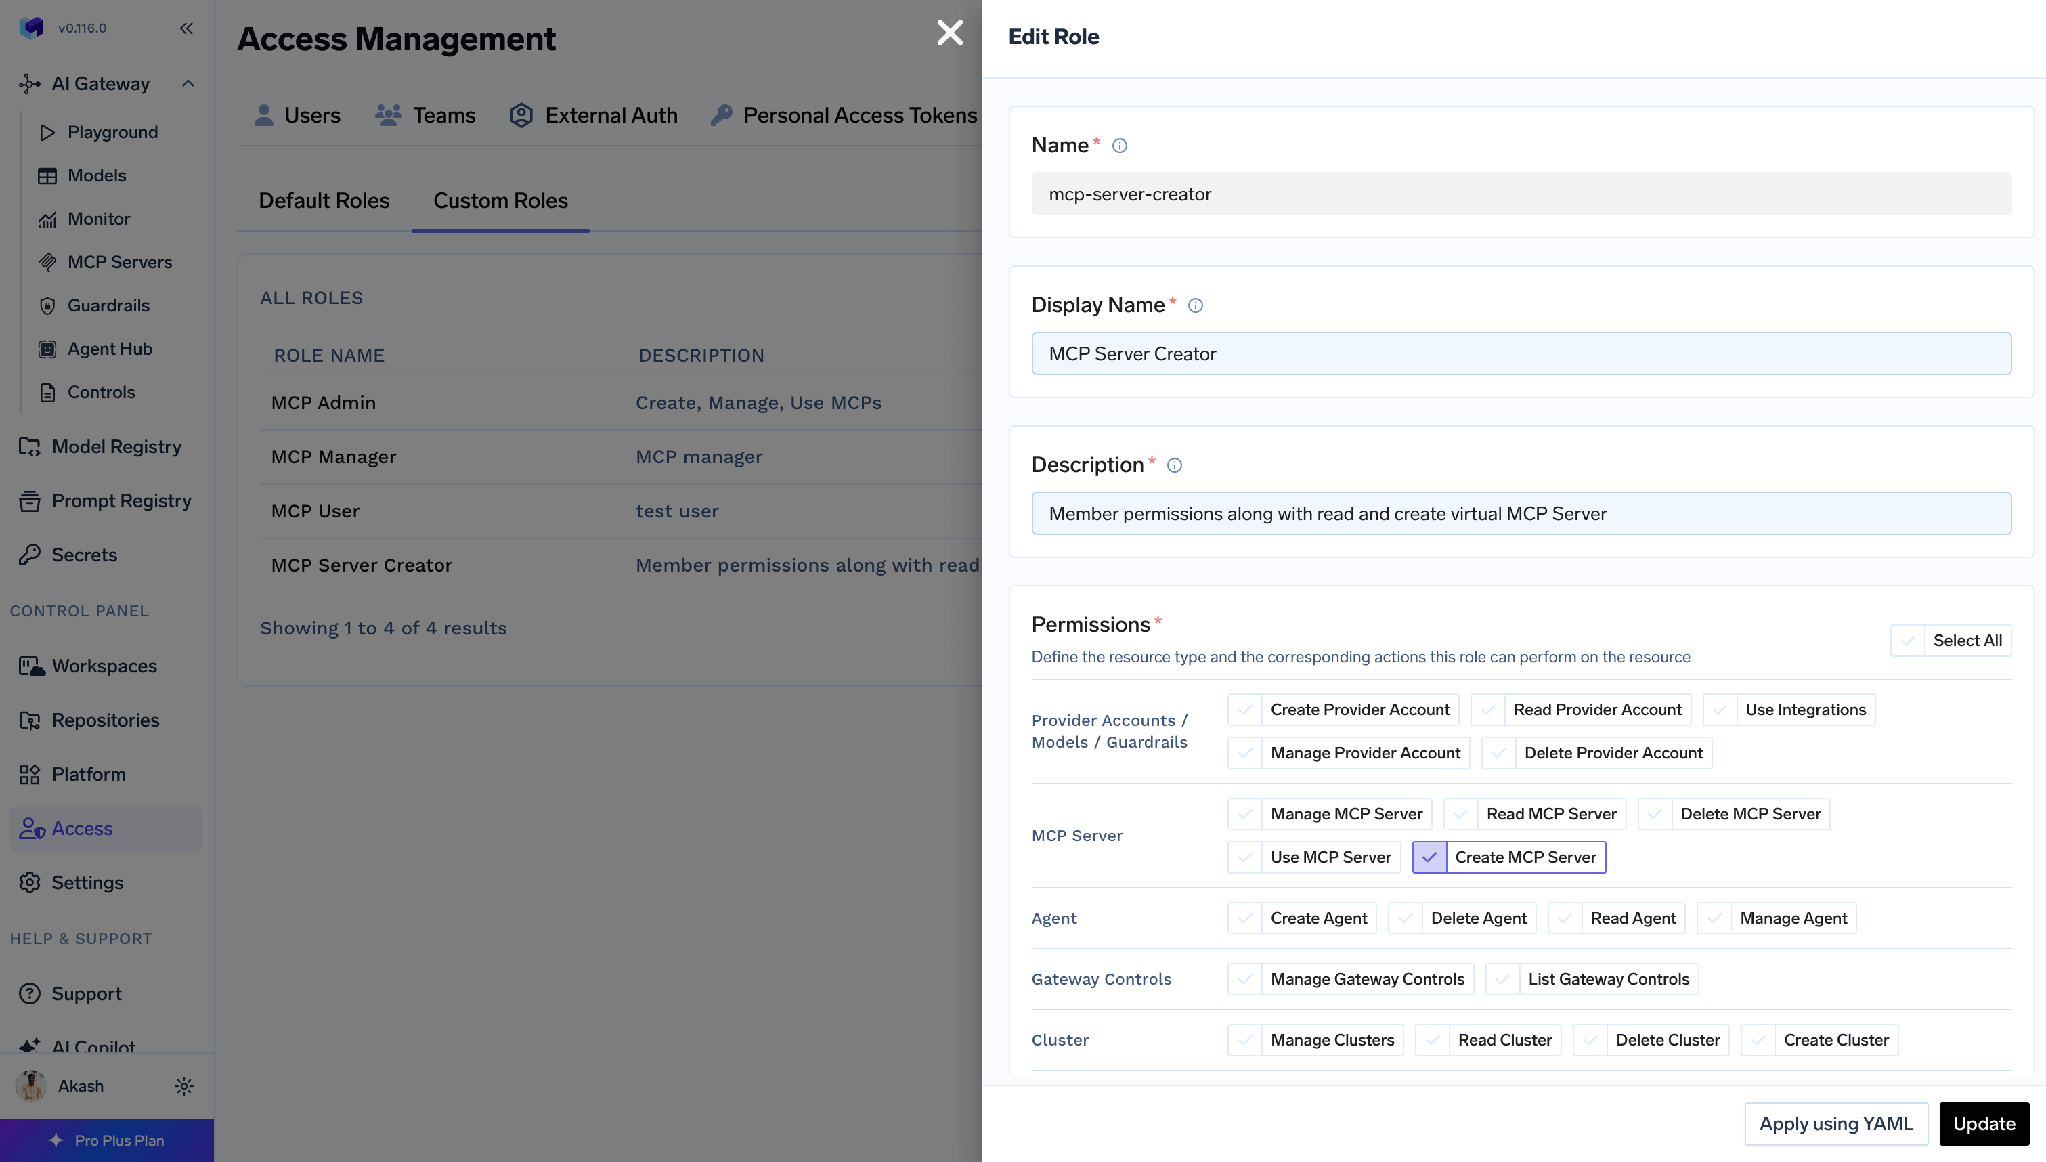
Weisen Sie diese anschließend unter Access > Users oder Access > Teams zu.
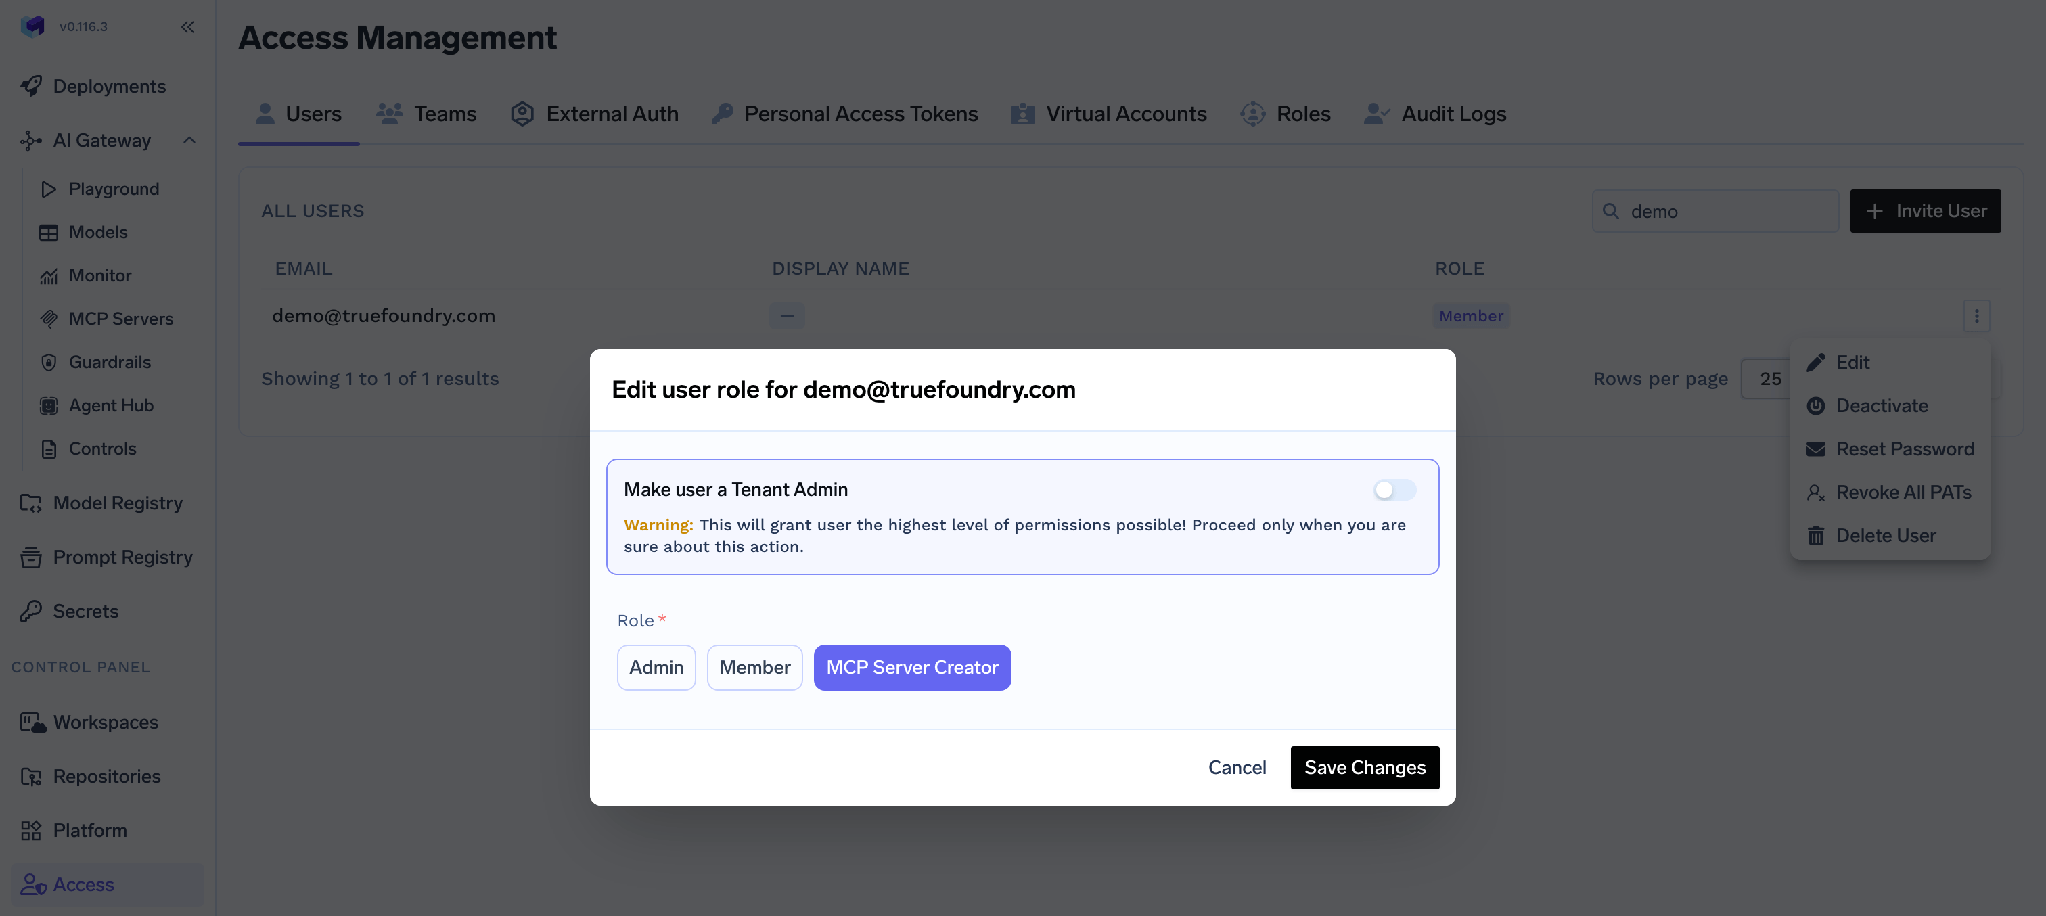
Das Verhalten spiegelt Kubernetes exakt wider. Create MCP Server erlaubt das Erstellen eines neuen Servers, gewährt aber keinerlei Rechte auf bestehenden Servern – genau wie create auf einer Kubernetes-Ressource keine Rechte auf bereits existierenden Objekten gewährt. Der Eigentümer weist sich anschließend selbst MCP Server Manager über die Access-Control-Seite dieses Servers zu, und die MCP-Zugriffskontrolle regelt, welche Tools der Agent aufrufen darf.
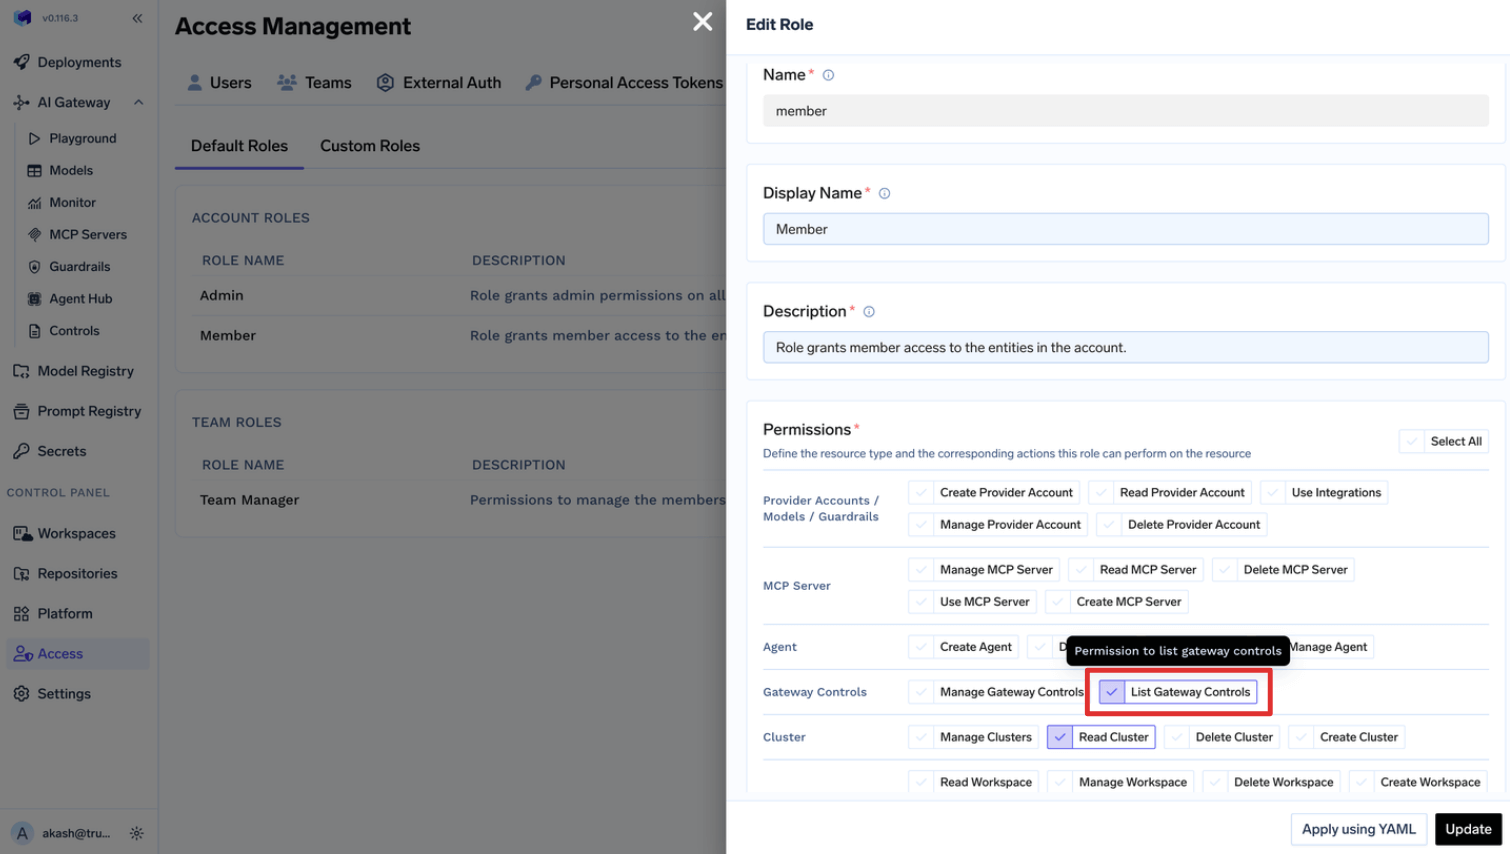
Eine weitere Parallele: Berechtigungen benutzerdefinierter Rollen gelten für alle Ressourcen des gewählten Typs – ähnlich wie ein ClusterRoleBinding für alle Namespaces gilt. Um den Zugriff auf eine einzelne Ressource zu beschränken, nutzen Sie die Access-Control-Seite dieser spezifischen Ressource. Dasselbe Prinzip gilt bei der Erweiterung der Basisrolle: Das Hinzufügen von gateway-controls:ListGatewayControls zur Rolle Member gewährt diese Berechtigung jedem Benutzer:
Der plattformeigene Agent ist ein Musterbeispiel für Role vs. ClusterRole. tfy-agent benötigt eine ClusterRole und ein ClusterRoleBinding, um Informer auszuführen, da Kubernetes-Informer keine Teilmenge von Namespaces überwachen können – er liest daher nur und filtert clientseitig. tfy-agent-proxy, der tatsächlich Schreibzugriffe durchführt, lässt sich hingegen einschränken: config.allowedNamespaces stellt ihn auf pro-Namespace-RoleBindings um, und tfyAgentProxy.clusterRole.strictMode: true reduziert ihn auf ein minimales Rechte-Set. Das ist die allgemeine Regel im Kleinformat.
Rechte kombinieren sich auf beiden Ebenen – das Entfernen des einen hebt das andere nicht auf. In Kubernetes ist der effektive Zugriff die Vereinigung aller passenden Bindings. In TrueFoundry kann ein Subject Rechte direkt besitzen und zusätzlich von einem Team erben. Prüfen Sie alle Quellen, bevor Sie schlussfolgern, dass ein Entzug fehlgeschlagen ist.
Das Bearbeiten einer Standard-Teamrolle auf Plattformebene ändert diese für alle Teams. Team Member und Team Manager werden unter Access > Default Roles bearbeitet, und diese Änderung wirkt global. Das Hinzufügen von virtual-account:ManageVirtualAccount, damit ein Team Tokens abrufen kann, gewährt dies in jedem Team. Kubernetes birgt dieselbe Gefahr in grün: Das Bearbeiten einer gemeinsam genutzten ClusterRole ändert sie für jedes Binding, das auf sie verweist.
Die meisten Probleme mit Kubernetes RBAC sind Scope-Probleme, keine Syntax-Probleme. Zwei Objektarten beschreiben Berechtigungen und zwei vergeben sie. Die Kunst besteht darin, die spezifischere Variante zu wählen, selbst wenn die breitere schneller getippt ist: Zuerst namespaced Role, ClusterRole gebunden per RoleBinding bei gewünschter Wiederverwendung, ClusterRoleBinding nur dann, wenn ein Subject tatsächlich den gesamten Cluster benötigt. Binden Sie Gruppen, vermeiden Sie Wildcards und überprüfen Sie Rechte mit kubectl auth can-i.
Was leicht übersehen wird: All dies beantwortet nur eine einzige Frage. Alles, was Ihre Teams über eine Plattform-API tun – ein Modell deployen, ein MCP-Tool aufrufen, eine Secret-Gruppe lesen – ist für Cluster-RBAC unsichtbar und erfordert eine eigene Lösung.
Auf TrueFoundry sind dies zwei Ebenen über derselben Infrastruktur: Sie teilen sich eine Grenze, weil ein Workspace ein Namespace ist, werden aber unabhängig voneinander konfiguriert, da sie unterschiedliche Objekte steuern. Ein Platform Engineer benötigt beide. Der häufigste Fehler ist die Annahme, eine Ebene decke die andere automatisch mit ab.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




Es ist der Autorisierungsmodus, der entscheidet, ob eine authentifizierte Identität über den API-Server ein Verb auf einer Ressource ausführen darf. Sie schreiben Berechtigungen in eine Role (Namespace-gebunden) oder eine ClusterRole (clusterweit) und verknüpfen sie dann über ein RoleBinding (nur dieser Namespace) oder ein ClusterRoleBinding (clusterweit) mit Subjekten. Regeln sind additiv, es gibt kein Deny, und alles, was nicht erteilt wurde, wird abgelehnt.
Eine Role ist an einen Namespace gebunden und kann nur Berechtigungen für Namespace-Ressourcen innerhalb ihres eigenen Namespace erteilen. Eine ClusterRole gilt clusterweit und kann zusätzlich Berechtigungen für clusterweite Ressourcen wie Nodes und Persistent Volumes sowie für Nicht-Ressourcen-URLs wie /healthz erteilen. Der praktische Unterschied ist die Wiederverwendung: Eine ClusterRole wird einmal definiert und kann mit einem RoleBinding in jeden einzelnen Namespace gebunden werden.
Ja, und das ist das empfohlene Muster. Die Berechtigungen bleiben auf den Namespace des RoleBinding beschränkt, sodass Sie eine Fähigkeit einmal definieren und Team für Team vergeben. Umgekehrt ist es nicht erlaubt: Ein ClusterRoleBinding kann niemals auf eine Role verweisen.
Ja. TrueFoundry läuft in Ihrer VPC, On-Prem, Air-Gapped oder hybrid, sodass Prompts und Antworten Ihre Domäne nie verlassen, auch wenn Sie über viele Anbieter hinweg routen.
Ja. Es umfasst ein MCP Gateway, ein Agent Gateway und eine MCP & Agents Registry mit Zugriffskontrolle auf Tool-Ebene. Agenten auf Basis von LangGraph, CrewAI, AutoGen oder einem eigenen Framework lassen sich alle zentral steuern.
Ja. Das Gateway ist OpenTelemetry-kompatibel und lässt sich in Grafana, Datadog, Prometheus oder Ihren bevorzugten Stack integrieren. Es verfolgt jede Anfrage vom Prompt bis zur Ausführung von Tools und Modellen, sodass Sie eine einheitliche Protokollierung erhalten, ohne Ihre bestehenden Systeme entfernen zu müssen.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet