August 31, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Guardrails in einem AI Gateway fungieren als Sicherheitsnetz zwischen leistungsstarken Sprachmodellen und Ihren kritischen Anwendungen. Sie stellen sicher, dass jede Anfrage und jede Antwort den Standards Ihrer Organisation für Sicherheit, Qualität und Compliance entspricht. Auf der TrueFoundry-Plattform ermöglichen Ihnen diese Guardrails die Definition präziser Regeln – wie das Maskieren personenbezogener Daten, das Filtern unzulässiger Themen oder das Blockieren unerwünschter Wörter. So können Sie darauf vertrauen, dass sensible Daten niemals durchsickern und Inhalte stets mit Ihrer Markensprache und den rechtlichen Anforderungen übereinstimmen. Durch die Auswertung jeder Ein- und Ausgabe anhand konfigurierbarer Richtlinien verhindern die Guardrails von TrueFoundry Halluzinationen, setzen Inhaltsstandards durch und wahren ein konsistentes Verhalten über alle Ihre LLM-gesteuerten Workflows hinweg.
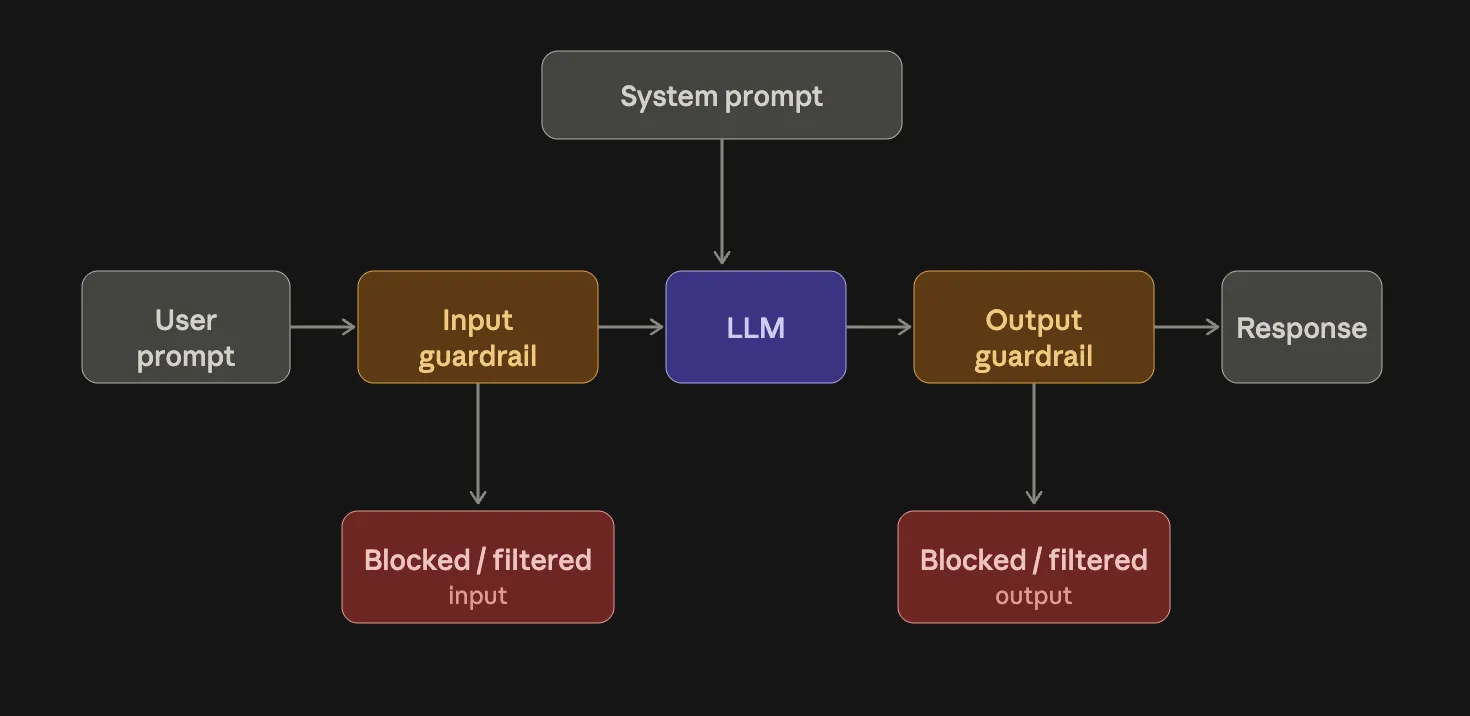
Unternehmen verlassen sich zunehmend auf Large Language Models, um den Kundensupport zu automatisieren, Marketingtexte zu erstellen und interne Workflows zu optimieren. Ohne Guardrails können diese Modelle unvorhersehbare Ausgaben erzeugen, die Unternehmen rechtlichen, repulationalen und operationalen Risiken aussetzen.
Erstens ist die Durchsetzung des Datenschutzes nicht verhandelbar. Guardrails ermöglichen es Ihnen, personenbezogene Daten (PII) automatisch zu erkennen und zu anonymisieren, bevor sie das System verlassen. Dies verhindert die versehentliche Offenlegung von E-Mails, Sozialversicherungsnummern oder anderen sensiblen Details und hilft Ihnen, Vorschriften wie die DSGVO (GDPR) und HIPAA einzuhalten.
Zweitens schützen Guardrails die Markenintegrität und das Vertrauen der Nutzer. Ein Enterprise Chatbot, der plötzlich mit Profanität oder vorurteilbehafteten Aussagen antwortet, kann Kunden verprellen und Ihre Marke schädigen. Indem Sie Ausgaben gegen eine Liste verbotener Themen und benutzerdefinierter Wortfilter validieren, bewahren Sie eine konsistente Markensprache und vermeiden unangemessene Ausdrücke. Diese Form der Content Governance ist essenziell, wenn mehrere Teams auf dasselbe AI Gateway zugreifen.
Drittens hängt die betriebliche Stabilität von einem vorhersehbaren Modellverhalten ab. AI Guardrails im Unternehmen geben Ihnen eine feingranulare Kontrolle darüber, welche Modelle spezifische Anfragen verarbeiten, und wenden unterschiedliche Regeln basierend auf Metadaten, Benutzerrollen oder Service-Kontexten an. Sie können frühzeitig abbrechen (Fail Fast), wenn eine Antwort gegen Richtlinien verstößt, anstatt Probleme erst in Produktionsprotokollen zu entdecken oder von verärgerten Nutzern davon zu erfahren.
Viertens unterstützen Guardrails die Revisionssicherheit und Rechenschaftspflicht. Jedes Mal, wenn eine Regel greift, erfassen Sie strukturierte Protokolle. Diese zeigen, welche Ein- oder Ausgabeprüfungen ausgelöst wurden, welche Transformation angewendet wurde und welcher Benutzer oder Dienst den Aufruf initiiert hat. Diese Logs bilden einen klaren Audit Trail für Sicherheitsüberprüfungen, Compliance-Audits und Post-Mortem-Analysen.
Schließlich reduzieren Guardrails das Risiko kostspieliger Halluzinationen. Indem Sie Ausgaben gegen semantische Themenfilter validieren, hindern Sie das Modell daran, Klauseln, medizinische Ratschläge oder andere risikoreiche Inhalte zu erfinden. In regulierten Branchen kann dieses Sicherheitsnetz den Unterschied zwischen einer erfolgreichen AI-Einführung und einer schädlichen Sicherheitsverletzung ausmachen.
Guardrails verwandeln leistungsstarke, aber unvorhersehbare LLMs in zuverlässige, regelkonforme Werkzeuge für Unternehmen. Sie ermöglichen es Ihnen, modernste AI mit der Gewissheit zu nutzen, dass jede Anfrage und Antwort Ihren Sicherheits-, Qualitäts- und Governance-Standards entspricht.
Verschiedene AI-Anwendungen sind unterschiedlichen Risiken ausgesetzt, weshalb Unternehmen Guardrails an mehreren Stellen im AI-Workflow benötigen. AI Guardrails im Unternehmen können Eingaben, Ausgaben, sensible Informationen, Inhalte, Prompts und den Zugriff auf AI-Tools steuern.
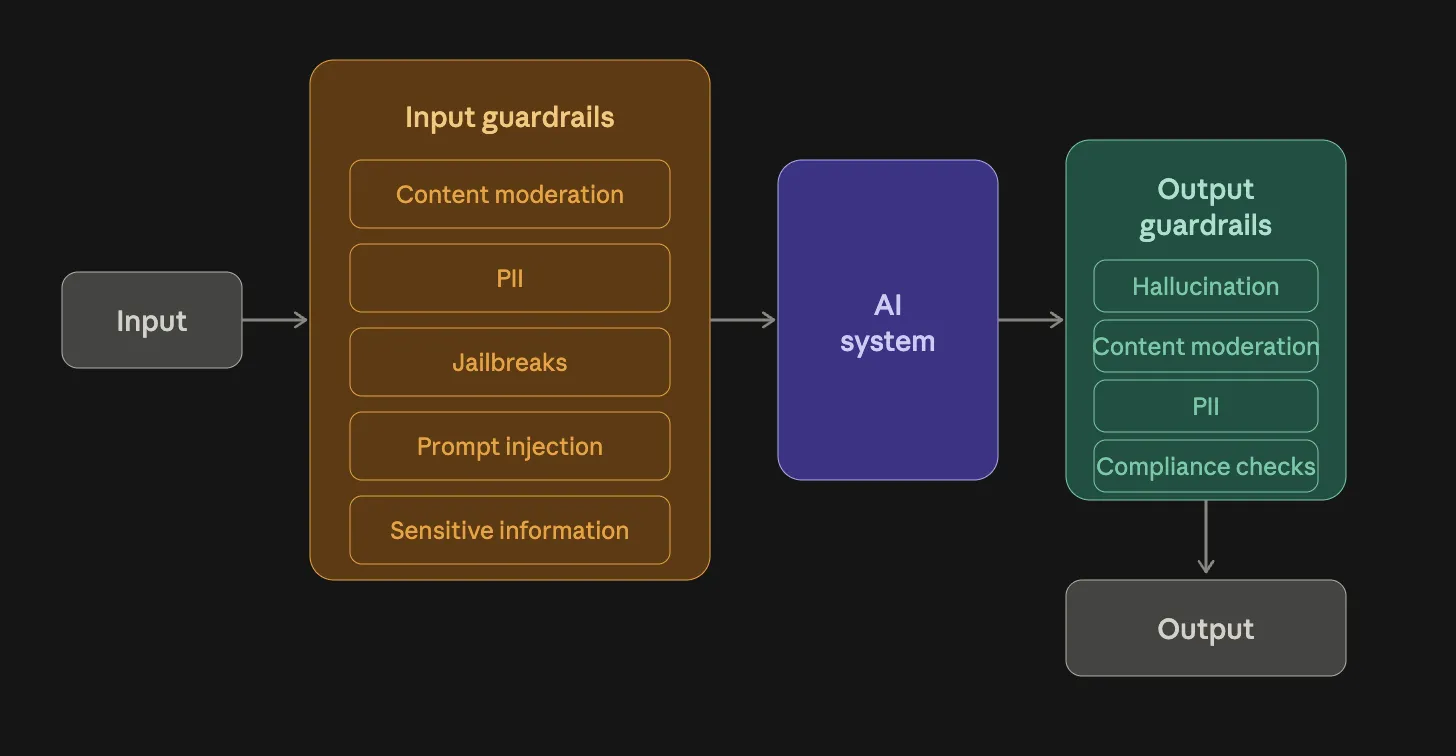
Guardrail-Regeln im TrueFoundry AI Gateway ermöglichen es Ihnen, Richtlinien an beiden Enden einer Interaktion mit einem Sprachmodell durchzusetzen. Jede Regel verfügt über eine Kennung, eine Reihe von Match-Bedingungen und zwei Abschnitte: Input- und Output-Guardrails. TrueFoundry wertet Regeln sequentiell aus und wendet nur den ersten Treffer auf jede Anfrage an. Dies stellt eine vorhersehbare Durchsetzung sicher, selbst wenn mehrere Richtlinien zutreffen könnten.
Eingabe-Guardrails gelten für alles, was in das Modell gelangt. Typische Szenarien umfassen das Maskieren oder Validieren von personenbezogenen Daten (PII), bevor sie das LLM erreichen. Beispielsweise anonymisiert eine Eingabe-Guardrail vom Typ PII mit der Aktion transform automatisch E-Mails, Telefonnummern oder Sozialversicherungsnummern. Sie können auch eine Eingabe-Guardrail vom Typ word_filter verwenden, um unerwünschte Phrasen zu entfernen oder die Unternehmens-Terminologie in Benutzer-Prompts durchzusetzen. Das frühzeitige Abfangen von Problemen verringert die Wahrscheinlichkeit von Richtlinienverstößen und kostspieligen Audits.
Ausgabe-Guardrails steuern die Antworten des Modells. Sie können Ausgaben gegen eine Liste verbotener Themen validieren – wie etwa medizinische Ratschläge, Hassrede oder Profanität – und sofort abbrechen (Fail Fast), wenn Inhalte gegen Richtlinien verstoßen. Alternativ können Sie Ausgaben transformieren, um sensible Informationen zu schwärzen oder unzulässige Wörter durch Platzhalter zu ersetzen. Separate Schwellenwert-Einstellungen (Thresholds) ermöglichen es Ihnen zu steuern, wie aggressiv das System Text markiert oder verändert. Dies gibt Ihnen die Flexibilität, das Benutzererlebnis mit Compliance-Anforderungen abzuwägen.
Jede Regel kann einen when-Block enthalten, um festzulegen, für welche Modelle, Metadaten-Tags oder Subjekte (Benutzer, Teams oder virtuelle Konten) sie gilt. Beispielsweise könnten Sie bei kundenorientierten Chatbots eine strengere PII-Schwärzung durchsetzen, während Sie für interne Analyseabfragen lockerere Filter verwenden. Die gezielte Ausrichtung nach Modell-ID oder Subjekt stellt das richtige Maß an Governance sicher, ohne andere Workflows übermäßig einzuschränken.
TrueFoundry verbindet diese Richtlinien mit seinem Guardrails-Dienst über die guardrails_service_url, die REST-APIs für die Regelauswertung und -durchsetzung bereitstellt. Jede Anfrage wird durch die Guardrails-Engine geroutet, wobei jede Auslösung protokolliert und Transformationen oder Validierungen in Echtzeit angewendet werden. Diese klare Trennung von Eingabe- und Ausgaberegeln macht es einfach, robuste, wartbare Richtlinien zu entwickeln, die Ihre LLM-Bereitstellungen sowohl leistungsstark als auch sicher halten.
Die PII-Guardrails von TrueFoundry identifizieren und verarbeiten personenbezogene Daten sowohl in eingehenden Prompts als auch in ausgehenden Antworten automatisch und schützen so sensible Daten vor Offenlegung.
Indem Sie input_guardrails und output_guardrails mit dem Typ pii konfigurieren, können Sie wählen, ob erkannte Entitäten basierend auf Ihren Compliance-Anforderungen validiert oder transformiert werden sollen.
Die Guardrail-Engine erkennt eine umfassende Auswahl an PII-Kategorien, einschließlich, aber nicht beschränkt auf E-Mail-Adressen, Telefonnummern, Sozialversicherungsnummern, Kreditkartendetails, physische Adressen und behördlich ausgestellte Identifikatoren (Reisepässe, Führerscheine, Steuer-IDs).
TrueFoundry unterstützt auch regionale Varianten wie die britische NHS-Nummer, die indische Aadhaar-ID und australische TFNs, was eine breite Abdeckung bei globalen Bereitstellungen gewährleistet.
Innerhalb jeder PII-Guardrail-Regel legt der options-Block fest, auf welche Entitätstypen abgezielt werden soll.
Die Einstellung action: transform meidet erkannte Entitäten durch anonymisierte Platzhalter zu ersetzen, bevor sie das Modell erreichen. Alternativ weist action: validate Anfragen zurück, die unzulässige PII enthalten, und gibt einen Fehler zurück, anstatt den Prompt weiterzuleiten.
Vorteile der Transformation
PII-Guardrails sind überall dort nützlich, wo KI-Anwendungen im Unternehmen mit sensiblen personenbezogenen Daten umgehen. Zu den Anwendungsfällen gehören:
Durch die Anwendung von PII-Guardrails auf der AI-Infrastrukturebene können Unternehmen sensitive Informationen über LLM-gestützte Anwendungen hinweg konsistent erkennen, transformieren oder blockieren, anstatt sich darauf zu verlassen, dass einzelne Anwendungsteams separate Kontrollen implementieren.
Themenfilter-Guardrails setzen semantische Regeln durch, die verhindern, dass eine AI über unzulässige Themen spricht. Durch die Überprüfung sowohl eingehender Prompts als auch ausgehender Antworten gegen eine konfigurierbare Liste gesperrter Themen können Unternehmen sicherstellen, dass jede Interaktion innerhalb definierter Inhaltsgrenzen bleibt. Dies schützt die Reputations der Marke und sichert die Einhaltung gesetzlicher Vorschriften.
Sie entscheiden, welche Themenbereiche blockiert werden sollen. Zu den gängigen Anwendungsfällen gehören:
Unter der Guardrail jedes Themas geben Sie zwei Hauptparameter im options-Block an:
Vorteile
Durch die Anwendung von Themenfiltern auf Gateway-Ebene bietet TrueFoundry Unternehmen eine zentrale Möglichkeit, Inhaltsrichtlinien über AI-Anwendungen hinweg durchzusetzen, ohne dass jede Anwendung ihre eigene Themenerkennungslogik implementieren und warten muss.
Die Wortfilter-Guardrails von TrueFoundry geben Ihnen die präzise Kontrolle über jedes Wort oder jede Phrase, die Ihr AI Gateway passiert. Durch das Definieren einer benutzerdefinierten Sperrliste (Blocklist) können Sie proprietäre Begriffe, Profanität oder jegliche sensible Sprache sowohl vor dem Erreichen des Modells als auch nach der Generierung erkennen und behandeln. Dies stellt sicher, dass Ihre LLM-gesteuerten Anwendungen niemals unbefugte Terminologie offenlegen oder in eine unpassende Markensprache abgleiten.
Unter jeder word_filter-Guardrail geben Sie die Optionen word_list, case_sensitive, whole_words_only und replacement an, um das Filterverhalten anzupassen. Die word_list ist ein Array von Begriffen oder Phrasen, die Sie erkennen möchten.
Die Einstellung case_sensitive: false sorgt dafür, dass der Abgleich die Groß-/Kleinschreibung ignoriert, während whole_words_only: true sicherstellt, dass nur freistehende Wörter markiert werden, wodurch unbeabsichtigte Treffer innerhalb längerer Wörter vermieden werden. Das Feld replacement definiert den Platzhaltertext, zum Beispiel „[REMOVED]“, der verwendet wird, wenn action: transform ausgewählt ist. Alternativ lehnt die Wahl von action: validate jede Anfrage ab, die gesperrte Wörter enthält, und gibt einen Fehler zurück, anstatt den Inhalt an das Modell weiterzuleiten.
Hier ist eine Beispielkonfiguration, die Wortfilterung sowohl auf Eingaben als auch auf Ausgaben anwendet und sich an GPT-4-Bereitstellungen mit einer Sperrliste für proprietäre Begriffe richtet:
Jedes Mal, wenn ein Wortfilter greift, protokolliert TrueFoundry das Ereignis mit Details dazu, welche Regel ausgelöst wurde, dem ursprünglichen und dem transformierten Text sowie dem Benutzer- oder Service-Kontext. Diese Audit-Logs helfen Sicherheits- und Compliance-Teams, Vorfälle zu überprüfen, Sperrlisten anzupassen und die Einhaltung interner Richtlinien oder Branchenvorschriften nachzuweisen.
Die Zentralisierung der Wortfilterung am Gateway bedeutet, dass Entwickler den Anwendungscode nicht mehr mit Ad-hoc-Prüfungen überfrachten müssen; Ihre Richtlinien befinden sich an einem Ort, sind leicht zu aktualisieren und gelten konsistent über alle LLM-Workflows hinweg.
AI Governance definiert die Richtlinien und Kontrollen, deren Einhaltung eine Organisation von ihren AI-Systemen erwartet. AI Guardrails verwandeln diese Richtlinien in Echtzeit-Kontrollen, indem sie Prompts, Modellantworten und AI-Aktionen direkt bei deren Ausführung überprüfen.
Dies macht Guardrails zu einer operationalen Schicht zwischen Governance-Anforderungen und dem täglichen AI-Verhalten. Anstatt sich nur auf dokumentierte Richtlinien oder manuelle Überprüfungen zu verlassen, können Unternehmen Verstöße automatisch erkennen und behandeln, bevor sie zu Sicherheits-, Compliance- oder Geschäftsrisiken werden.
Für Unternehmen machen diese Eigenschaften Guardrails zu einer wichtigen Ausführungsschicht für die AI Governance. Plattformen wie TrueFoundry bringen diese Kontrollen in die AI-Infrastrukturschicht ein und helfen Teams, Sicherheit, Datenschutz und Richtliniendurchsetzung konsistent über LLM-Anwendungen und -Bereitstellungen hinweg anzuwenden.
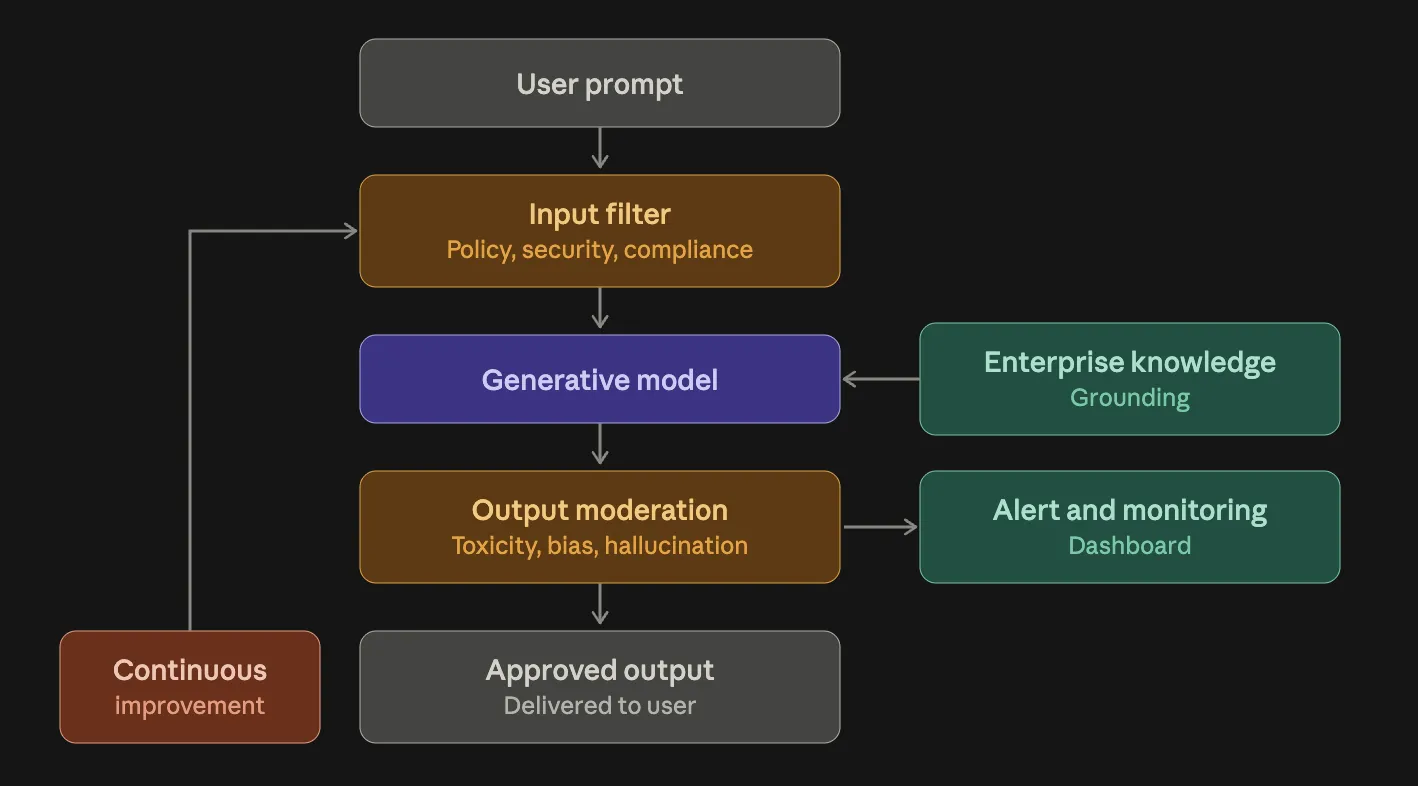
AI Guardrails im Unternehmen funktionieren am besten, wenn sie eng mit dem Risikoprofil und den Anwendungsfällen Ihrer Organisation abgestimmt sind. Beginnen Sie mit einer klaren Definition dessen, was Sie schützen müssen – seien es sensible Daten, regulatorische Compliance oder die Markensprache – und ordnen Sie jede Anforderung spezifischen Guardrail-Typen wie PII-, Themen- oder Wortfiltern zu. Binden Sie Stakeholder aus Rechts-, Compliance- und Produktteams frühzeitig ein, um sicherzustellen, dass die Richtlinien reale Rahmenbedingungen widerspiegeln und kritische Workflows nicht unbeabsichtigt blockieren.
Halten Sie Ihre Regeln als Nächstes so fokussiert wie möglich. Breites „Alles verbieten“-Listen können zu übermäßigen False Positives führen, die Nutzer frustrieren. Gruppieren Sie stattdessen verwandte Richtlinien in separate Regeln, die nach Kontext abgegrenzt sind, und nutzen Sie den when-Block, um gezielt bestimmte Modelle, Teams oder Metadaten anzusprechen.
Wenden Sie beispielsweise eine strenge PII-Schwärzung nur auf kundenorientierte Bots an, während Sie internen Analyse-Assistenten mehr narrativen Spielraum lassen. Dieser modulare Ansatz erleichtert die Wartung und Weiterentwicklung Ihrer Enterprise AI Guardrails im Laufe der Zeit.
Die Abstimmung von Schwellenwerten (Threshold Tuning) ist eine weitere wichtige Praxis. Beginnen Sie in nicht-kritischen Umgebungen mit konservativen Empfindlichkeitsstufen, um zu beobachten, wie oft Regeln greifen, und passen Sie die Schwellenwerte basierend auf der tatsächlichen Nutzung nach unten oder oben an. Nutzen Sie die Protokolle jedes Guardrail-Ereignisses, um Muster von False Positives oder übersehenen Verstößen zu identifizieren, und iterieren Sie dann über Ihre Einstellungen. Automatisierte Test-Suiten, die bekannte Richtlinienverstöße in Prompts und erwartete Antworten einspeisen, können helfen, die Regelabdeckung zu validieren, bevor Updates in die Produktion eingespielt werden.
Dokumentation und Observability sind unerlässlich. Führen Sie ein zentrales Repository Ihrer Guardrail-Konfigurationen mit klaren Beschreibungen des Zwecks und des Umfangs jeder Regel. Stellen Sie sicher, dass Ihre Protokollierung erfasst, welche Regel ausgelöst wurde, welcher Inhalt gematcht wurde und welche Transformationen angewendet wurden. Integrieren Sie diese Logs in Ihre Monitoring-Tools, um Benachrichtigungen auszulösen, wenn die Auslösungsraten von Regeln unerwartet ansteigen, was auf potenziellen Missbrauch oder Änderungen im Benutzerverhalten hinweisen kann.
Etablieren Sie schließlich eine Feedbackschleife mit Nutzern und Entwicklern. Bieten Sie Endnutzern oder Anwendungsteams Mechanismen zur Meldung von Über-Blockierungen oder fehlenden Richtlinien. Überprüfen Sie regelmäßig Feedback, Nutzungsmetriken und Sicherheits-Audit-Ergebnisse, um Ihre Guardrails zu verfeinern. Durch die Kombination von klaren Zielen, gezielten Regeln, iterativer Abstimmung und starker Observability bauen Sie ein Guardrail-Framework auf, das Ihr Unternehmen schützt, ohne Innovationen zu behindern.
Guardrails verwandeln leistungsstarke, aber unvorhersehbare LLMs in zuverlässige, enterprise-fähige Dienste, indem sie bei jeder Interaktion klare, kontextbezogene Richtlinien durchsetzen. Durch das Definieren präziser Eingabe- und Ausgaberegeln – wie das Maskieren sensibler PII, das Blockieren unzulässiger Themen oder das Filtern proprietärer Begriffe – wahren Sie den Datenschutz, halten die Markensprache ein und erfüllen regulatorische Anforderungen, ohne den Anwendungscode anzupassen.
Modulare Regeln, die über den when-Block eingegrenzt werden, ermöglichen Ihnen eine maßgeschneiderte Durchsetzung pro Modell, Team oder Workflow, während Schwellenwert-Tuning und robuste Protokollierung das Gleichgewicht zwischen Schutz und Benutzerfreundlichkeit sichern.
Mit den Guardrails von TrueFoundry gewinnen Sie zentrale Kontrolle, kontinuierliche Revisionssicherheit und das Vertrauen, AI in großem Maßstab einzusetzen – in dem Wissen, dass jede Anfrage und Antwort Ihren Governance-Standards entspricht.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




AI guardrails in enterprise are controls that help organizations manage how AI systems receive inputs, generate outputs, access data, and use tools. They can prevent unsafe content, protect sensitive information, detect prompt injection, and enforce organizational policies.
Key components include input and output validation, PII protection, content moderation, prompt injection detection, access controls, and tool restrictions. Together, these enterprise AI guardrails help control AI behavior, protect sensitive data, and enforce security policies.
AI guardrails for enterprise applications can reduce security risks, protect sensitive information, prevent harmful outputs, and support policy enforcement. They also provide greater control over AI systems, helping organizations deploy applications more consistently across teams and business functions.
The right AI guardrail tool depends on your models, workloads, security requirements, and deployment environment. Evaluate tools based on input and output controls, PII protection, prompt injection detection, observability, integrations, customization, and enterprise deployment options. Platforms such as TrueFoundry can provide these controls alongside centralized AI infrastructure and governance for enterprise deployments.
AI guardrails support compliance by enforcing consistent policies around data handling, content, model access, and AI actions. Combined with audit logs, access controls, and monitoring, they give enterprises greater visibility and control over how AI systems are used.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet