



November 6, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
DeepSeek-V4-Pro ging am 24. April 2026 in die Preview und wurde am 13. August 2026 allgemein verfügbar (GA) — nach knapp vier Monaten. Der API-Modellname hat sich nie geändert: Sie rufen weiterhin deepseek-v4-pro auf, und die GA-Version hat einfach die Preview dahinter ersetzt.
Die Spezifikationen gemäß der DeepSeek-Seite Models & Pricing und der GA-Modellkarte (Stand: September 2026):
Zwei Details sind wichtiger als die Parameteranzahl.
Erstens: Die Gewichte sind wirklich offen. Der GA-Checkpoint ist unter deepseek-ai/DeepSeek-V4-Pro-0813 unter der MIT-Lizenz veröffentlich — keine maßgeschneiderte Community-Lizenz mit einer Umsatzgrenze oder Nutzungsbereichsbeschränkungen. MIT ist so freizügig wie nur möglich. Das ist die eine Tatsache, die den Rest dieses Beitrags überhaupt erst schreibenswert macht.
Zweitens: Die Effizienzarbeit ist die eigentliche Architektur-Story. Die Preview-Modellkarte beschreibt ein hybrides Attention-Design, das Compressed Sparse Attention und Heavily Compressed Attention kombiniert, und berichtet, dass V4-Pro bei einem Kontext von 1M Token nur etwa 27 % der Single-Token-Inferenz-FLOPs und 10 % des KV-Caches von DeepSeek-V3.2 benötigt. Langer Kontext lässt sich hier auf eine Weise günstig bereitstellen, wie es in der V3-Generation nicht möglich war, was die Self-Hosting-Kalkulation genau deshalb so interessant macht.
[SCREENSHOT: DeepSeek chat — the Expert Mode selector that routes to V4-Pro on app and web]
DeepSeek drückt sich hier ungewöhnlich direkt aus. Die GA-Modellkarte gibt an, dass V4-Pro-0813 „auf der Modellstruktur von DeepSeek-V4-Pro (Preview) aufbaut, an die ein DSpark-Modul für spekulatives Dekodieren angehängt wurde“ — das Basismodell ist dasselbe; das Post-Training und der Dekodierungspfad sind es nicht.
Die veröffentlichten Abweichungen von der Preview zur GA-Version:
Quelle: DeepSeek-V4-Pro-0813 Modellkarte, September 2026.
Ein Wort der Warnung beim Lesen dieser Zahlen. DeepSeek weist darauf hin, dass die Ergebnisse der Code-Agenten mit dem eigenen DeepSeek Harness im Minimalmodus bei maximalem Reasoning-Aufwand (reasoning_effort = max), Temperature = 1,0, top_p = 0,95 erzielt wurden. Ein fast fünffacher Sprung bei DeepSWE ist ein Post-Training-Ergebnis, das unter dem eigenen Harness des Anbieters gemessen wurde, keine unabhängige Reproduktion. Die Tendenz ist eindeutig real; das Ausmaß verdient jedoch Ihre eigene Evaluierung.
Neben dem Modell brachte die GA-Version native Unterstützung für die OpenAI Responses API mit einer Ein-Klick-Codex-Konfiguration sowie die dreistufige Steuerung des reasoning_effort, die den binären Thinking-Schalter ersetzt.
Die GA-Modellkarte enthält eine Vergleichstabelle mit offenen und geschlossenen Konkurrenten. Hier ist der Teil, den jeder zitiert, und anschließend der Teil, den die meisten Beiträge weglassen.
Quelle: DeepSeek-V4-Pro-0813 Modellkarte, September 2026.
Wo V4-Pro führt. Terminal-basierte Agenten-Aufgaben und sicherheitsrelevantes Coding. Es schlägt Opus-4.8 bei Terminal Bench 2.1, DeepSWE, Cybergym und AutomationBench. Für ein Modell, das man herunterladen kann, ist das ein echtes Ergebnis.
Wo die proprietären Modelle weiterhin gewinnen. Reines Wissen und die komplexeren Repository-Aufgaben. Opus-4.8 liegt bei NL2Repo um mehr als acht Punkte vorne, ebenso bei DSBench-Hard, Toolathlon-Verified und HLE ohne Tools. Fable-5 mit Fallback führt bei den meisten derselben Disziplinen. Wenn Ihre Arbeitslast von komplexen Änderungen an mehreren Repository-Dateien oder von der Wissensbreite dominiert wird, bleiben die proprietären Frontier-Modelle die bessere Antwort — daran ändert auch noch so viel Lizenz-Enthusiasmus nichts.
Wo die anderen Open-Source-Modelle stehen. Kimi K3 liegt bei Terminal Bench 2.1 und DeepSWE knapp vor V4-Pro. Der Titel „Bestes Open-Weight-Modell“ ist umkämpft und nicht entschieden. Der interessante Anspruch ist spezieller und nachhaltiger: Ein herunterladbares Modell ist jetzt nah genug an der Leistungsgrenze (Frontier), dass sich die Frage nach dem eigenen Deployment konkret stellt.
DeepSeek hat mit der GA-Version eine getrennte Abrechnung nach Spitzenzeiten (Peak) und Nebenzeiten (Off-Peak) eingeführt, die am 16. August 2026 um 16:00 UTC in Kraft getreten ist. Die Off-Peak-Tarife betragen genau die Hälfte der Peak-Tarife. Spitzenzeiten sind Montag bis Freitag von 01:00-04:00 und 06:00-10:00 UTC, ausgenommen chinesische Feiertage; alle anderen Zeiten, einschließlich der Wochenenden, gelten als Off-Peak.
Quelle: DeepSeek Models & Pricing, September 2026.
Drei Dinge sind hierbei zu beachten: Der Preis für einen Cache-Hit ist 30-mal niedriger als für einen Cache-Miss, daher ist die Prompt-Struktur bei allen Anfragen mit einem stabilen System-Prompt enorm wichtig. Die Aufteilung in Peak und Off-Peak ist ein Instrument zur Laststeuerung, kein Rabatt — wer Batch-Aufgaben in die Off-Peak-Zeiten verlegt, halbiert seine Rechnung. Zudem hat DeepSeek die Preise bei der GA-Freigabe gegenüber der Preview erhöht, wobei die veröffentlichten Tarife der Preview [VERIFY] sind — sie stehen nicht mehr auf der Preisseite und wir werden sie nicht aus Sekundärquellen beziehen.
Ein betrieblicher Hinweis: Das Limit für gleichzeitige API-Anfragen (Concurrency Limit) für deepseek-v4-pro liegt bei 500. DeepSeek hat am 10. September 2026 außerdem bestätigt, dass die V4 Pro API auch über den 14. September 2026 hinaus mit unveränderter Abrechnung bereitgestellt wird (Änderungsprotokoll).
[SCREENSHOT: DeepSeek Platform — usage dashboard showing peak vs off-peak token spend]
Bei Open-Weight-Frontier-Modellen treten immer wieder vier Fehlermuster auf — und V4-Pro weist sie alle vier auf.
Die Self-Hosting-Rechnung betrifft einen Node, nicht eine GPU. DeepSeeks Referenz-Befehl zur Bereitstellung in der Modellkarte zielt auf eine Konfiguration mit einem einzelnen 4-Node-GB300-System über vLLM ab, wobei FP8-KV-Cache, Expert Parallelism und DSpark für spekulatives Dekodieren aktiviert sind. Ein MoE mit 1,7 Billionen Parametern fährt man nicht mal eben auf einer ungenutzten A100 hoch. Die Open-Weights geben Ihnen die Option zum Self-Hosting; ob die Rechnung gegenüber $ 1,98 pro Million Output-Token aufgeht, hängt vollständig von Ihrer Auslastung ab. Unterhalb einer recht hohen, gleichmäßigen Grundlast gewinnt die API.
Es gibt kein Chat-Template. Die GA-Version wird ohne Jinja-Chat-Template ausgeliefert. DeepSeek stellt stattdessen einen Ordner mit Python-Skripten zur Kodierung bereit, um Nachrichten im OpenAI-Format in Modell-Inputs umzuwandeln und die Ausgabe zurückzuparsen. Jeder Teil Ihres Stacks, der tokenizer.apply_chat_template voraussetzt, muss angepasst werden.
V4-Pro hat keine Vision-Unterstützung. Multimodale Verarbeitungsfähigkeiten sind der Flash-Reihe vorbehalten, nicht Pro. Eine Einzel-Modell-Strategie, die Multimodalität voraussetzt, greift hier nicht — was bedeutet, dass Sie Anfragen über mindestens zwei Modelle routen müssen, ob Sie das geplant hatten oder nicht.
Datenresidenz und API sind jetzt zwei getrennte Entscheidungen. Das Senden von Prompts an api.deepseek.com ist eine andere Datenflussfrage als das Ausführen derselben Gewichte in Ihrer eigenen VPC. Teams verwechseln häufig „Wir können DeepSeek V4 nutzen“ mit „Wir können die DeepSeek-API aufrufen“ — und beide Fragen erhalten bei derselben Sicherheitsüberprüfung unterschiedliche Antworten. Ihre eigene Rechtsabteilung entscheidet, was zulässig ist; der Punkt ist lediglich, dass die Open-Weights technisch beide Wege ermöglichen.
Ein Open-Weight-Frontier-Modell ändert Ihre Wirtschaftlichkeit nur dann, wenn Sie es auch tatsächlich irgendwo einsetzen können. Das ist genau der Teil, den TrueFoundry übernimmt.
Hosten Sie es selbst in Ihrer eigenen VPC. Das AI Gateway registriert selbstgehostete Open-Weight-Modelle neben gehosteten Anbietern: Sie deployen V4-Pro auf Ihrem eigenen Kubernetes mit vLLM oder SGLang, verweisen das Gateway auf den Endpunkt, und es erscheint im Modellkatalog mit demselben Routing, Rate Limiting, Cost Tracking und derselben Observability wie jedes API-Modell (Dokumentation zu selbstgehosteten Modellen). Da sowohl vLLM als auch SGLang standardmäßig ein OpenAI-kompatibles API bereitstellen, benötigt das Gateway keinen DeepSeek-spezifischen Adapter.
Oder rufen Sie die API auf und halten Sie sich die Option offen. Wenn Sie noch nicht bereit für Self-Hosting sind, routen Sie über das Gateway zur API von DeepSeek und nutzen Sie denselben Aufrufpfad, den Sie später für ein selbstgehostetes Deployment verwenden würden. Der Wechsel vom gehosteten Endpunkt zu Ihrem eigenen Cluster wird so zu einer bloßen Konfigurationsänderung statt zu einem Umschreiben der Anwendung.
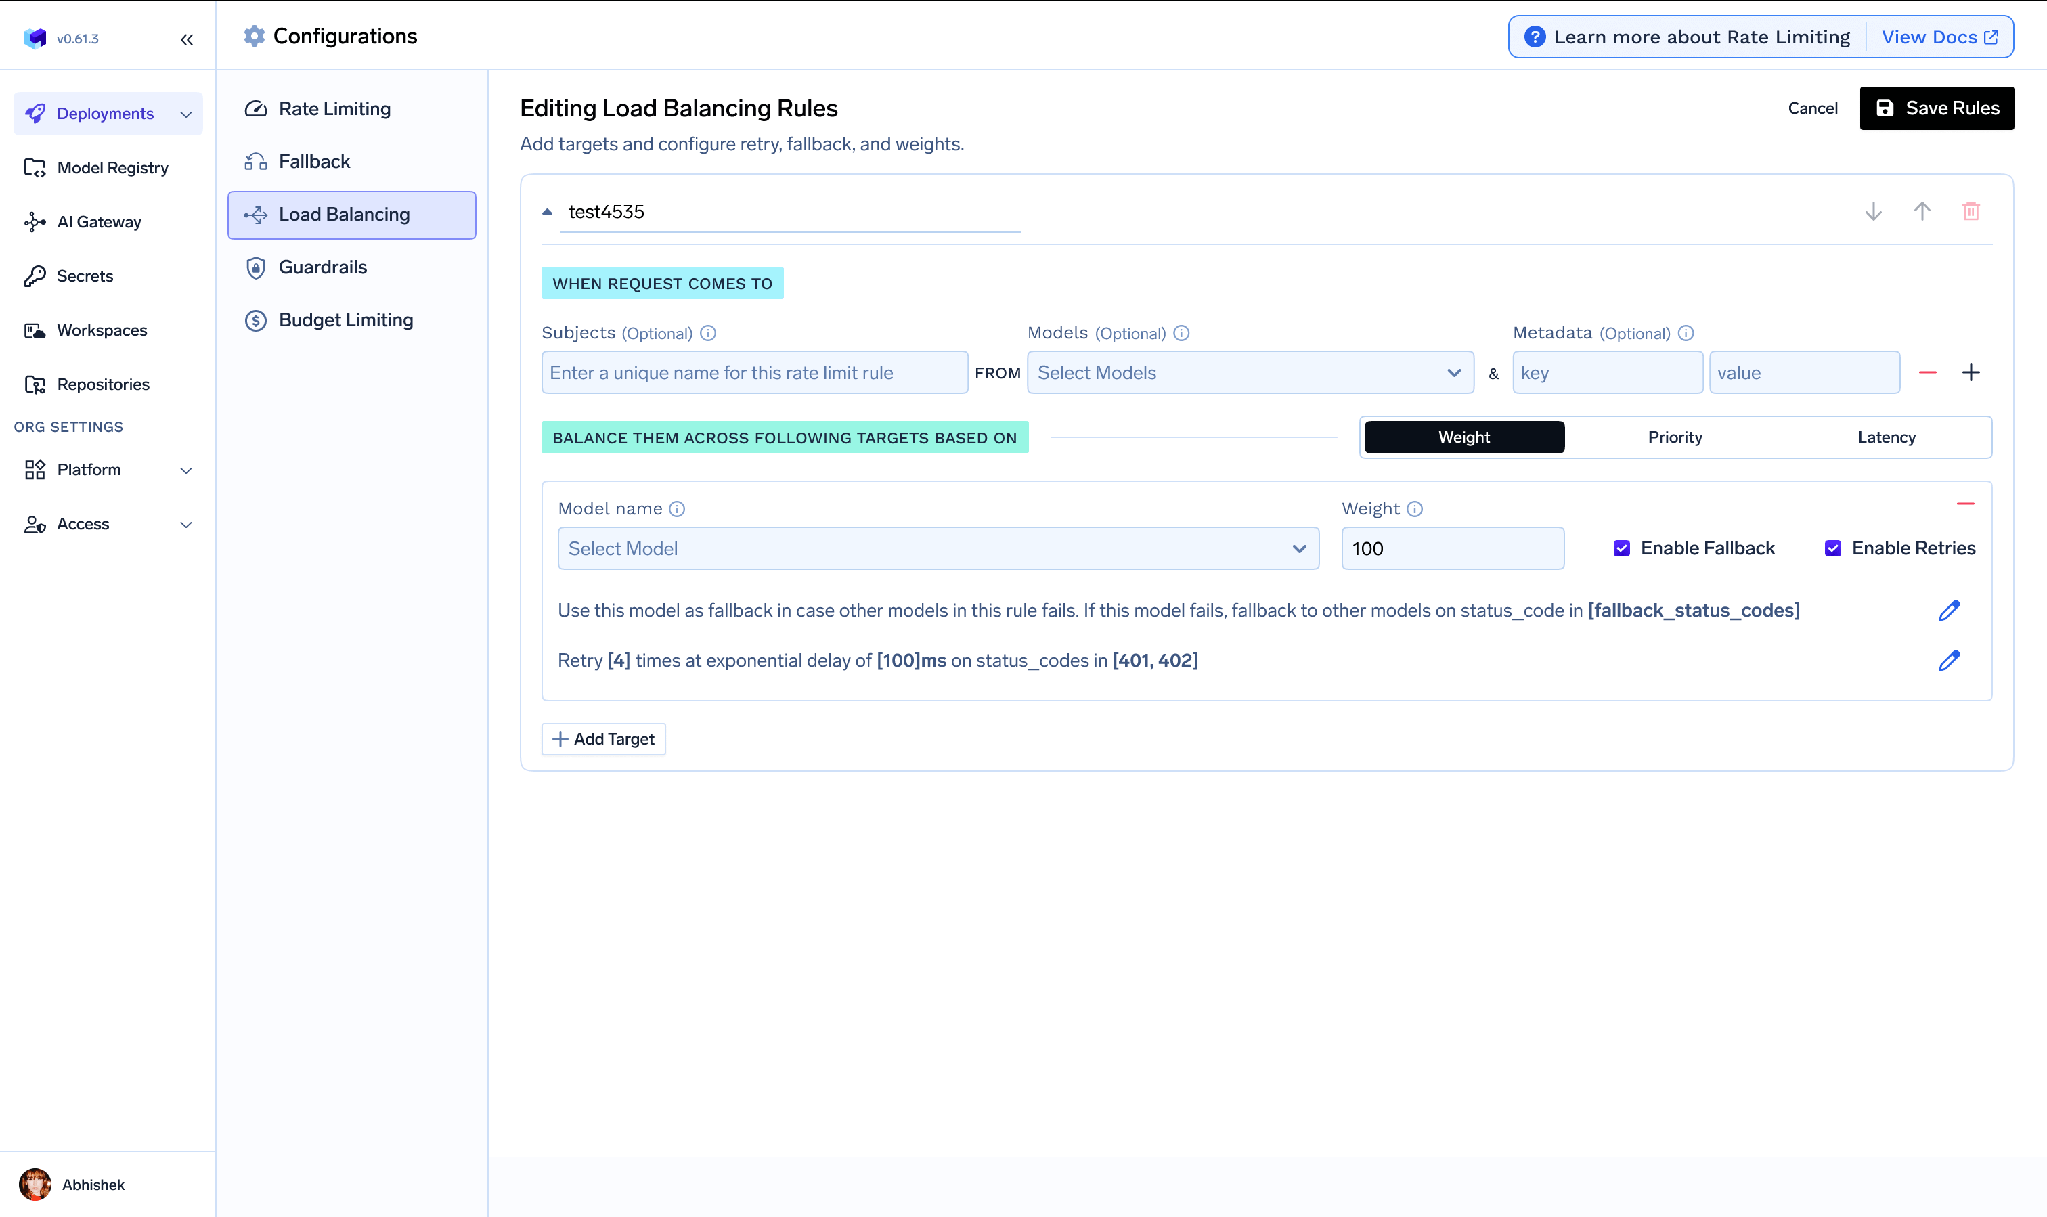
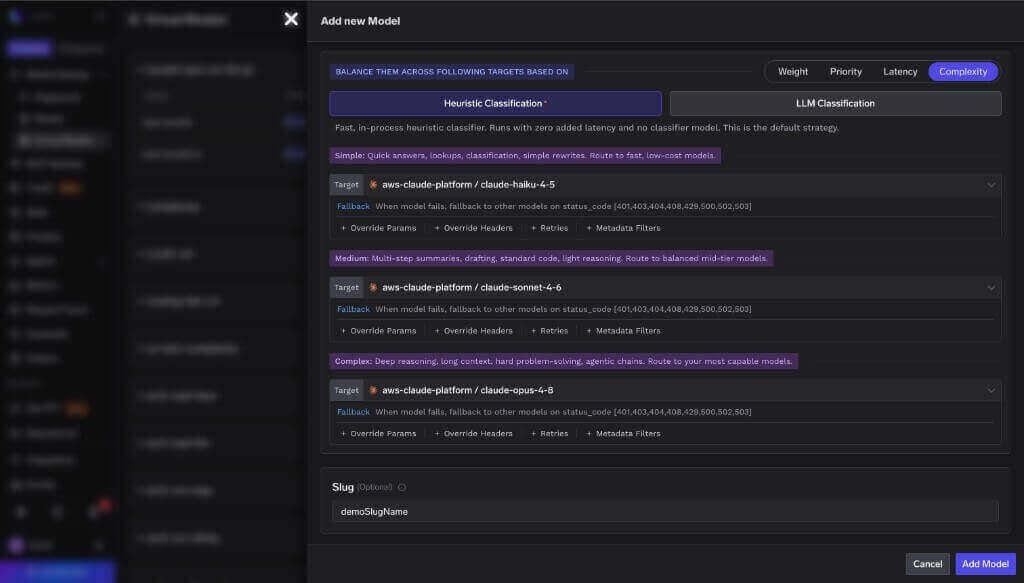
Routen Sie nach Komplexität, nicht nach Gewohnheit. Die Benchmark-Tabelle oben ist ein Argument für eine gemischte Flotte, nicht für eine Migration — und kosten- und qualitätsbewusstes Routing ist der Weg, eine solche zu betreiben. Komplexe Repository-Arbeiten gehen an Opus-4.8, Terminal-basierte Agentenläufe an V4-Pro, Klassifizierung und Extraktion an ein günstigeres Modell. Im eigenen Auto-Routing-Benchmark von TrueFoundry über 550 Prompts hinweg senkte die Staffelung von Anfragen die Kosten um 69 % bei Erhalt von 98 % der Baseline-Qualität, während die durchschnittliche Latenz von 7,6 s auf 4,0 s sank; bei produktionsnahem Datenverkehr erreichte die Einsparung 80 %.
Wenden Sie in beiden Fällen dieselben Guardrails an. Ein selbstgehostetes Modell erbt nicht automatisch den Sicherheits-Stack eines Anbieters. Guardrails auf Gateway-Ebene greifen im Request- und Response-Pfad — unabhängig davon, ob es sich beim Modell um den Endpunkt von DeepSeek oder Ihren eigenen Pod handelt.

Messen Sie, bevor Sie sich festlegen. Die Kosten und Latenzzeiten pro Anfrage und Team sind der einzige Weg, um herauszufinden, ob die Off-Peak-Preise von V4-Pro oder ein selbstgehosteter Node Ihre aktuellen Betriebskosten tatsächlich unterbieten.

Die Kurzfassung (Stand: September 2026):

Die GA-Veröffentlichung von DeepSeek V4-Pro ist keine reine Benchmark-Erfolgsgeschichte. Nach den von DeepSeek selbst veröffentlichten Zahlen schlägt es Opus-4.8 bei einigen Agenten-Aufgaben, unterliegt ihm jedoch bei komplexeren Repository-Arbeiten sowie beim Allgemeinwissen, und Kimi K3 macht ihm die Führung unter den Open-Source-Modellen streitig. Als bloßer Ranglisteneintrag betrachtet ist es ein gutes Modell mit einem gemischten Leistungsprofil.
Betrachtet man es jedoch als Lizenzmodell, ergibt sich ein anderes Bild. Ein Modell mit 1M-Kontext, das nah genug an der Leistungsgrenze liegt, um eine echte Option darzustellen, und unter der MIT-Lizenz veröffentlicht wurde, bedeutet: Die Frage nach dem Deployment ist nicht mehr rein theoretischer Natur. Sie können es in Ihrer eigenen VPC ausführen, Prompts auf der von Ihnen kontrollierten Infrastruktur halten und für Compute statt für Token bezahlen — vorausgesetzt, Ihre Auslastung rechtfertigt einen leistungsstarken Node und Sie sind bereit, den Serving-Stack selbst zu betreiben. Für die meisten Teams wird das heute noch nicht der Fall sein, weshalb der richtige Schritt darin besteht, Anfragen an die API zu routen und sich gleichzeitig den Pfad zum Self-Hosting offenzuhalten.
Das ist das ehrliche Fazit: Es läuft darauf hinaus, was Sie selbst verwalten möchten. Wenn Sie möchten, dass jemand anderes das Modell betreibt, ist die proprietäre Frontier weiterhin der schnellste Weg und liefert bei den schwersten Aufgaben nach wie vor die besten Ergebnisse. Wenn Sie sich die Option offenhalten wollen, das Modell ohne Anpassungen an der Anwendung in Ihre eigene Umgebung zu verlagern, ist ein Open-Weight-Modell hinter einem Gateway der Weg, sich diese Option kostengünstig zu sichern — und Sie sollten sie sich sichern, bevor Sie sie dringend benötigen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




DeepSeek V4 ist die Mixture-of-Experts-Modellfamilie von DeepSeek. Die V4-Preview mit V4-Pro und V4-Flash erschien am 24. April 2026. DeepSeek-V4-Pro erreichte am 13. August 2026 als DeepSeek-V4-Pro-0813 die allgemeine Verfügbarkeit.
Die Gewichte und das Repository sind unter der MIT-Lizenz auf Hugging Face unter deepseek-ai/DeepSeek-V4-Pro-0813 veröffentlicht. Das umfasst Gewichte und Code, nicht die Trainingsdaten; „Open Weight“ ist daher der präzisere Begriff als „Open Source“.
Stand September 2026: 0,66 $ pro Million Input-Tokens außerhalb der Spitzenzeiten und 1,32 $ zu Spitzenzeiten bei einem Cache-Miss, 0,022 $ und 0,044 $ bei einem Cache-Hit sowie 1,98 $ und 3,96 $ pro Million Output-Tokens. Spitzenzeiten sind werktags von 01:00 bis 04:00 und von 06:00 bis 10:00 UTC.
Ja, und DeepSeek veröffentlicht Serving-Rezepte für vLLM und SGLang. Seien Sie realistisch, was die Größenordnung angeht: Es ist ein Modell mit 1,7 Billionen Parametern, und die Referenzkonfiguration in der Model Card ist ein GB300-Knoten mit mehreren GPUs.
Das AI Gateway von TrueFoundry fügt etwa 3–4 ms hinzu und bewältigt mehr als 350 RPS auf 1 vCPU – unerheblich im Vergleich zu Generierungszeiten von mehreren Sekunden.
Nein, und die oben gezeigte Streuung der Benchmarks ist das Argument dagegen. Nach Aufgabentyp über offene und geschlossene Modelle hinweg zu routen, ist meist günstiger und besser, als sich auf eines festzulegen.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet



















