



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Aktualisiert: November 3, 2026
Published: April 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Die Auswahl eines Large Language Models (LLM) ist heute weit komplizierter als noch vor ein oder zwei Jahren. Regelmäßig werden neue Modelle veröffentlicht, bestehende erhalten umfassende Upgrades, und jedes verspricht bessere logische Schlussfolgerungen, schnelleres Antwortverhalten, größere Kontextfenster oder niedrigere Kosten. Eine größere Auswahl ist zwar von Vorteil, macht die Wahl des passenden Modells jedoch auch deutlich anspruchsvoller.
Die Realität zeigt: Es gibt kein einzelnes LLM, das in allen Bereichen das beste ist. Ein Modell, das beim Coding hervorragende Ergebnisse liefert, ist für den Kundensupport möglicherweise nicht die kosteneffizienteste Wahl. Ein anderes glänzt vielleicht bei komplexen Schlussfolgerungen, fällt jedoch bei der Latenz oder beim Tool Calling ab. Deshalb reicht es nicht aus, sich ausschließlich auf Benchmark-Werte oder die Popularität eines Modells zu verlassen.
Hier kommt der Vergleich der LLM-Fähigkeiten ins Spiel. Statt zu fragen: „Welches Modell ist das beste?“, lautet die bessere Frage: „Welches Modell ist das beste für meinen konkreten Anwendungsfall?“
In diesem Leitfaden erörtern wir, was LLM-Fähigkeiten sind, wie Sie sie vergleichen sollten und warum dieser Vergleich von entscheidender Bedeutung ist.
LLM-Fähigkeiten sind die einzelnen Merkmale und Funktionen, die festlegen, was ein Large Language Model leisten kann und wie effizient es eine Aufgabe ausführt. Obwohl LLMs darauf ausgelegt sind, Sprache zu verstehen und zu generieren, unterscheiden sich ihre Fähigkeiten je nach Trainingsmethode, den genutzten Trainingsdaten und der zugrunde liegenden Architektur.
Ein Vergleich der LLM-Fähigkeiten ist keineswegs nur eine technische Übung – er dient der Risikominimierung, bevor Ihre Anwendung in den Produktivbetrieb geht. Er hilft Ihnen zu überprüfen, ob ein Modell Ihre funktionalen Anforderungen heute erfüllt und Ihre Anwendung auch bei künftigem Wachstum zuverlässig unterstützt.
Anstatt Einschränkungen erst mitten in der Entwicklung zu entdecken, können Sie diese frühzeitig identifizieren und fundierte Kompromisse eingehen.
Das erreichen Sie durch einen gezielten Vergleich der Fähigkeiten:
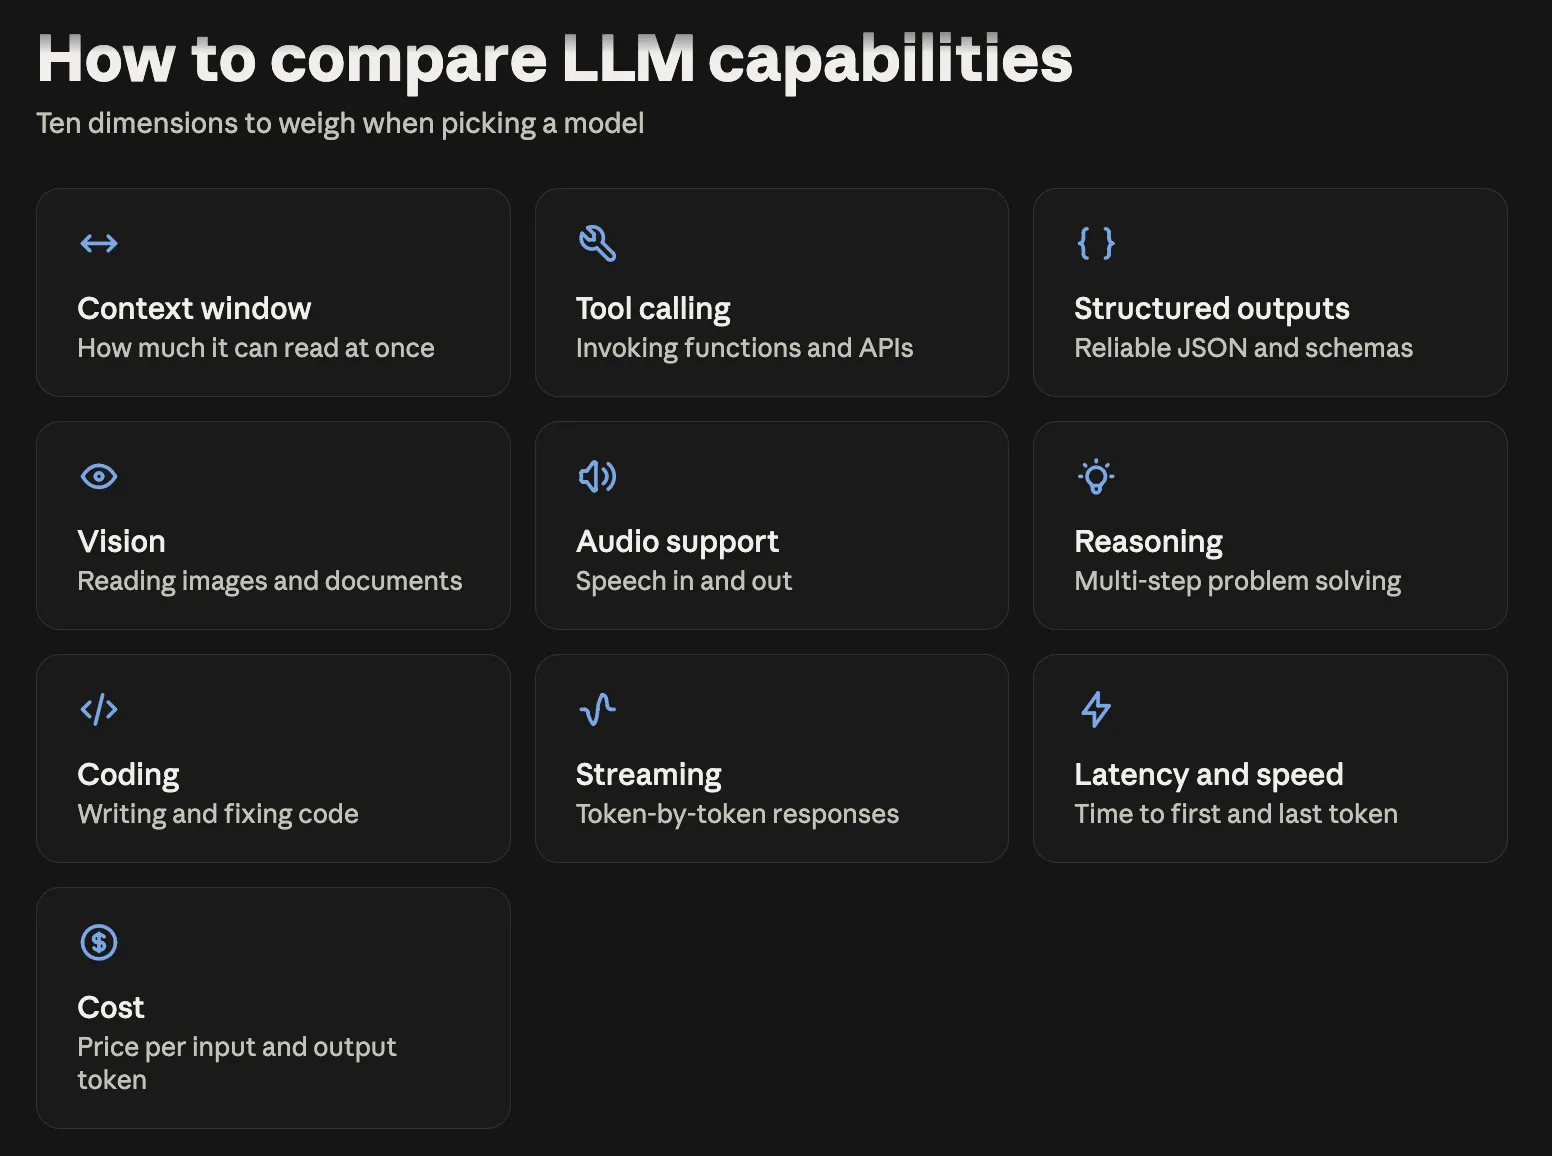
Ein effektiver Vergleich von LLM-Fähigkeiten konzentriert sich auf die Funktionen, die sich direkt auf Ihre Anwendung auswirken. Anstatt sich nur auf Benchmark-Ergebnisse zu verlassen, sollten Sie evaluieren, ob ein Modell die für Ihren Anwendungsfall erforderlichen Fähigkeiten tatsächlich unterstützt.
Vergleichen Sie die folgenden Fähigkeiten, um zu beurteilen, wie gut das jeweilige Modell zu den Anforderungen Ihrer Anwendung passt:
Ein größeres Kontextfenster ermöglicht es dem Modell, umfangreiche Dokumente, lange Unterhaltungen oder komplexe Codebasen in einer einzigen Anfrage zu verarbeiten. Vergleichen Sie sowohl die unterstützte Kontextlänge als auch die Verarbeitungsleistung bei größeren Eingabemengen.
Tool Calling ermöglicht es LLMs, mit APIs, Datenbanken und anderen externen Systemen zu interagieren. Evaluieren Sie, wie zuverlässig ein Modell diese Aktionen ausführt.
Wenn Ihre Anwendung auf Formate wie JSON angewiesen ist, sollten Sie vergleichen, wie konsistent die Modelle strukturierte, schema-konforme Antworten erzeugen.
Vision-fähige Modelle können Bilder, PDFs, Diagramme und Screenshots analysieren. Prüfen Sie die unterstützten Eingabetypen und die Qualität des visuellen Verständnisses.
Vergleichen Sie bei sprachbasierten Anwendungen, ob die Modelle Spracheingabe, Transkription oder Audio-Generierung unterstützen.
Die Fähigkeit zur logischen Schlussfolgerung bestimmt, wie gut ein Modell mehrstufige Analysen, Planungen und Problemlösungen bewältigt. Testen Sie dies mit Aufgaben, die Ihren realen Workflows entsprechen.
Wenn Sie Entwickler-Tools aufbauen, sollten Sie evaluieren, wie gut das Modell Code über verschiedene Programmiersprachen hinweg generiert, erklärt und fehlerbereinigt.
Beim Streaming werden Antworten direkt während der Generierung zurückgegeben, was die Antwortzeiten und Interaktivität bei Chatbots und anderen Echtzeitanwendungen erheblich verbessert.
Eine niedrige Latenz ist für interaktive Nutzererfahrungen essenziell. Vergleichen Sie die Antwortzeiten unter realistischen Workloads, anstatt sich nur auf veröffentlichte Werte zu verlassen.
Berücksichtigen Sie die Token-Preise in Kombination mit der Leistung, um zu ermitteln, ob ein Modell für Ihre erwartete Nutzung kosteneffizient ist.
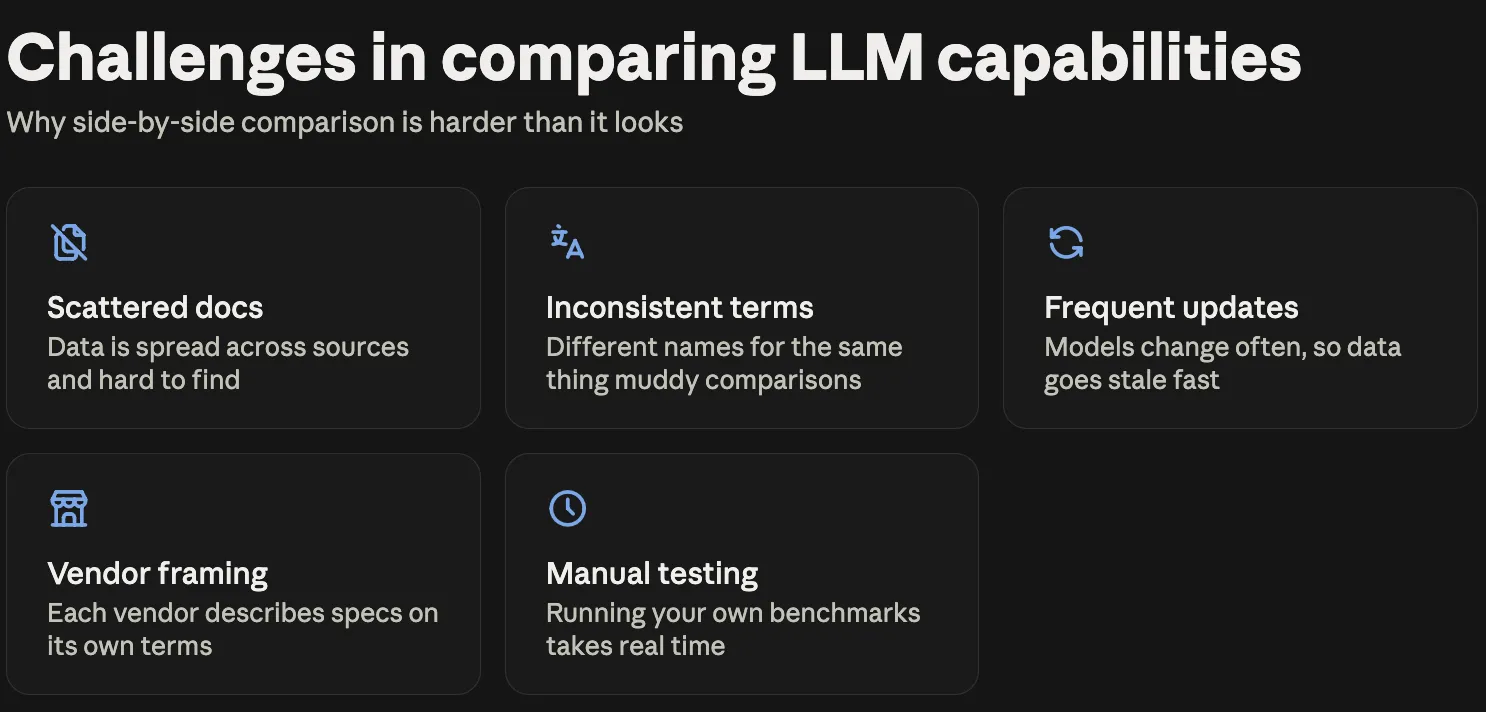
Die Bewertung von LLM-Fähigkeiten ist komplexer als es zunächst scheint. Unterschiedliche Dokumentationsstandards und häufige Modell-Updates erschweren präzise Vergleiche.
Sobald Sie wissen, welche Fähigkeiten entscheidend sind, benötigen Sie eine einfache Möglichkeit, diese modellübergreifend zu vergleichen. Statt die Dokumentationen verschiedener Anbieter manuell zu durchsuchen, bieten Modellprofile alle Informationen in einem standardisierten Format.
Stellen Sie sich ein Modellprofil wie eine Datenkarte für die Fähigkeiten eines LLMs vor. Anstatt Dokumentationen zu durchforsten oder Mutmaßungen anzustellen, sehen Sie die unterstützten Funktionen in einer einheitlichen Struktur.
Modellprofile enthalten Informationen wie Kontextfenster, Tool Calling, strukturierte Ausgaben, Vision-Unterstützung, Audio-Fähigkeiten und weitere Kernfunktionen, die beim Vergleich von LLM-Fähigkeiten relevant sind. Da jedes Modell demselben Schema folgt, lassen sich Anbieter mühelos direkt gegenüberstellen.
Die Daten stammen von models.dev, einem Open-Source-Projekt, das Fähigkeiten von Modellen führender Anbieter wie OpenAI, Anthropic, Google und weiteren erfasst. Diese Profile stehen über LangChain-Pakete zur Verfügung und bieten Entwicklern einen konsistenten Weg, programmgesteuert im Code auf Informationen zu Modellfähigkeiten zuzugreifen.
Stellen Sie sich vor, Sie lesen, dass ein Modell Bildverarbeitung unterstützt, und entwickeln daraufhin eine Funktion zur Bildanalyse. Einige Wochen später stellen Sie fest, dass diese Funktion nur in einer Preview-Version verfügbar war oder eine spezielle API-Konfiguration erforderte. Plötzlich funktioniert Ihre Implementierung nicht mehr – nicht wegen eines Fehlers im Code, sondern aufgrund einer fehlerhaften Annahme bezüglich der Modellfähigkeiten.
Oder Sie vergleichen fünf verschiedene Modelle für ein neues Projekt. Sie öffnen die Dokumentation mehrerer Anbieter, erstellen eine Tabelle und versuchen herauszufinden, ob Begriffe wie Tool Calling, Function Calling und API-Integration alle dieselbe Funktion bezeichnen. Sehr schnell nimmt der Vergleich der Modelle mehr Zeit in Anspruch als deren eigentliche Evaluierung.
Modellprofile verhindern solche Szenarien. Anstatt anbieterspezifische Dokumentationen zu übersetzen, erhalten Sie eine standardisierte Übersicht der unterstützten Funktionen. Ihre Anwendung kann Fähigkeiten vor der Nutzung einer Funktion sogar automatisiert abfragen. Das reduziert unerwartete Probleme während der Entwicklung und macht den Vergleich von LLM-Fähigkeiten schneller, konsistenter und verlässlicher.
Die Auswahl eines LLMs erfordert oft zeitintensive Recherche in unterschiedlichen Dokumentationen. Modellprofile vereinfachen diesen Prozess, indem sie Entwicklern auf einen Blick zeigen, was jedes Modell leistet.
Die Auswahl eines LLMs beginnt meist mit einer Reihe von Fragen: Wird Tool Calling unterstützt? Wie groß ist das verarbeitbare Kontextfenster? Können Bilder verarbeitet werden? Antworten auf diese Fragen bei verschiedenen Anbietern zu suchen, kostet wertvolle Zeit.
Mit Modellprofilen können Entwickler Modelle schnell nach den benötigten Fähigkeiten filtern. Ein Team, das einen Kundensupport-Bot entwickelt, kann beispielsweise direkt prüfen, welche Modelle Tool Calling für Bestellabfragen unterstützen und ausreichend Kontextkapazität für längere Unterhaltungen bieten. So bleibt mehr Zeit für das Testen der tatsächlichen Modellleistung, anstatt Grundfunktionen manuell zu überprüfen.
Moderne Anwendungen nutzen häufig mehrere Modelle für unterschiedliche Aufgaben. Ein Modell übernimmt komplexe logische Analysen, während ein anderes einfachere Anfragen kostengünstig verarbeitet.
Modellprofile ermöglichen es Anwendungen, vor dem Senden einer Anfrage automatisiert zu prüfen, ob das Modell die erforderlichen Fähigkeiten unterstützt. Dies erleichtert den Aufbau von Systemen, die flexibel zwischen Modellen wechseln und Änderungen ohne unerwartete Ausfälle bewältigen können.
Viele Teams greifen standardmäßig auf das leistungsfähigste Modell zurück, da es vertraut und verlässlich wirkt. Allerdings erfordert nicht jede Aufgabe das Modell mit den umfangreichsten Fähigkeiten.
Durch den Vergleich von Modellprofilen können Entwickler kleinere oder kosteneffizientere Modelle identifizieren, die dennoch alle erforderlichen Funktionen bieten. Das hilft Teams, Kosten zu optimieren und gleichzeitig die geforderte Leistung für verschiedene Workloads sicherzustellen.
Modellprofile sind nicht nur für Entwickler beim Schreiben von Code wertvoll, sondern auch für Teams, die strategische Entscheidungen zum Einsatz von KI treffen. Durch die einheitliche Darstellung von Modellfähigkeiten helfen sie Engineering-Teams beim Aufbau verlässlicherer Anwendungen und unterstützen Produkt-Teams bei der schnelleren Evaluierung von Optionen.
Modellprofile vereinfachen den Vergleich von LLMs erheblich, sind jedoch nicht das einzige Entscheidungskriterium. Sie zeigen auf, was ein Modell grundsätzlich unterstützt – Leistung, Kosten und die Eignung für Ihren spezifischen Anwendungsfall müssen Sie dennoch individuell bewerten.
Beachten Sie die folgenden Einschränkungen, wenn Sie Modellprofile für Vergleiche nutzen:
Ein mehtodisches Vorgehen macht den Vergleich von LLMs deutlich effektiver. Anstatt ein Modell allein nach Popularität oder Benchmark-Ergebnissen auszuwählen, sollte die Passgenauigkeit für Ihre Anwendung im Vordergrund stehen. Die folgenden Praktiken unterstützen Sie bei der systematischen Evaluierung:
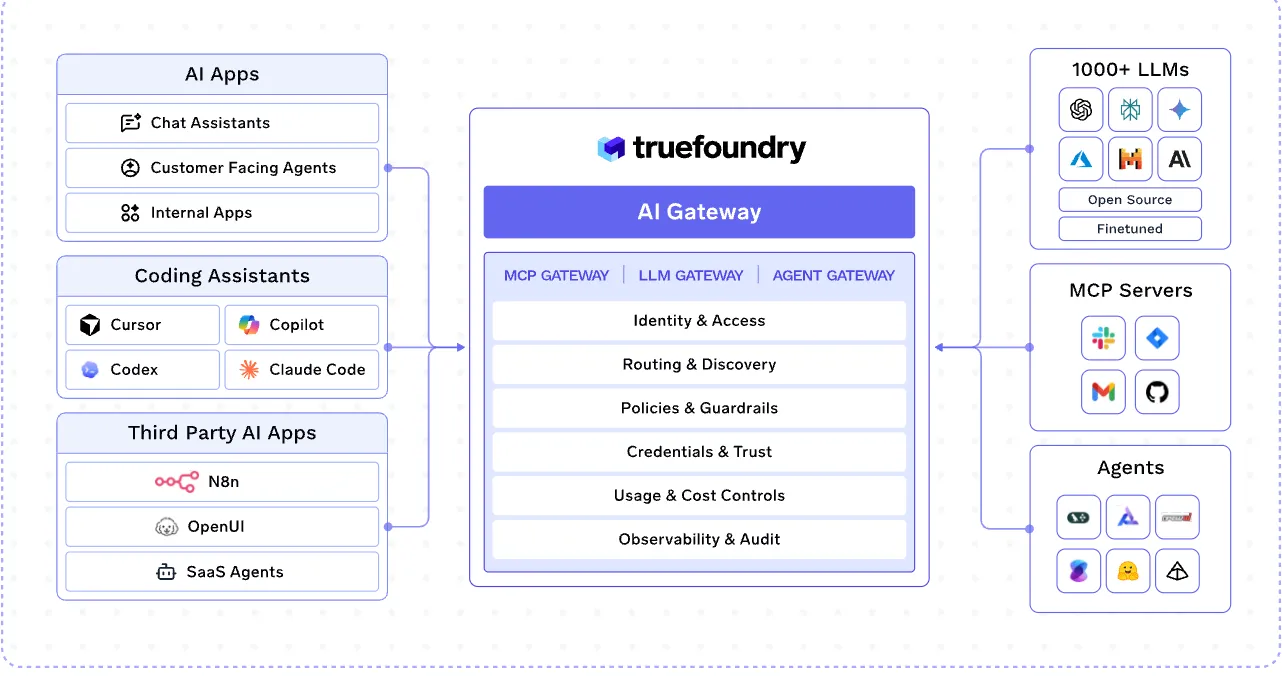
Der manuelle Vergleich von LLMs kann schnell zu einem zeitaufwendigen Unterfangen werden. Sie müssen Webseiten verschiedener Anbieter prüfen, abweichende Funktionsbeschreibungen einordnen und ein eigenes Vergleichsraster erstellen, bevor Sie eine Entscheidung treffen können.
Die Model Comparison App von TrueFoundry vereinfacht diesen Prozess, indem sie LLM-Fähigkeiten in einer einheitlichen, standardisierten Ansicht zusammenführt. Basiert auf dem TrueFoundry AI Gateway ermöglicht sie Ihnen den Vergleich von Modellen führender Anbieter wie OpenAI, Anthropic und Google bezüglich entscheidender Fähigkeiten wie Kontextfenster, Tool Calling, Vision-Unterstützung und strukturierter Ausgaben.
Mit dem Tool können Sie:
Anstatt eigene Vergleichstabellen manuell zu pflegen, nutzen Sie die Model Comparison App, um gezielt die Modelle in die engere Auswahl zu nehmen, die die benötigten Fähigkeiten Ihrer Anwendung abdecken.
Die LLM-Landschaft entwickelt sich schneller als je zuvor – und die Art und Weise, wie wir Modelle evaluieren, muss sich anpassen. Ein Modell, das für einen bestimmten Workflow hervorragend funktioniert, liefert für einen anderen möglicherweise nicht die gleichen Ergebnisse. Flexibilität und kontinuierliche Evaluierung sind daher entscheidend für den langfristigen Erfolg von KI-Projekten.
Anstatt stets dem neuesten Modell-Release hinterherzulaufen, sollten Sie den Fokus auf den Aufbau von KI-Systemen legen, die sich anpassen können, wenn neue Fähigkeiten, Anbieter und Anwendungsfälle entstehen. Die richtige Wahl des LLMs ist letztlich diejenige, die Ihre Ziele optimal unterstützt, zu Ihren betrieblichen Anforderungen passt und nachhaltig Mehrwert generiert.
Bereit, Ihre Modellauswahl einzuschränken? Nutzen Sie die Model Comparison App, um LLM-Fähigkeiten anbieterübergreifend in einer einheitlichen Übersicht zu vergleichen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




For enterprises, important LLM capabilities include reasoning, tool calling, structured outputs, security, context handling, multimodal support, scalability, and cost efficiency. These capabilities help organizations build reliable AI applications for automation, customer support, data analysis, and workflow optimization.
LLM capabilities describe what a model supports, such as tool calling, vision, structured outputs, or a particular context window. Benchmarks measure how well a model performs on specific tasks or evaluations. Teams should consider both capability support and real-world performance when comparing models.
Key LLM capabilities include text generation, reasoning, coding, summarization, translation, context understanding, vision support, audio processing, tool calling, and structured outputs. These abilities determine how effectively a model can handle different tasks across various applications.
Organizations measure LLM capabilities using benchmarks, task-specific evaluations, human feedback, accuracy tests, latency measurements, and cost analysis. Many teams also test models with real-world prompts and workflows to understand performance in their specific business scenarios.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















