


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Jedes Team, das das Model Context Protocol einführt, beginnt auf dieselbe Weise. Ein Entwickler fügt Claude Desktop einen Dateisystem-Server und einen GitHub-Server hinzu, bearbeitet eine JSON-Konfigurationsdatei, fügt ein Token ein, und es funktioniert. Dies ist der richtige Weg für den Anfang. Es ist schnell, hat keine beweglichen Teile und zeigt dem Team, was MCP tatsächlich tut, bevor sich jemand für Infrastruktur verpflichtet.
Die Frage ist nicht, ob man dort anfangen soll. Es ist die Frage, wann man aufhören sollte. Das direkte Modell hat eine Fehlerkurve, die bei kleinem Maßstab unsichtbar und bei mittlerem Maßstab brutal ist. Die meisten Teams erreichen den Knick dieser Kurve, ohne es zu merken, normalerweise an dem Punkt, an dem das zweite Team denselben Server verwenden möchte und niemand sagen kann, wer die Anmeldedaten dafür besitzt. In diesem Beitrag geht es darum, wo dieser Knick liegt, wie man ihn kommen sieht und was sich tatsächlich ändert, wenn man ein Gateway in die Mitte stellt. Wenn Sie zuerst die grundlegende Definition wünschen, erklärt was ein MCP Gateway ist die Form der Sache; hier konzentrieren wir uns auf die Entscheidung.
Wachsen Sie aus direkten MCP-Verbindungen heraus? Sehen Sie, was ein Gateway ersetzt. Buchen Sie eine Demo.
„Direkt“ bedeutet, dass jeder Client so konfiguriert ist, dass er mit jedem benötigten Server spricht. In Claude Desktop, Cursor, VS Code oder einem benutzerdefinierten Agenten ist dies eine Konfigurationsdatei pro Client, die jeden Server, seinen Transport und seine Anmeldedaten auflistet. Der Client hält die Verbindung und das Secret. Es gibt keine gemeinsame Schicht. Wenn zehn Clients denselben Server verwenden, befinden sich Adresse und Token dieses Servers an zehn Orten.
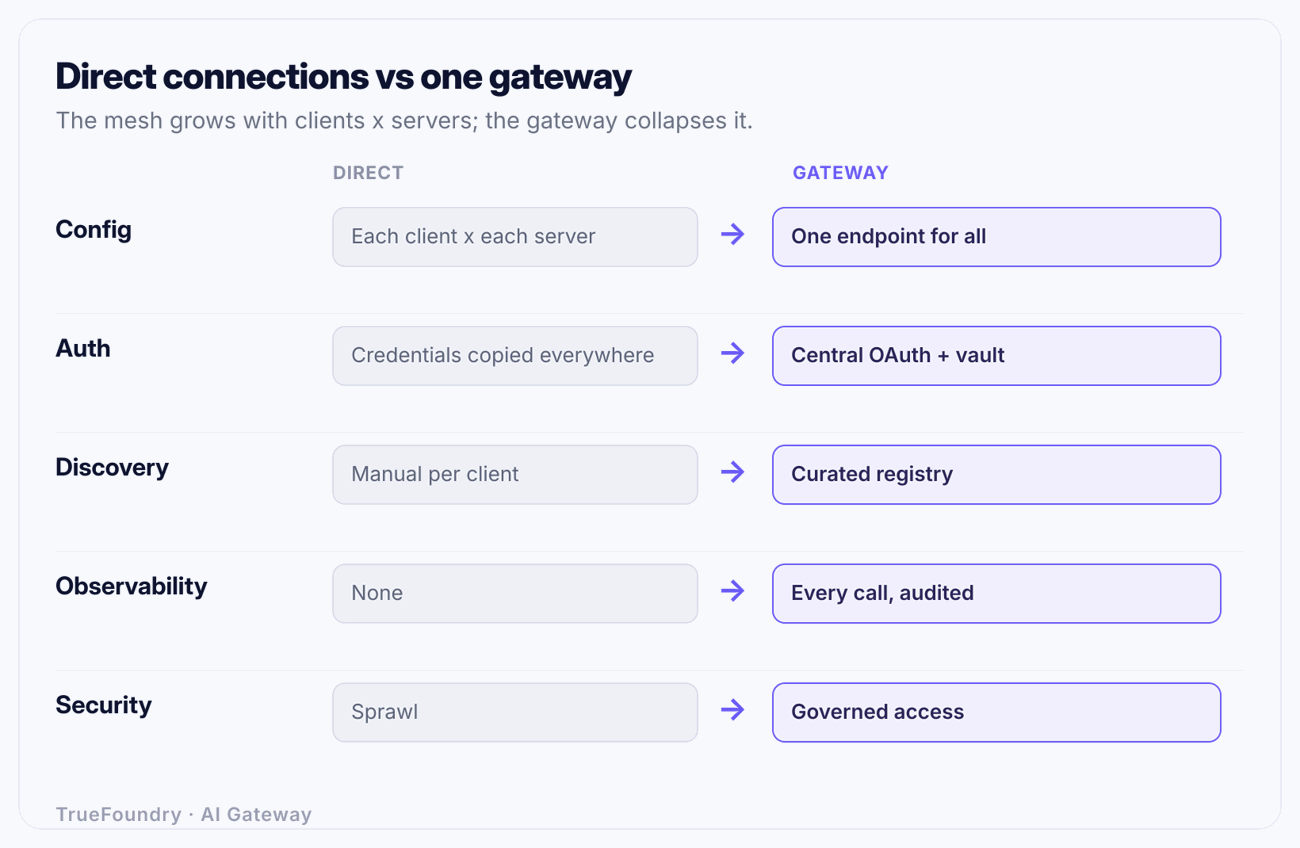
Ein Gateway bedeutet, dass jeder Client einmal konfiguriert wird, um mit dem Gateway zu sprechen. Das Gateway verwaltet das Registry der vorhandenen Server, beendet die Verbindung zu jedem Backend-Server und entscheidet pro Anfrage, ob dieser Aufrufer dieses Tool erreichen darf. Clients halten niemals Backend-Anmeldedaten; sie authentifizieren sich gegenüber dem Gateway, und das Gateway authentifiziert sich gegenüber den Servern. Die Topologie ändert sich von einem Mesh zu einem Stern.
Dieses Bild ist das gesamte Argument in einer Abbildung, aber das Bild untertreibt es, weil die Linien nicht nur Netzwerkverbindungen sind. Jede Linie im Mesh ist auch ein bereitzustellender Anmeldedatensatz, ein zu wartender Konfigurationseintrag und ein Pfad ohne Audit. Der Stern reduziert nicht nur Linien; er ändert, wer die jeweilige Verantwortung trägt.
Die Unterschiede sind nicht gleichmäßig verteilt. Einige spielen bei jedem Maßstab eine Rolle; einige greifen erst ab einem Schwellenwert. Hier ist die ehrliche Aufschlüsselung.
Lesen Sie die Zeilen „Server hinzufügen“ und „Skalierung“ zusammen, und die Dynamik wird deutlich. Im direkten Modell vervielfacht jede Wachstumseinheit die Arbeit. Im Gateway-Modell ist das Wachstum additiv, und die Kosten pro Element bleiben gleich. Das ist der Unterschied zwischen einem Modell, das skaliert, und einem, das bloß funktioniert.
Zahlen machen dies konkret. Nehmen Sie ein mittelgroßes Plattform-Team: 30 Entwickler, die jeweils eine Mischung aus Clients verwenden (einige Claude Desktop, einige Cursor, einige einen selbstgemachten Agenten), und 6 MCP-Server, die die Organisation allen zur Verfügung stellen möchte. Ein GitHub-Server, ein Jira-Server, ein interner Dokumentationsserver, ein Datenbank-Lese-Server, ein Observability-Server und ein Deployment-Server.
Direkt. Jeder Entwickler konfiguriert jeden der 6 Server in jedem Client. Ignorieren Sie die Multi-Client-Komplikation und nehmen Sie jeweils einen Client an: Das sind 30 × 6 = 180 Konfigurationseinträge, verteilt auf 30 Maschinen, manuell gepflegt. Wichtiger noch: Die drei Server, die echte Anmeldedaten benötigen – der Datenbank-Lese-Server, der Deployment-Server und der GitHub-Server – haben ihre Token jetzt auf jeweils 30 Laptops kopiert. Das sind 90 aktive Anmeldedaten-Kopien für drei sensible Systeme, die in Klartext-Konfigurationsdateien liegen, ohne zentrale Aufzeichnung darüber, welche Kopie sich wo befindet.
Führen Sie nun die Vorgänge aus, die tatsächlich vorkommen. Das Token des Datenbankservers wird rotiert: 30 Entwickler müssen jeweils eine Datei bearbeiten, und bis der letzte es tut, sind einige fehlerhaft und einige verwenden ein veraltetes Secret. Ein Entwickler verlässt das Unternehmen: Jemand muss wissen, dass sein Laptop Kopien von drei sensiblen Token enthielt, und jedes einzelne widerrufen. Es gibt jedoch keine Aufzeichnung, die das besagt, sodass es in der Praxis niemand tut, und drei Anmeldedaten das Haus verlassen. Ein siebter Server wird hinzugefügt: 30 weitere Konfigurationsbearbeitungen. Eine Sicherheitsüberprüfung fragt „wer hat am letzten Dienstag den Deployment-Server aufgerufen“: Es gibt keine Antwort, weil nichts es zentral protokolliert hat.
Gateway. Jeder Entwickler konfiguriert einen Endpunkt: das Gateway. Das sind 30 Konfigurationseinträge, und sie ändern sich fast nie, da sich das Ziel, auf das sie zeigen, nicht bewegt. Die 6 Server werden einmal im Registry des Gateways registriert. Die sensiblen Anmeldedaten befinden sich im Gateway, auf null Entwickler-Laptops. Die Token-Rotation ist eine Änderung an einem Ort. Der ausscheidende Entwickler wird aus der Zugriffskontrolle des Gateways entfernt, und jeder Pfad, den er hatte, wird in einer Aktion geschlossen – mit einem Audit-Eintrag darüber, worauf er zugegriffen hatte. Der siebte Server ist ein Registry-Eintrag und erscheint durch dynamische Discovery im Katalog für jeden, der dazu berechtigt ist. Die Sicherheitsfrage ist eine Abfrage gegen das Audit-Log.
Die Anzahl der Konfigurationen sinkt von 180 auf 30, aber das untertreibt es noch. Die Zahl, auf die es ankommt, sind die Anmeldedaten-Kopien, die von 90 auf 0 sinkt, und die Anzahl der Orte, an denen eine Änderung vorgenommen werden muss, die von „jeder betroffene Laptop“ auf „einer“ sinkt. Das direkte Modell ist nicht gescheitert, weil 180 eine große Zahl ist. Es ist gescheitert, weil jedes operative Ereignis – Rotation, Offboarding, Wachstum, Audit – mit dem Mesh skalierte.
Hier ist der Teil, den die meisten Gateway-Anbieter überspringen. Für eine große und legitime Reihe von Situationen sollten Sie kein Gateway betreiben, und die Installation eines solchen wäre reiner Overhead.
Betreiben Sie Server direkt, wenn alle folgenden Punkte zutreffen: Ein Entwickler oder ein paar, die keine Server teilen. Ein oder zwei Server. Lokale Server, die auf derselben Maschine wie der Client über stdio laufen, keine Remote-Server, die über das Netzwerk erreicht werden. Keine gemeinsam genutzten Anmeldedaten, da jeder seine eigenen verwendet. Keine Compliance- oder Audit-Anforderung, da es sich um Experimente oder persönliche Werkzeuge handelt. Dies ist der Laptop-Fall, und für den Laptop-Fall fügt ein Gateway einen Hop, eine Abhängigkeit und etwas zu Betreibendes hinzu – im Austausch für die Lösung von Problemen, die Sie gar nicht haben.
Das klarste Indiz ist der Transport. Ein Server, der lokal über stdio läuft und von der einen Person besessen wird, die ihn nutzt, ist ein Prozess auf Ihrer Maschine; ihn in ein Gateway zu hüllen ist wie das Setzen eines Load Balancers vor ein Skript. In dem Moment, in dem ein Server remote ist und über Streamable HTTP von mehr als einem Client erreicht wird, kehrt sich die Rechnung um. Denn jetzt gibt es Anmeldedaten, die reisen, eine Verbindung, die sich viele Clients teilen, und die Frage, wer sie nutzen darf – genau die Reihe von Problemen, für deren Lösung ein Gateway existiert. Die Diskussion zur MCP-Server-Hostung geht tiefer auf die Grenze zwischen lokal und remote ein und warum sie die eigentliche architektonische Weiche ist.
Wenn Sie einen einzelnen Ablauf wünschen, ist es dieser. Gehen Sie die Fragen in Reihenfolge durch; halten Sie beim ersten starken Signal an.

Der Baum kodiert eine einfache Idee: Das Gateway verdient seinen Platz in dem Moment, in dem ein Belang gemeinsam genutzt wird. Gemeinsam genutzt über Clients hinweg, gemeinsam genutzt über Personen hinweg, gemeinsam genutzt über das Netzwerk hinweg oder gemeinsam genutzt mit einem Auditor. Solange alles privat für einen Entwickler auf einer Maschine ist, gewinnt direkt. In dem Moment, in dem etwas gemeinsam genutzt wird, muss das Element, das Verteilung, Auth, Zugriff, Discovery und Audit verwaltet, irgendwo zentral leben – und dieses „irgendwo“ ist das Gateway.
Hier ist dieselbe Logik als Checkliste, die Sie auswerten können. Zählen Sie Ihre „Ja“-Antworten.
Null oder ein „Ja“ und Sie befinden sich bequem im Bereich direkter Verbindungen; genießen Sie die Einfachheit. Zwei oder drei und Sie befinden sich am Knick der Kurve, wo sich ein Gateway gleich auszahlen wird. Vier oder mehr und Sie zahlen bereits die Kosten, keines zu haben – in Anmeldedaten-Wildwuchs und unbeantwortbaren Audit-Fragen, ob es nun auf einem Dashboard erscheint oder nicht.

Sehen Sie, wie TrueFoundry N-mal-M MCP-Verbindungen in einem gesteuerten Endpunkt zusammenführt. Buchen Sie eine Demo.
Es lohnt sich, präzise zu sein, was in die Mitte verlagert wird, da „ein Gateway“ wie ein vager Proxy klingen kann. Vier konkrete Dinge verlagern sich.
Identität und Auth. Das Gateway beendet OAuth zu den Backend-Servern und verarbeitet sowohl zweibeinige (Service-zu-Service) als auch dreibeinige (im Namen eines Benutzers) Abläufe. Clients präsentieren dem Gateway somit eine Anmeldeinformation und halten niemals Backend-Secrets. Die Mechanik dieser Abläufe wird in MCP-Authentifizierung behandelt; der Punkt hier ist, dass sie einmal am Engpass geschehen, anstatt pro Client neu implementiert oder kopiert zu werden.
Das Registry. Anstatt dass jeder Client eine Liste von Servern fest codiert, verwaltet das Gateway ein kuratiertes Registry der vorhandenen Server, und Clients entdecken Tools dynamisch daraus. Das Hinzufügen oder Veraltenlassen eines Servers ist ein Registry-Vorgang, keine flottenweite Bearbeitung. Wenn das Registry-Konzept neu für Sie ist, erklärt was ein MCP Registry ist das Modell.
Zugriffskontrolle und Guardrails. RBAC entscheidet, welche Benutzer oder Teams welche Server und Tools erreichen können, und Guardrails für Dinge wie PII und Prompt Injection werden einheitlich angewendet, da jede Anfrage einen einzigen Ort passiert. Im direkten Modell erzwingt jeder Server das, was er zufällig erzwingt, uneinheitlich; im Gateway-Modell wird die Richtlinie einmal geschrieben. Das breitere Steuerungmodell ist in Enterprise MCP Governance dargelegt.
Observability und Audit. Jeder Aufruf erzeugt einen Datensatz: wer, welcher Server, welches Tool, wann, mit welcher Latenz und welchem Ergebnis. Das ist die einzelne häufigste Sache, von der Teams feststellen, dass sie sie im direkten Modell nicht tun können, und die am schwersten nachzurüstende Sache, da man Aufrufe nicht protokollieren kann, die nie einen gemeinsamen Punkt passiert haben.
Sie installieren ein Gateway für ein Setup mit einem Entwickler und einem Server. Overhead ohne Ertrag. Wenn Sie unter der ersten Schwelle liegen, löst ein Gateway nichts und fügt eine Abhängigkeit hinzu. Beginnen Sie direkt, und wechseln Sie, wenn ein Signal anschlägt.
Sie bleiben direkt, bis Anmeldedaten durchsickern. Der häufigere und teurere Fehler. Das direkte Modell hat keine Offboarding-Logik. Wenn also jemand mit Token auf seinem Laptop geht oder eine Konfigurationsdatei in ein Repository committed wird, ist das erste Mal, dass jemand den Wildwuchs bemerkt, während des Vorfalls. Die 90 Anmeldedaten-Kopien waren die ganze Zeit über ein Risiko; sie wurden nur sichtbar, als eine davon missbraucht wurde.
Sie behandeln „wir haben Observability“ als abgedeckt, weil jeder Server protokolliert. Logs pro Server beantworten keine übergreifenden Fragen. „Welcher Benutzer hat diese Woche serverübergreifend das teure Tool beansprucht“ ist unbeantwortbar, wenn die Logs an sechs Orten mit sechs Schemata und ohne gemeinsame Identität liegen. Zentralisierte Observability ist etwas anderes als sechs lokale Logs.
Sie fügen das Gateway hinzu, lassen aber einen direkten Pfad offen. Wenn Clients Server weiterhin direkt erreichen können, sind die Zugriffskontrolle und das Audit des Gateways beratend, nicht erzwungen. Ein Nadelöhr steuert nur das, was gezwungen ist, hindurchzugehen. Das Schließen des direkten Pfads macht das Gateway von einer Annehmlichkeit zu einer echten Steuerung.
Sie verwechseln „zustandslosen Transport“ mit „keine Infrastruktur erforderlich“. Dass Streamable HTTP zustandslos ist, macht Server leicht zu skalieren, aber es verwaltet keine Anmeldedaten, Discovery oder Audit. Das sind genau die Aufgaben, die das Gateway übernimmt, und sie verschwinden nicht, nur weil die Leitung einfacher geworden ist.
Die Wahl zwischen einem Gateway und direkten Verbindungen ist nicht ideologisch, und es heißt nicht „Gateways sind für Unternehmen, direkt ist für Hobbyisten“. Es ist eine Funktion des Teilens. Solange ein Server privat für eine Person auf einer Maschine ist, ist die direkte Verkabelung die einfachere, bessere Antwort, und der Griff zu einem Gateway ist verfrüht. In dem Moment, in dem ein Server geteilt wird – über Clients, über Personen oder über das Netzwerk hinweg –, müssen die Anforderungen, die durch das Teilen entstehen (Auth, Zugriff, Discovery und Audit), an einem zentralen Ort leben. Und dieser zentrale Ort ist ein Gateway.
Die Falle besteht darin, dass das direkte Modell nicht ankündigt, wenn es nicht mehr funktioniert. Es funktioniert einfach weiter, während sich die Kopien der Anmeldedaten anhäufen und die Audit-Lücke größer wird – genau bis zu dem Zeitpunkt, an dem eine Rotation das halbe Team lahmlegt oder jemand das Unternehmen verlässt mit Token, die niemand nachverfolgt hat. Die vier Fragen – mehr als ein Client, gemeinsam genutzte Server, Remote-Server, jeglicher Compliance-Bedarf – zeigen Ihnen den Knick, bevor Sie ihn erreichen. Zählen Sie Ihre Ja-Antworten und handeln Sie, wenn die Zahl es vorschreibt, nicht erst nach dem Vorfall.
Wechseln Sie von verstreuten MCP-Servern zu einem einzigen Kontrollpunkt. Buchen Sie eine Demo.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





