


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Die meisten Teams stellen das Bedürfnis nach einer Evaluierungsplattform auf dieselbe Weise fest: Eine Prompt-Änderung, die im Notebook unbedenklich aussah, führt in der Produktion schleichend zu Qualitätseinbußen, ein Kunde sendet einen Screenshot einer halluzinierten Antwort, und niemand kann verlässlich sagen, ob die neue Modellversion tatsächlich besser ist als die alte oder schlicht anders. Auf die Frage „Ist diese LLM-App gut?“ gibt es solange keine Antwort, bis die Systeme zur Messung aufgebaut wurden.
Diese Systeme stellen LLM-Evaluierungsplattformen bereit. Die Kategorie ist jedoch unübersichtlich. Einige Tools stellen die Evaluierung in den Vordergrund und ergänzen Tracing. Andere konzentrieren sich primär auf Observability und fügen Evals nachträglich hinzu. Manche sind Open-Source-Bibliotheken zur Eigenverwaltung, andere verwaltete SaaS-Lösungen. Die neueste Herausforderung sind Agenten: Die Evaluierung einer einzelnen Eingabe und Fertigstellung ist ein überschaubares Problem – die Evaluierung eines zehnstufigen Agenten, der Tools aufruft, Dokumente abruft und Schleifen durchläuft, ist um ein Vielfaches komplexer.
Dieser Leitfaden deckt drei Kernbereiche ab: Er definiert den Eval-Lebenszyklus, damit Sie die tatsächlich benötigten Funktionen erkennen. Er stellt die wichtigsten Plattformen (Langfuse, Arize Phoenix, Braintrust, LangSmith, Comet Opik, Maxim, Helicone) mit ihren jeweiligen Stärken und Schwächen vor. Und er erläutert die Rolle eines AI Gateways, da dessen Traces und Kostendaten das Rohmaterial bilden, das die meisten Eval-Plattformen verarbeiten.
Sie möchten Traces pro Anfrage, Kostenanalysen und Inline-Guardrails zusammen mit Ihren Evals nutzen? Buchen Sie eine Demo.
Evaluierung ist kein isolierter Schritt vor dem Produktivstart. Sie ist ein Regelkreis aus vier Phasen, und eine ausgereifte Plattform unterstützt jede davon.
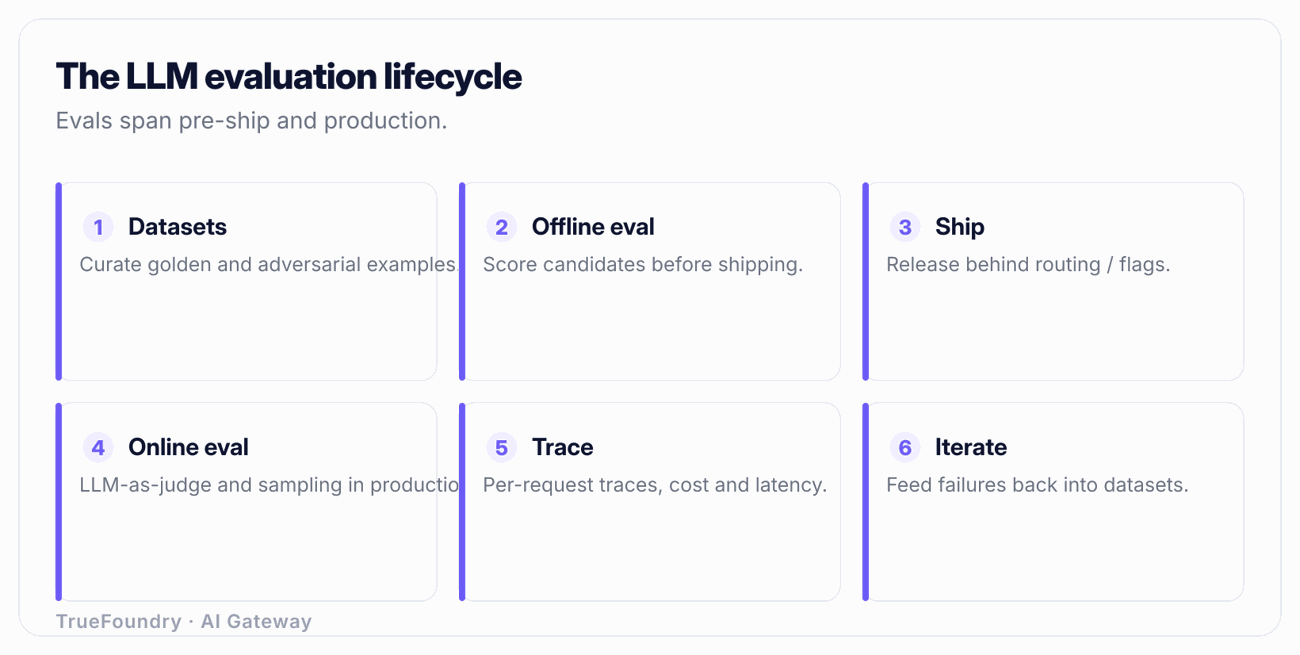
1. Datensätze. Alles beginnt mit Beispielen. Ein Datensatz ist eine Sammlung von Eingaben – optional mit erwarteten Ausgaben oder Referenzantworten –, die die Arbeitsweise Ihrer Anwendung repräsentiert. Die besten Datensätze entstehen nicht synthetisch, sondern werden aus der Produktion gewonnen: den echten Anfragen von Benutzern, insbesondere jenen mit fehlerhaftem Verlauf. Ein erfahrenes Team führt fehlerhafte oder niedrig bewertete Traces aus der Produktion fortlaufend in den Datensatz zurück, damit die Eval-Suite mit der Zeit anspruchsvoller wird, anstatt auf dem Niveau des Launches zu verharren.
2. Offline-Evaluierung. Bevor Sie Änderungen an Prompts, Modellen oder Retrieval-Verfahren freigeben, testen Sie diese am Datensatz und bewerten die Ausgaben. Die Bewertungsmethoden reichen von deterministischen Verfahren (exakte Übereinstimmung, Regex, Validität von JSON-Schemata, Ausführbarkeit von SQL) bis hin zu modellgestützten Bewertungen (LLM-as-Judge für Korrektheit, Relevanz und Tonalität). Die Offline-Eval dient als Prüfstein vor dem Merge und beantwortet die Frage: „Hat diese Änderung die Ergebnisse bei bereits bekannten Fällen verbessert oder verschlechtert?“
3. Online-Evaluierung. Offline-Datensätze decken niemals alle Szenarien der Praxis ab. Die Online-Evaluierung führt Scorings auf dem Live-Datenverkehr durch (meist stichprobenartig), um Leistungsabfälle und neue Fehlermuster zu erfassen, die im Datensatz fehlten. Hier messen Sie Parameter wie Halluzinationsraten in der Produktion, Antwortrelevanz und Guardrail-Verletzungen in realen Nutzersitzungen.
4. Tracing und Observation. Die Grundlage beider Verfahren ist das Tracing: das Erfassen jedes einzelnen Ausführungsschritts als strukturierte Spans. Bei einem einfachen Chatbot sind das die Eingabe, die generierte Antwort sowie Token-Anzahl und Latenz. Bei einem Agenten entsteht ein komplexer Baum: der Planungsschritt, jeder Tool-Aufruf samt Argumenten und Ergebnis, jeder Informationsabruf mit den zurückgelieferten Textabschnitten sowie jeder Modellaufruf mit Prompt und Ausgabe. Ohne diesen Strukturbaum lässt sich zwar die finale Antwort eines Agenten bewerten, nicht jedoch die Ursache eines Fehlers – etwa ob der Informationsabruf unvollständig war, das Tool einen Fehler ausgab oder das Modell den Kontext ignorierte.
Der Kreislauf schließt sich, wenn die Erkenntnisse aus den Phasen 3 und 4 wieder in Phase 1 einfließen. Eine gute Plattform ermöglicht dies nahtlos: Sie identifizieren einen fehlerhaften Produktions-Trace, fügen ihn dem Datensatz hinzu und führen künftige Offline-Evals dauerhaft gegen diesen Fall aus.
Die Evaluierung von Agenten bringt zwei zusätzliche Herausforderungen mit sich. Erstens: Der Ablaufpfad ist ebenso entscheidend wie das Endergebnis. Ein Agent kann über einen fehlerhaften Pfad zu einer korrekten Antwort gelangen (etwa durch drei redundante Tool-Aufrufe oder einen fehlerhaften Abruf, den das Modell nur durch Zufall ignorierte). Diese Instabilität führt später zu Problemen. Daher müssen die einzelnen Zwischenschritte bewertet werden, nicht nur das Resultat. Zweitens: Nicht-Determinismus summiert sich. Bei einem zehnstufigen Agenten mit leichten Abweichungen pro Schritt führen identische Eingaben zu stark abweichenden Durchläufen. Benötigt werden daher mehrere Durchläufe pro Fall und aggregierte Bewertungen statt einfacher Bestanden/Fehlgeschlagen-Entscheidungen.
Bei freiformulieren Ausgaben, Zusammenfassungen, Chat-Antworten oder extrahierten Feldern mit unscharfer Korrektheit stoßen reguläre Ausdrücke an ihre Grenzen. Die praxistaugliche Lösung ist ein weiteres LLM als Bewertungsinstanz: LLM-as-Judge.
Das Verfahren ist leistungsfähig, erfordert jedoch Vorkehrungen, um verlässliche Ergebnisse zu garantieren:
Jede der nachfolgend genannten Plattformen bietet LLM-as-Judge-Funktionen. Die Unterschiede liegen in der Handhabung von Kalibrierung, Rasterdefinition und Versionierung.
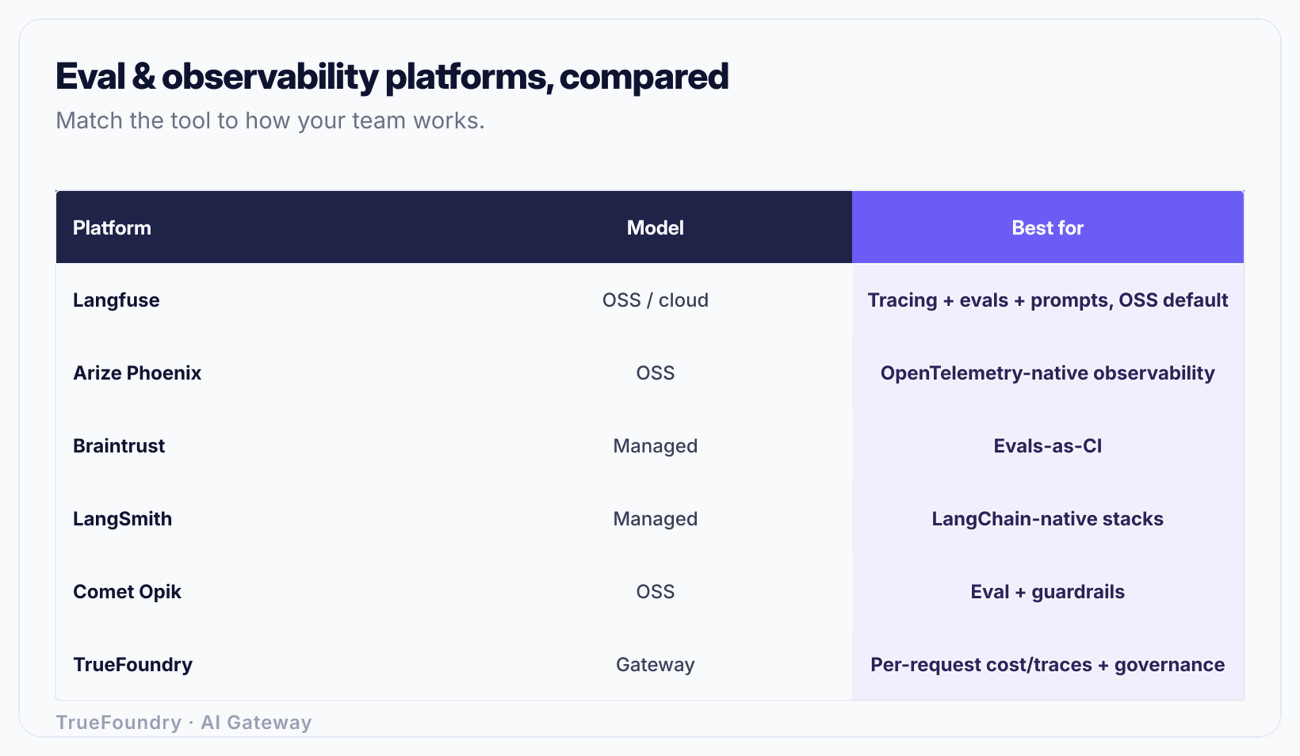
Es gibt keine Universallösung für alle Anforderungen. Nachfolgend finden Sie eine objektive Übersicht.
Langfuse. Open Source (als Self-Hosting-Variante oder Cloud-Service verfügbar) und das umfassendste OSS-Angebot am Markt. Es vereint Tracing, Evals, Prompt-Management und Datensätze in einem einzigen System. Ideal für Teams, die aus Gründen der Datenresidenz auf Self-Hosting setzen und Observability sowie Evaluierung ohne die Kombination mehrerer Einzeltools nutzen möchten. Das Tracing-Modell ist flexibel und framework-unabhängig. Wer eine Open-Source-Plattform für den gesamten Lebenszyklus sucht, findet hier meist den passenden Einstieg. Lesen Sie auch unsere Übersicht zu LLM-Observability-Tools zur Einordnung im Gesamtmarkt.
Arize Phoenix. Open Source und von Grund auf auf OpenTelemetry ausgerichtet. Phoenix nutzt die semantischen OTel-Konventionen für LLM-Spans. Dadurch fügen sich Traces nahtlos in bestehende Infrastrukturen ein, ohne an proprietäre Formate gebunden zu sein. Die Stärken liegen im Debugging von Retrieval- und RAG-Prozessen (Analyse von Embeddings und Chunks). Für Organisationen mit bestehendem OpenTelemetry-Standard ist Phoenix die naheliegende Wahl. Arize bietet zudem eine kostenpflichtige Enterprise-Plattform auf Basis des OSS-Kerns an.
Braintrust. Verwaltete Lösung mit klarem Fokus auf Evaluierung. Das Konzept versteht Evals als Teil der CI-Pipeline: Evaluierungen werden direkt in den Entwicklungszyklus integriert, sodass jede Prompt- oder Codeänderung automatisch gegen Datensätze getestet wird. Testergebnisse lassen sich analog zu Softwaretests vergleichen. Braintrust bietet eine ausgereifte Benutzeroberfläche für den direkten Vergleich von Prompt- und Modellvarianten. Optimal für Teams, deren Hauptproblem im Fehlen von Regressionstests bei häufigen Prompt-Änderungen liegt. Im Vergleich zu Langfuse ist der Funktionsumfang bezüglich Self-Hosting und vollständiger Observability geringer ausgeprägt.
LangSmith. Verwaltet, vom LangChain-Team entwickelt und tief in LangChain und LangGraph integriert. Wenn Ihr Stack bereits auf LangChain basiert, ist das Tracing nahezu kostenlos, die Instrumentierung läuft automatisch mit und die Ansichten für Agent-Trajektorien sind stark. Der Kompromiss besteht darin, dass die nahtloseste Erfahrung das LangChain-Ökosystem voraussetzt; außerhalb davon ist es zwar immer noch nutzbar, aber nicht mehr der offensichtliche Gewinner.
Comet Opik. Open Source, aus der Ahnenreihe von Comet (ML-Experiment-Tracking). Deckt Tracing, Evals und insbesondere Prüfungen im Guardrail-Stil zusammen mit Evaluierungen ab. Eine gute Wahl für Teams, die Comet bereits für klassisches ML-Experiment-Tracking nutzen und ihre LLM-Arbeit im selben Haus haben möchten, oder die ein OSS-Eval-Tool mit integrierten Moderationsprüfungen suchen.
Maxim AI. Eine Eval- und Observability-Plattform, die auch Bifrost ausliefert, ein Open-Source-AI Gateway. Das kombinierte Versprechen lautet "evaluieren, beobachten und routen bei einem Anbieter". Die Lücke, auf die Käufer stoßen, ist, dass Evals und das Gateway effektiv separate Produkte statt einer einzigen Control Plane sind, die Gateway-Preise nicht öffentlich sind (Zugang anfragen) und es sich um einen jüngeren Anbieter handelt, dessen Benchmarks größtenteils selbst ermittelt wurden. Wenn Sie speziell Maxim oder dessen Bifrost-Gateway abwägen, wiegen Sie die Eval-Tiefe und die Gateway- sowie Governance-Tiefe separat gegeneinander ab, da nur wenige Tools in beiden Bereichen erstklassig sind.
Helicone. Open Source, ausgerichtet auf Observability und Proxy. Es sitzt als leichtgewichtiger Proxy vor Ihren Modellaufrufen und erfasst Logs, Latenz und Kosten mit minimalem Integrationsaufwand (Ändern einer Base-URL). Evals sind vorhanden, aber weniger umfangreich als bei einer dedizierten Eval-Plattform. Am besten geeignet, wenn Ihre Priorität auf schneller, günstiger Observability mit geringem Setup-Aufwand liegt und Sie tiefe Evaluierung als sekundär betrachten.
Hier ist der Vergleich zusammengefasst:
Erfahren Sie, wie TrueFoundry Ihren Eval-Stack um Observability und Governance erweitert. Buchen Sie eine Demo.
Die Auswahl aus der obigen Liste kommt auf eine Handvoll Achsen an. Bewerten Sie Kandidaten anhand dieser Kriterien und nicht anhand von Marketing-Funktionslisten.
Eine konkrete Möglichkeit, das Raster zu nutzen: Wenn Ihre harte Anforderung lautet "Kundendaten dürfen unsere VPC nicht verlassen", haben Sie sich sofort auf die selbst hostbaren OSS-Optionen (Langfuse, Phoenix, Opik) oder einen Enterprise-Plan mit In-VPC-Bereitstellung verengt, und die rein verwalteten Tools fallen weg – unabhängig davon, wie gut ihre UX ist. Starten Sie bei Ihren unverzichtbaren Anforderungen und optimieren Sie dann innerhalb des verbleibenden Rahmens.
Eine Eval-Plattform benötigt Daten zur Evaluierung: Traces, Prompts, Completions, Token-Zahlen, Latenzen und Kosten pro Aufruf. Woher kommen diese? Für eine einzelne Anwendung instrumentieren Sie diese direkt. Über eine Organisation hinweg, die Dutzende von Apps und Agenten gegen viele Modellanbieter ausführt, ist die sauberere Quelle die Schicht, durch die bereits jeder Aufruf fließt: das AI Gateway.
Ein Gateway wie TrueFoundry sitzt vor dem gesamten Modell- und Anbieter-Traffic hinter einer einheitlichen, OpenAI-kompatiblen API. Da jeder Request es passiert, gibt es Observability pro Request aus: Tokens in und out, Latenz, das verwendete Modell und der Anbieter sowie Kosten, alle getaggt nach Benutzer, Team und Anwendung. Das ist genau der Stream, den eine Eval-Plattform erfassen möchte, und er kommt ohne ständige Instrumentierung pro App an, weil das Gateway ihn zentral erzeugt.
Das Gateway führt auch Guardrails inline zur Aufrufzeit aus – PII-Erkennung, Prompt-Injection-Prüfungen, Secret-Scanning – was eine andere Aufgabe als die Offline-Evaluierung ist. Guardrails blockieren oder markieren eine schlechte Anfrage oder Antwort während sie passiert; Evals bewerten die Qualität im Nachhinein anhand von Datasets und Produktionsstichproben. Sie benötigen beides. Das Guardrail stoppt den offensichtlichen Schaden im Request-Pfad; die Eval-Plattform zeigt Ihnen, ob die Antwortqualität über Wochen hinweg steigt oder fällt.
Die Arbeitsteilung ist sauber: Das Gateway besitzt den Request-Pfad (Routing, Fallback, Caching, Budgets, Inline-Guardrails und Trace-Emittierung); die Eval-Plattform besitzt die Messschleife (Datasets, Offline- und Online-Scoring, LLM-as-a-Judge, Experimentvergleich). TrueFoundry stellt die Gateway-Seite und den Observability-Feed bereit; eine dedizierte Eval-Plattform aus der obigen Liste verarbeitet diesen. Für Teams, die Kosten und Governance über viele Modelle hinweg standardisieren, ist die Kombination beider Werkzeuge besser, als zu versuchen, eines der Tools für die Aufgabe des anderen zu erzwingen. Unser Leitfaden zu den besten AI Observability-Plattformen für LLMs im Jahr 2026 geht speziell auf die Observability-Hälfte näher ein.
LLM-as-a-Judge als absolute Wahrheit behandeln. Der Judge ist ein Modell mit seinen eigenen Verzerrungen und Fehlermustern. Teams, die einen Judge einsetzen, ohne ihn anhand menschlicher Labels zu kalibrieren, optimieren am Ende ihre App darauf, einen falsch kalibrierten Beworter zufriedenzustellen – was schlimmer ist als gar keine Eval, weil es sich streng anfühlt, obwohl es falsch ist. Messen Sie immer zuerst die Übereinstimmung zwischen Judge und Mensch.
Nur die finale Antwort eines Agenten evaluieren. Eine korrekte Antwort aus einer fehlerhaften Trajektorie ist ein verdeckter Bug. Wenn Sie die Zwischenschritte nie bewerten, werden Sie nicht bemerken, dass Ihr Agent die richtige Antwort über drei verschwenderische Tool-Aufrufe und ein ignoriertes Retrieval erreicht – bis eine kleine Änderung ihn zum Scheitern bringt und Sie keine Ahnung haben, warum.
Das Dataset beim Launch einfrieren. Ein statisches Eval-Set misst für immer den Schwierigkeitsgrad des Launch-Tages, während die Produktion darunter drifted. Ohne eine Schleife, die fehlerhafte Produktionstraces kontinuierlich zurück in das Dataset zieht, verliert Ihr grünes Eval-Dashboard langsam jegliche Bedeutung.
Ein Eval-Tool für ein Problem kaufen, das ein Guardrail lösen sollte. Wenn Ihr tatsächlicher Bedarf lautet "PII und Prompt-Injection im Request-Pfad blockieren", dann sind das Inline-Guardrails am Gateway und keine Offline-Eval-Suite. Umgekehrt ist das Ausführen von Offline-Datasets zum Erfassen von Echtzeitangriffen zu langsam. Stimmen Sie das Tool darauf ab, ob die Prüfung im Pfad oder im Nachhinein erfolgt.
Datenresidenz bis zur Beschaffung ignorieren. Teams wählen ein Managed-Eval-Tool basierend auf der UX aus und stellen dann im Security-Review fest, dass Produktions-Prompts mit Kundendaten die VPC nicht verlassen dürfen. Entscheiden Sie die Frage OSS vs. Managed und die Bereitstellung zuerst; sie eliminiert Optionen schneller als jedes Feature.
Evaluierung ist die Disziplin, die "die KI fühlt sich jetzt besser an" in eine Zahl verwandelt, die Sie verteidigen können. Die Plattformen unterscheiden sich weniger darin, ob sie Evals durchführen – das tun sie alle –, sondern darin, wie sie den gesamten Lebenszyklus handhaben: Dataset-Kuratierung, Offline-Gating, Online-Überwachung, Agent-Trajektorien-Tracing und kalibriertes LLM-as-a-Judge. Starten Sie bei Ihren harten Anforderungen (Datenresidenz, bestehendes Framework, OSS vs. Managed), bewerten Sie die engere Auswahl anhand des Auswahlrasters und bestehen Sie auf der vollständigen Schleife anstelle eines einmaligen Testaufbaus.
Und denken Sie daran, dass Evaluation nicht isoliert stattfindet. Das Gateway vor Ihren Modellen liefert bereits die Traces und Kosten-Daten, die Ihre Eval-Plattform benötigt, und setzt Guardrails im Request-Pfad durch, die offline Evals nicht bieten können. Kombinieren Sie eine starke Eval-Plattform mit einem Gateway, das Ihnen eine saubere Observability pro Request sowie Inline-Controls bietet – so erhalten Sie sowohl das Echtzeit-Sicherheitsnetz als auch das langfristige Qualitätssignal, um ein LLM-Produkt verlässlich zu halten.
Kombinieren Sie Ihre Evals mit einem governed Gateway. Buchen Sie eine Demo.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





