


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Die meisten Teams, die ein AI Gateway evaluieren, beginnen mit derselben Sorge: „Wenn ich vor jeden Modellaufruf einen Proxy schalte, füge ich einen Hop hinzu, und dieser Hop kostet Latenz.“ Das ist ein verständlicher Reflex, aber ein schlechter Grund, auf das Gateway zu verzichten. Der Reflex täuscht sich in der Größenordnung. Ein Modellaufruf zu einem modernen Frontier-LLM dauert zwischen 300 Millisekunden für eine kurze Vervollständigung und 20 Sekunden oder mehr für eine lange Reasoning-Antwort. Ein kompetent gebautes Gateway fügt darüber hinaus nur wenige Millisekunden an eigener Verarbeitungszeit hinzu. Die Frage ist nie, „ob das Gateway Latenz hinzufügt“ (das tut es, allerdings in vernachlässigbarem Maße), sondern „kann ich den Overhead präzise messen, und bleibt er auch bei Ausreißern (Tail-Latenz) und unter Last gering.“
Das Problem ist, dass fast niemand dies korrekt benchmarkt. Teams führen eine Schleife von 100 Anfragen über das Gateway aus, schauen sich die durchschnittliche Gesamtlaufzeit an, vergleichen sie mit 100 direkten Aufrufen und ziehen daraus Schlüsse über die „Performance“, die in Wirklichkeit von Anbieterschwankungen und Netzwerk-Jitter dominiert wird. Das Signal, auf das es ihnen ankommt – der eigene Beitrag des Gateways – geht in den Sekunden der Modellzeit unter und wird nie isoliert.
Dieser Beitrag bietet eine anbieterneutrale Methode zur ordnungsgemäßen Benchmarking eines AI Gateways: welche Metriken wichtig sind, wie man den Gateway-Overhead von der Anbieter-Latenz isoliert, wie man die Tail-Latenz und das Verhalten unter Last testet, wie man mit Streaming und Caching umgeht und wie „gut“ aussieht. Jedes numerische Beispiel hier ist eine veranschaulichende Vorlage, kein gemessenes Ergebnis. Sie sollten die Tabellen mit Zahlen aus Ihren eigenen Testläufen füllen.
Möchten Sie den tatsächlichen Gateway-Overhead mit Ihrem eigenen Datenverkehr messen? Buchen Sie eine Demo.
Ein AI Gateway befindet sich im Anfragepfad zwischen Ihrer Anwendung und einem oder mehreren Modell-Anbietern. Im Fall von TrueFoundry handelt es sich um eine einheitliche, OpenAI-kompatible API, die Routing, Fallback und Retries, exaktes und semantisches Caching, Budgets und Rate Limits, Guardrails sowie Observability pro Anfrage übernimmt. Jede dieser Funktionen erfordert Rechenzeit, und Rechenzeit kostet Zeit. Benchmarking ist die Disziplin, Zeit der richtigen Stelle zuzuordnen.
Eine einzelne, nicht gestreamte Anfrage hat ein Latenz-Budget, das wie folgt aussieht:
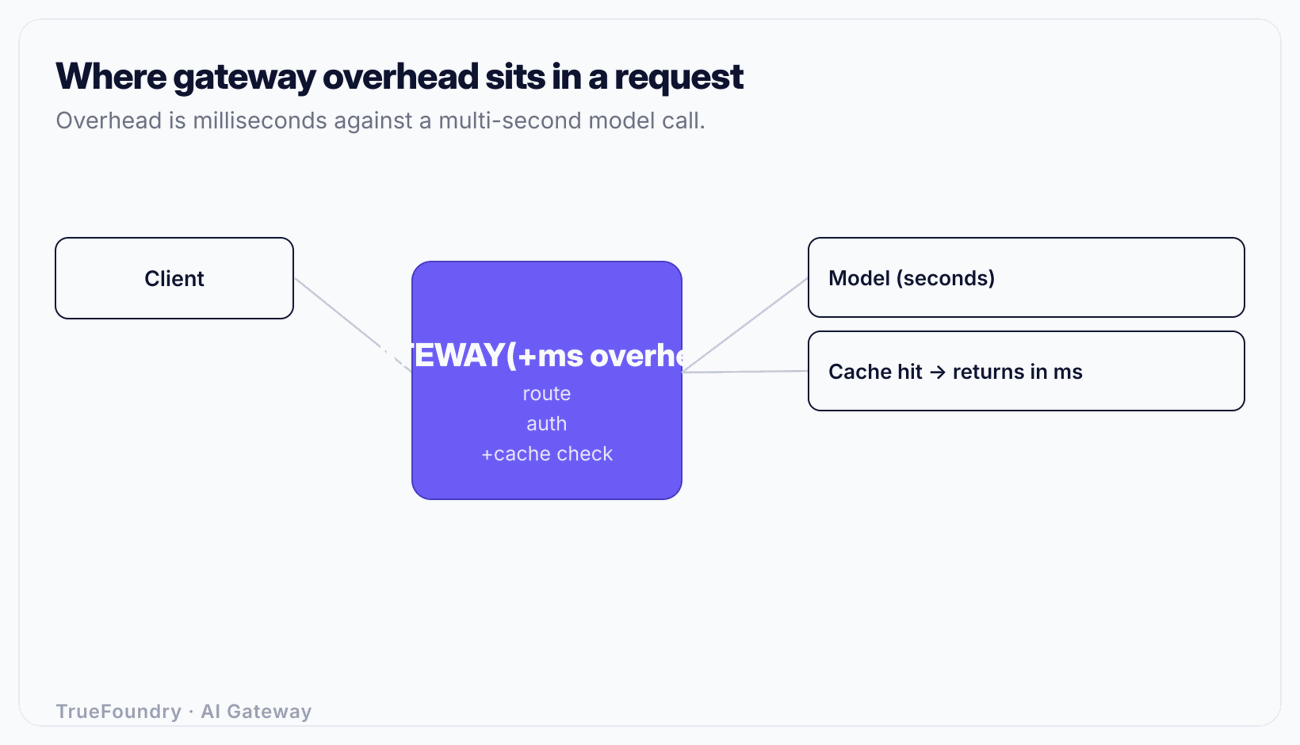
Unterteilen Sie die Gesamtlaufzeit einer Anfrage in vier Teile:
Die wichtigste Benchmark-Metrik ist die zusätzliche Latenz (Added Latency): (2) plus (4), isoliert von (1) und (3). Wenn Ihr Tool nur die End-to-End-Zeit anzeigt, messen Sie den Anbieter, nicht das Gateway.
Sechs Zahlen beschreiben die Performance eines Gateways. Erfassen Sie alle sechs; ein einzelner Durchschnittswert ist kein Benchmark.
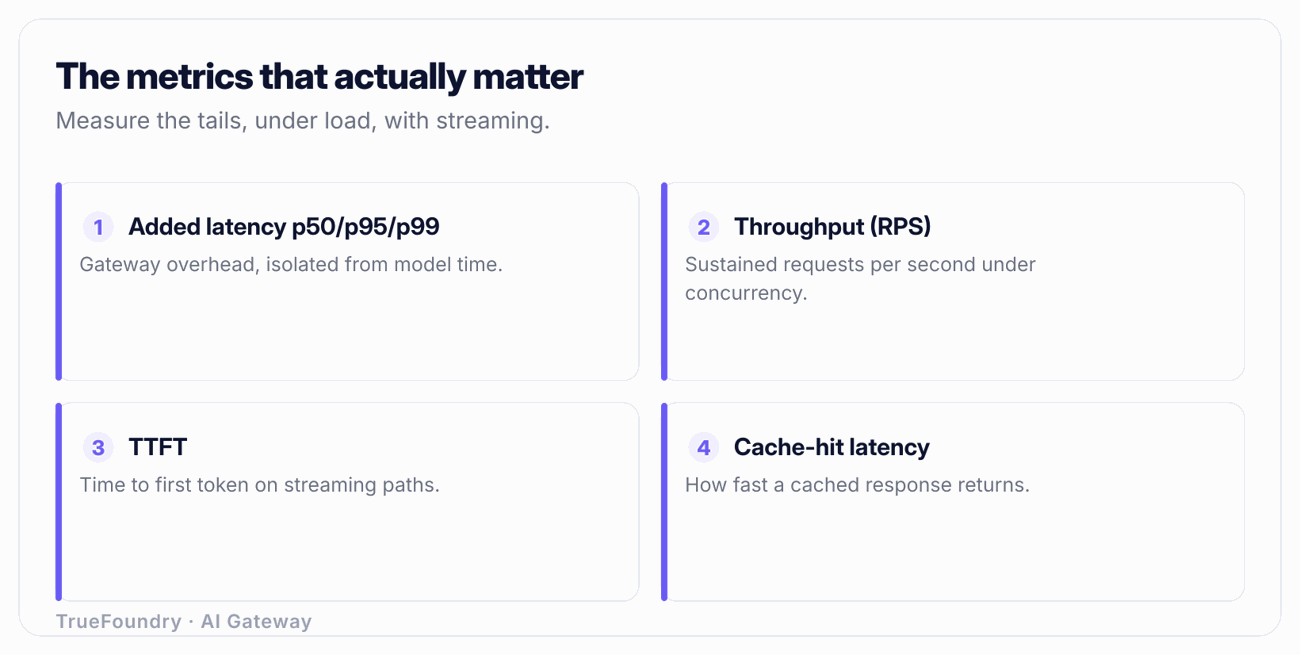
Die beiden Tail-Metriken verdienen besondere Aufmerksamkeit. Bei einer Agenten-Workload kann sich eine einzelne Benutzeraktion in 10 bis 50 Modellaufrufe innerhalb einer Reasoning-Schleife auffächern. Wenn jeder Aufruf eine Chance von 1 zu 100 hat, auf einen langsamen p99-Pfad zu treffen, trifft eine Schleife mit 30 Aufrufen diesen Pfad etwa bei jeder dritten oder vierten Benutzeraktion. Die Tail-Latenz ist bei Agenten-Skalierung kein Randfall, sondern der Normalfall.
Der methodische Kernschritt ist die Subtraktion. Die Falle besteht darin, dass die Latenz des Anbieters schwankt; eine naive Subtraktion führt daher zu einem schwankenden Overhead-Wert.
Option A: Paarweise Anfragen. Senden Sie für jeden Testdurchlauf dieselbe Anfrage direkt an den Anbieter und über das Gateway, zeitlich so nah wie möglich beieinander, idealerweise verschachtelt. Ziehen Sie die Direktzeit paarweise von der Gateway-Zeit ab. Die Paarbildung gleicht Schwankungen der Anbieterlast während des Tests aus, da beide Hälften eines Paares ungefähr dieselben Anbieterbedingungen vorfinden. Sammeln Sie Tausende von Paaren und ermitteln Sie dann die Perzentile der Differenz. Dies misst die tatsächliche zusätzliche Latenz einschließlich des Upstream-Aufrufs des Gateways, reagiert jedoch empfindlich auf Jitter des Anbieters zwischen den beiden Hälften des Paares.
Option B: Gateway-interne Zeitmessung. Ein gutes Gateway zeichnet seine eigene Verarbeitungszeit pro Anfrage auf – das Intervall zwischen der Annahme der Anfrage und dem Absenden des Upstream-Aufrufs sowie die arbeitsschritte auf der Antwortseite. Die Observability pro Anfrage von TrueFoundry legt die Latenz aufgeschlüsselt nach Benutzer, Team und Modell offen. Dies liefert Ihnen den Overhead direkt, ohne Subtraktion und ohne Rauschen des Anbieters. Es ist die Zahl, der Sie vertrauen können, wenn sie verfügbar ist. Validieren Sie sie einmalig gegen paarweise Anfragemessungen und verlassen Sie sich dann für das laufende Monitoring auf die interne Metrik.
Option C: Mocken des Anbieters. Richten Sie das Gateway auf einen lokalen Stub aus, der eine vordefinierte Antwort mit einer festen, bekannten Verzögerung (z. B. 200 ms) zurückgibt. Nun ist die Anbieterzeit eine von Ihnen gewählte Konstante, und alles darüber hinaus ist Gateway-Overhead plus Netzwerk. Dies ist der sauberste Weg, die eigenen Codepfade des Gateways bei hohen RPS zu belasten, ohne für einen echten Anbieter zu bezahlen oder von diesem über Rate Limits gedrosselt zu werden – und es ist das richtige Werkzeug, um den Durchsatz-Knickpunkt zu finden. Es bildet das reale Verhalten des Anbieters nicht ab, nutzen Sie es daher für Overhead und Durchsatz, nicht für End-to-End-Realismus.
Nutzen Sie alle drei Optionen. Option C findet die Durchsatzobergrenze, Option A validiert die zusätzliche Latenz unter realen Bedingungen, und Option B liefert Ihnen die Zahl, die Sie im Produktionsbetrieb überwachen werden. Weitere Informationen darüber, wo das Gateway im Vergleich zu Ihrer Anwendung positioniert ist und warum diese Platzierung die Latenz bestimmt, finden Sie unter Control Plane vs. Data Plane und im breiteren Kontext in So wählen Sie ein AI Gateway aus.
Ein Benchmark-Lauf bei einer Nebenläufigkeit von 1 zeigt Ihnen das Minimum, sagt aber nichts über die Produktion aus. Reale Gateways bedienen Hunderte oder Tausende gleichzeitig laufende Anfragen. Das interessante Verhalten zeigt sich darin, wie sich der Overhead verschlechtert, wenn die Nebenläufigkeit steigt.
Gestalten Sie den Lasttest als Stufentest (Ramp). Beginnen Sie bei niedriger Nebenläufigkeit, halten Sie das Niveau, erhöhen Sie es, halten Sie es erneut und steigern Sie es weiter, bis die zusätzliche p95-Latenz Ihren Schwellenwert überschreitet. Erfassen Sie bei jedem Schritt die zusätzliche Latenz für p50, p95, p99 und die erreichten RPS. Das Ergebnis ist eine Kurve, kein einzelner Punkt. Drei Verläufe treten häufig auf:
Zwei Details bei der Lasterzeugung verändern die Zahlen stärker als meist erwartet. Nutzen Sie erstens ein Open-Loop-Lastmodell, bei dem Anfragen nach einem festen Zeitplan eintreffen, unabhängig davon, ob vorherige abgeschlossen wurden. Nutzen Sie kein Closed-Loop-Modell, bei dem ein fester Pool von Workern auf jede Antwort wartet. Closed-Loop-Tests verbergen Staus in der Warteschlange, da langsame Antworten die angebotene Last drosseln, was Ihre Tail-Zahlen schönfärbt. Generieren Sie zweitens Last aus ausreichend vielen Client-Verbindungen, damit der Client nicht selbst zum Engpass wird; ein einzelner Client-Prozess mit einem kleinen Verbindungspool meldet eine „Gateway“-Latenz, die in Wirklichkeit eine clientseitige Warteschlange ist.
Bei Chat- und Agenten-Workloads werden die meisten Antworten gestreamt. Streaming kehrt um, welche Metrik wichtig ist: Der Benutzer nimmt die Time to First Token wahr, während die Gesamtzeit für die gefühlte Geschwindigkeit fast irrelevant ist.
Ein korrekt gebautes Gateway leitet gestreamte Chunks weiter, sobald sie eintreffen, und fügt nur einen kleinen, konstanten Overhead pro Chunk hinzu. Ein schlecht gebautes Gateway puffert die gesamte Upstream-Antwort, wendet die Antwortverarbeitung an und beginnt erst dann mit dem Streaming an den Client. Dies verwandelt eine gestreamte 3-Sekunden-Antwort in eine 3-sekündige Wartezeit, gefolgt von einer schlagartigen Ausgabe. Der TTFT-Benchmark deckt dies sofort auf: Messen Sie das Intervall vom Absenden der Anfrage bis zum Empfang des ersten Bytes des ersten Inhalts-Chunks, sowohl über das Gateway als auch direkt. Der TTFT-Overhead des Gateways sollte nahe an seinem Nicht-Streaming-Overhead liegen – wenige Millisekunden, nicht Hunderte.
Response-Guardrails verkomplizieren dies jedoch. Wenn Sie eine Output-Guardrail ausführen, die die vollständige Antwort prüfen muss (bestimmte PII- oder Richtlinien-Prüfungen), können Sie den vollständigen Text nicht gleichzeitig optimistisch streamen und scannen, ohne eine Architekturentscheidung zu treffen: optimistisch streamen und ggf. zurückziehen, oder puffern und verzögern. Benchmarken Sie beide Modi, wenn Sie Output-Guardrails nutzen, und geben Sie die TTFT-Kosten für jeden Modus an. Lassen Sie sich von einem Anbieter keine Streaming-TTFT nennen, die bei deaktivierten Guardrails gemessen wurde, wenn Sie diese in der Produktion aktivieren.
Erfahren Sie, wie TrueFoundry die zusätzliche Latenz im einstelligen Millisekundenbereich hält. Buchen Sie eine Demo.
Sie müssen ein Gateway nicht nach seiner Implementierungssprache auswählen, aber Sie sollten verstehen, wie Sprache und Architektur die Durchsatzkurve prägen. Das zeigt Ihnen, worauf Sie beim Stresstest achten müssen.
Ein Gateway, das auf einer einzelprozessbasierten Ereignisschleife (Single-Threaded Event Loop) basiert, bewältigt eine enorme Nebenläufigkeit bei I/O-gebundenen Aufgaben (Warten auf den Anbieter), serialisiert jedoch jede CPU-gebundene Arbeit im kritischen Pfad. Wenn das Parsen von Anfragen, das Zählen von Token oder Regex-Prüfungen von Guardrails inline ausgeführt werden, konkurrieren diese Schritte um den einen Thread und zeigen sich unter Last als steigende p99-Latenz. Eine Laufzeitumgebung mit einem Global Interpreter Lock (GIL) hat eine ähnliche Einschränkung: Selbst mit einem Thread-Pool laufen CPU-gebundene Abschnitte innerhalb eines Prozesses nicht echt parallel. Sie skalieren daher, indem Sie mehr Prozesse ausführen, und Ihr Benchmark muss den Speicherbedarf und die Duplizierung von Verbindungspools pro Prozess berücksichtigen. Kompilierte, multi-threaded Laufzeitumgebungen (Go, Rust) parallelisieren CPU-Arbeiten über mehrere Kerne hinweg innerhalb eines Prozesses. Dies verschiebt den Knickpunkt des Durchsatzes pro Instanz meist nach oben – auf Kosten eines anderen betrieblichen Profils.
Die praktische Erkenntnis lautet nicht „Go ist besser als Python“. Sie lautet: Identifizieren Sie, was im kritischen Pfad läuft, und benchmarken Sie es unter Nebenläufigkeit. Das Zählen von Token bei einem Kontext von 100.000 Token, das Ausführen eines Prompt-Injection-Klassifizierers oder das Berechnen eines Embeddings für semantisches Caching sind allesamt CPU-Arbeiten. Wenn sie inline laufen, werden sie Ihre Tail-Kurve verändern. Wenn sie außerhalb des kritischen Pfads oder hinter einem Fast-Path laufen, tun sie das nicht. Testen Sie mit repräsentativen Prompt-Größen, nicht mit 10-Token-Beispielen, da die Kontextlänge die CPU-Kosten genau dieser Schritte bestimmt. Die Aufgabe des Gateways als LLM-Proxy besteht darin, diese Arbeit pro Anfrage klein und vorhersehbar zu halten.
Das eine Szenario, das die gesamte Diskussion über „Gateways fügen Latenz hinzu“ auf den Kopf stellt, ist das Caching – und es ist das Szenario, das Teams beim Benchmarken am häufigsten vergessen.
TrueFoundry unterstützt sowohl exaktes Caching (identische Anfrage gibt die gespeicherte Antwort zurück) als auch semantisches Caching (eine Anfrage, deren Embedding innerhalb eines Cosinus-Ähnlichkeitsschwellenwerts zu einer vorherigen Anfrage liegt, gibt diese Antwort zurück). Bei einem Treffer findet der Modellaufruf überhaupt nicht statt. Die Latenz der Anfrage reduziert sich von den Hunderte von Millisekunden bis Sekunden des Modells auf die reine Suchzeit des Gateways: die Embedding-Berechnung (bei semantischem Caching) plus eine Vektor- oder Schlüssel-Suche – typischerweise im einstelligen bis niedrigen zweistelligen Millisekundenbereich.
Benchmarken Sie dies als eigenes Szenario:
Ein Rechenbeispiel (nur zur Veranschaulichung): Nehmen wir an, ein direkter Modellaufruf für Ihre Workload dauert 1.200 ms bei p50. Ein exakter Cache-Treffer antwortet vielleicht in 6 ms, und ein semantischer Treffer in 22 ms (dominiert vom Embedding-Schritt). Bei einer Trefferquote von 40 Prozent liegt der gewichtete p50-Wert bei etwa 0,6 × 1.200 + 0,4 × 15 ≈ 726 ms – eine Reduzierung der typischen Latenz um 40 Prozent und eine Reduzierung der Token-Kosten um 40 Prozent, beides erzielt durch das Gateway. Als End-to-End-Durchschnitt betrachtet, wirkt das Gateway drastisch schneller als direkte Aufrufe. Deshalb ist die Aussage „das Gateway fügt Latenz hinzu“ die falsche Herangehensweise: Bei gecachtem Datenverkehr spart es Latenz ein. Fügen Sie Ihre eigenen Zahlen ein; die Struktur bleibt unabhängig von den spezifischen Werten gültig.
Gehen Sie diese Liste durch, bevor Sie Latenzbehauptungen zu einem Gateway vertrauen – einschließlich Ihren eigenen.
Die folgende Tabelle ist eine Vorlage, die Sie mit Ihren eigenen Testläufen füllen können. Die Zahlen sind Platzhalter, die den erwarteten Verlauf und die Größenordnung zeigen, und keine gemessenen Ergebnisse eines bestimmten Produkts. Ersetzen Sie jede Zelle mit Werten, die Sie mit Ihren Modellen, Regionen und Ihrem Datenverkehr gemessen haben.
Eine einzelne Zeile für sich genommen ist nicht aussagekräftig. Der Wert liegt im Vergleich: Cache-Hit versus Miss, Streaming versus Nicht-Streaming, geringe Last versus Knickpunkt.
Es wird die End-to-End-Latenz gemessen und als Gateway-Performance bezeichnet. Das Modell dominiert die Gesamtlaufzeit, sodass der „Benchmark“ hauptsächlich den Anbieter und das Netzwerk misst. Isolieren Sie den Overhead, andernfalls haben Sie nichts über das Gateway gemessen.
Es wird der Mittelwert gemessen und darauf aufgebaut. Der p50-Wert sieht hervorragend aus, aber die p99-Latenz führt in der Produktion zu Timeouts in Ihren Agenten-Schleifen. Bei der Skalierung von Agenten ist die Tail-Latenz entscheidend für die Nutzererfahrung. Weisen Sie immer p95 und p99 aus.
Es wird bei einer Nebenläufigkeit von 1 getestet. Der Overhead bei einer einzelnen aktiven Anfrage sagt nichts über das Verhalten bei 500 Anfragen aus. Der Verlauf der Leistungsabnahme und der Knickpunkt darin sind das Wesentliche. Erhöhen Sie die Last im Test.
Das Caching wird beim Benchmarken vergessen. Caching ist die eine Funktion, die das Gateway schneller macht als direkte Aufrufe – und es ist das Szenario, das am häufigsten übersprungen wird. Messen Sie die Hit-Latenz und die gewichtete Latenz bei Ihrer tatsächlichen Trefferquote. Andernfalls unterschätzen Sie den Wert des Gateways um den gesamten Caching-Vorteil.
Einer Anbietezahl wird vertraut, ohne sie zu reproduzieren. Eine Latenzzahl in einer Präsentation wurde mit dem Modell, der Region, der Prompt-Größe und der Guardrail-Konfiguration eines anderen gemessen. Bis Sie sie mit Ihrem eigenen Datenverkehr reproduzieren, ist sie reines Marketing. Gehen Sie die Checkliste selbst durch.
Die Sorge, dass ein AI Gateway unakzeptable Latenzen hinzufügt, hält sich hartnäckig, weil Teams das Falsche messen. Die End-to-End-Gesamtlaufzeit wird vom Modell dominiert und sagt daher fast nichts über das Gateway aus. Wenn Sie den Overhead isolieren und die Ausreißer (Tail-Latenz) betrachten, dreht sich das Bild um: Ein kompetentes Gateway fügt einer Anfrage, die ohnehin Sekunden dauert, nur wenige Millisekunden hinzu. Bei gecachtem Datenverkehr macht es die Anfrage deutlich schneller und senkt gleichzeitig die Token-Kosten.
Führen Sie die Benchmarks selbst durch. Nutzen Sie die Checkliste, füllen Sie die Vorlage mit Ihren eigenen Testläufen, steigern Sie die Nebenläufigkeit, um den Knickpunkt zu finden, und messen Sie p99- sowie Cache-Hit-Latenzen als primäre Metriken. Ein Gateway, das diese Kriterien erfüllt, bietet Ihnen Routing, Fallback, Caching, Budgets, Guardrails und Observability pro Anfrage zu Latenzkosten, die im Vergleich zum Modell kaum ins Gewicht fallen. Der einzige Weg, dies zu beweisen, ist die Messung mit Ihrem eigenen Datenverkehr.
Benchmarken Sie ein Gateway, das mit aktiviertem Caching schneller wird. Buchen Sie eine Demo.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





