



November 16, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
複数のプロバイダーにわたるLLMの請求額は、支払うのは簡単ですが、割り振るのが困難です。AnthropicのコンソールにはAPIキーごとに1つの数字が表示され、OpenAIにはプロジェクトごとに1つの数字が表示されます。これらの数字は正確です。しかし、誰が、どのアプリで、どの機能で、誰の予算から支出したのかには答えてくれません。本記事では、ゲートウェイレベルのアトリビューション層がこのギャップをどのように埋めるかを解説します。メタデータタグ付けスキーマ、プロバイダーを跨いだトレースごとのコスト計算式、数百万のスパントレースを毎日のチームロールアップに変換する集計パイプライン、リアルタイムなコンカレンシーモデルによるソフト/ハード予算制限の強制、そして最終的に出力されるチャージバックレポートについて説明します。
水曜日の午後、Northwind社にて。 プラットフォーム部門VPのSarahにSlackが届きます。「金曜日の第2四半期予算会議のために、チームごとのAIコストの内訳が必要です。」彼女はAnthropicコンソールを開きます。そこには1行の表示。「今月初めから本日までの合計:$47,234.12」。sk-ant-prod-northwind-sharedに対して課金されています。そのキーは、4つのチームにまたがる50人以上のエンジニアと、多数のアプリケーションを動かしています。数字は正確です。しかし、金曜日に必要な会話 — どのチームが、どのアプリケーションで、どの機能のために、どの顧客に対してその請求が発生したのか — には全く役に立ちません。
Sarahの選択肢は厳しいものです。キーを4つに分割して、ゲートウェイのマルチプロバイダールーティング機能を犠牲にするか。各チームのリードに見積もりを求めて手動で調整するか(その数字は30%はズレるでしょう)。あるいは、作業がすでに記録されている場所、つまりゲートウェイのトレースストアから答えを引き出すかです。この記事では、3番目の選択肢がどのように機能するかを説明します。
プロバイダーネイティブの請求における構造的な問題は、チームの境界ではなく、資格情報(クレデンシャル)の境界で集計されることです。AnthropicはAPIキーと組織ごとに、OpenAIはプロジェクトごとに、Azureはデプロイとリソースグループごとに、AWS BedrockはIAMロールとアカウントごとにコストをグループ化します。これらはどれも、実際に課金したい運用単位(チーム、アプリケーション、機能、顧客)と一致していません。
「チームごとに1つのクレデンシャルを持つ」という古典的な回避策は機能しますが、ゲートウェイを導入した本来の価値を無効化します。難しいリクエストにはAnthropicを選択し、シンプルなリクエストにはHaikuを選択したり、AnthropicがオーバーロードしたときにAzureにフェイルオーバーしたり、リージョンデプロイメント間でロードバランスをとるようなルーティングロジックです。これらはすべて、ゲートウェイが各プロバイダーのクレデンシャルを保持している必要があります。チームごとのキーを導入すると、チームごとのプロバイダー関係を強いることになります。アプリケーション層でのインストゥルメンテーションも不完全です。グリーンフィールドのコードベースでは機能しますが、2つのSDKバージョンとフォークされたLangChainにわたって3つのプロバイダーを呼び出すエージェントでは機能しません。アトリビューションはゲートウェイで行われるべきです。なぜなら、すべてのプロバイダー呼び出しはどのみちゲートウェイを経由してルーティングされるからです。
パターンはシンプルです。ゲートウェイへのすべてのリクエストは、呼び出し元が誰か、誰のために呼び出しているか、何をしているかを表すJSONオブジェクトを保持します。ゲートウェイはこのオブジェクトをgen_ai属性と一緒にトレースに保存し、厳選されたフィールドのサブセットを集計に使用されるメトリックラベルにプロジェクションします。
HTTP — アプリケーションはすべてのゲートウェイ呼び出しでメタデータヘッダーを設定します
フィールドは意図的に異種混合(Heterogeneous)にされています。カーディナリティの低いフィールド(team、app、feature、env)は、メトリックラベルによくプロジェクションされます。カーディナリティの高いフィールド(user_id、pipeline_id)は、プロジェクションするとメトリックストレージが爆発するため、トレースのみに残ります。ゲートウェイはその違いを知る必要があります。集計用タグ(tag-for-aggregation)フィールドは明示的な許可リスト(一般的な設定: team、app、feature、env、model_class)であり、毎日のロールアップキー空間の一部となります。それ以外はすべて監査用タグ(tag-for-audit)であり、フォレンジックやアドホッククエリのためにトレースに保存されます。
アプリケーションは、外部呼び出し時にメタデータを一度設定します。ゲートウェイは、フォールバック(別のプロバイダーへのフォールバックでも同じメタデータが維持されます)やマルチターンエージェントループ(各ツール呼び出しは親呼び出しと同じメタデータを持ちます)を含むスパンツリー全体にそれを伝播します。継承は自動的であり、チームはすべての呼び出し場所にメタデータを渡す必要はありません。
コストは請求時ではなく、スパン終了時に計算されます。ゲートウェイは (provider, model) ペアごとにバージョン管理された価格設定テーブルを保持し、最終応答チャンクで報告された使用トークンに適用します。出力はプロバイダースパンに gen_ai.usage.cost_usd として保存され、ルートにロールアップされます。
Python — プロバイダースパン終了時のコスト計算、複数明細対応の計算式
見落としがちですが重要な2つの詳細があります。第一に、プロバイダーが価格を変更することがあり、請求はリクエスト時点で有効だったものと一致する必要があるため、価格設定テーブルはタイムスタンプでバージョン管理されます。過去のトレースを今日の価格で再計算してはいけません。第二に、音声と画像の入力はトークンごとではなく分単位や画像単位で価格設定されるため、それらを別々の行として追加する必要があります。そうしないと計算式でそれらが無視されてしまいます。
キャッシュトークンの減算(fresh = input_tokens − cache_read − cache_write)は、OpenTelemetry GenAI仕様が指摘しているのと同じ繊細な点です。gen_ai.usage.input_tokens は両方のキャッシュラインを含む合計として定義されているため、一般的なバグとして cache_read のみを減算して cache_write を減算しない場合、キャッシュ書き込み部分がフレッシュ入力料金とキャッシュ書き込み料金の両方で二重カウントされてしまいます。
すべてのPRでエージェントを実行している50人のエンジニアを抱える単一の組織では、1日に100万個のプロバイダースパンが容易に発行されます。その生のボリュームをクエリして「プラットフォームチームが昨日費やした費用」に答えることは、技術的には可能ですが、運用上は最悪です。トレースストアへのフルスキャンは、クエリごとに基礎となる推論と同じくらいの費用がかかります。解決策は、3つのレイヤーで行われる事前集計です。
集計パイプライン — 分単位のカウンター → 時間単位のロールアップ → 日次MV
これを手頃な価格にするためのコスト管理: トレースストアをクエリして集計しないでください。トレースストアはフォレンジック用です。集計はロールアップテーブルから取得します。Northwindの規模(1日あたり100万スパン)では、ロールアップはサブセカンドのクエリレイテンシでギガバイト範囲内に収まります。エンジンの選択は主に好みです — ClickHouseは大規重集計で高速であり、カーディナリティ制御が優れています。TimescaleDBはすでにPostgresを実行しているチームにとって親しみやすいものです。どちらも、スタートアップから中規模までは単一のVM上でこのワークロードを実行できます。1日あたり約10億スパンを超えると、ClickHouseが優位になります。
チームの支出をほぼリアルタイムで計算できるようになると、予算の管理が可能になります。パターンは2段階です。
ソフト制限 (予算の80%)。 PagerDutyまたはSlackを介してチーム所有者に通知をトリガーします。リクエストはブロックされません。目的は、問題になる前に傾向を浮き彫りにすることです。一部のチームは60% / 80% / 95%の3段階ソフト制限を設定します。
ハード制限 (予算の100%)。 ゲートウェイは原因を特定するエラーボディとともにHTTP 429を返し、プロバイダーへの呼び出しを拒否します:
HTTP 429 — budget_exhausted レスポンスの形式
並行性の問題は深刻です。チームXが25,000ドルの予算のうち24,997ドルに達しており、10個の並行リクエストが到着した場合、単純な read-then-write ロジックでは、各ワーカーが「予算内」と判断し、10個すべてが送信されます。修正方法はアトミックカウンターです。Redisの INCRBYFLOAT が活用されます。各ワーカーは、派遣前に予想されるリクエストコスト(トークン数の余裕と、チームに許可されている最も安いモデルから推定)でインクリメントし、インクリメント後の値を制限と比較して、超えている場合は中止します。実際のコストはスパン終了時に予測と調整され、小さな調整は日次ロールアップで解決されます。
このパターンは、中止されたリクエストでわずかにオーバーカウントされますが、アンダーカウントされることはありません。予算サーキットブレーカーの場合、それが正しい非対称性です。数セントのオーバーカウントは、数千ドルの予算オーバーに優ります。
予算システムの最も脆い部分は、100%での崖です。完全な品質から一歩で429に移行することは悪い体験です。より優れたパターンは段階的な機能低下(Graceful Degradation)です。稼働率が上昇するにつれて、より安いモデルにルーティングします。
ゲートウェイのルーティングレイヤーとの統合は、デフォルトのモデル選択をオーバーライドする予算認識ポリシーです。一般的な構成:
YAML — 予算対応オーバーライドを備えたルーティングポリシー断片
80%で、チームはSonnetからHaikuに変更されます。これは、ほとんどの非クリティカルなタスクが許容する品質低下で、コストを3分の1に削減します。95%では出力制限も強化され、最悪のシナリオでのリクエストごとのコストがバインドされます。チーム所有者には各遷移時に通知されます。パイプラインは停止しません。
トレードオフはワークロードごとに意識的に行われる必要があります。コードレビューとチケットのトリアージは問題なく段階的に機能低下できますが、医療記録の要約はおそらくそうすべきではありません。ルーティングポリシーは、アプリケーションの他の本番設定の隣に配置されます。
ループを閉じる成果物は、コスト割り当て作業を行う担当者(通常はFinOpsチームまたは財務パートナー)にエクスポートされる月次のチャージバックレポートです。スキーマは日次ロールアップのコピーであり、月にフィルタリングされ、(team, app, model, provider) の1行ごとにグループ化されます。
cache_savings_usd カラムは、プラットフォーム投資のほとんどを正当化するものです。(cache_read_tokens × fresh_input_rate − cache_read_tokens × cached_rate) / 1e6 として計算されます。これは、それらのトークンがキャッシュされたレートでかかった費用と、フレッシュな状態であった場合にかかった費用との差額です。何千ものリクエストにわたって安定したシステムプロンプトを持つエージェントの場合、この数字は総支出の3分の1から3分の2になることがよくあります。
レポートは、組織の既存のFinOpsツールに直接取り込むためのCSV、およびチーム所有者自身のためのレンダリングされたダッシュボードとして生成されます。以下のモックアップは、月末の表示がどのようになるかを示しています。
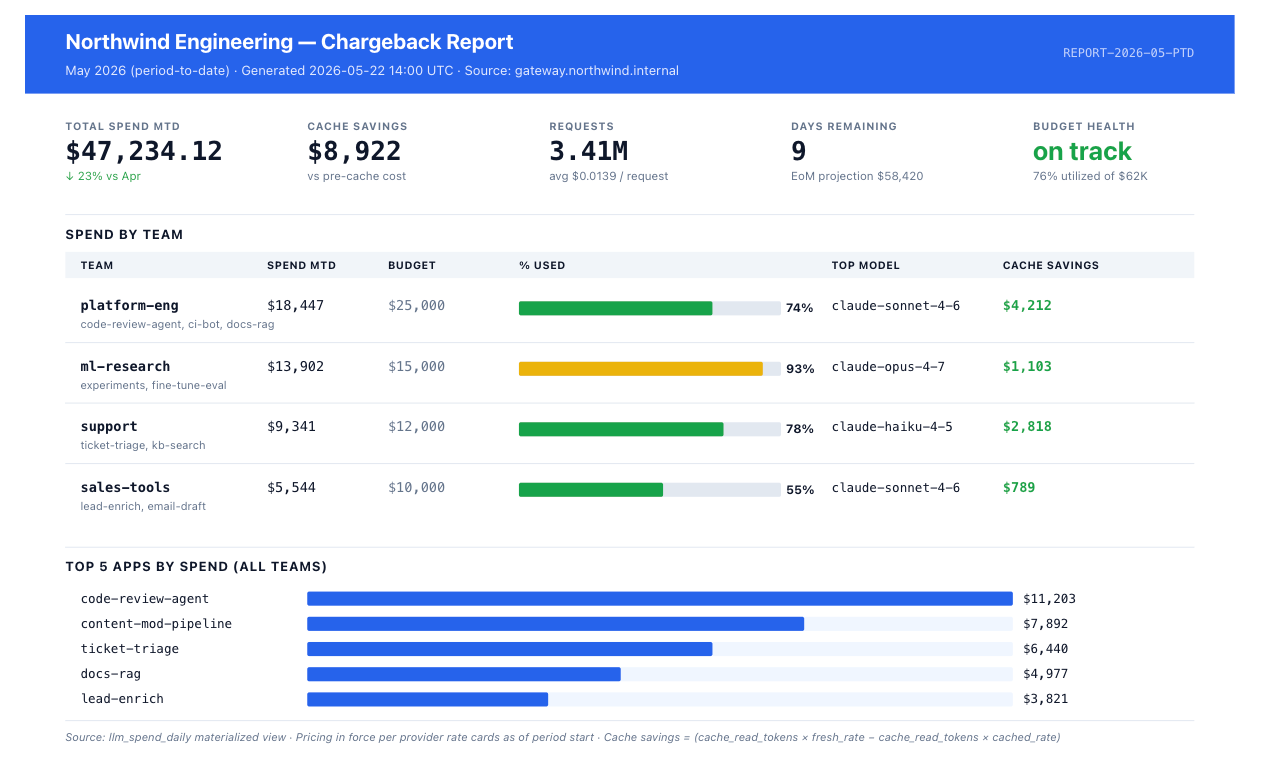
2026年5月時点のClaude Sonnet 4.6の価格設定を使用した具体的な数値: 1,000,000トークンあたり入力$3、出力$15、キャッシュ読み取り$0.30、キャッシュ書き込み$3.75。
Northwindのコードレビューエージェントは、すべてのプルリクエストで実行されます。PRごとの内訳: 12,000トークンのシステムプロンプト(スタイルガイド、リポジトリの規約、チェックリスト、few-shotの例)、1,500トークンのディフ、約800トークンのインラインレビュー出力。50人のエンジニア × 10 PR/日 = 500 PR/日。
キャッシュなしの場合。 PRごと: (12,000 + 1,500) × $3/1M + 800 × $15/1M = $0.0405 + $0.012 = $0.0525。日次: $26.25。月次: $787。
12Kシステムプロンプトでの5分間のプロンプトキャッシュありの場合 — コールドパスでのキャッシュミス、ウォームパスでのキャッシュ読み取り、混雑したリポジトリでのウォームヒット率約85%:
500人のエンジニアを抱える組織では、同じ計算が比例してスケールし、キャッシュなしで月額$7,870、キャッシュありで月額$3,940になります。トレースごとのアトリビューションがない場合、この差額は見えません。差別化されていない共有キーの合計の一部にすぎません。アトリビューションがある場合、チャージバック行には次のように読み取れます: platform-eng / code-review-agent / claude-sonnet-4-6 / anthropic — 支出$394、キャッシュ節約額$393、15,500リクエスト、エラー率0.1%。金曜日の会話は、もはや共有キーでの$47,234についての議論ではなくなります。
チームごとに1つのAPIキーを使用し、プロバイダーのダッシュボードを確認するだけではダメですか?
それも可能です。しかし、ゲートウェイの価値であるマルチプロバイダールーティング、自動フォールバック、ロードバランシング、統合されたレート制限、一括キーローテーションを失うことになります。そこから始めるほとんどのチームは、キーの分離がトラフィックポリシーの分離も強制することに気づき、1四半期以内にゲートウェイレベルのアトリビューションに移行します。メタデータタグのアプローチは、そのトレードオフなしでアトリビューションを提供します。
コストデータの最新性を保つにはどうすればよいですか?日次ロールアップはリアルタイムダッシュボードには遅すぎます。
3層アーキテクチャは、まさにその両方を提供するために存在します。時間単位のロールアップは数分以内に更新され(分単位のカウンターが継続的にフラッシュされます)、日次ロールアップがチャージバックの真実のソースになります。リアルタイムダッシュボードの場合は、時間単位のロールアップをクエリします。チャージバックの場合は、日次ロールアップをクエリします。
埋め込み、ベクトルストア、ファインチューニングなどの非LLMコストはどうですか?
埋め込み(Embeddings)は推論と同じ使用プロファイルを持ち、ゲートウェイは同じメタデータでアトリビューションを行います。ベクトルストアとファインチューニングは通常、ゲートウェイの外で課金されます。FinOpsパイプラインがそれらを取り込んでいる場合、チャージバックレポートはそれらの外部明細項目を結合できます。
ストリームが終了するまで最終コストが分からないストリーミング応答の場合、これはどのように機能しますか?
プロバイダースパンはストリーム全体が開いたままであり、コスト計算は最終的な使用ブロックが末尾のチャンクに到着するスパン終了時に実行されます。リクエスト開始時の予算の事前割り当てには予測された上限が使用され、調整はスパン終了時に行われます。
Redisの障害やネットワークパーティション下での予算制限はどのように動作しますか?
アトミックカウンターは、ハード制限の実施に関する真実のソースです。Redisに到達できない場合、ゲートウェイには2つの設定可能なモードがあります: フェイルオープン(リクエストを許可し、予算オーバーのリスクを受け入れる)またはフェイルクローズ(リクエストを拒否し、可用性への影響を受け入れる)。適切な呼び出しはワークロードによって異なり、ゲートウェイはチームごとの設定としてそれを公開します。ソフト制限の通知はベストエフォートです。
TrueFoundryはどこに適応しますか?
X-TFY-METADATA ヘッダー、価格設定テーブルのメンテナンス、ストリーミング集計パイプライン、および予算サーキットブレーカーはすべて、デフォルトでTrueFoundry AI Gatewayの一部です。チャージバックのエクスポートは、スケジュールされたCSV/JSON/Webフックとして、または予算所有者向けのインタラクティブなダッシュボードとして実行されます。価格設定テーブルはプロバイダーのレートカードを追跡し、過去のトレースはリクエスト時に有効だったレートを引き続き使用するため、先月のチャージバックを再実行しても、先月と同じ数字が生成されます。
LLMワークロードが現在共有APIキーに対して課金されている場合、最もレバレッジが高い最初のステップは、完全なアトリビューションパイプラインをデプロイする前であっても、すべての呼び出し場所にメタデータヘッダーを追加することです。ヘッダーには前方互換性があります。設定された瞬間からトレースへのデータの蓄積が開始され、ロールアップテーブルが開始された日からチャージバックレポートが役立つようになります。
ここでのNorthwind、Sarah、および具体的な金額は説明のための例です。データモデル、X-TFY-METADATA ヘッダー設計、およびパイプラインアーキテクチャは、TrueFoundryのような本番環境向けAIゲートウェイが実際に支出を属性付けする方法に基づいています。引用されているプロバイダーの価格設定は、プロバイダーの公開レートカードに従い、2026年5月時点のものです。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























