



November 16, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
企業やデベロッパーがより高度なLLM駆動型アプリケーションを構築する中で、会話の中で頻繁に登場する2つのフレームワークがあります。それがLlamaIndexとLangGraphです。どちらも大規模言語モデル(LLM)を扱う複雑さを簡素化することを目指していますが、対処する課題は大きく異なります。
LlamaIndexは主にデータの統合と検索拡張世代(RAG)に焦点を当てており、LLMをプライベートデータやエンタープライズデータソースに容易に接続できるようにします。インデックス作成、クエリ実行、検索パイプラインを提供し、モデルが適切なタイミングで適切なコンテキストにアクセスできるようにします。
一方、LangGraphはステートフルなワークフローオーケストレーション向けに設計されており、デベロッパーはグラフ構造を使用して複雑なエージェントベースのアプリケーションを構築できます。ループ、リトライ、分岐、マルチエージェント連携を強調しており、これらは単純なプロンプトチェインを超えて本番環境に対応したAIシステムに移行するために必要な機能です。
この比較では、LlamaIndexとLangGraphがどのように補完し合うのか、どこが異なるのか、そして特定のLLM開発ニーズにおいてどちらのフレームワークがより適しているかを詳しく探っていきます。
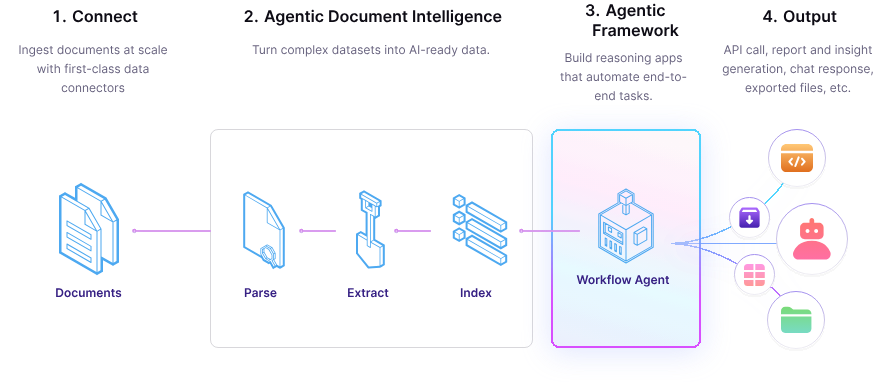
LlamaIndexは、デベロッパーが大規模言語モデル(LLM)を自社データに構造化され効率的な方法で接続できるように設計されたオープンソースフレームワークです。モデルがトレーニングから知っている情報だけに頼るのではなく、LlamaIndexを使用することで最新のドメイン固有情報へのアクセスをモデルに簡単に提供でき、より正確で文脈に沿った回答が可能になります。
複数のソースからのデータの取り込み、インデックス作成、クエリ実行のためのツールを提供します。これらのソースには、PDF、データベース、API、ウェブサイト、その他のドキュメントリポジトリが含まれます。取り込まれたデータはエンベディングに変換され、LLMが応答を生成する際に検索できるインデックスに格納されます。
このフレームワークはモジュール式であるため、データの処理および検索方法を正確に選択できます。例えば、ストレージにPineconeやWeaviateなどのベクトルデータベースを使用したり、検索精度を向上させるためにチャンキング戦略をカスタマイズしたり、アプリケーションのニーズに合わせてクエリパイプラインを定義したりできます。
LlamaIndexは、特に検索拡張世代(RAG)ワークフローで人気があります。これらのセットアップでは、モデルは回答を生成する前にインデックス付きデータから関連するコンテキストを検索します。これにより、ハルシネーション(幻覚)が減少し、事実に基づいた正確性が向上し、カスタマーサポート、調査、コンプライアンスチェック、社内ナレッジ管理などの現実世界のタスクにおいてAIがより有用になります。
組み込みの統合機能、柔軟なAPI、単純な検索パイプラインと複雑な検索パイプラインの両方のサポートを備えたLlamaIndexは、強力なLLMとプライベートな構造化データセットとの橋渡しを目指すデベロッパーにとって標準的な選択肢となっています。
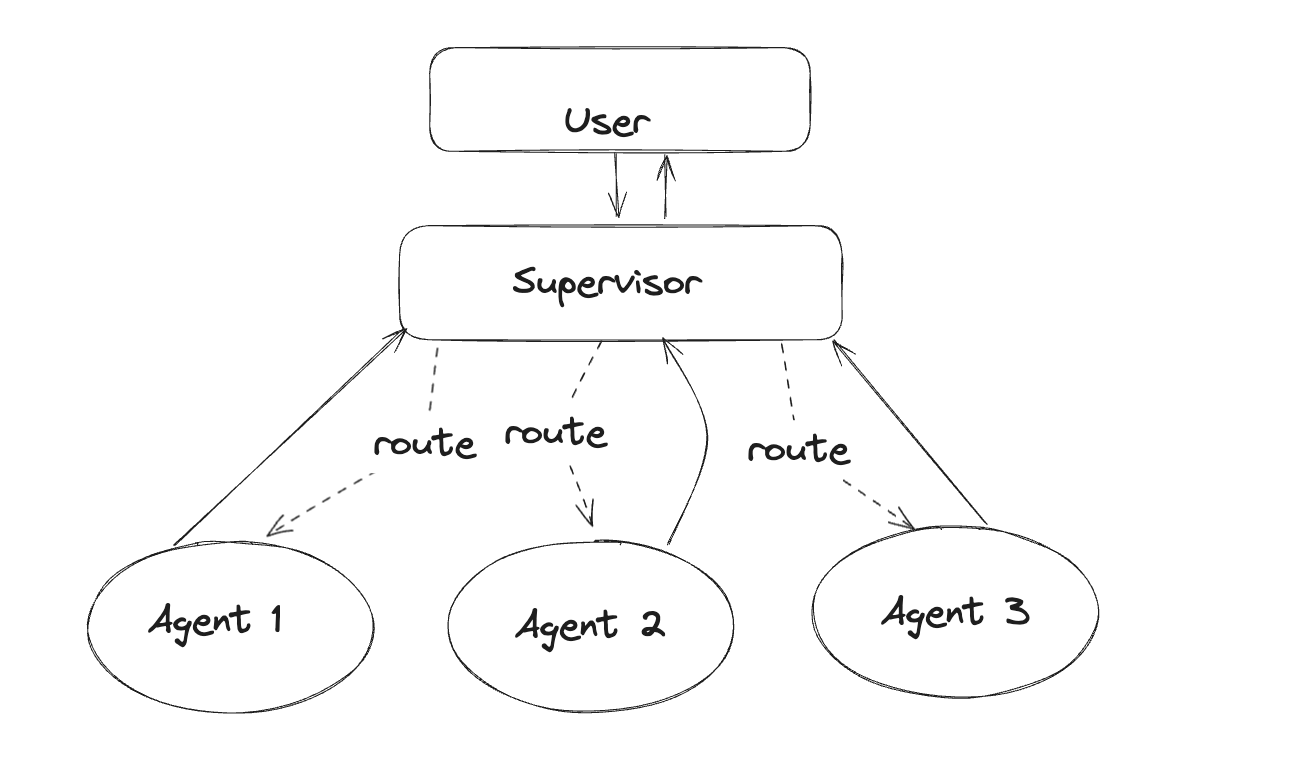
LangGraphは、実行フローが明示的に定義され、複数のステップにわたって状態(ステート)が維持されるAIアプリケーションを構築できるフレームワークです。単純なプロンプト応答のセットアップとは異なり、LangGraphを使用すると各ステップの結果に基づいて動的に適応する構造化されたワークフローを作成できます。
ノードがアクションや決定を表し、エッジがアプリケーションがそれらの間をどのように移動するかを定義するグラフベースのアーキテクチャを使用します。この設計により、ループ、分岐パス、または以前のステップへの再訪問を含む可能性のある複雑で非線形なプロセスを管理しやすくなります。LangGraphワークフローの各ステップでは、LLM呼び出しの実行、外部ツールのトリガー、またはカスタム機能の実行が可能です。
LangGraphの主な強みの1つは、ステートの永続性です。長期にわたるセッション全体でも、過去のインタラクション、変数、決定事項を記憶できます。これにより、継続性が必要なマルチターンアシスタント、調査研究エージェント、誘導型トラブルシューティングシステムなどのユースケースに適しています。
また、LangGraphはイベント駆動型の実行をサポートしているため、ワークフローの任意の段階で外部トリガーやユーザー入力に反応できます。これにより、AIがリアルタイムで応答する必要があるアプリケーションや、続行する前に人間のレビューのために一時停止する必要があるアプリケーションの可能性が広がります。
デベロッパーにとって、LangGraphはAIシステムの動作をより細かく制御し、デバッグするための明確な方法を提供します。すべての決定と状態の変更を可視化することで、より予測可能で保守しやすく透明性の高いAIアプリケーションを実現します。
LlamaIndexは、大規模言語モデルを適切なタイミングで適切な情報に接続するという1つの重要な課題の解決に集中しています。複数のソースからデータを収集し、効率的にインデックスを作成し、精度を向上させる方法でクエリを実行するためのツールを提供します。検索拡張世代ワークフロー専用に構築されているため、主なニーズがLLMに構造化データ、プライベートデータ、またはドメイン固有の知識へのアクセス権を与えることである場合に最適です。柔軟なデータコネクタ、複数のストレージバックエンド、カスタマイズ可能なクエリパイプラインにより、検索拡張型AIアプリケーションの構築プロセスを効率化します。
対照的に、LangGraphはAIアプリケーションのロジックと制御フローの設計に焦点を当てています。プロセスが厳密に線形ではなく、分岐、ループ、または以前のステップの再実行が含まれる可能性がある状況で真価を発揮します。グラフベースの実行モデルにより、AIがアクション、ツール、決定ポイントの間をどのように移動するかを正確にマッピングできます。これにより、ステートの永続性、決定の可視性、Human-in-the-loop(人間の関与)チェックポイントが重要となる、適応型の長期実行ワークフローの構築において強力な選択肢となります。
LlamaIndexは、アプリケーションが大規模言語モデルに外部ソースからの正確で最新かつ文脈豊かな情報を提供する必要がある場合に適した選択肢です。LLM自体はトレーニングされた内容しか知らず、その情報は古かったり不完全であったりする可能性があります。LlamaIndexは、モデルを独自のデータに接続できるようにすることでこのギャップを埋めます。
プロジェクトに検索拡張世代(RAG)が含まれる場合、LlamaIndexを最初の選択肢の1つとして検討すべきです。ドキュメント、データベース、API、その他のリポジトリからデータを取得し、エンベディングに処理して効率的な検索のためにインデックスを作成する作業が簡単になります。これにより、LLMはクエリに答える前に関連するコンテキストを取得できるようになり、事実の正確性が向上し、ハルシネーションが減少します。
ワークフローに以下が必要な場合は、LlamaIndexの採用を検討してください。
特に以下のようなユースケースで価値を発揮します。
社内ナレッジベース:従業員がドキュメントに裏付けられた正確な回答を必要とする場合。
カスタマーサポートシステム:製品マニュアルやFAQに基づいて応答する必要がある場合。
リサーチアシスタント:公開情報と固有情報を組み合わせてレポートを作成する場合。
コンプライアンスおよび監査ツール:正確性とトレーサビリティが重要となる場合。
LlamaIndexはLLMに関連情報を提供するのに非常に優れていますが、複数ステップのワークフロー全体の意思決定プロセスを制御するようには設計されていません。AIに複雑なオーケストレーションや永続的なステート管理が必要な場合は、LlamaIndexをLangGraphのようなツールと組み合わせることで、高品質なコンテキストと堅牢なワークフロー制御の両方を得ることができます。
LangGraphは、解決策へのパスが厳密に線形ではなく、決定が変化する条件や複数段階の推理に依存するAIアプリケーションに最適です。ワークフローに新しい入力に基づく分岐、ループ、または以前のステップの再訪問が含まれる場合、LangGraphはそのプロセスを設計および制御するための構造を提供します。
主な利点の1つは、ステートの永続性です。多くのAIアプリケーションでは、ステップ間でコンテキストを記憶する能力が不可欠です。LangGraphはワークフロー全体を通じて状態を保存・引き継ぎするため、長時間のタスク、マルチターンの会話、または続行する前に人間の承認を得るために一時停止する必要があるプロセスに最適です。
ワークフローに以下が必要な場合は、LangGraphの採用を検討してください。
LangGraphは、プロセスの途中で適応できる予測可能で透明性の高いAIの挙動が必要な場合に真価を発揮します。LlamaIndexのような大規模なデータの取り込みや検索の管理向けには構築されていませんが、2つを組み合わせることで強力な威力を発揮します。LlamaIndexが正確で関連性の高いデータを提供し、LangGraphがそのデータを使用するワークフローが効率的かつ確実に実行されるように保証します。
LlamaIndexとLangGraphのどちらを選択するかは、優先事項がAIに適切な情報へのアクセスを与えることか、それともその情報を処理する方法を制御することかによって決まります。
主な課題がデータ検索である場合は、LlamaIndexの方が適しています。LLMをプライベートデータ、構造化データ、またはドメイン固有データに接続し、クエリ実行時に関連するコンテキストを返すように設計されています。これにより、応答を生成する前にモデルの精度が複数のソースから適切な情報を取得することに依存する、RAGベースのアプリケーションに最適となります。
一方、AIワークフローの構造、適応性、透明性に重点を置く場合は、LangGraphの方が強力な選択肢となります。すべてのステップをマッピングし、分岐やループのパスを作成し、長時間のプロセス全体でステートを維持できます。これは、コンテキストに基づいて意思決定が変化したり、人間のレビューが必要であったり、タスクが複数の段階に及んだりするアプリケーションで特に役立ちます。
LlamaIndexはAIが知るべきことを知っていることを保証し、LangGraphはその知識を効果的に使用するために適切なプロセスに従うことを保証します。ユースケースで正確な検索と制御された実行の両方が必要な場合は、LlamaIndexをデータ層として提供し、LangGraphをワークフロー層として管理することで、2つを組み合わせることができます。
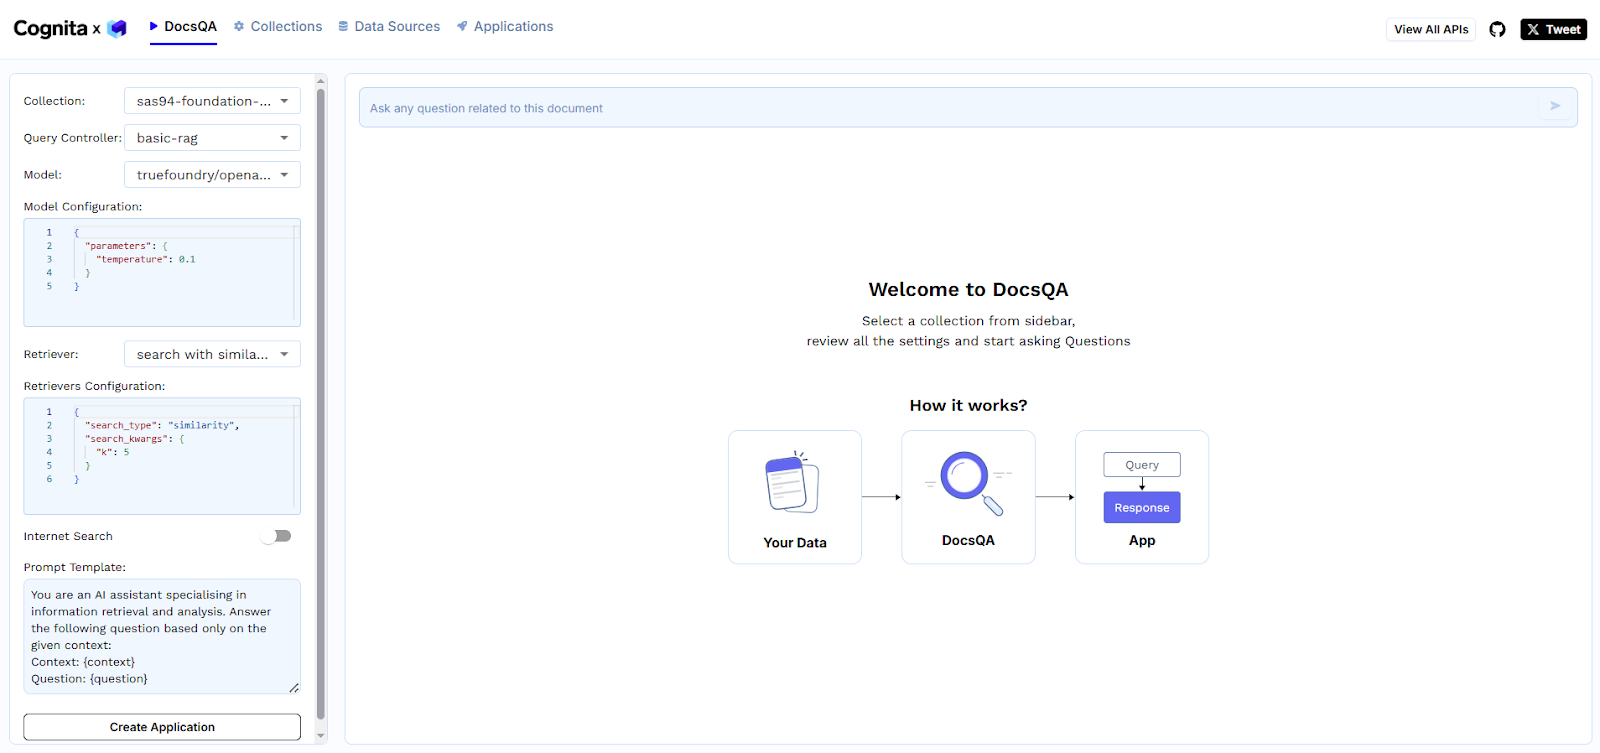
TrueFoundry Cognitaは、検索拡張世代(RAG)アプリケーションを構築およびスケールするためのエンタープライズ対応フレームワークです。VPC、オンプレミス、またはエアギャップ環境での安全なデプロイが可能な、モジュール式でAPI駆動型のアーキテクチャを提供します。CognitaはSOC 2、HIPAA、GDPRコンプライアンスを満たしています。大規模な並行ワークロードのオートスケーリングをサポートします。組み込みのオブザーバビリティとトレーシングにより、ミッションクリティカルなユースケースにおける正確性、信頼性、監査可能性を確保します。
主な機能:
CognitaによるRAGアプリケーションの構築
Cognitaを使用したエンタープライズRAGアプリの作成は、シンプルでありながら本番環境を意識したものです。まず、S3、ローカルファイル、データベース、APIなどのデータソースを選択し、PDFやMarkdownなどのフォーマットをパースします。エンベディングモデルを選択し、QdrantやWeaviateなどのベクトルデータベースに接続します。チャンキング、類似性検索、リランキングなどのリトリーバーパラメーターを設定し、検索されたコンテキストをLLMに入力するためのプロンプトテンプレートを設計します。スケーリング、キャッシュ、トレーシングの実行時設定を適用し、API経由でデプロイします。Cognitaは、エンタープライズセキュリティとパフォーマンスを維持しながら、検索からリランキング、プロンプト実行までのフロー全体をオーケストレートします。
TrueFoundry CognitaがLlamaIndexやLangGraphよりも優れている理由
Cognitaは、LlamaIndexの検索機能とLangGraphのワークフローオーケストレーションを超え、両方を統合したエンタープライズ対応RAGプラットフォームです。安全でコンプライアンスに準拠したデプロイを実現し、重いワークロード下でもシームレスにスケールし、パイプラインのデバッグと最適化のためのエンドツーエンドのオブザーバビリティを提供します。LlamaIndexとは異なり、エンタープライズスケールでRAGを実行するためのインフラストラクチャが含まれており、LangGraphとは異なり、検索層と実行環境の両方を1つの統合フレームワークで管理します。
LlamaIndexとLangGraphは、AI開発において異なりながらも補完的な役割を果たします。LlamaIndexは、正確な検索のために大規模言語モデルを外部の構造化されたプライベートデータに接続することに長けています。LangGraphは、AIが情報を処理する方法をガイドする適応的でステートフルなワークフローの設計に焦点を当てています。どちらを選択するかは、データアクセスとワークフロー制御のどちらを優先するかによって決まります。両方の結合を目指す企業には、TrueFoundry Cognitaが理想的な基盤を提供します。安全でコンプライアンスに準拠したデプロイオプション、オートスケーリング、完全なオブザーバビリティを備えたCognitaは、検索とオーケストレーションをシームレスに統合する信頼性の高いエンタープライズグレードのRAGアプリケーションの構築を可能にし、本番環境でAIシステムが正確かつ効率的に機能することを保証します。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























