



November 16, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
要約: Kimi-K2 Thinking (Moonshot AI) は、マルチステップ推論、長期的なツールオーケストレーション、および巨大なコンテキストウィンドウを推進する、オープンウェイトかつツール認識型の「思考 (thinking)」モデルです。Humanity’s Last Exam (HLE) および複数のエージェントベンチマークにおいて、トップクラスの数値(特にツールアクセスが有効な場合)を記録しており、LLMにおける次の主要なフロンティアは、単なる生のパラメータ数ではなく、思考 + ツール + ロングコンテキストであるという強力な根拠を示しています。
Truefoundry AI Gatewayを使用して、今すぐお試しください。
MMLU、コーディングテスト、チャットベンチマークなどの従来のベンチマークは多くの洞察を与えてくれましたが、マルチステップ推論、ツールオーケストレーション、あるいは長期的な計画立案を完全には測定していません。新しいクラスの「思考」モデルは、これらの能力向けに明示的にトレーニングされています。モデルは、内部の段階的な推論と外部ツールの呼び出し(検索、コードインタープリタ、Webブラウジング)を交互に行い、多くの連続するステップ全体で一貫性を維持する必要があります。
Kimi-K2 Thinkingはこの傾向の代表的な例です。エージェントシステムとして設計されており、推論し、ツール呼び出しを決定し、ツール出力を取り込み、推論を継続します。これらはすべて、何百ものステップにわたってコンテキストを維持しながら行われます。その結果、HLEやBrowseCompなどのハードな「思考」ベンチマークで大幅な向上を実現しました。
公式モデルカードからの主な技術的ハイライト:
これらの要素(MoEスケール、巨大なコンテキスト、明示的なツールオーケストレーション、効率的な低ビット推論)は、Kimi-K2が対話型Transformer以上にエージェントとして機能することを可能にする構成要素です。
Humanity’s Last Exam (HLE) は、検索や近道ではなく、本物の推論に負荷をかける非常に挑戦的な試験形式のベンチマークとなることを目指しています。数学、科学、工学、その他の分野にわたる、専門性が高く、多くはマルチステップの課題が含まれています。HLEの課題は通常、マルチステップ推論や、場合によっては外部での検索や計算を必要とするため、ツール機能を持つロングコンテキストエージェントにとって優れたストレステストとなります。Kimi-K2の開発ではHLEやその他のエージェントベンチマークが強調されており、モデルカードではHLEがコア評価ターゲットの1つとして明確に挙げられています。
Moonshot AIが公開した評価結果によると:
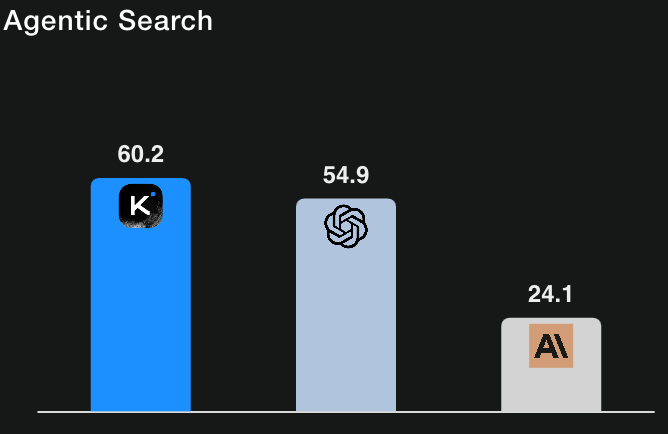
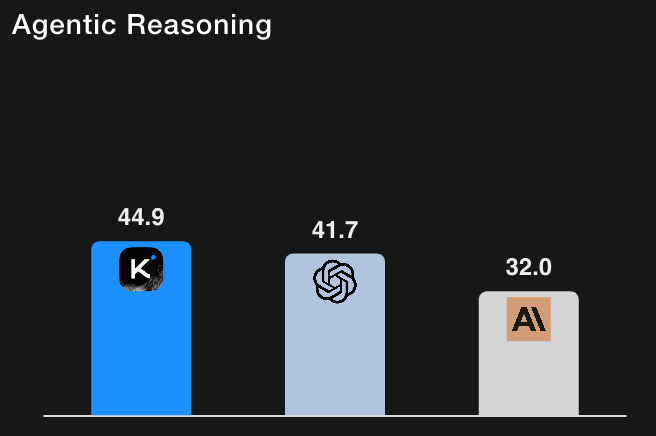
参考までに、ツールを使用したHLEでのGPT-5 (High) は約41.7%(彼らの内部再実行)、Claude Sonnet 4.5は約32.0%(思考モード)です。したがって、Kimi-K2の結果は、ツールを有効にしたHLE実行において報告されているベースラインを上回っています。(すべての数値はMoonshot AIの評価テーブルおよび脚注から引用されています。)
重要なニュアンス: モデルカードには、ツールアクセス、判定設定、トークン予算、コンテキスト制限がどのように処理されたかが注意深く記録されています。また、著者らは一部のベースライン数値が公式投稿から取得されたものであり、他の数値は内部で再テストされたものであるとも述べています。要約すると、これらは強力なシグナルですが、読者はこれらがMoonshot AIによって報告されたものであり、結果とともに説明されている詳細な評価プロトコルを条件としていることに注意する必要があります。
HLEから50のデータ行をサンプリングした結果は以下の通りです
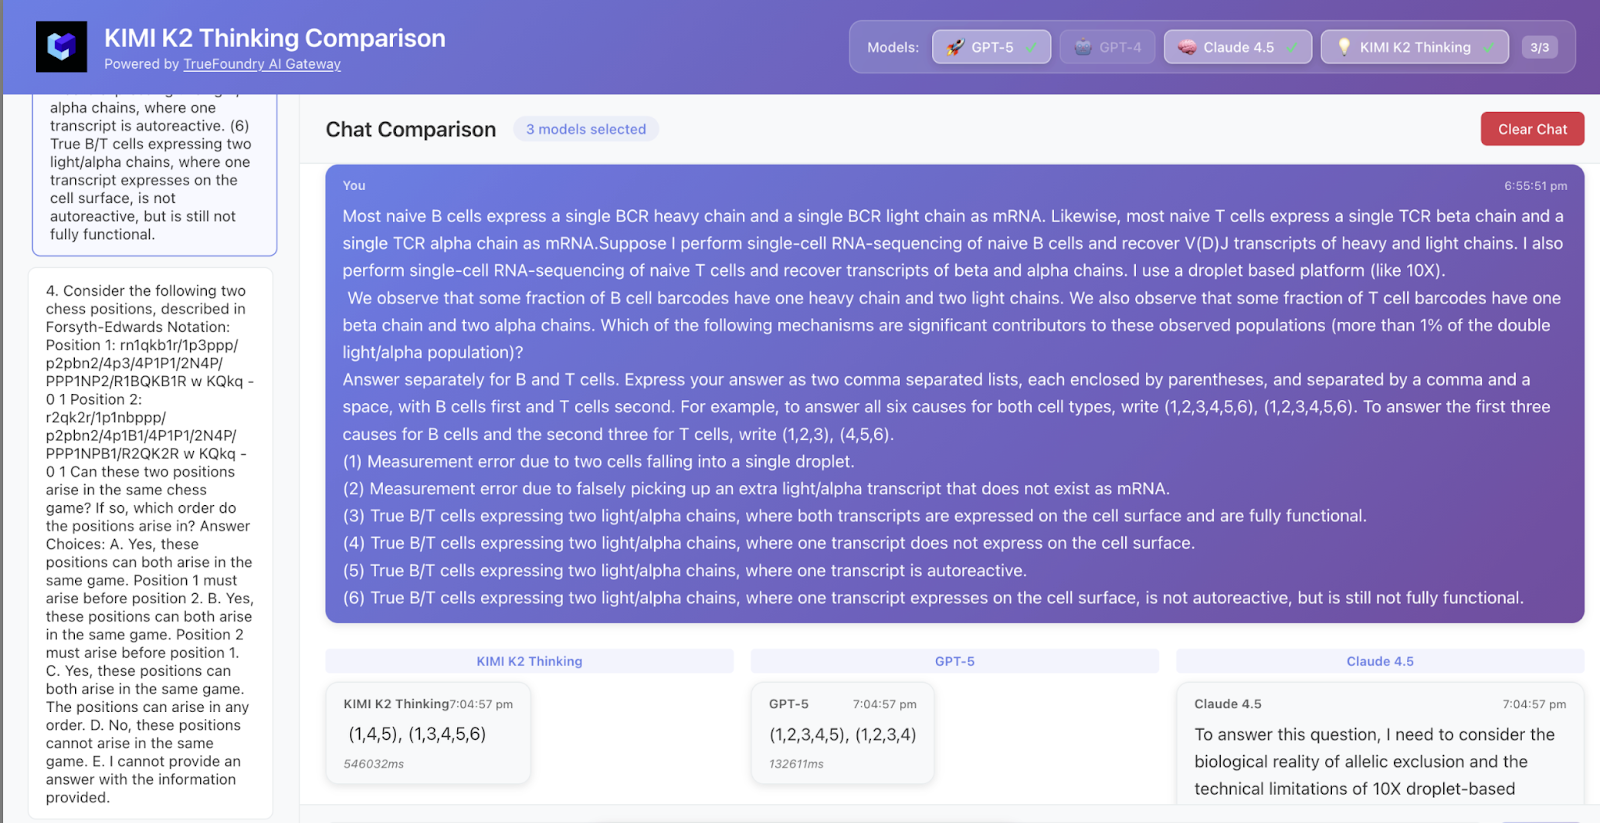
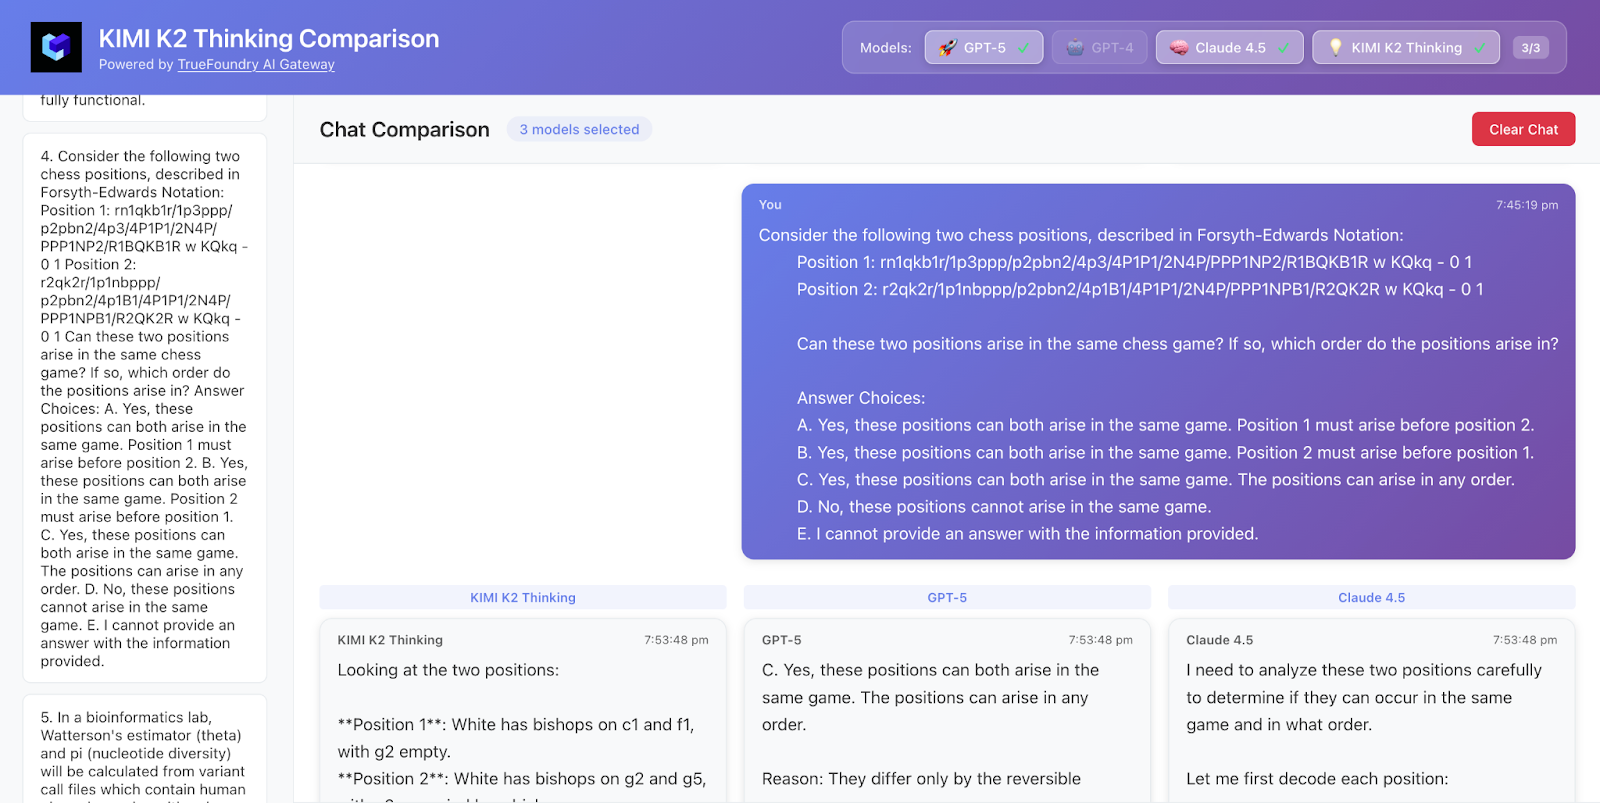
GPT-5は回答のみが正しく、Claudeは正しくなかったのに対し、Kimi K2は回答とロジックの両方が正解でした。
Kimi-K2がツールなし → ツールありでHLEのパフォーマンスを約倍増(約24→45%)させたことは、決定的なポイントを示しています:
簡単に言えば、HLEの向上は、核心的な問題が単なる生のモデルサイズではなく、モデルがどのように推論しツールを使用するかにあることを示唆しています。
ベンチマークを超えて最もエキサイティングなのは、このような機能がいかに身近になりつつあるかということです。実験を開始するのに何ヶ月も待つ必要はありません。ご自身で体験していただけます。 TrueFoundry AI Gateway を使用すると、Kimi-K2 Thinkingやその他の最先端モデルに直接アクセスし、自社のデータでベンチマークを行ったり、ワークフローに統合したりすることが容易になります。
よりパーソナライズされた支援が必要な場合は、デモを予約してください。パフォーマンス、デプロイメントの選択肢、コスト、およびこれらのモデルをご自身のタスクで評価する方法についてチームがご案内します。当社は市場の最新動向を把握し、新しいモデルを可能な限り素早くご利用いただけるよう維持しています。
結論: Kimi-K2 Thinkingは単なるもう1つのLLMではありません。オープンで効率的、ツールを認識し、マルチステップの課題解決にチューニングされた、推論能力を持つエージェントの未来を示す明確な垣間見です。ぜひお試しいただき、ご自身の課題で比較して、エージェント的なツールオーケストレーションが実際のタスクにおいてどれほどの違いをもたらすかをご確認ください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























