



November 16, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
大規模言語モデルの急増は、チームがAI主導のプロダクトを構築する方法を一変させましたが、同時に新たな課題ももたらしました。デベロッパーはモデルのパフォーマンスを監視し、コストを最適化し、プロンプトを洗練させ、大規模環境における信頼性を確保する必要があります。これらすべての動きのある要素を管理するには、あらゆるAPI呼び出しと応答に対する可視性と制御が不可欠です。
Heliconeはこのまさにその課題を解決するために登場しました。OpenAIやAnthropicなどの言語モデルへのリクエストを追跡、分析、最適化する統一プラットフォームを提供し、チームがより迅速にデバッグを行い、運用オーバーヘッドを削減できるよう支援します。
しかし、組織が成長するにつれて、その要件はHeliconeが提供する機能を超えることがよくあります。より深いアナリティクス、オンプレミスデプロイ、またはデータプライバシーに対するより強力なコントロールを必要とする組織もあれば、より高い柔軟性や高度なルーティングロジックを備えたツールを求める組織もあります。
そこで登場するのが、 TrueFoundryのような代替ツールです。エンタープライズAI運用向けに設計されたTrueFoundryの AI Gateway および MCP Gateway は、フルスタックの可視性、マルチモデルルーティング、コンプライアンス第一のインフラストラクチャを提供し、チームがモデルの使用を安全かつ効率的にスケールできるよう支援します。
このガイドでは、Heliconeとは何か、その仕組み、チームが代替ツールを探す理由について説明し、AIインフラストラクチャに適したソリューションを選択するのに役立つトップ5のHelicone代替ツールをレビューします。
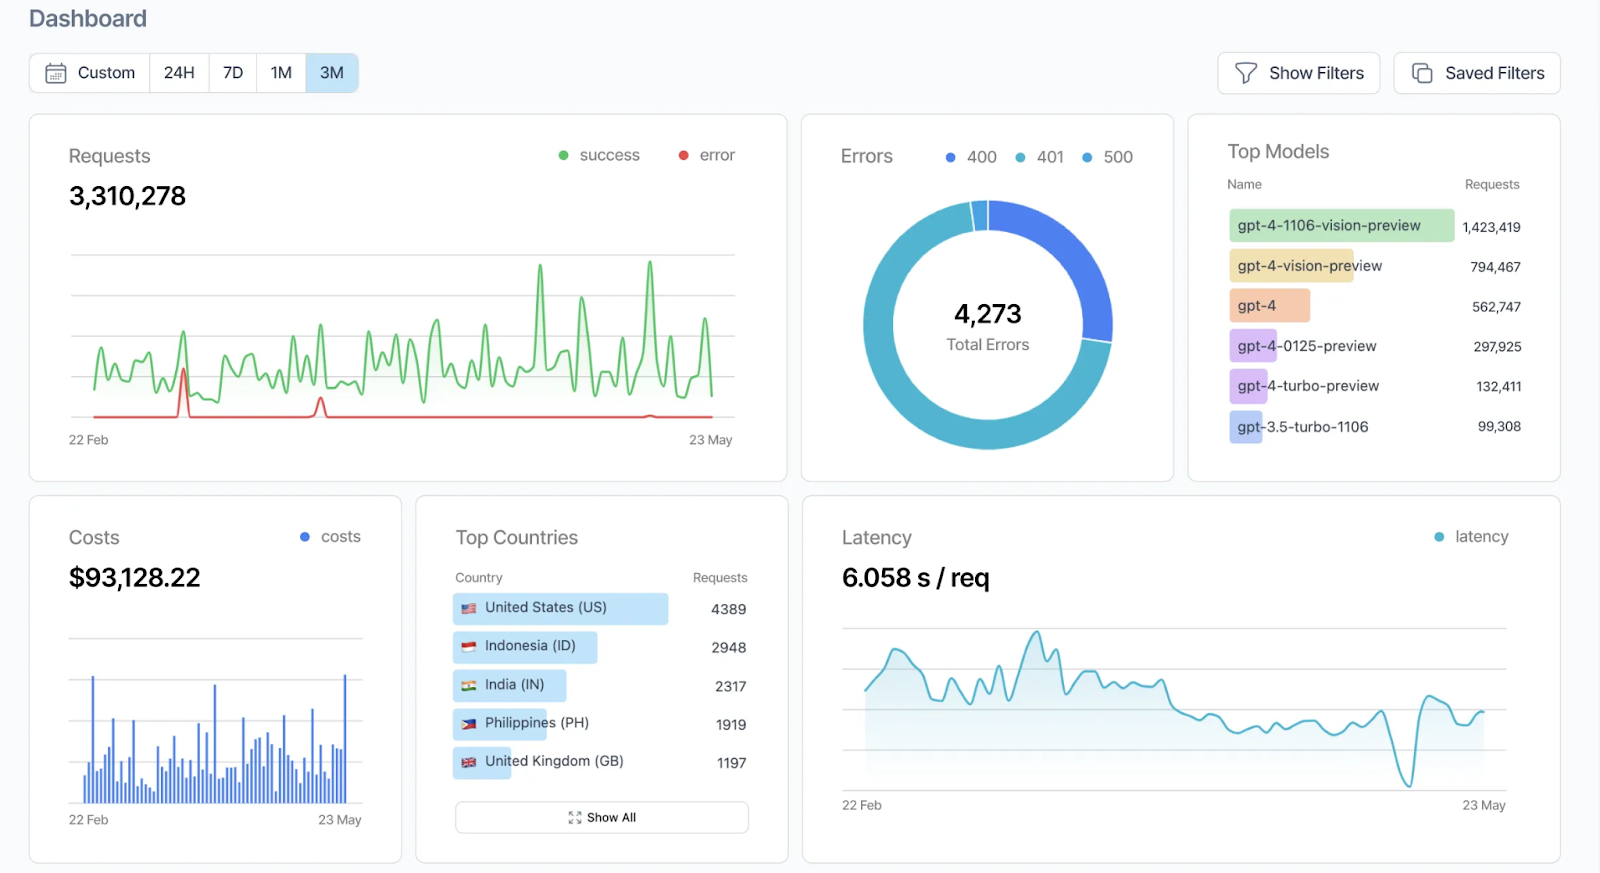
Heliconeは、デベロッパーにAIアプリケーションの完全な制御と可視性を提供するように設計された、オープンソースのLLMオブザーバビリティおよびモニタリングプラットフォームです。高パフォーマンスなゲートウェイとして機能し、OpenAI、Anthropic、Google Gemini、Together AIなどの主要な言語モデルプロバイダーに、単一の統一インターフェースを通じてアプリケーションを接続します。
急速に進化するAIエコシステムにおいて、可視性とトレーサビリティは極めて重要です。Heliconeは、プロンプトや応答からトークン使用量、レイテンシ、コストに至るまで、リクエストのあらゆる詳細を自動的に記録することでLLMの運用を簡素化します。この集中化により、複数のAPIにわたる手動追跡の必要性がなくなり、チームが問題を検知し、パフォーマンスを向上させ、モデルの挙動を精密に最適化するのに役立ちます。
Heliconeの主な機能
コア機能を超えて、Heliconeは強力なオープンソースコミュニティを構築してきました。GitHubで4,000以上のスターを獲得し、数百人のデベロッパーからの貢献を受けて、急速に成長し続けています。透明性と拡張性に重点を置いたコミュニティの姿勢により、ベンダーロックインなしで信頼性を求めるAIエンジニアにとって信頼できる選択肢となっています。
モデルの信頼性向上、運用コストの削減、AIスタック全体のリアルタイムオブザーバビリティの獲得など、目標が何であれ、Heliconeは自信を持ってインテリジェントなアプリケーションを構築、監視、スケールさせるために必要なインフラストラクチャを提供します。
Heliconeは、アプリケーションを100以上の言語モデルプロバイダーに接続する統一APIゲートウェイとして機能します。Heliconeを通じてリクエストをルーティングすることで、デベロッパーは大幅なコード変更を行うことなく、統合を簡素化し、オブザーバビリティを向上させ、モデルのパフォーマンスを最適化できます。
シームレスな統合
Heliconeの統合はシンプルです。デベロッパーは、既存のOpenAIまたはその他のLLM SDKをHeliconeのゲートウェイエンドポイントに向けるように設定するだけです。
このアプローチにより、アプリケーションは一貫したインターフェースを使用して複数のLLMプロバイダーとインタラクトできるようになり、多様なAPIを管理する複雑さが軽減されます。
包括的なオブザーバビリティ
Heliconeは各リクエストの詳細なメタデータを自動的に記録し、デベロッパーにAIワークフローへのリアルタイムのインサイトを提供します。記録されるデータには以下が含まれます。
これらの情報はすべて集中型ダッシュボードから利用でき、チームがパフォーマンスを監視し、ボトルネックを特定し、使用傾向を効率的に分析できるようにします。
インテリジェントルーティングとフェイルオーバー
Heliconeには、リクエストの配信を最適化するインテリジェントルーティングエンジンが含まれています。主な機能は以下の通りです。
このルーティングシステムにより、多様なデプロイシナリオにおいて高い信頼性と一貫したパフォーマンスが保証されます。
パフォーマンス最適化のためのエッジキャッシュ
レイテンシとAPIコストを削減するため、Heliconeはエッジキャッシュを提供しています。頻繁にリクエストされる応答はエッジに保存されるため、より高速な取得が可能になり、冗長なAPI呼び出しを最小限に抑えて、スピードとコスト効率の両方を向上させます。
柔軟なデプロイオプション
Heliconeは、クラウドホスト型とセルフホスト型の両方のデプロイをサポートしています。
どちらのデプロイオプションもSOC 2やHIPAAを含むエンタープライズグレードの標準に準拠しており、セキュリティや規制の厳しい環境に適しています。
ゲートウェイ評価のための主要指標
| 評価基準 | 評価すべきポイント | 優先度 | TrueFoundry |
|---|---|---|---|
| レイテンシ | 最初のトークンまでの時間(time-to-first-token)のp95オーバーヘッドが10ms未満か? | 必須(Must Have) | ✅ サポート済み |
| データレジデンシー | ログを指定のリージョン内(EU/US)に保持できるか? | ユースケースによる | ✅ サポート済み |
| レイテンシベースのルーティング | リアルタイムのレイテンシや障害に基づいて自動的に再ルーティングするか? | 必須(Must Have) | ✅ サポート済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効が可能か? | 必須(Must Have) | ✅ サポート済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効が可能か? | 必須(Must Have) | ✅ サポート済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効が可能か? | 必須(Must Have) | ✅ サポート済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効が可能か? | 必須(Must Have) | ✅ サポート済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効が可能か? | 必須(Must Have) | ✅ サポート済み |

HeliconeはLLMアプリケーションに対して包括的なオブザーバビリティ、ルーティング、ロギングを提供しますが、すべての組織の要件を満たすとは限りません。特にHeliconeとPortkeyの比較で議論されるようなトレードオフを評価する際、柔軟性、コスト構造、または特定の専門機能における制限に対処するために、チームは代替手段を検討することがよくあります。
代替ツールを探す理由の1つは、モデルの多様性と制御性です。Heliconeは100以上のモデルをサポートしていますが、一部の組織では、完全にはサポートされていないニッチなLLMや独自LLMとのネイティブ統合が必要になる場合があります。代替ツールを使用することで、これらのモデルとの統合が容易になったり、より高度なルーティングロジックが提供されたりする可能性があります。
代替ツールを検討する際の主なポイント:
カスタマイズ性とデプロイの柔軟性も要因の1つです。HeliconeはHelmチャートによるセルフホスティングをサポートしていますが、一部のチームはキャッシュ戦略、ロギングフォーマット、またはマルチリージョンデプロイに対するより深い制御を必要としています。コストとスケーラビリティの考慮事項も評価を後押しします。Heliconeはパススルー課金を提供していますが、大量のリクエストを抱える企業や厳格な予算制約を持つ企業は、使用量をさらに最適化できるツールの恩恵を受ける可能性があります。
Heliconeの代替ツールを検討することで、堅牢なLLMオブザーバビリティと信頼性を維持しながら、技術的ニーズ、運用目標、コスト考慮事項により適したソリューションを見つけることができます。
HeliconeはLLMアプリケーション向けに強力なオブザーバビリティとルーティングを提供しますが、すべてのチームの具体的なニーズに適合するとは限りません。デベロッパーは、より高い柔軟性、強化されたアナリティクス、または専門的な統合を得るために、代替手段を検討することがよくあります。
以下の5つのプラットフォームは、大規模言語モデルの監視、トレース、最適化のための信頼できるオプションを提供しており、それぞれ異なるワークフローに適した独自の強みを持っています。
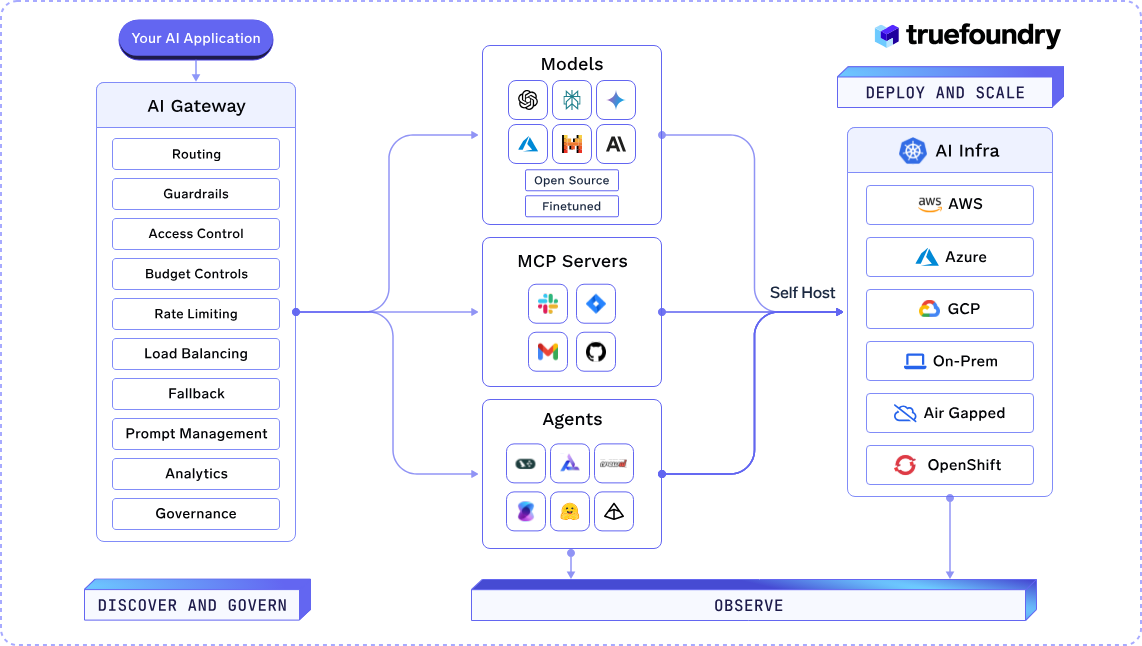
TrueFoundryは、AIアプリケーションを大規模に構築、デプロイ、管理するための統一インフラストラクチャを提供します。AIエージェントのオーケストレーション、モデルデプロイの管理、多様な環境にわたるセキュリティとコンプライアンスの確保のためのツールを提供します。
プラットフォームのコアコンポーネントには、AI Gateway、Model Control Protocol(MCP)サーバー、およびトレース機能が含まれており、それぞれがAIアプリケーションの開発とデプロイにおける特定の課題に対処するように設計されています。
TrueFoundryは、AIのデプロイ、オブザーバビリティ、ガバナンスを1つのスケーラブルなソリューションに統合しているため、業界をリードするエンタープライズプラットフォームとなっています。AI Gateway、MCPサーバー、エンドツーエンドのトレースなどの高度な機能により、組織に完全な制御、セキュリティ、透明性を提供し、大規模な複雑なAIアプリケーションの管理に最適です。
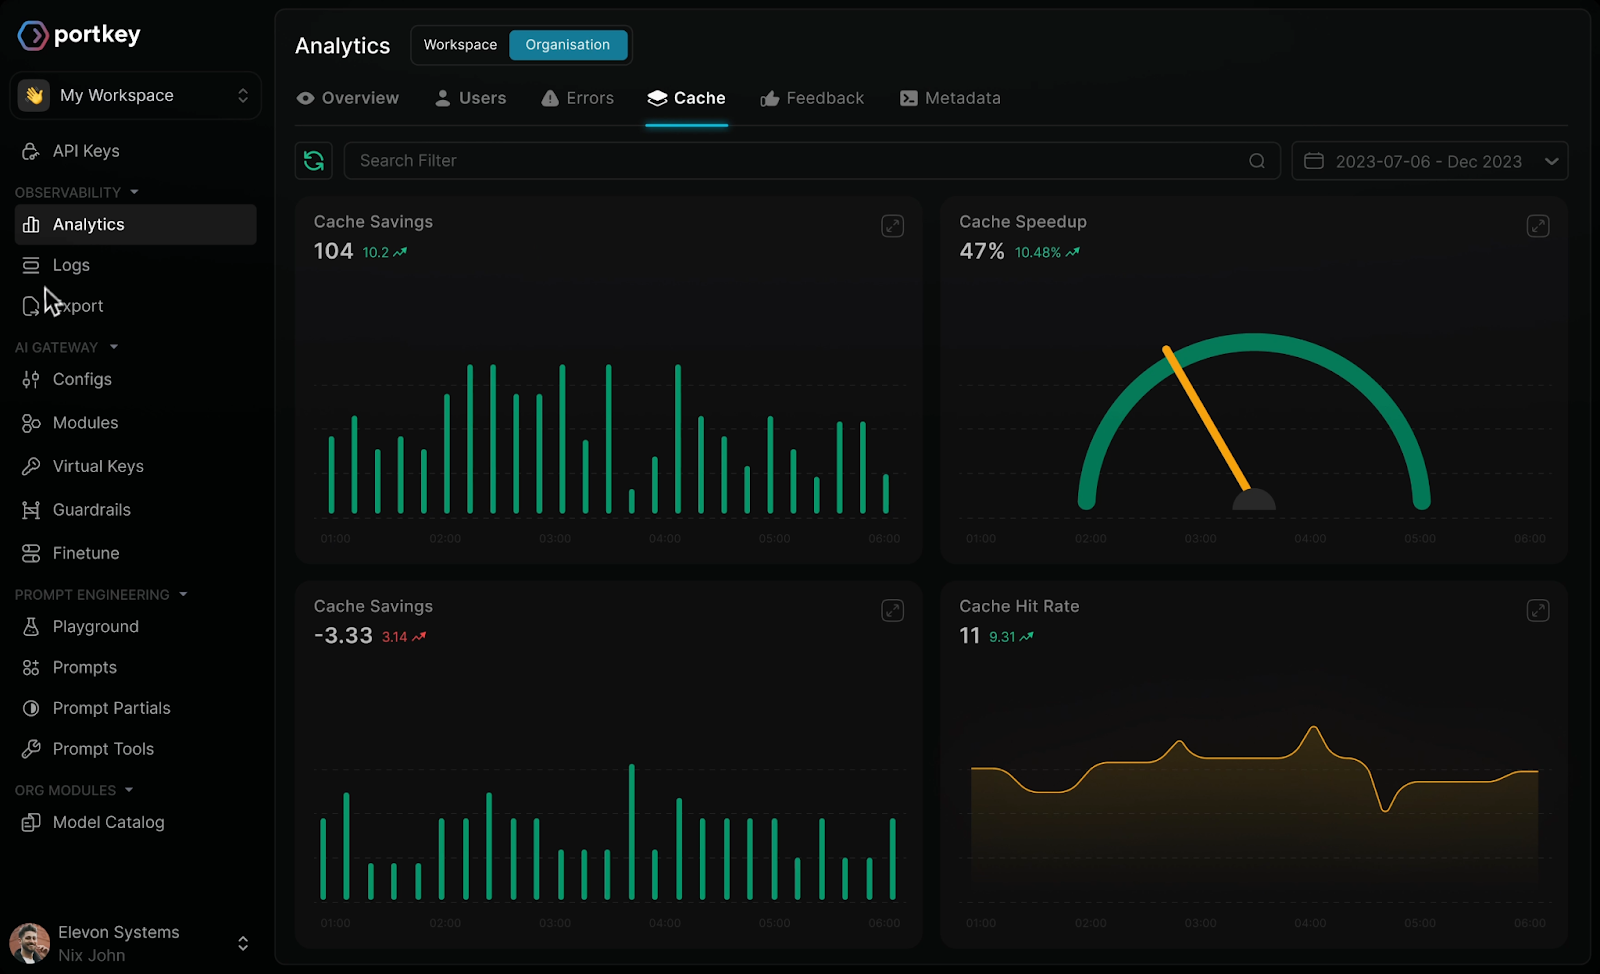
Portkeyは、組織が複数の言語モデルと対話する方法を効率化するために構築されたオープンソースのAIゲートウェイです。プロバイダーごとに別々のAPIを管理する代わりに、デベロッパーはPortkeyを単一のインターフェースとして使用してリクエストを送信し、パフォーマンスを監視し、トラフィックを効率的にルーティングできます。
これにより、ワークフローが簡素化され、複数のモデルを同時に統合・維持するオーバーヘッドが削減されます。
基本的な接続性を超えて、Portkeyは、パフォーマンス、コスト、または定義済みのルールに基づいて、リクエストを自動的に最も適したモデルに送信するインテリジェントルーティング機能を提供します。これは、Portkeyの代替ツールを比較する際にチーム間でよく議論されるポイントです。また、フォールバックメカニズムやリトライもサポートしており、一部のエンドポイントでレイテンシやダウンタイムが発生した場合でも信頼性を確保します。オブザーバビリティはプラットフォームに組み込まれており、リクエストの成功率、レイテンシ、使用パターンに関する詳細なメトリクスが提供されます。
主な機能:
デメリット:
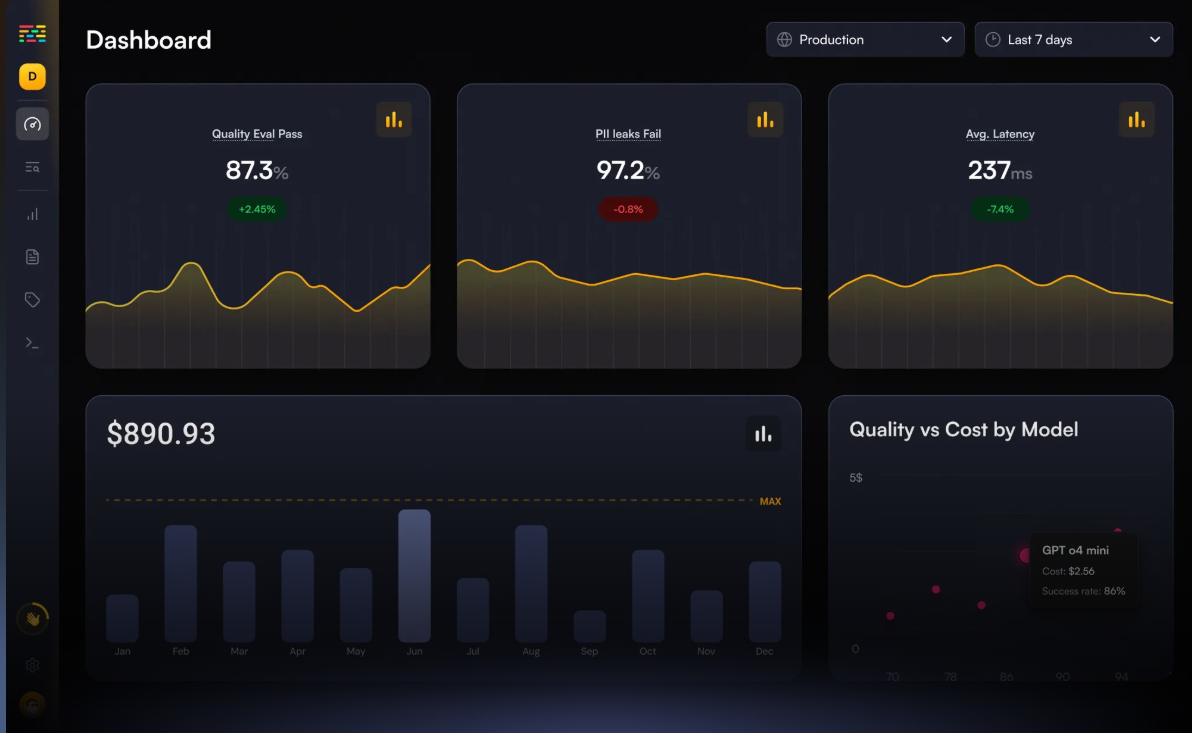
TraceloopのOpenLLMetryは、OpenTelemetry上に構築されたオープンソースのオブザーバビリティフレームワークであり、大規模言語モデルアプリケーションの監視とデバッグに特化しています。モデルのインタラクションとパフォーマンスに関する深いインサイトを提供し、効果的なトラブルシューティングと最適化を促進します。
主な機能:
デメリット:
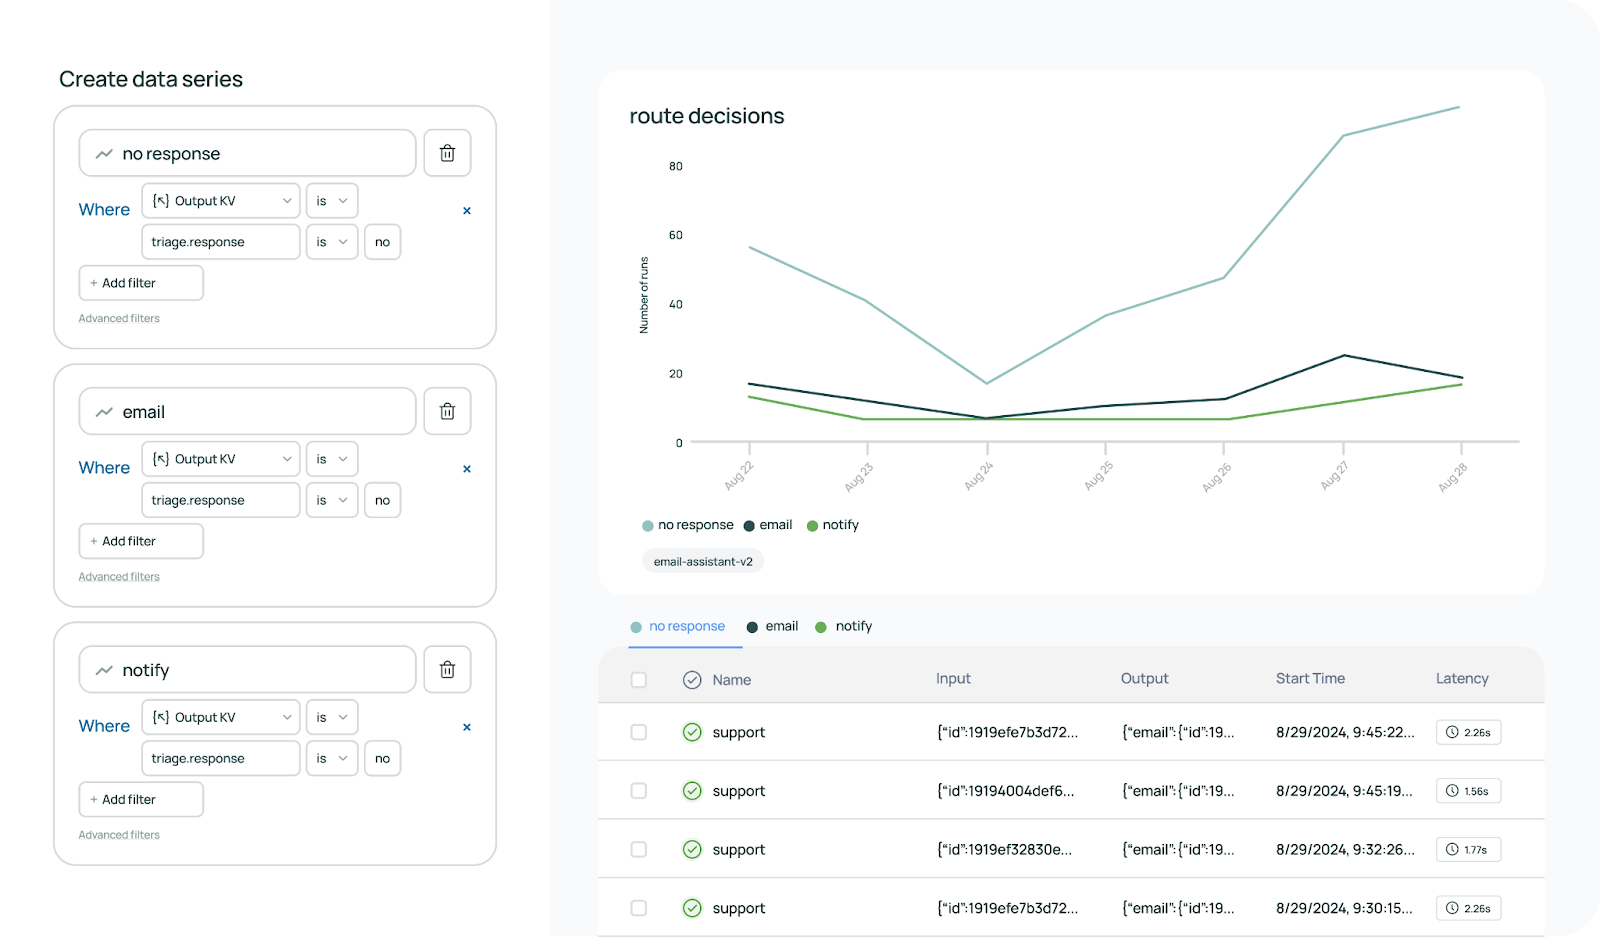
LangSmithは、LangChainコミュニティによって開発された、大規模言語モデルアプリケーション向けの統一オブザーバビリティおよび評価プラットフォームです。AIワークフローのトレース、監視、分析を行うツールを提供し、デバッグとパフォーマンスの最適化を強化します。
主な機能:
デメリット:
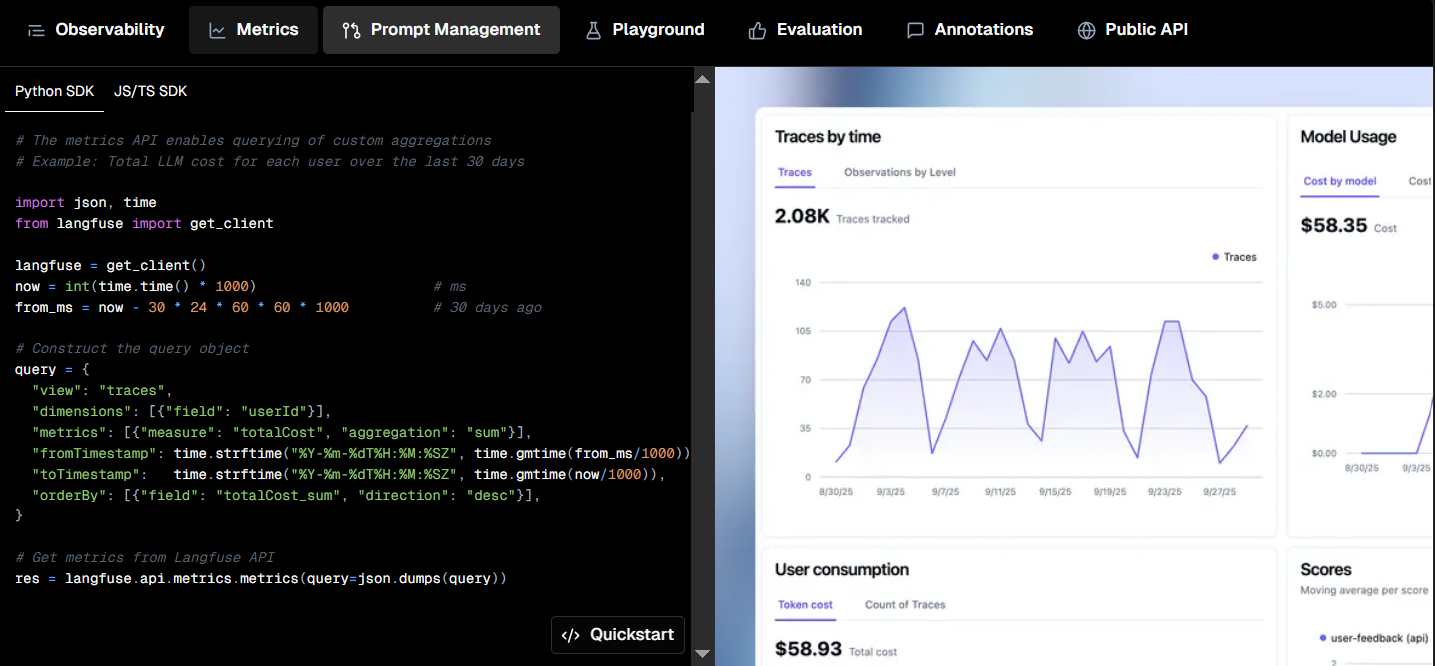
Langfuseは、大規模言語モデルアプリケーションのオブザーバビリティとアナリティクスに焦点を当てたオープンソースプラットフォームです。チームがAIワークフローをトレース、分析、最適化できるようにし、モデルのインタラクションとパフォーマンスに関する深いインサイトを提供します。
主な機能:
デメリット:
Heliconeは、LLMのオブザーバビリティ、ルーティング、アナリティクスのための強力なオープンソースプラットフォームを提供しており、AIアプリケーションの包括的な監視を求めるチームにとって強力な選択肢となります。ロギングを集中化し、トークン使用量を追跡し、複数のモデルプロバイダーにわたるインサイトを提供する機能は、信頼性の高いLLMベースのシステムを構築する際の運用の課題を簡素化します。
しかし、AIアプリケーションがより複雑になるにつれて、組織は特定のワークフロー、デプロイ環境、または統合ニーズに対応するソリューションを必要とすることがよくあります。Heliconeの代替ツールを検討することで、チームは自社の技術的・運用要件により適したプラットフォームを選択できます。たとえば、TrueFoundryは高度なAI GatewayおよびMCPサーバー機能を備えたエンタープライズグレードのオーケストレーション、トレース、ガバナンスを提供しており、セキュリティ、コンプライアンス、スケーラビリティを優先する組織に最適です。
Portkeyは多様なモデルへの統一APIアクセスとルーティングに優れており、TraceloopはOpenTelemetryベースのトレースを通じて深いオブザーバビリティを提供します。LangSmithはLangChainアプリケーション向けに専用の評価とデバッグを提供し、Langfuseは非同期オブザーバビリティのための詳細なロギングとアナリティクスを提供します。
適切なLLMオブザーバビリティプラットフォームの選択は、デプロイの柔軟性、モデルのサポート、監視の深さ、コスト効率などの要因によって異なります。
各オプションの機能、強み、制限事項を評価することで、開発チームは実際のプロダクションワークロード全体でパフォーマンス、セキュリティ、信頼性を維持する、堅牢で透明性が高くスケーラブルなAIシステムを導入できます。
エンタープライズ規模に対応する最高のHelicone代替ツールには、TrueFoundry、Portkey、Traceloopがあります。Heliconeが軽量なオブザーバビリティに重点を置いているのに対し、TrueFoundryは統合されたAI Gatewayとセキュリティ機能を備えた統一インフラストラクチャを提供します。LangfuseやLunaryなどの他の注目すべきオプションは、プロダクションアプリケーション向けの深いアナリティクスや専門的な評価ツールを必要とするチーム向けに、オープンソースのトレースを提供しています。
基本的なプロキシ監視を超えて成長し、エンタープライズグレードのガバナンスが必要になったときに、チームは移行を検討することがよくあります。Heliconeは、強力なRBAC、監査ロギング、およびマルチステップのエージェント型ワークフローに対する深いサポートの欠如によって制限されることが頻繁にあります。TrueFoundryのようなプラットフォームに移行することで、プライベートVPC内でのデプロイが可能になり、プロダクション規模のAIシステムを管理するために不可欠な高度なコスト管理ポリシーが提供されます。
はい、著名なオープンソースの代替品にはPortkey、Langfuse、Traceloopなどがあります。これらのプラットフォームでは、セルフホスティングが可能で、既存のOpenTelemetryパイプラインとのより深い統合が行えます。シンプルなPythonベースのプロキシを求めているデベロッパーには、マネージドSaaSプロバイダーのオーバーヘッドやデータリスクなしに、何百ものモデル間でAPI呼び出しを標準化するLiteLLMがコミュニティで人気を集めています。
はい、Heliconeはその統一APIを通じて基本的なマルチモデルルーティングとプロバイダーフェイルオーバーをサポートしています。ただし、エンタープライズゲートウェイに見られるような、メタデータを意識した高度なルーティングロジックはありません。TrueFoundryのようなプラットフォームは、チームが複雑なフォールバックチェーンやチームレベルのクォータを定義できるようにすることでこの機能を拡張し、商用モデルプロバイダーとセルフホスト型モデルプロバイダーの両方にわたって高い利用可能性を確保します。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























