GoogleがGemini 3で「あらゆるものを計画する(Plan anything)」 と謳い、MoonshotがKimi-K2 Thinkingこそが新たな推論SOTA であると主張し、xAIがGrok-4を「世界で最も知的なモデル」と呼び、OpenAIがGPT-5.1を推進し続ける中、何が現実で何が単なる宣伝(バイブス)なのかを見極めるのは困難です。
ベンチマークチャートの箇条書きを並べる代わりに、より絞り込んだ疑問を投げかけてみましょう。
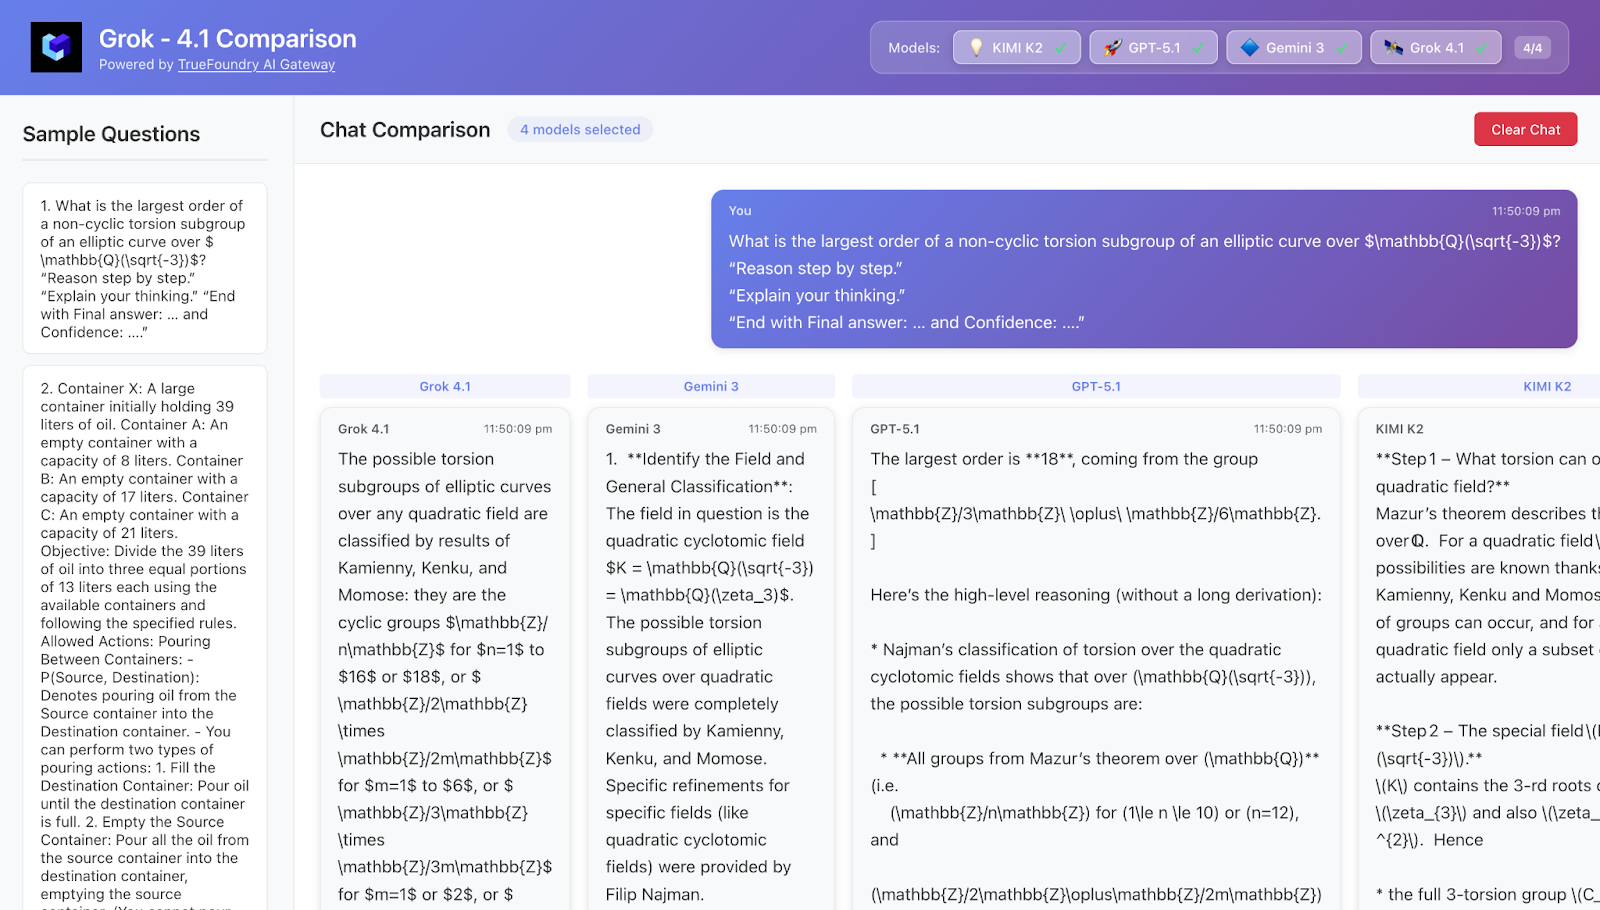
Gemini 3、Kimi-K2 Thinking、Grok-4.1、GPT-5.1に、Humanity’s Last Exam形式の問題セットを解かせ、彼らがどのように 思考するかを実際に観察するとどうなるでしょうか?
本記事の構成:
なぜHumanity’s Last Exam (HLE) が学術ベンチマークの「ラスボス」となったのか。 「思考型」モデルとしてのGemini 3、Kimi-K2 Thinking、Grok-4.1、GPT-5.1 の概要。 数学、マルチモーダル物理学、ロングコンテキスト科学、ゲーム理論、プランニングにわたる5つの具体的なHLEスタイルのケーススタディ 。 TrueFoundry AI Gatewayを介してご自身で同じ実験を実行する 方法。 1. 2分でわかるHumanity’s Last Exam MMLUのようなベンチマークは、最先端(フロンティア)レベルでは基本的に「やり尽くされた」状態です。多くのトップモデルが90%以上を記録しているため、モデル間で±1%の差があっても、実際の業務でどう機能するかについての情報価値は高くありません。
Humanity’s Last Exam (HLE) はそれらとは異なります。
数学、自然科学、工学、経済学、人文学、法学など にわたる、専門家によって厳選された試験です。多肢選択式と完全一致式 の問題が混在しており、その多くは直感的ではない複数の推論ステップを必要 とします。問題の大部分はマルチモーダル であり、モデルはテキストと画像を結合して推論することを余儀なくされます。 重要な点として、今日の最高のモデルでさえ、HLEにおいては人間の専門家レベルからは程遠く 、その確信度(Confidence)のキャリブレーション(自己評価の正確さ)も著しく欠けていることが多い点です。 著者らは、HLEが長期的に有用なベンチマークであり続けることを望んでいるため、生の問題を再公開しないよう 明示的に求めています。そのため、本記事では:
オリジナル問題の原文は掲載しません 。 代わりに、5つの代表的な「HLEスタイル」のタスク と、それらに対するモデルの振る舞いを説明します。 公開されているHLEデータセットや、ご自身のドメインからの同様の問題を使用して、これらのパターンをご自身で再現できます。
2. 2025年における4つの「思考型」モデル ここでは単なる「チャットボット」を比較しているのではなく、深い思考の連鎖(CoT)、ツール利用、ロングコンテキスト、プランニングといった、明示的に推論エンジン として訴求されているモデルを検討します。
Gemini 3 (Pro + Deep Think) GoogleはGemini 3 をこれまでで最も機能的なモデルとして発表しています:
Gemini 2.5世代よりも強力な推論力 とマルチモーダル理解力 。 ツールなしのHLEで競争力のあるスコアを記録し、GPQA、MMMU-Pro、Video-MMMUなどの推論ベンチマークでも優れたパフォーマンスを発揮。 長期タスクやツール呼び出しを実行するエージェントへの強いこだわり:Vending-Benchのようなプランニングベンチマークでのトップ成績を含む「Plan anything」の実現。 また、Gemini 3は、困難な問題に対してより多くの計算リソースとトークンを費やし、さらなる精度を引き出すDeep Think モードを備えています。
Kimi-K2 Thinking MoonshotのKimi-K2 Thinking は、オープンウェイトの「思考型」モデルです:
巨大な総パラメータ予算を持ちながら、トークンあたりのアクティブサブセットを小さく抑えたMixture-of-Experts(MoE)アーキテクチャ。 長大なコンテキスト(数万〜数十万トークン)と、設計段階からの非常に重厚なChain-of-Thought(思考の連鎖) 。 公開分析では、Kimi-K2 Thinkingとその「Heavy」バリアントが、HLEやその他の推論ベンチマークでトップまたはそれに近い位置につけていることがよく示されています。 1つの数学問題に対してモデルが何ページにもわたる内部モノローグ を吐き出すのを見たことがあるなら、それがKimiスタイルの特徴です。
Grok-4 / Grok-4.1 xAIのGrok-4 シリーズは以下のようにアピールされています:
ネイティブなツール使用とWeb検索を備えた、非常に高性能な推論 モデル。 HLE、GPQA、およびエージェントが多くのステップにわたって一貫した行動を維持しなければならない長期的タスクにおいて強力。 Grok-4.1では「感情的」およびクリエイティブな知性に重点が追加されましたが、中核となる推論の強みは維持されています。 Grok-4.xは、本気でエージェント になろうとしているモデル(計画、検索、行動、反省、反復)と考えると捉えやすいでしょう。
GPT-5.1 (GPT-5 ファミリー) OpenAIのGPT-5 ファミリーは、多くの人々が基準とするベースラインです:
コーディング、推論、マルチモーダル、ロングコンテキストなど、広範なベンチマークスイートで非常に強力。 高い「推論努力(reasoning effort)」/「思考(thinking)」モード で実行すると、より多くのトークンと計算を割り当てて難問に対応し、HLEやGPQAなどの高度なベンチマークでの差を縮める傾向があります。本記事では、その高負荷プロファイルで実行されるGPT-5バリアントをGPT-5.1 Thinking と呼びます。
3. 比較方法(HLEをリークせずに) ここでの目標は、別のリーダーボードを作ることではなく、これらのモデルがHLEスタイルのタスクでどのように 振る舞うかを観察することです。
全体的なアプローチ:
代表的なHLE問題 (数学、マルチモーダル物理、長文科学論文、ゲーム理論、プランニング)のセットを選定。各問題に対して、一貫した「試験モード」プロンプト を使用:「ステップバイステップで推論してください。」 「あなたの思考プロセスを説明してください。」 「最後に『Final answer: …』および『Confidence: …』で締めくくってください。」 以下にわたって、まったく同じ問題とフレームワークを実行:Kimi-K2 Thinking Grok-4.1 GPT-5.1 Thinking Gemini 3 Pro (および利用可能な場合は Gemini 3 Deep Think ) これらすべてはTrueFoundry AI Gateway を経由して接続されました:
OpenAI、Google、xAI、Moonshot、および1000以上のその他のモデルをプラグインできる単一のルール・エンドポイント。 コールごとの応答、トークン、レイテンシ、コストをログに記録する1つの統合環境。 ベンダーをまたぐアクセス制御(Auth)、クォータ、ガードレールの一元設定。 これについては後ほど詳しく説明します。まずは5つのケーススタディを見ていきましょう。
4. ケーススタディ 1 – 高度な数学:精度 vs トークン消費型の思考 タスク 大学院レベルの数学問題(数論 / 組合せ論など):
単一の短い解答(整数または単純な数式)。 約4〜6個の直感的ではない推論ステップが必要。 実際に解き進めなければ正解を当てるのは極めて困難。 観察ポイント
モデルが構造を正しく設定 できているか(適切な定理/分類の適用など)? 符号(マイナス記号など)を落とさずに最後まで推論を実行できるか? そこに到達するまでにどれだけのトークン を消費するか? 確信度のキャリブレーション (自己評価)は適切か? 観察された典型的なパターン
Kimi-K2 Thinking 非常に長いChain-of-Thought:関連する定理を呼び出し、複数のアプローチを探索し、しばしば分岐やバックトラックを行います。 特に「Heavy」モードでは精度が非常に高いものの、他のモデルよりも著しく多くのトークンを消費することが多い。 自己報告による確信度は、非常に繊細な問題であっても90〜100%になることがよくあります。 Grok-4.1 大胆で探索的:直感的な答えを素早くスケッチし、それを正当化しようと試みます。 正解したときは素晴らしいパフォーマンスを示しますが、間違っているときは非常に 自信満々に誤ることがあります。 GPT-5.1 Thinking 優れた構造化:ケースを明確に枚挙し、ラベルを付け、綺麗に参照し直します。 特に問題が複数の深い事実を必要とする場合、確信度の見込みはやや控えめになる傾向があります。 Gemini 3 (Pro / Deep Think) マルチステップの推論を行いますが、Kimi-K2の長文テキストに比べると著しく簡潔 です。 Deep Thinkモードは、説明をある程度控えめに保ちながら、Kimi/GrokとのHLEスコアの差の多くを埋めます。 結論 HLEスタイルの数学で1点でも多くのスコア を追い求めるなら、Kimi-K2 ThinkingとGrok-4.xがリードしており、Gemini 3 Deep Thinkがそれに肉薄しています。純粋な精度と同様にコストとスピード も重視する場合は、Gemini 3とGPT-5.1 Thinkingが、トークン消費を抑えながら同様の結果を達成できるため魅力的です。
5. ケーススタディ 2 – マルチモーダル物理学:「実際に図を見る」 タスク 図を多用した物理 / 工学の問題:
回路図、力行図(フリーボディダイアグラム)、または光学設定が画像として組み込まれています。 問題は数値解(電流、角度、時間など)を求めています。 図を適切に解析 しなければ正解できません。 観察ポイント
モデルは画像に一致する方法で図を説明 できているか? 画像に存在しない前提 を作り出していないか? 画像とテキストをどれだけうまく一貫した導出プロセスに統合できているか? 観察された典型的なパターン
Gemini 3 画像そのものに対して非常に緻密:「矢印は左を指している」「直列の抵抗が3つある」「質量は2つのバネで接続されている」など。 図の内容に関するハルシネーション(誤認)が少ない。 全体として、マルチモーダル推論において最もグラウンディング(根拠に基づいた思考) ができている印象を与えます。 GPT-5.1 Thinking 強力なマルチモーダル理解力を持ちますが、説明が明示的でないことが多く、図を正しく使いつつも詳細に説明しない場合があります。 失敗する場合、画像ではなくテキストの読み誤りに起因することが多いです。 Kimi-K2 Thinking 与えられた条件が正しければ、物理の展開は堅実です。 しかしプレッシャー下では、図の要素(コンポーネントの数など)を数え間違え、そのエラーを長大な導出プロセス全体に波及させてしまうことがあります。 Grok-4.1 スタイルの面ではGPT-5.1に類似:直感的で正解することも多いですが、誤解した線やラベルに対して過度に自信を持つことがあります。 結論 HLEスタイルのワークロードに図面、回路図、視覚的パズル が多く含まれる場合、Gemini 3のマルチモーダルスタックが頭一つ抜けています。GPT-5.1、Kimi-K2、Grok-4.1も能力は高いものの、存在しない詳細を「見てしまう」傾向がやや強くなります。
6. ケーススタディ 3 – ロングコンテキスト科学:解くだけでなく、読むこと タスク 高密度で長文の科学的文章(生物学 / 医学 / 化学):
実験、方法、結果、注意事項を説明する複数の段落。 最後の段落だけでなく、文章全体から情報を統合 することを要求する問題。 観察ポイント
モデルは文章を正確に要約 できているか? 段落をまたいで変数、条件、例外事項 を把握し続けられているか? 問題に回答するために実際に重要な 詳細を正確に特定できているか? 観察された典型的なパターン
Gemini 3 長い文章を非常に焦点を絞った箇条書き に圧縮するのが得意。 主要な事実を再確認した上で、「メモから」回答へと導く傾向があります。 文章の前の部分を参照する際に矛盾を来すことがめったにありません。 GPT-5.1 Thinking 変数や実験設定の追跡に優れており、丁寧なティーチングアシスタント(TA)のように機能します。 多くの場合、最も洗練された「読む → 要約する → 推論する」パイプラインを提供します。 Kimi-K2 Thinking 極めて詳細:文章の多くを反復し、背景理論を再導出することもあります。 その深さは有用ですが、純粋な長さゆえに、時折論理のブレや内部矛盾が忍び込むことがあります。 Grok-4.1 実践的な示唆 (「これは〜の場合に治療法Aが望ましいことを示唆している」など)の抽出に非常に長けています。テキスト内で言及されている稀なエッジケースをたまに見落とすことがあります。 結論 HLEスタイルの「これを読んで実際に理解せよ」 という問題では、Gemini 3とGPT-5.1 Thinkingが特に強力です。これらは的確に要約し、重要な詳細を保持し、論理の一貫性を保ちます。Kimi-K2とGrok-4.1も優秀ですが、記述が長くなることで論理がブレる機会が増える可能性があります。
7. ケーススタディ 4 – ゲーム理論とミクロ経済学:誰がTAのように推論するか? タスク ミクロ経済学 / ゲーム理論の問題:
複数のプレイヤー、小さな行動セット、利得の記述。 均衡の特定、戦略の特性評価、または福祉結果の比較が求められます。 観察ポイント
モデルは関連するすべてのケースを網羅 できているか? ケース分析から最終回答まで論理の一貫性を保てているか? 混合戦略、支配、対称性などの微妙な点に留意できているか? 観察された典型的なパターン
Kimi-K2 Thinking 大学院生のTA(助手)のように読み取れます:ケースごとの分析、反例の明示的な構築、エッジケースの注意深い検討が盛り込まれます。 思考プロセス全体を確認したい場合に非常に強力です。 Grok-4.1 インセンティブ推論 (「プレイヤーAが逸脱するとXを得るため、これは均衡になり得ない」など)の直感に優れています。早い段階で直感的な均衡に囚われ、再考を促す必要がある場合があります。 GPT-5.1 Thinking 体系的:ケースにラベル(ケース1、ケース2…)を付け、結果を要約し、それらをスムーズに結びつけます。 深さと簡潔さのバランスが優れています。 Gemini 3 構造はGPT-5.1に似ていますが、特にDeep Thinkモードでは明示的に追考する傾向(「〜という前提を再考してみましょう」)がやや強くなります。 結論 ゲーム理論的HLE問題では、Kimi-K2 Thinking とGrok-4.1 が最も人間のTAに近いフィーリングを提供し、明示的なケース分析と直感的な議論を多用します。Gemini 3 とGPT-5.1 は迷うことなく回答に到達するため、出力をコードや意思決定パイプラインに直接流し込む場合に適しています。
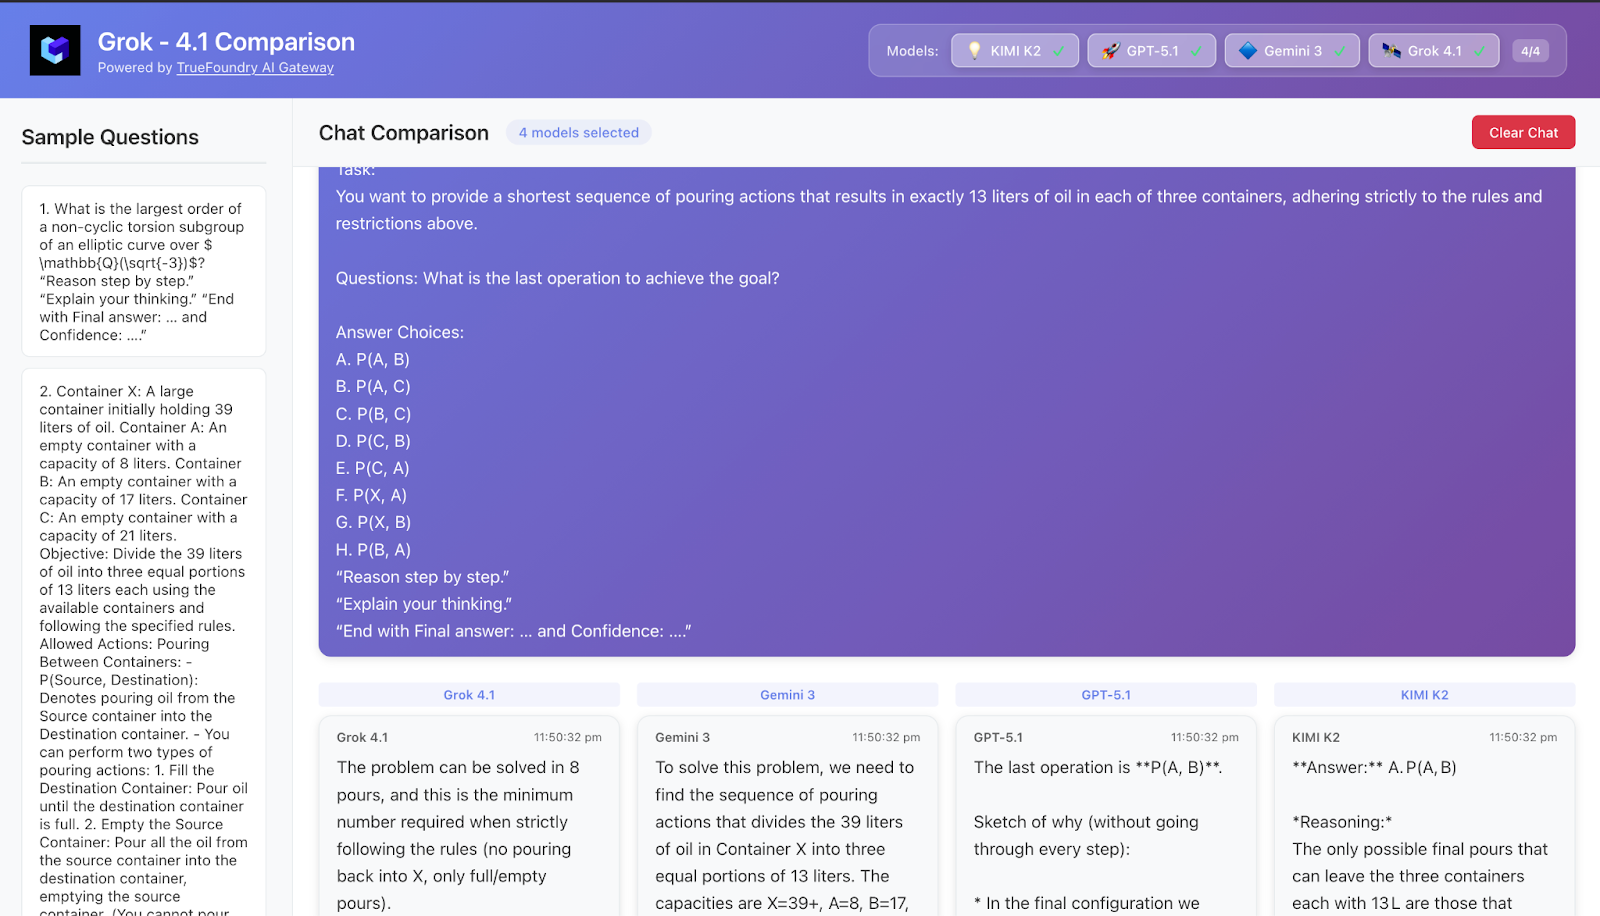
8. ケーススタディ 5 – プランニング問題:プロンプト内部のミニエージェント タスク プランニング / オペレーションズ・リサーチ形式のパズル:
複数のコンテナ、容量、注ぎ出しのルール、またはスケジューリング/在庫管理の設定。 制約のもとで最小ステップ で目標に到達するポリシーまたはアクションシーケンスを選択する必要があります。 観察ポイント
モデルは状態空間を明確に設定 できているか? 以前のアクションを忘れることなく、正確にシーケンスをシミュレートできているか? 自身が記述した制約を守り続けているか? 観察された典型的なパターン
Grok-4.1 非常にエージェント的:状態を明示的に書き出し(「ステップ3の後:在庫はX, Y, Z」)、それぞれを目標と照らし合わせ、必要に応じて軌道修正します。 単一のプロンプト内で本物のプランニングエージェントを使用している感触に最も近いです。 Gemini 3 同様のプランニングスタイル:目的と制約を言い換え、方針を提案し、いくつかのステップをシミュレートします。 長いシーケンスにわたって状態を見失わない 点に長けており、これは長期タスク/ Vending-Benchでの強みと一致しています。 GPT-5.1 Thinking 概念的な計画は優れていますが、多くのステップにわたる計算や記録の細かいミスが発生しやすい傾向があります。 「最短シーケンス」の保証を求められた際、再試行が必要になることがあります。 Kimi-K2 Thinking 詳細なシミュレーションを多く提供しますが、長いCoTと複雑な状態の組み合わせにより、ステップ間で数量がいつの間にか変わってしまうような小さな不整合が生じることがあります。 結論 プランニング要素を含むHLEタスクにおいて、Grok-4.1 とGemini 3 は最も信頼できるミニエージェントとして機能します。Kimi-K2とGPT-5.1も極めて有能ですが、状態追跡が重要な場合、その長大な推論プロセスが裏目に出ることがあります。
9. 結局… Humanity’s Last Examを「制する」のは誰か? HLEの表面的なパーセンテージ だけを見れば、現在Kimi-K2 Thinking(特にHeavyバリアント)と一部のGrok-4構成がトップまたはそれに近い位置にあり、Gemini 3 Deep Think がそれに続き、GPT-5 Pro がわずかに下に位置しています。
しかし、HLEは良い意味で一筋縄ではいきません:
正解率は依然として人間の専門家レベルを大きく下回っています。 確信度の調整(キャリブレーション)がうまくいっていないことが多く、モデルは非常に 自信満々に酷い 間違いを犯すことがあります。 領域(数学 vs 科学 vs プランニング vs 人文学)によって勝者が異なります 。 5つのケーススタディから得られた見解:
Kimi-K2 Thinking 性能を最後の一滴まで絞り出すために、トークンコストやレイテンシを支払ってでも最大限の思考の深さ を求めたい場合に最適。 Grok-4.1 プランニングやエージェント的な推論 で真価を発揮。タスクがシミュレーションやマルチステップのビジネス上の意思決定に似ている場合、非常に自然に機能します。GPT-5.1 Thinking 強力で安全なデフォルト。優れた長文読解力、全般的に整った構造を持ち、既存システムへの統合が非常に容易。 Gemini 3 (Pro + Deep Think) マルチモーダル推論 、構造化された読解 、およびプランニング において特に魅力的。「Plan anything」の謳い文句は単なるマーケティングではなく、長大な状態保持を伴う問題の処理能力に表れています。Humanity’s Last Examに唯一の絶対的な勝者は存在しません。「最適な」モデルとは、実際の制約下で、あなたの実際のタスクにおいて最も失敗が少ない モデルのことです。
10. TrueFoundry AI Gatewayを通じた実行方法 内部的な仕組みとして、4つの別々のインテグレーションを構築したわけではありません。すべてはTrueFoundry AI Gateway (truefoundry.com/ai-gateway )を経由して実行されました:
OpenAI (GPT-5.1)、Google (Gemini 3)、xAI (Grok-4.x)、Moonshot (Kimi-K2)、その他数百のモデルを運用するための単一のエンドポイント 。 一元化された可視性(Observability) :ベンダーを横断してプロンプト、応答、トークン、レイテンシ、エラーのログを取得。 組み込みのガバナンスとセキュリティ :RBAC、監査ログ、自社クラウドやオンプレミス環境にデータを保持するデプロイオプション。 実験の側面からは、以下を意味します:
評価ハーネスをGatewayに1度接続するだけで完了。 gpt-5.1-thinking、kimi-k2-thinking、grok-4.1、gemini-3-pro、gemini-3-deep-thinkを単なる異なるモデルID として登録。 それらの切り替えは新しいSDKの統合ではなく、1行の設定変更で実現。 11. 自社の「Last Exam」でGemini 3(およびその他のモデル)を試す 本記事の観察パターンを再現(あるいは検証)したい場合:
テスト用の問題(Exam)を選定する。 HLEを使用するか、研究開発の質問、サポートチケット、コードレビュー、インシデント事後分析など、自社ドメインのデータから内部用試験を作成します。 複数のモデルで実行する。 評価パイプラインをTrueFoundry AI Gatewayに向け、Gemini 3、Kimi-K2 Thinking、Grok-4.1、GPT-5.1 Thinkingにわたって同じプロンプトを実行します。 1つの場所で比較する。 正確性、推論の質、トークン使用量、レイテンシ、コストを並べて確認します。 自社の タスクにおいて、どの「思考型」モデルが真に合格点に値するかを判定します。2025年において、本当に重要となるベンチマークはHLE、MMLU、GPQAではなく、自社の実務に即した試験だからです。1つの ゲートウェイの背後に4つのモデルを接続し、結果に語らせることができるため、単一のモデルを無条件に信じ込む必要はありません。
よくある質問(FAQ) Kimi K2とGemini 3の違いは何ですか? GoogleのGemini 3は、Deep Thinkモードによるマルチモーダル理解と強力なツール呼び出し機能に重点を置いています。オープンウェイトモデルであるKimi-K2 Thinkingは、長大なコンテキスト対応と詳細なChain-of-Thought(思考の連鎖)推論で知られています。Kimi K2とGemini 3を比較することで、高度なAI問題解決に対するアプローチの違いが明らかになります。
Kimi K2 Thinkingの最適なユースケースは何ですか? Kimi-K2 Thinkingは、複雑な推論や深い問題解決タスクに最適です。長大なコンテキストと設計段階からの重厚なChain-of-Thoughtを備えたKimi K2は、高度な数学問題やHumanity's Last Examのようなベンチマークなど、広範な内部モノローグを必要とする課題に長けており、しばしばトップモデルとして評価されます。
Gemini 3とGPT-5はどちらが優れていますか? 当社のブログでは、Humanity's Last Exam におけるパフォーマンスを評価することで、Gemini 3 と GPT-5.1 を深く比較検証しています。「どちらが優れているか」は、具体的な推論タスクやモデルの挙動によって異なることが分かりました。当社の AI Gateway を通じて実施された TrueFoundry の分析では、各モデルの独自の領域における問題解決アプローチを明確にしており、お客様の AI ソリューションに最適なモデルを選択するのに役立ちます。
Gemini 3 vs Grok-4: どちらのモデルがより優れているか? Gemini 3 と Grok-4 を比較すると、どちらも強力な推論エージェントとして優れており、Humanity's Last Exam のような複雑なタスクで高いパフォーマンスを発揮します。Gemini 3 は高度なマルチモーダル理解と Deep Think モードを特徴とする一方、Grok-4 はネイティブなツール利用とエージェント機能に重点を置いています。最適なパフォーマンスは、多くの場合、特定のタスク要件に依存します。
推論タスクに最適な AI モデルはどれか? 複雑な推論タスクにおいて、Gemini 3、Kimi-K2 Thinking、GPT-5.1 などのモデルは高い能力を発揮します。当社のブログでは、各モデルがさまざまな課題に対してどのように機能するかを評価し、それぞれの具体的な強みを理解するのに役立つ情報を提供しています。Gemini 3 vs Kimi-K2 Thinking vs GPT-5.1 を比較する際の最適な選択肢は、最終的にはプロジェクト固有の要件と必要とされる推論の種類によって決まります。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.