



November 6, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
決済APIのオブザーバビリティを確保するのは簡単です。なぜなら、単調だからです。同じ入力が同じコードパスを生成するため、リクエストレート、エラー率、処理時間の3つの数値でほぼすべてを把握できます。障害が発生した場合はスタックトレースを確認します。スタックトレースはプログラムの意図に関する推測ではなく、事実です。
エージェントはその前提をすべて覆します。モデルが実行時にパスを選択するため、同じ入力が同じコードパスを生成することはありません。多くの場合、エラーすら発生しません。エージェントは処理を完了してテキストを返し、実行されたすべてのHTTP呼び出しは200を返します。そして、何が問題だったかは、通常クラッシュではなく意思決定にあります。間違ったツールを選択したり、取得済みのファイルを再読み込みしたり、絶対に成功しない検索を何度も再試行したりすることです。
そのため、問題は「稼働していたか」ではなく「なぜそれを実行したのか」へとシフトします。そして「なぜ」は単一のリクエストのプロパティではなく、シーケンス全体に属するプロパティです。これこそが、ダッシュボードが正常に見えても agent が失敗する理由です。すべてのモデル呼び出し全体の P99 レイテンシーが 900 ms であることは、それを 140 回行った実行について何も教えてくれません。
データには 4 つの入れ子状のレベルがあり、下位の 2 つだけが従来のリクエストのように見えます。
中央の 2 つのレベルに価値が存在しますが、これらはリクエストスコープのトレーサーがモデル化しないまさに 2 つのレベルです。トレーサーは意味のある親を持たないアウトバウンド呼び出しのばらつきを認識するのみで、呼び出し 11 から 27 が同じことを 7 回試行する 1 つの turn であったかを判別できません。
分散トレーシングとこれを真に区別する 1 つの特性は、任意のレベルがループし得るということです。通常のサービスグラフにはこれに相当するものはありません。A が B を呼び出し、B が C を呼び出す構造において、A が自身を呼び出すことがあればそれはバグです。agent においては、ステップが再度自身を呼び出すと判断するのが正常なケースであり、生産的なループとスタックしたループを区別する唯一の方法はシーケンスを読み取ることです。
各レベルには独自のシグナルが必要です。あらゆる場所ですべてを収集するとインサイトのないデータが生成されるため、以下は投資に見合う最小限の項目です。
最後のセルは、エージェントの可観測性において最も収益性の高いシグナルでありながら、ほとんど誰も記録していません。「1ターン内で同じツールが同じ引数で2回呼び出された場合はループである」ということです。引数がスパン上にあれば些細なことですが、集計メトリクスから把握するのは不可能です。
本番環境におけるインシデントのほぼすべては、次の3つのパターンに集約されます。
1. サイレントリトライループ。 エージェントがナレッジベースを検索し、有用な情報を得られず、言い換えて再度検索する — これを20回繰り返します。すべての検索は300 msでステータス200を返すため、リクエスト率やエラー率のダッシュボードにはわずかなトラフィックの増加しか表示されません。しかしセッションレベルでは一目瞭然です。ターン数が1、ツール呼び出し回数が20、所要時間が2分となります。原因の診断は単一のスパンにあるのではなく、反復そのものにあります。
2. ゴミを返しながら成功するツール。 ドキュメント取得ツールが権限の壁に突き当たり、HTMLのログインページをボディに含む丁寧な200を返します。モデルはそれを読み取り、該当するポリシーは存在しないと報告します。どこにもエラーは発生していません。これを捉える唯一の方法は、生の結果(raw result)を記録することです。だからこそ、単なるステータスコードではなく、結果のキャプチャが必須条件(table stakes)となるのです。
3. 40倍コストの実行。 セッションコストの中央値が$0.04であるのに対し、ある1つのセッションが$1.60かかり、しかも何も失敗していませんでした。単一のステップが大きなファイルをコンテキストに再読み込みし、そのファイルがそれ以降のすべてのターンに引き継がれ、実行の残りの部分で入力トークンが複利的に増加しました。これを見つけるには、セッションをコスト順に並べ替え、外れ値のターンごとのトークン数をステップの変化が見えるまで確認します。平均値からは絶対に分かりません。
これら3つすべてに共通するパターンは、異常がステップ間の関係性にあるということです。ステップを独立して保存するツールは、まさに必要とする情報を捨ててしまっています。
これは、エージェントコードにインストゥルメンテーションを施すことなくキャプチャ可能です。なぜなら、制御(enforcement)と観測が1つの場所で行われるからです。すべてのモデルおよびツール呼び出しはゲートウェイを経由するため、その配信の副産物として軌跡が記録されます。分散したログから再構築する必要も、ログの取得を無効化(オプトアウト)されることもありません。
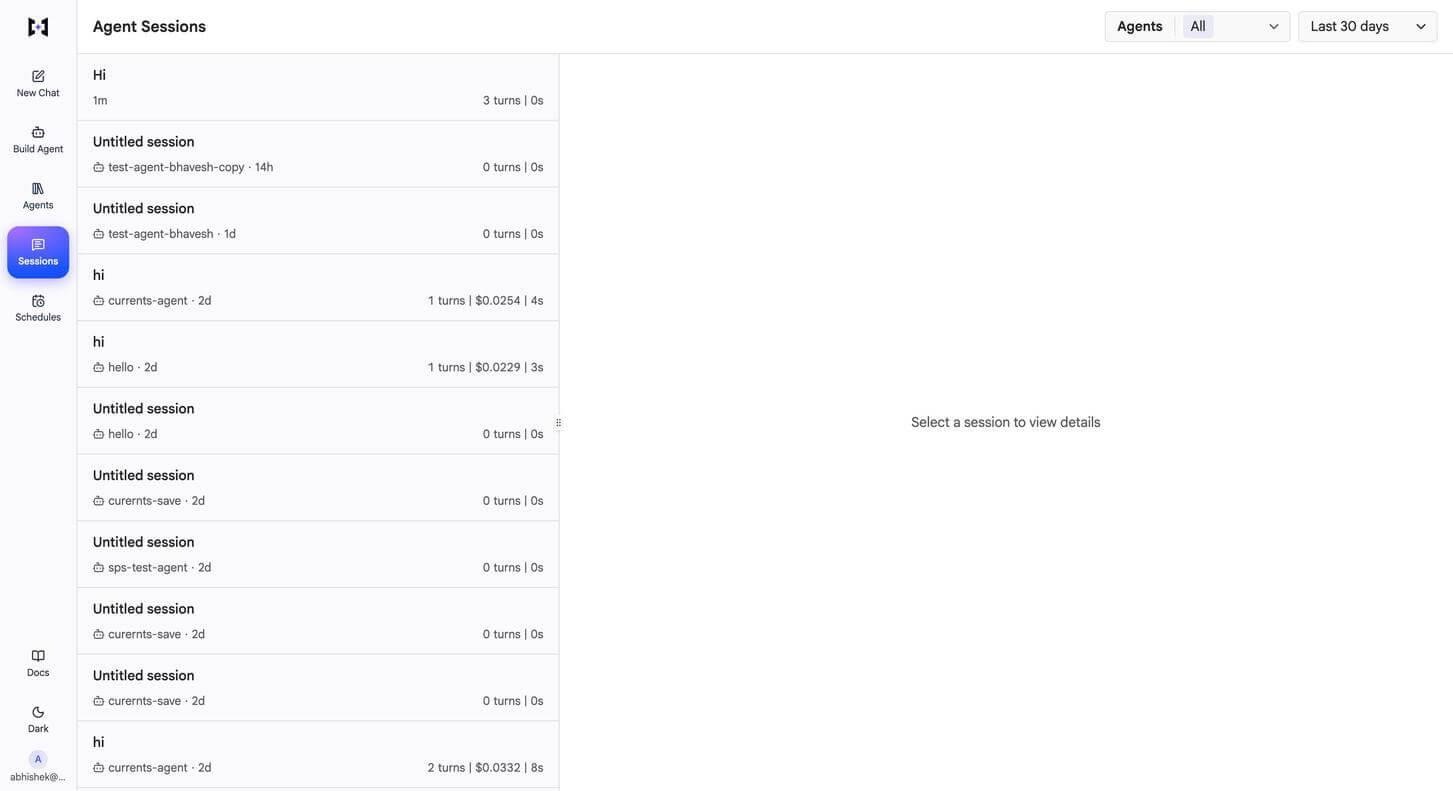
TrueFoundryのエージェントハーネス上のエージェントにおいて、Sessionsはすべてのエージェントにわたるすべての会話(開始メッセージ、エージェント、ターン数、コスト、所要時間)を一覧表示します。何も開かずに、高コストまたは長すぎる実行をスキャンするのに十分であり、これこそが障害モード3で必要な機能です。
セッションを開くと、階層が要求する3つの要素すべてが表示されます。集計メトリクスは、ターン、所要時間、コスト、トークン、コンテキスト、ツール呼び出し、サブエージェント、エラーをカバーします。イベントタイプのタイムラインは、実行をターンごとにシステム、ユーザー、モデル、ツール呼び出しのセグメントに分解します。ツール呼び出しの色が支配的なターンはツール処理依存、モデルの色が支配的なターンはモデル処理依存となり、計算することなく一目で確認できます。その下にはトランスクリプトがあり、ターンごとのトークン、所要時間、コスト、そしてツール呼び出しを結果とともに順序通りに一覧表示する折りたたみ可能なagent stepsパネルが配置されています。
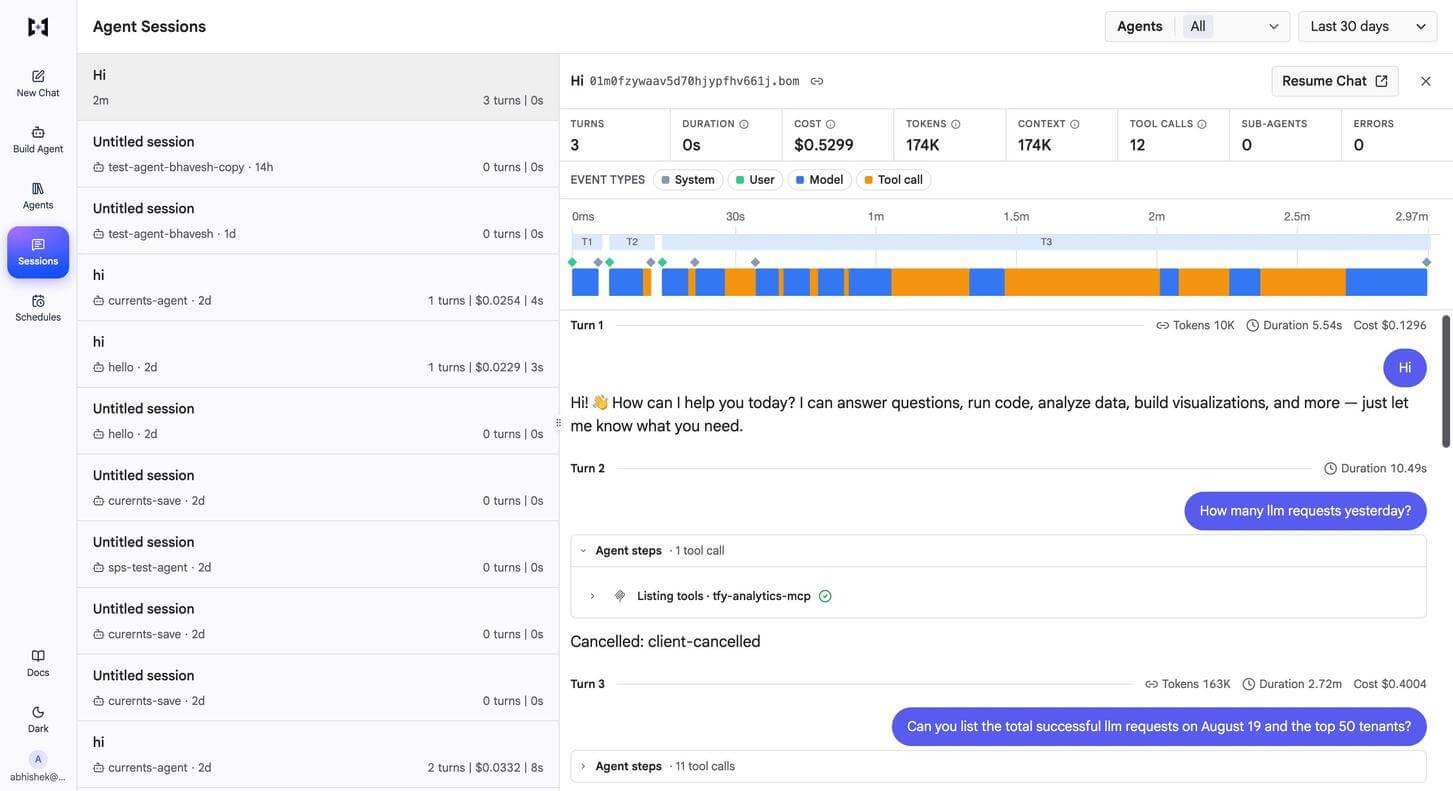
この順序付きステップリストこそが、キャンセルされたターン、失敗しているMCPサーバー、または空のツール結果が視覚化される場所です。セッションは同じビューからライブチャットとして再開でき、修正を確認する手段となります。
1つ下のレベルでは、トレースはフラットなログではなく、完全なスパン階層となっています。PIIガードレールがアタッチされた単一のchat completionは、5つのスパンを生成します。親を持たないChatCompletionルート、その下のGuardrailスパン、その下のガードレールのアウトバウンド呼び出し、Modelスパン、そしてその下のモデルのアウトバウンド呼び出しです。
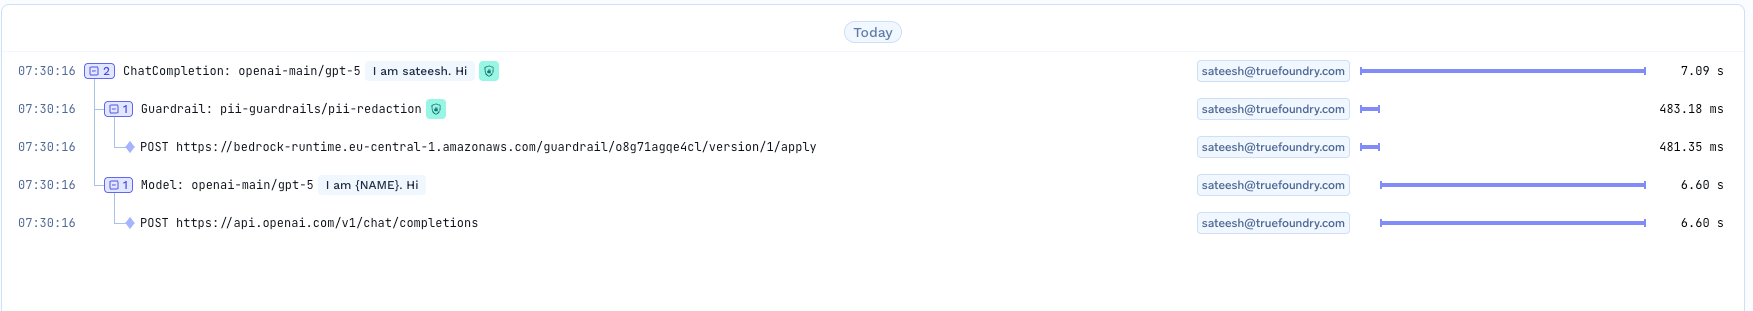
スパン属性により、コストとレイテンシは推測ではなく属性として特定可能になります。ルートスパンには、tfy.input、tfy.output、tfy.triggered_guardrail_fqnsとともに、tfy.model.metric.cost_in_usd、input_tokens、output_tokens、latency_in_ms、time_to_first_token_in_ms、inter_token_latency_in_msが保持され、すべてのスパンにそれを作成した主体が記録されます。スパンはクエリ可能です。trace_idsフィルターと時間ウィンドウを指定してclient.traces.query_spans(...)を実行すると、階層全体がページネーション表示で返されます。これが、「このセッションが高コストだった」から「このスパンが高コストだった」へと掘り下げる方法です。
ガードレールの実行は、result、latency、findingsを持つ独自のスパンとして表示され、ブロックされたリクエストもトレースされます。拒否された呼び出しはギャップではなくエビデンスです。
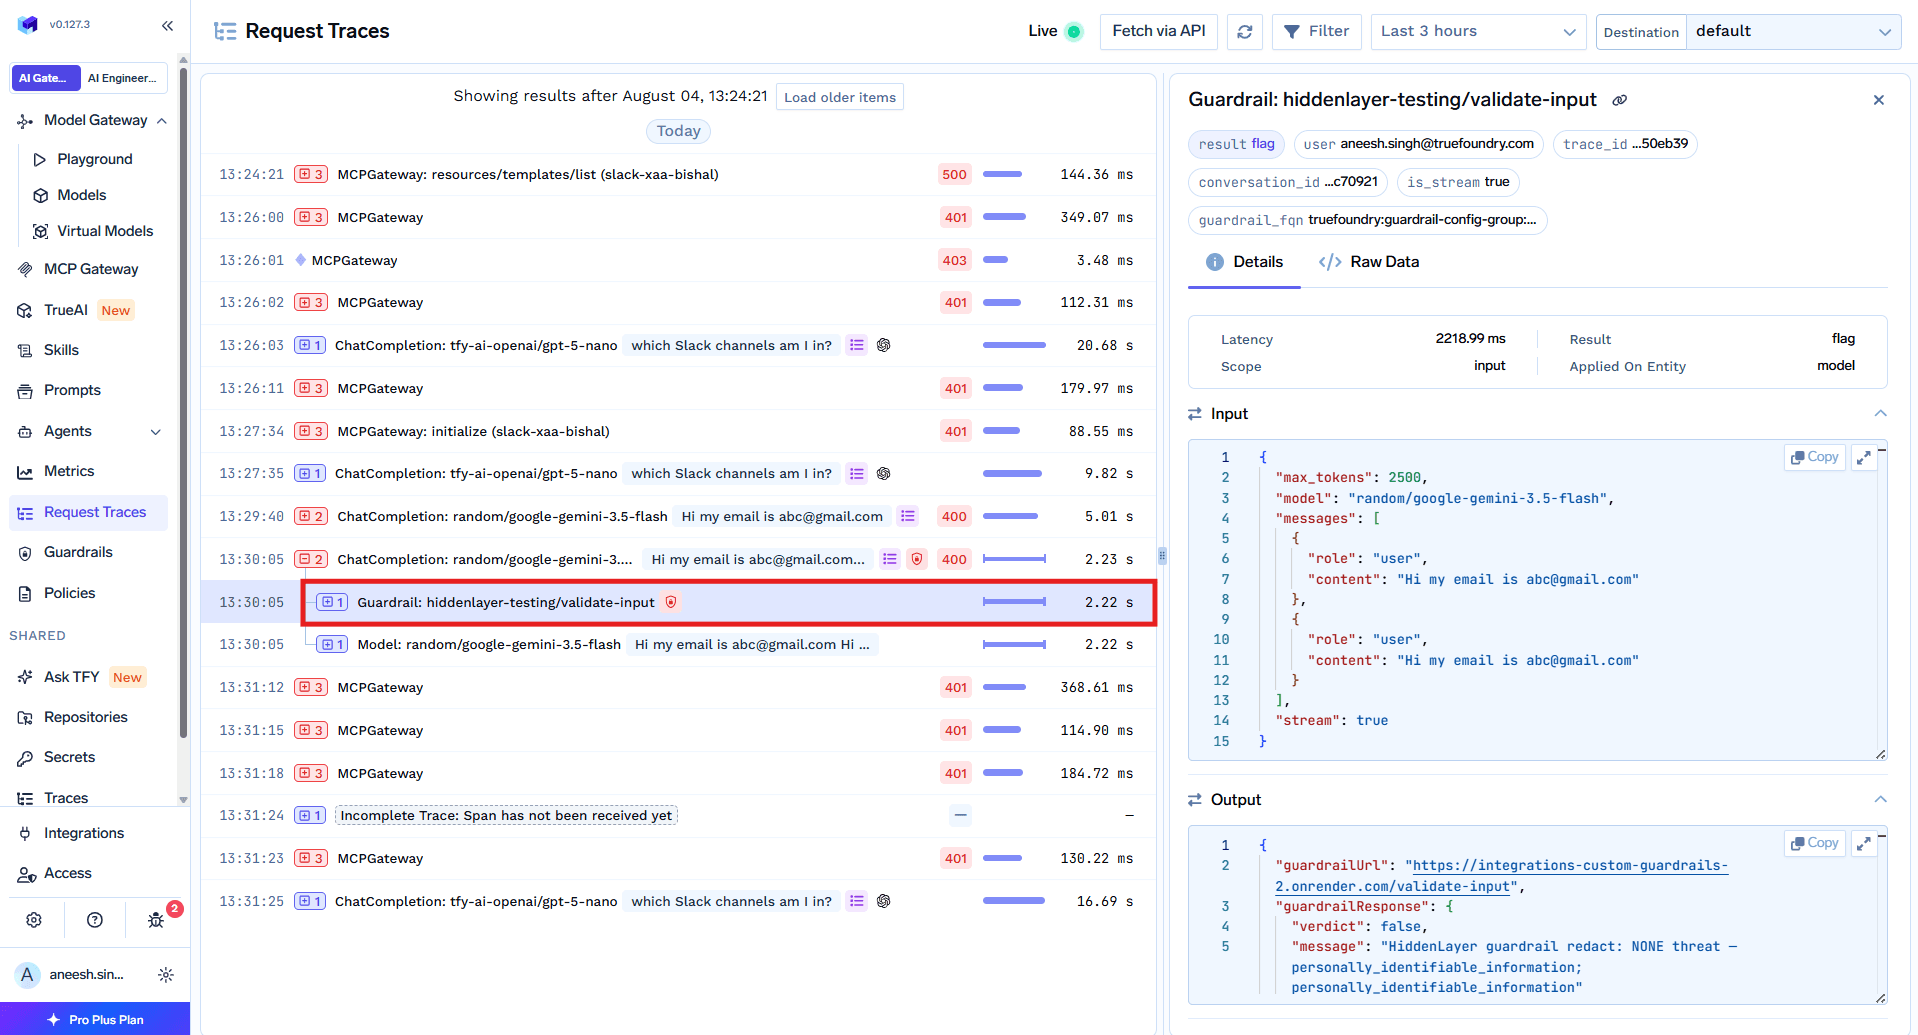
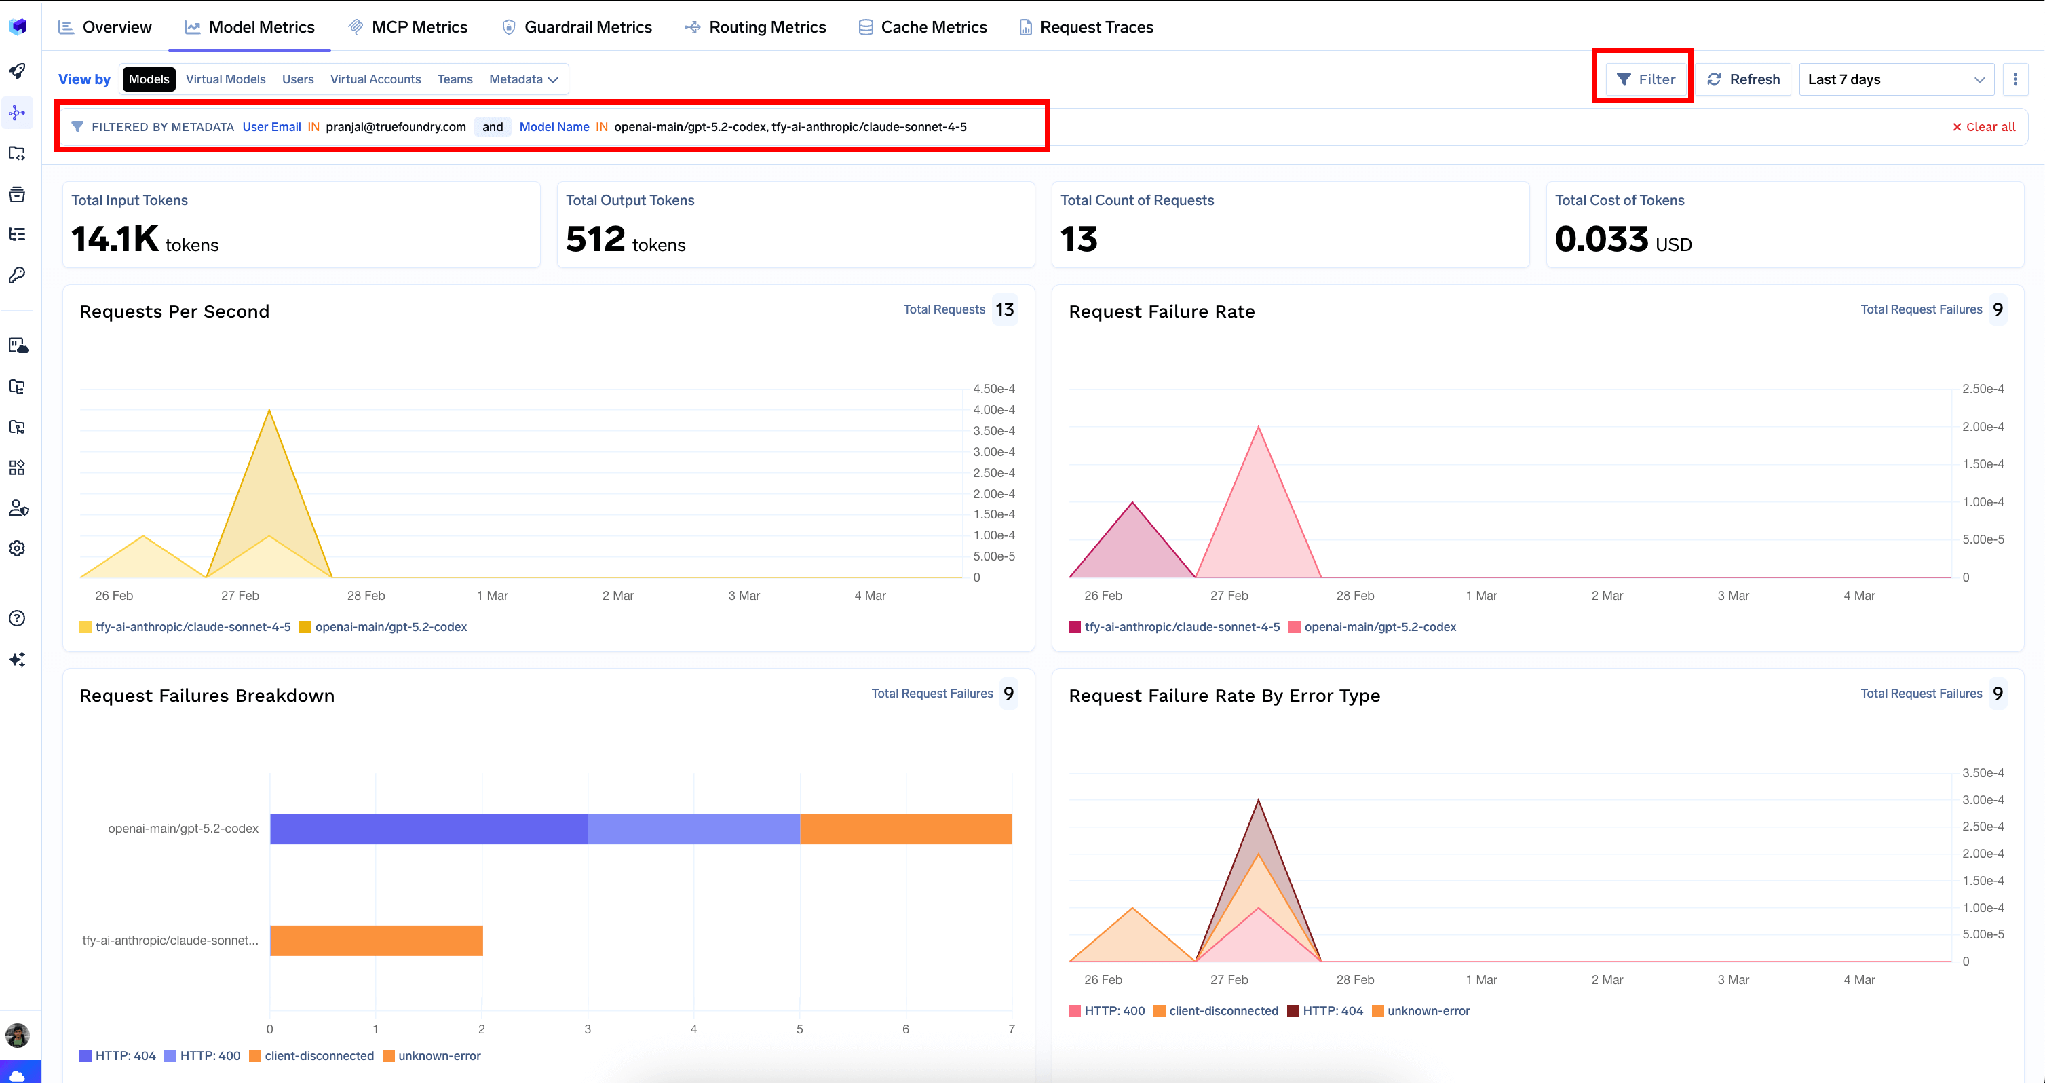
集計はMetrics Dashboardに表示されます。Model Metricsには、入力および出力トークン、リクエスト数、総コストに加えて、スループット、失敗率、エラータイプごとの失敗の内訳が含まれます。レイテンシは、エンドツーエンドのレイテンシ、最初のトークンまでの時間、トークン間レイテンシ、出力トークンあたりの時間の4つの指標にわたり、P50、P75、P90、P99で測定されます。これは、最初のトークンの遅延とトークンストリームの遅延では原因が異なるため重要です。
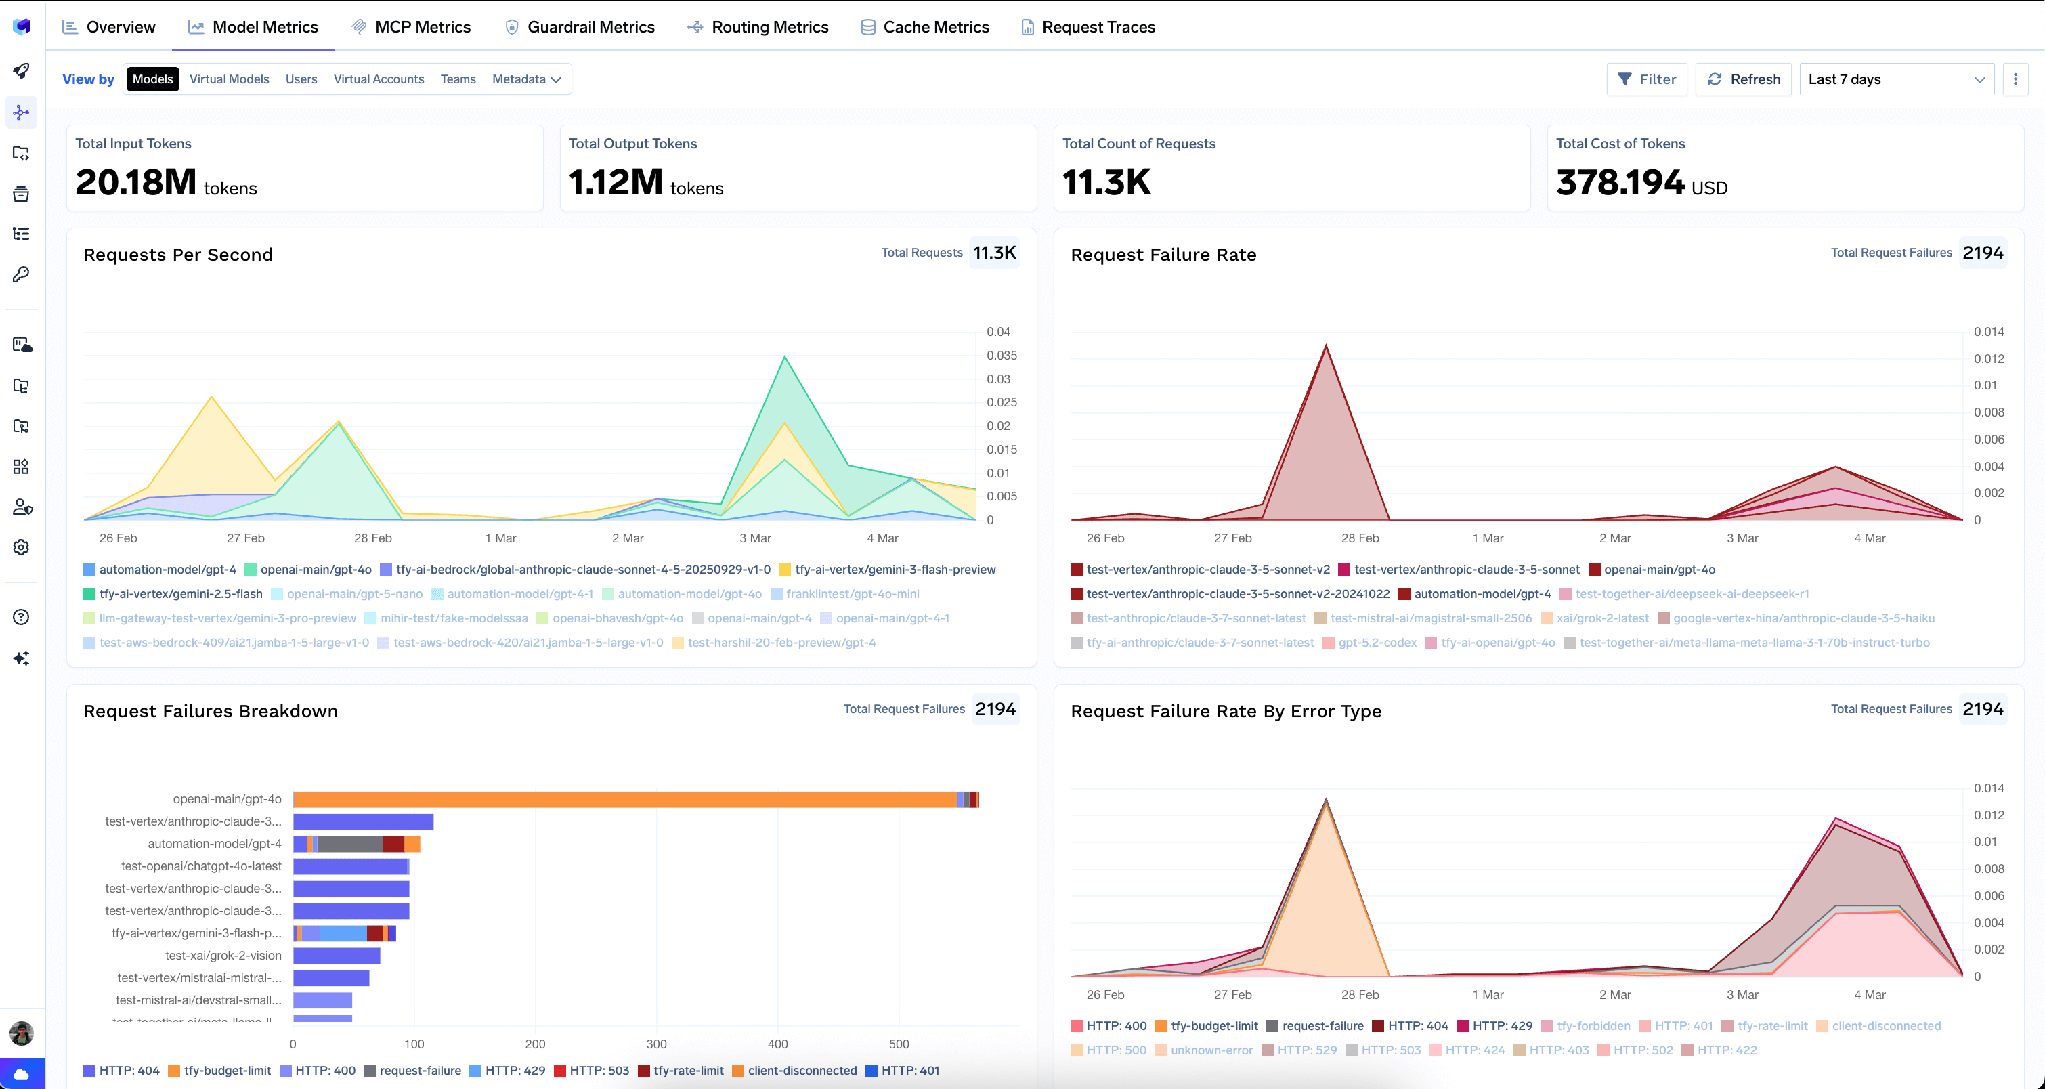
すべてのチャートは、View byセレクター(モデル、バーチャルモデル、ユーザー、バーチャルアカウント、チーム、またはリクエストヘッダーとして送信されたカスタムメタデータキー)を介して軸を切り替えることができます。早期にメタデータの設計を行いましょう。エージェント名や実行IDを送信すれば、追加の構築なしでエージェントごとのコストやレイテンシのビューを取得できます。
ツール呼び出しは、MCP metricsを通じて同様の処理が行われます。これは、ほとんどのLLM中心の構成が見落としがちな半分です。サーバービューでは、サーバーごとのスループット、レイテンシパーセンタイル、失敗率、エラーの内訳に加えて、tools/list、tools/call、resources/listなどのメソッド呼び出しの内訳が提供されます。繰り返されるtools/listでリクエストを無駄に消費しているエージェントは、タスクの問題ではなく検出(ディスカバリー)の問題を抱えています。
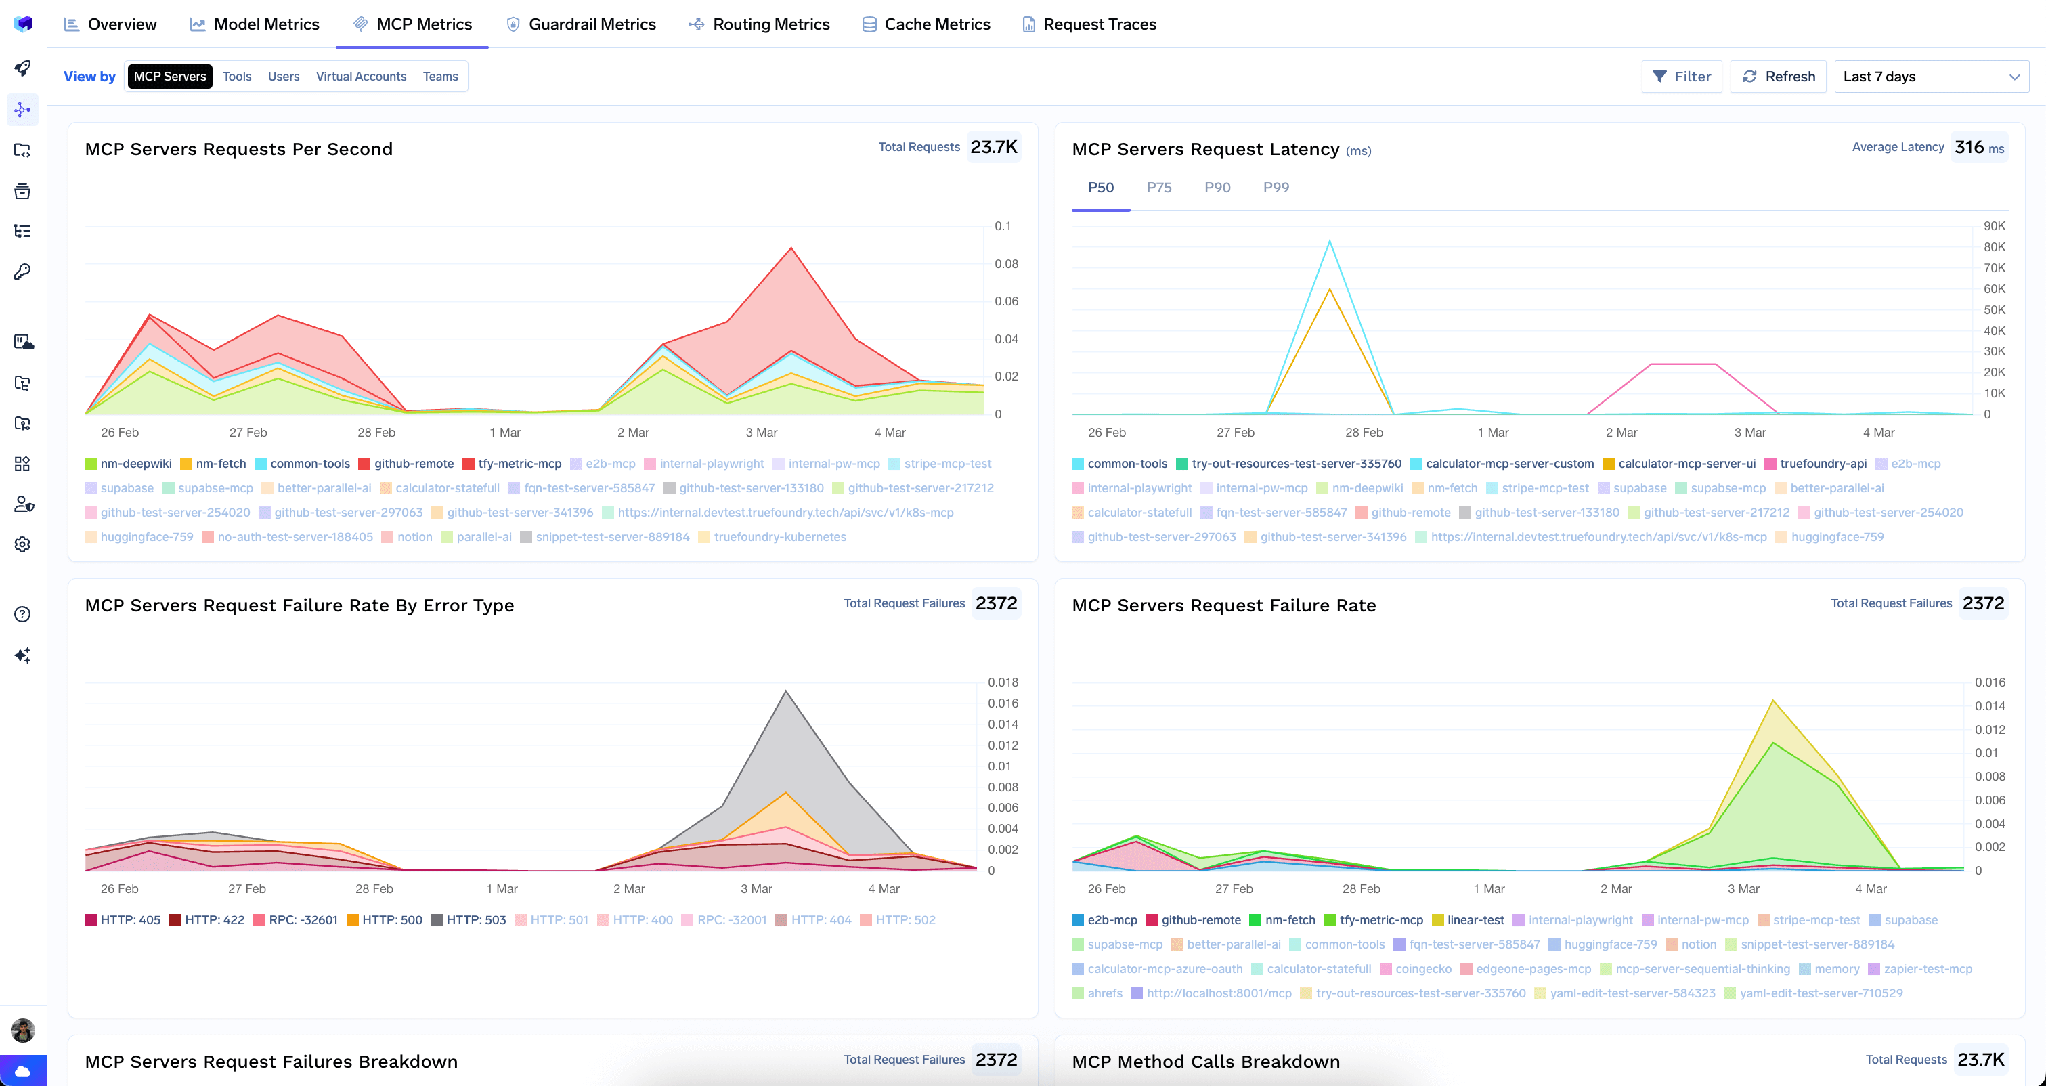
サーバーごとのリクエストレート、レイテンシ、メソッド呼び出しの内訳を表示するMCP Metricsサーバービュー
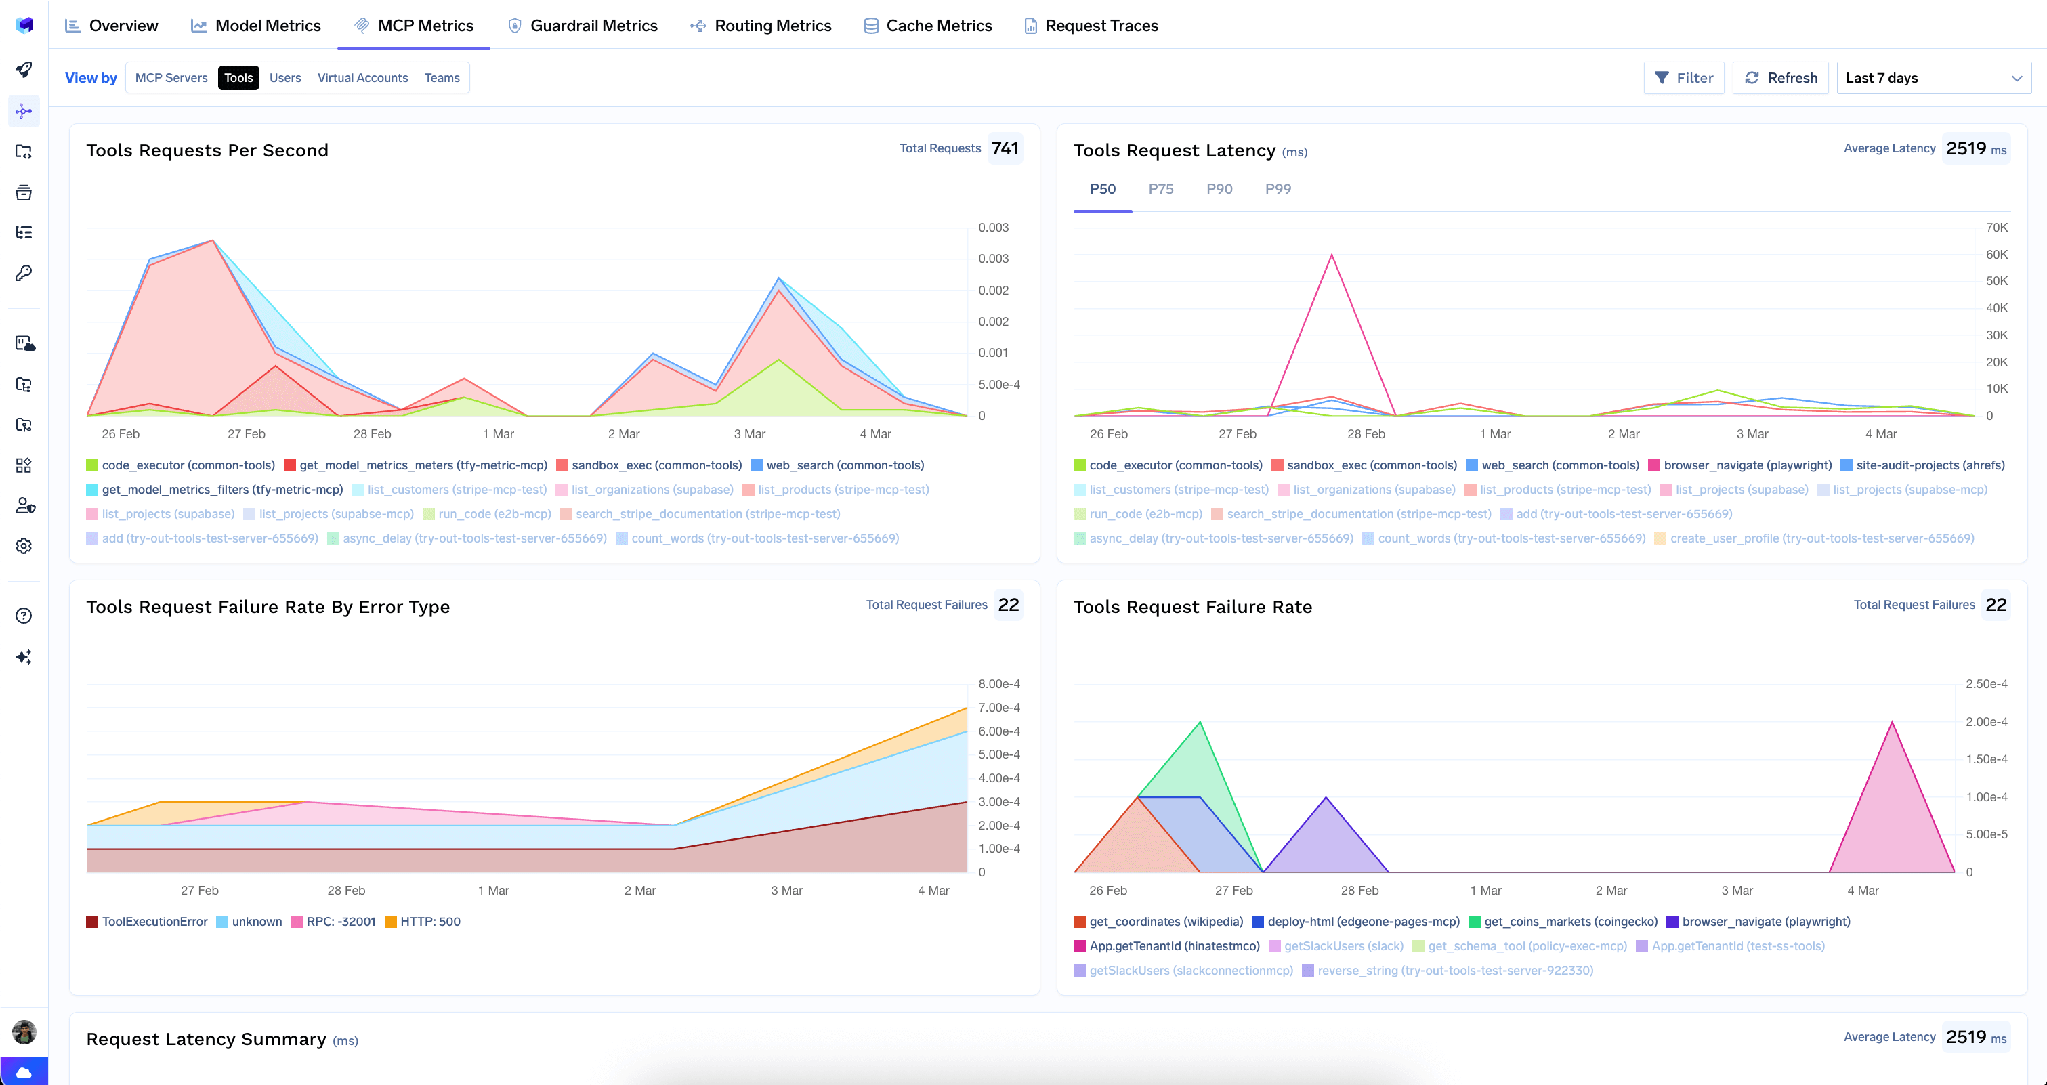
Toolsビューでは、すべてのサーバーにわたる個々のツールにドリルダウンできます。1秒あたりのリクエスト数、レイテンシパーセンタイル、エラータイプ別の失敗率、並列レイテンシの概要、およびリクエスト数でランク付けされたツールが表示されます。このランキングは、エージェントが想定以上に依存しているツールを特定する最も迅速な方法です。
フィルターはタブをまたいで保持されるため、モデルタブで特定の1ユーザーに絞り込んだ場合、MCPに切り替えてもそのフィルターが維持されます。これにより、クエリを再構築することなく、遅延セッションの原因がモデルにあるのかツールにあるのかを判断できます。
登録されたエージェントには、リクエスト数、レイテンシパーセンタイル、エラー率、時系列での使用状況をカバーする1つのダッシュボードが用意されています。これは、エージェントがBedrock、LangGraph、カスタムサービスのいずれで実行されていても同一です。

同じデータはクエリ可能です。metrics APIは、agentName、agentFramework、またはagentServerTypeでグループ化され、latencyMsに対するパーセンタイル集計を備えた、分布または時系列の結果を返すagentMetricsデータソースを公開します。マルチエージェントシステムでは、Request Tracesが各呼び出しを行ったエージェントとそれが代理したユーザーを記録します。このアトリビューションにより、サブエージェントのツール呼び出しを個人まで遡って追跡可能になります。
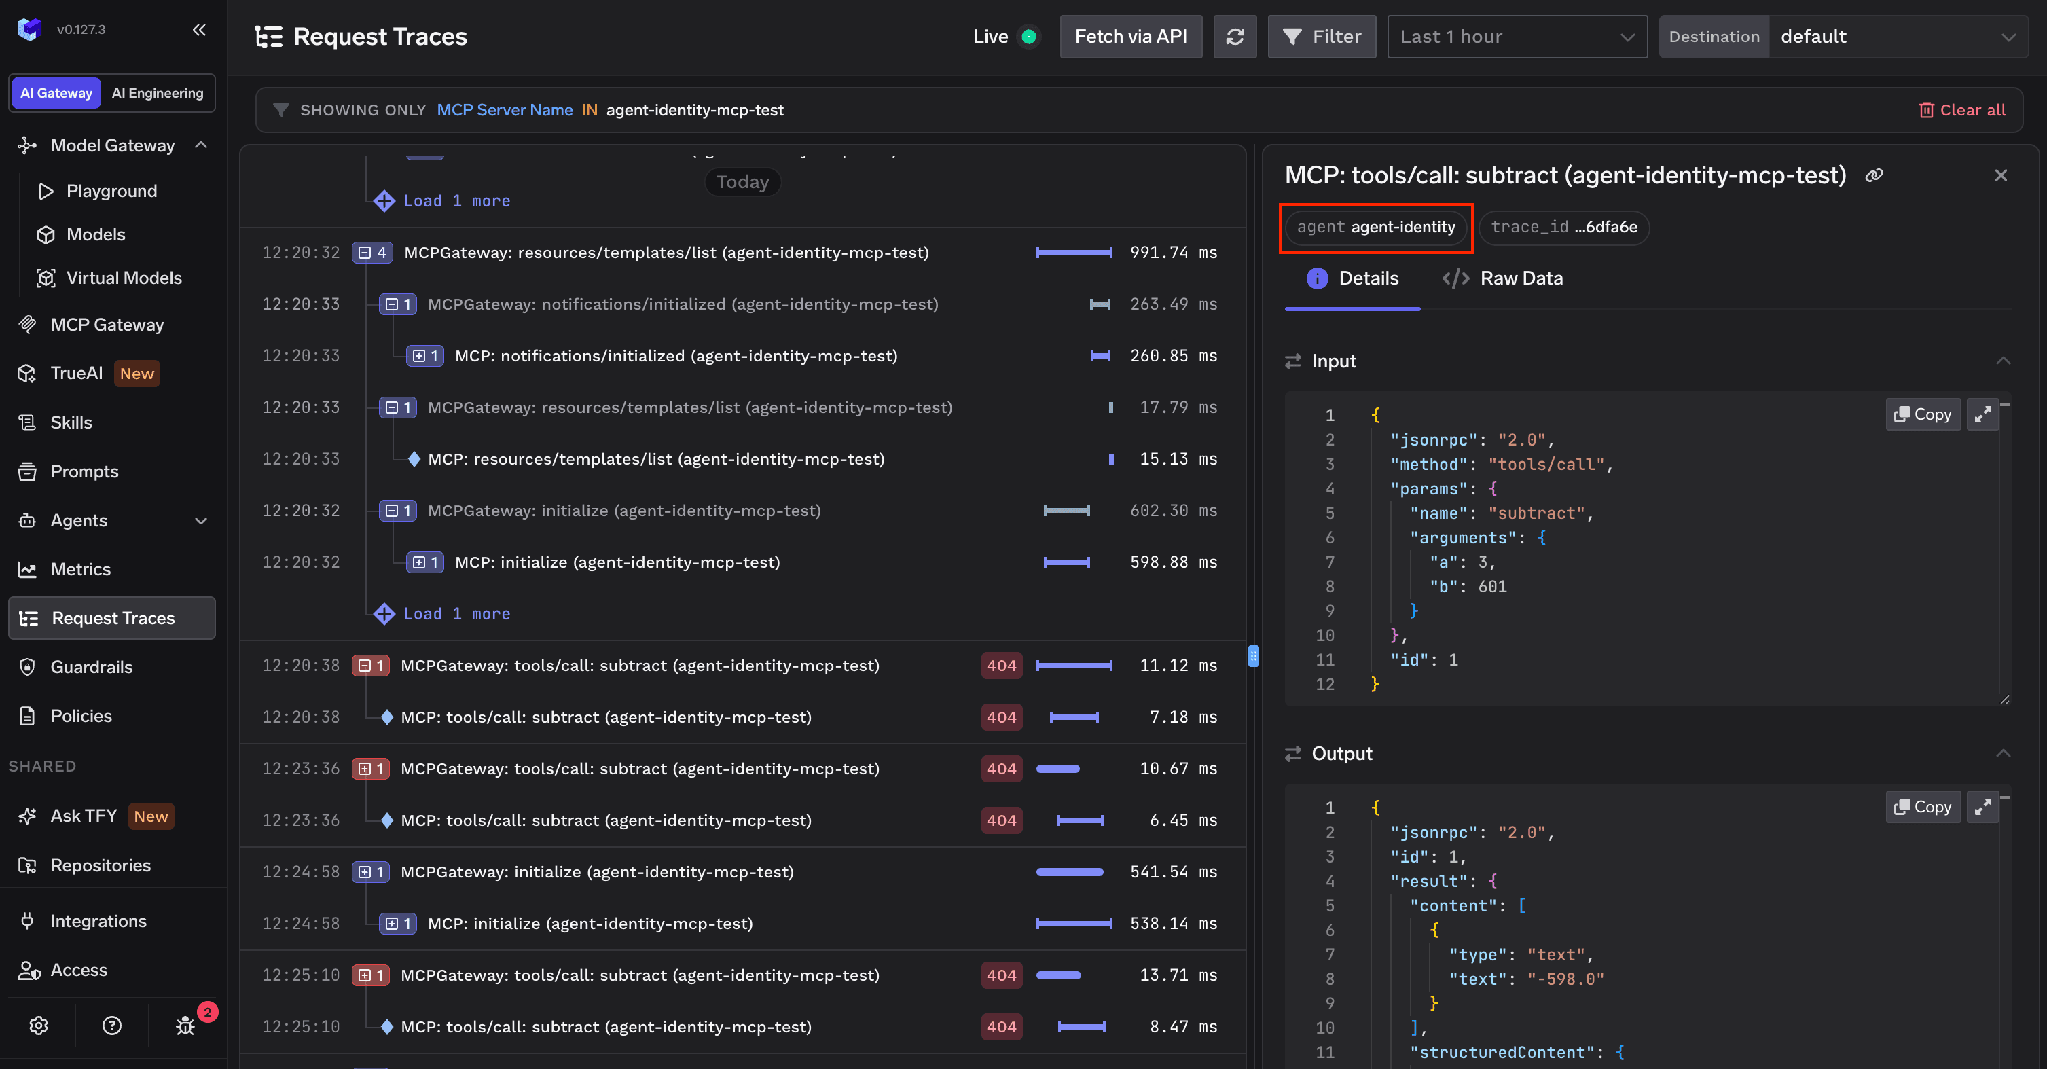
ひとつ正直な制限として、ユーザー → エージェント → サブエージェント → ツールを1つのレンダリングされたトレースに繋ぎ合わせるフルアクターチェーンビューは、ドリフト検出、異常アラート、ワンクリックでのエージェント一時停止とともに近日実装予定です。現在では、チェーンを1つの画像として描画するのではなく、各トレースでホップごとのアトリビューションが取得できます。
レイテンシやコストは計測可能ですが、回答の品質は測定できません。そのため、フィードバックは別のテーブルではなくトレースに紐付ける必要があります。すべてのゲートウェイレスポンスは、x-tfy-feedback-target-idヘッダーを返します。これを1から5の評価およびオプションのコメントとともに/api/svc/v1/gateway-feedbackにポストすると、スパンの横およびtfyGatewayFeedbacksの下の生データに表示され、返されたIDによって更新または削除が可能です。現在、ターゲットIDはルートスパンを指定するため、フィードバックはサブステップではなくリクエストに到達します。
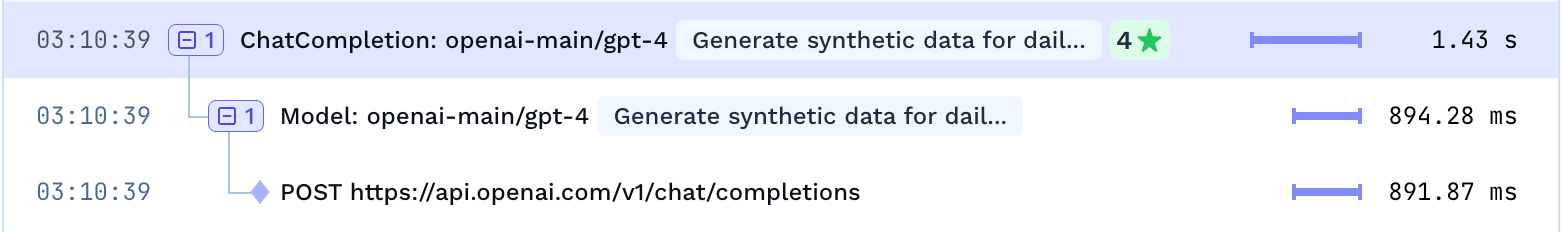
これをプロダクトのグッドボタン/バッドボタンのコントロールに接続すると、外れ値セッションに品質ラベルが付与され、「この実行は40倍のコストがかかった」を「この実行は40倍のコストがかかり、ユーザー評価は2だった」に変換できます。
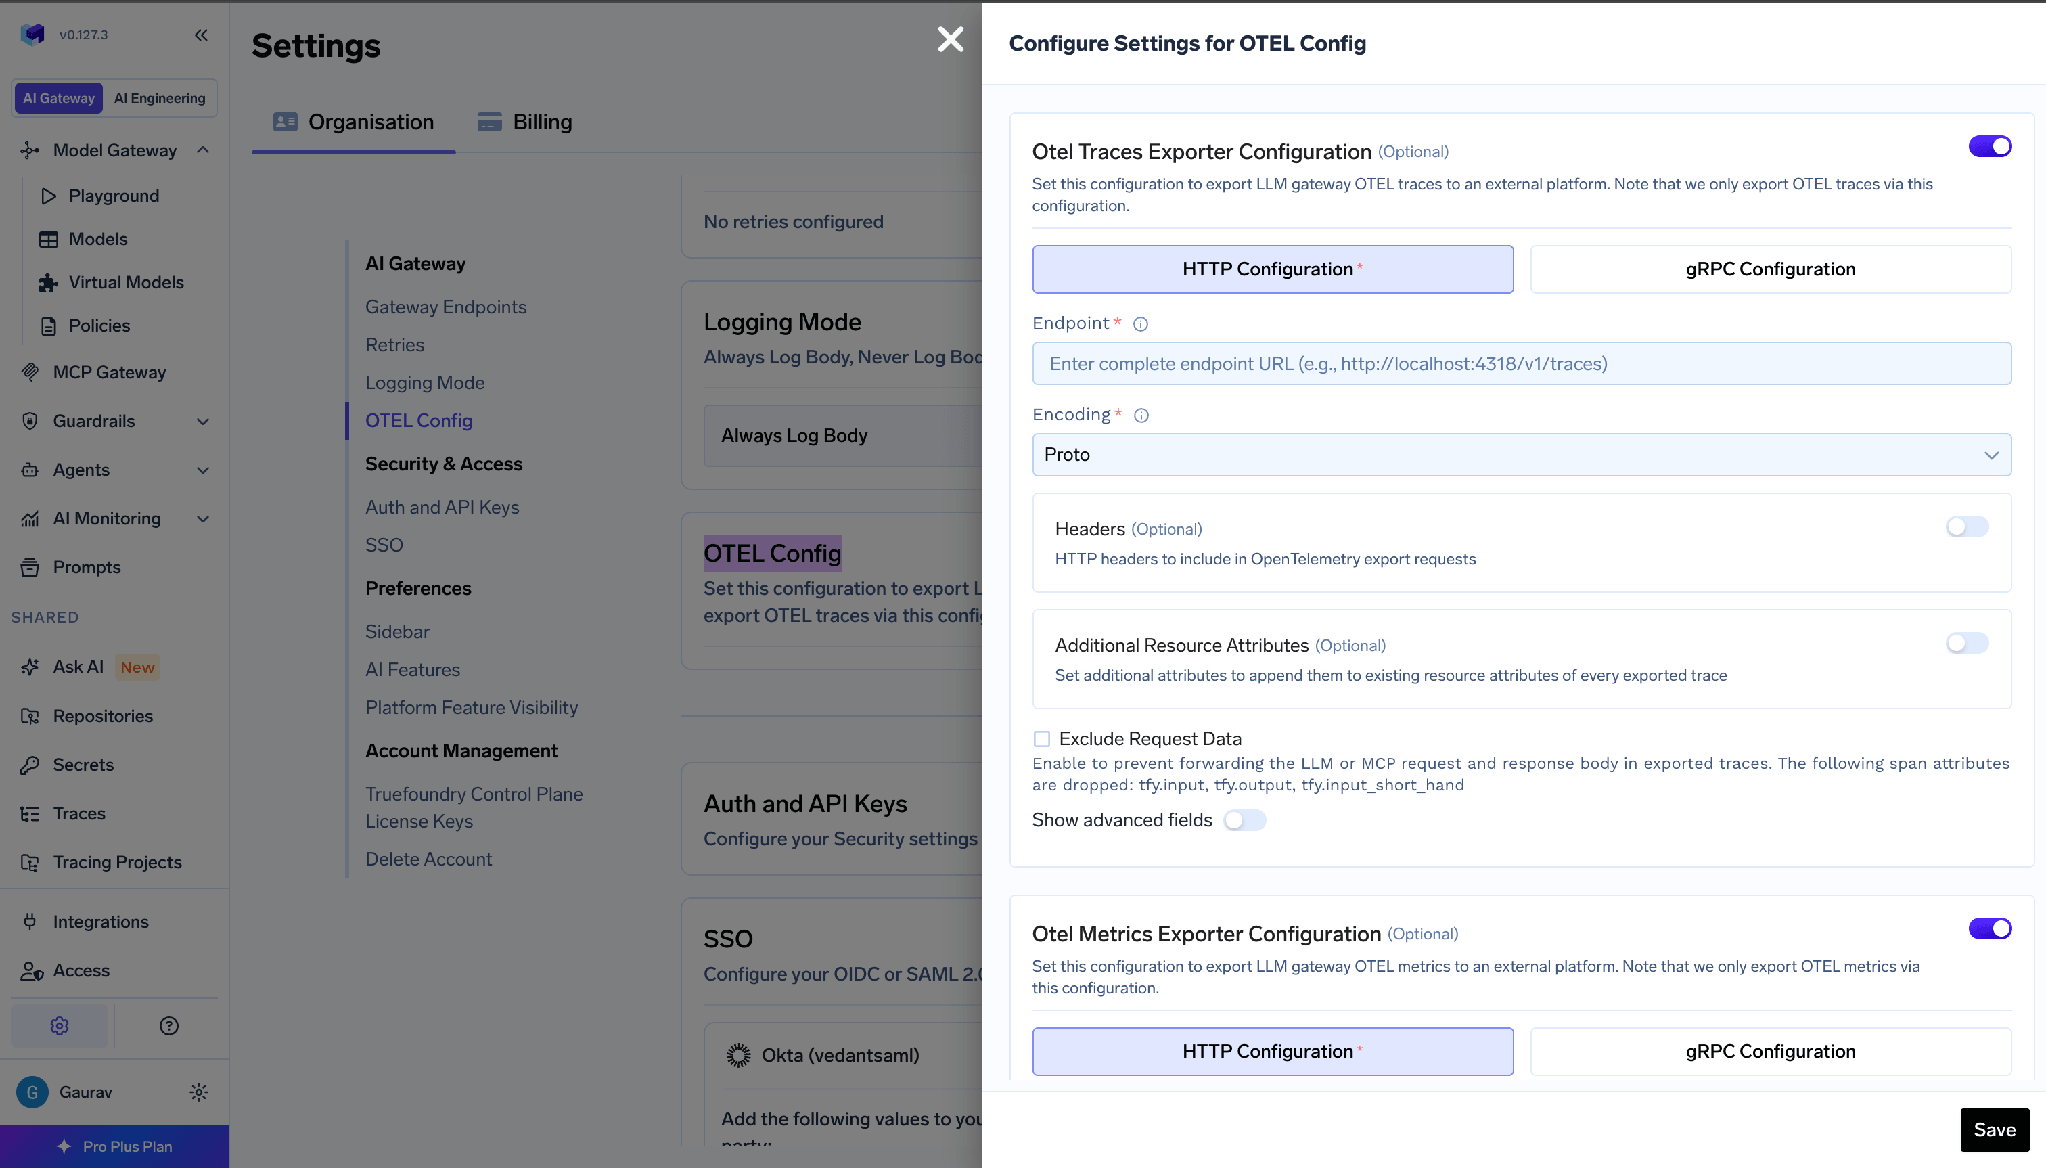
これらを利用するために、既存のスタックを離れる必要はありません。ゲートウェイはOpenTelemetryに準拠しており、トレースとメトリクスは独立してエクスポートされます。どちらもAI Gateway → Controls → Settings → OTEL Configの下で設定でき、HTTPまたはgRPC経由、protoまたはjsonエンコーディング、任意の認証ヘッダーを使用できます。DatadogやCloudWatchなど、デルタエンコードされたメトリクスを期待するバックエンドの場合、Export Delta Metricsトグルと、ゲートウェイデプロイメントでの一時的な環境変数が必要です。Prometheusは、セルフホストされたゲートウェイの/metricsをスクレイピングできます。
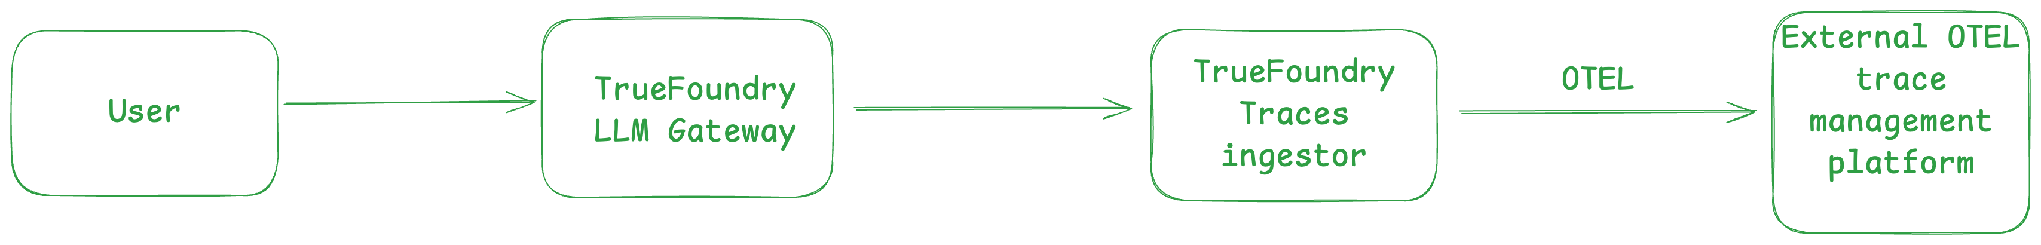
OpenTelemetryトレースフロー:TrueFoundryによって保存され、外部バックエンドにエクスポートされるトレース
エクスポートは追加的なものであり、引き継ぎではありません。どちらの場合もTrueFoundryはトレースを保存し続けるため、GrafanaやDatadogが同じデータを取得している間も、プロダクト内のセッションビューやスパンビューを引き続き利用できます。
本番運用を開始して1週間が経過したサポートコパイロット。財務部門から「なぜ請求額が3倍になったのか」と問われたケースを考えます。
セッションレベルから開始。コストでソートします。中央値は数セントですが、4つのセッションが1ドルを超えており、すべて単一桁のターン数です。つまり、これは会話が長いからではなく、個々のターンが過剰な処理を行っていることを意味します。
1つを開いてタイムラインを確認。ターン3は、ほぼ完全にツール呼び出しの色で占められています。ツール呼び出し:31。エラー:0。失敗したものはないため、アラートが送信されなかった理由が分かります。
ターン3のエージェントステップを展開。順序付けられたリストを見ると、1つのドキュメント取得ツールが繰り返し呼び出されており、ターンごとのトークン数がターン3以降、元に戻ることなく急激に増加しています。これは、大きなドキュメントがコンテキストに入り、そのまま保持されたことを示しています。
ツールレベルで確認。MCP metricsのToolsビューで、そのツールはリクエスト数ランキングで大差をつけてトップであり、p90が最も悪化しています。
修正し、検証。修正案がツールの絞り込みであれ、ページネーションであれ、あるいは「すでにファイルを持っている」とエージェントに伝えるプロンプトの変更であれ、検証手順は同じです。翌日のそのエージェントのセッションをフィルタリングし、コスト分布が平坦化したか確認します。フィードバックを接続している場合は、外れ値が評価の低い実行でもあったかどうかを確認します(通常はそうです)。
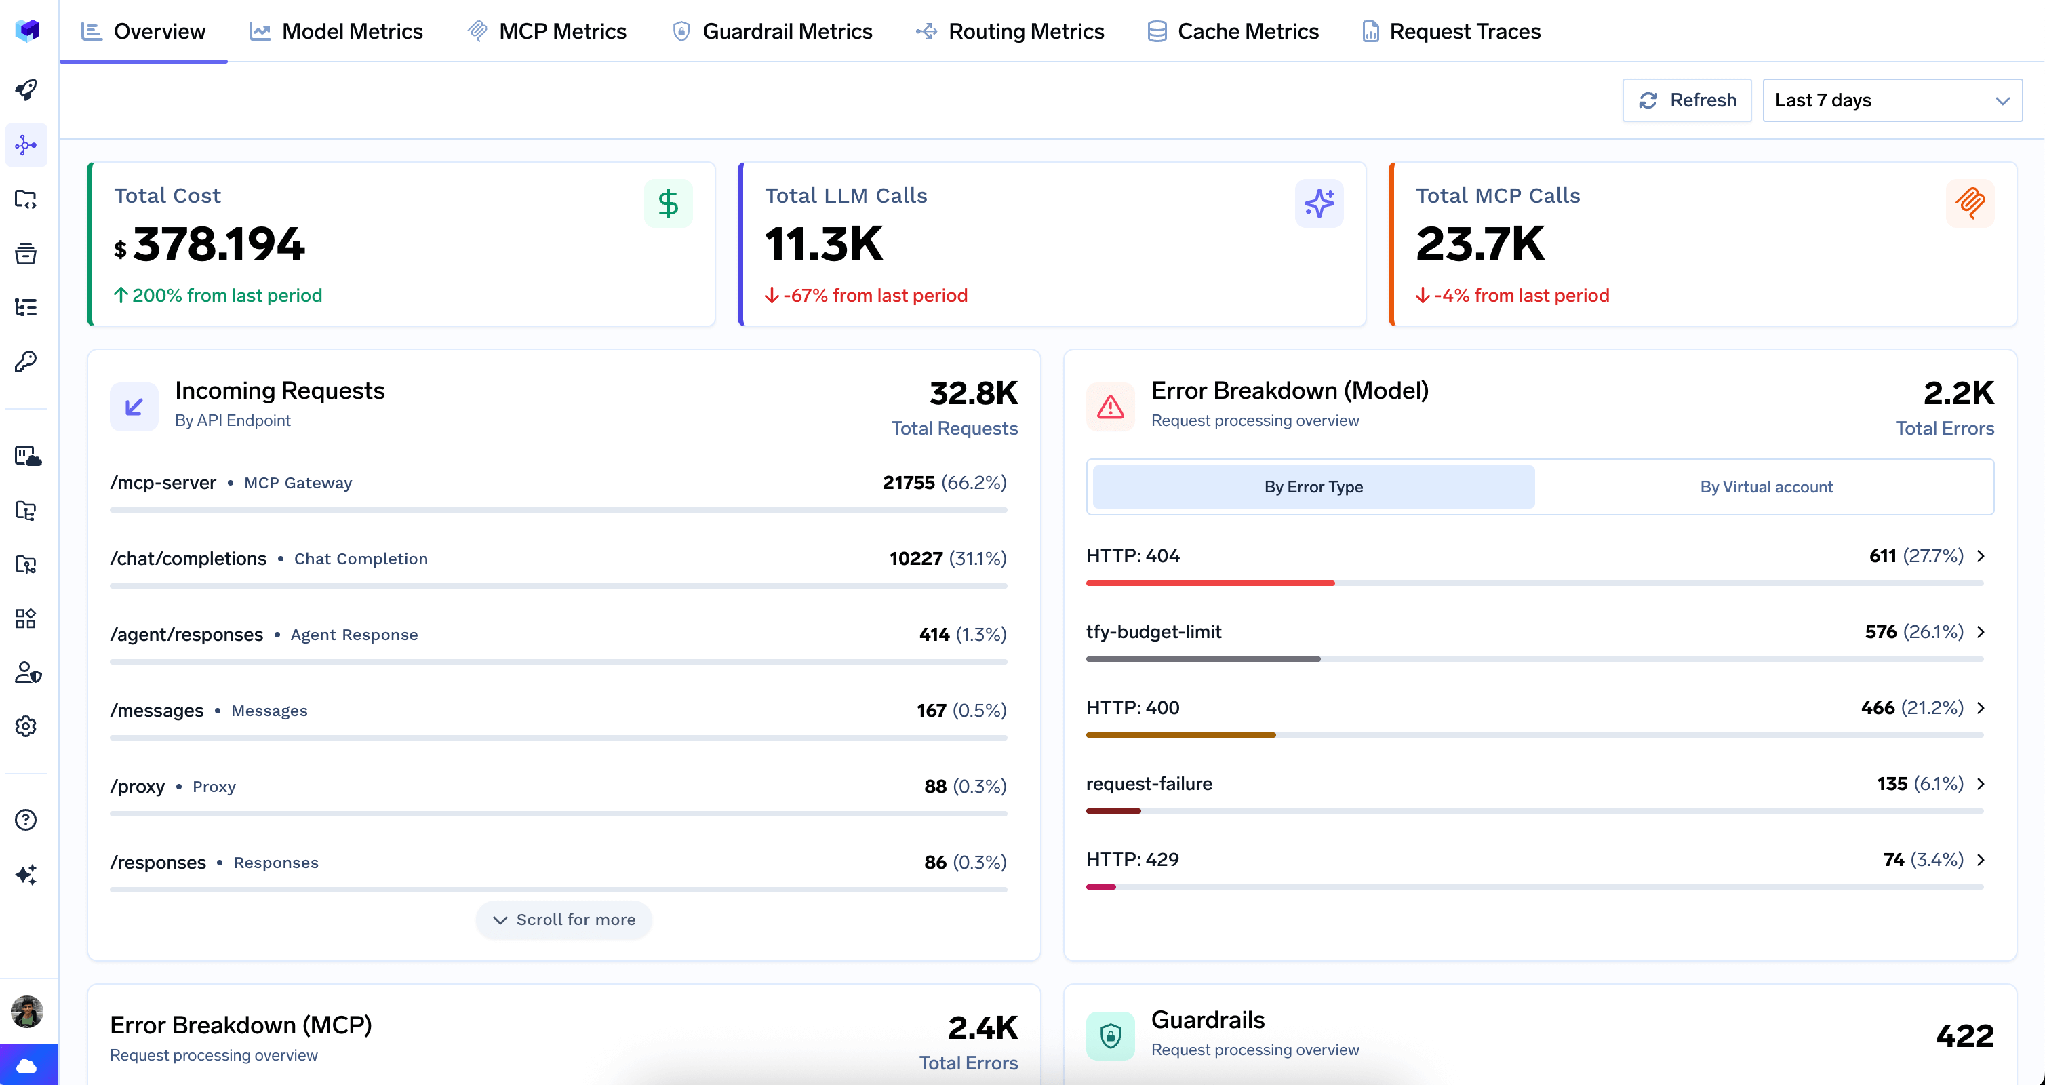
カスタムなインスツルメンテーションなしの5つのステップで、そのすべてが軌跡(トラジェクトリ)に関する問いに答えています。
エージェントメトリクスには、デフォルトですべてのゲートウェイリクエストが含まれます。エージェントを経由しなかった行は、agentName、agentFramework、agentServerTypeに対してnullを返し、groupBy出力にnullバケットとして表示されます。これら3つのフィールドではIS_NULLがサポートされていないため、agentName IN [...]またはSTRING_*演算子を使用してスコープを設定してください。
トレースとメトリクスのエクスポートは個別に設定します。トレースエクスポーターはトレースのみを送信し、メトリクスエクスポーターはメトリクスのみを送信します。一方を有効にして他方も設定されたと思い込むと、片方のデータしか取得できない状態になりがちです。
必要になる前にメタデータを設計してください。リクエストヘッダーとして送信されたカスタムメタデータキーは、ダッシュボード全体でView byのディメンションになります。事前に対象のエージェント名、環境、実行IDを追加するコストはゼロです。後から追加しようとすると、前四半期のデータをその軸で分割することはできません。
エージェントモニタリングにおいて陥りがちなのが、既存のダッシュボードにエージェントを無理やり組み込み、p99とエラー率を監視して「オブザーバビリティが確保された」と思い込むことです。しかし、その手法は最初のインシデントが起きるまでしか機能しません。予算を使い果たした実行がすべてのホップで200を返し、どのチャートにも異常として表示されないことに後から気づくことになるのです。
修正に必要なのは、さらなるメトリクスではなく、異なる観測単位です。軌跡(セッション、ターン、モデル呼び出し、ツール呼び出しと、スパン上の引数および結果)を記録することで、実際に発生する3つの失敗の明確化が容易になります。ループは同一の引数による呼び出しの繰り返しであり、悪いツール結果は保持されているため可視化され、40倍の実行はトップにソートされる外れ値として特定できます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




エージェントの実行の軌跡全体、つまりセッション、ターン、モデル呼び出し、ツール呼び出しを、引数、結果、トークン、コスト、レイテンシとともに記録し、なぜそのように動作したのかを説明できるようにすることです。アプリケーション監視との違いは観測の単位にあります。リクエストには開始と終了がありますが、軌跡は入れ子になったシーケンスであり、どの階層でもループが起こり得ます。
LLMのオブザーバビリティは、モデル呼び出し(プロンプト、生成結果、トークン、レイテンシ、コスト)を対象とする部分集合です。エージェントのオブザーバビリティは、その周囲のすべてを加えます。どのツールが、どの順序で、どの引数と結果で実行されたのか、そして1つのターンが停止するまでに何回ループしたのか、といった情報です。実際の障害の多くは、単一の生成結果ではなく、この構造の中にあります。
モデルとツールのトラフィックがすでにゲートウェイを経由している場合は不要です。ゲートウェイは、リクエストを処理する過程で各ホップを記録するためです。フレームワークレベルのSDKによる計装は、ゲートウェイからは見えない内部の推論ステップを補うものなので、両者は二者択一ではなく補完関係にあります。
はい。VPC、オンプレミス、エアギャップ環境、ハイブリッド、複数のクラウドのいずれにもデプロイでき、データがお客様のドメインの外に出ることはありません。
はい。MCP Gateway、Agent Gateway、そしてツール単位のアクセス制御を備えたMCP & Agents Registryが含まれています。LangGraph、CrewAI、AutoGen、または独自のフレームワークで構築されたエージェントを、すべて一元的に統制できます。
はい。ゲートウェイはOpenTelemetryに準拠しており、Grafana、Datadog、Prometheus、またはお好みのスタックに接続できます。プロンプトからツール、モデルの実行まで、すべてのリクエストを追跡するため、既存のシステムを大幅に変更することなく、統合されたロギングを実現できます。






















